ARTICLE · 1233132
端侧AI工具链原理(03):DAG规范化与Shape/Layout:图优化为什么要先把语义整理干净
本文是端侧 AI 工具链原理第 3 篇。上一篇讨论模型格式与 IR,这一篇进入编译器前端:在 Fusion 和 Tiling 之前,为什么必须先完成图规范化、Shape 推导和 Layout 治理?
开篇:图里多一个 Transpose ,可能让整段网络退出 NPU
算法框架导出的图常常不是硬件最喜欢的形态。它可能包含连续 Reshape、冗余 Cast、可折叠常量、训练残留节点、重复 Transpose 和表达相同语义的不同 Operator 组合。
这些节点单独看都不贵,但会破坏 Pattern 匹配、切断融合、制造 Layout 转换,甚至让后端认为某个子图不受支持。
图规范化的目标不是“减少节点数量”,而是把等价语义变成稳定、可分析、可 Lowering 的 Canonical Form。
一、 DAG 中需要保存哪些信息
一个计算图可以表示为:
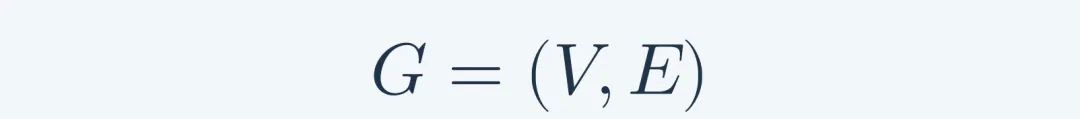
节点V表示 Operator ,边E表示 Tensor 或依赖。对 AI 编译器而言,边上至少需要保存:
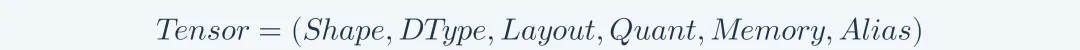
仅有节点名称和连接关系,不足以判断广播是否合法、 Buffer 能否复用、两个算子能否融合。
二、 Canonicalization 做什么
常见规范化包括:
规范化必须保持可观察语义:
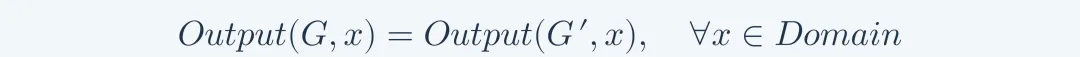
浮点优化还需要明确允许的数值误差和 NaN/Inf 语义,不能把数学等价直接当成位级等价。
三、 Constant Folding 为什么比看起来复杂
若一个子图输入全部为常量,编译期可以执行并替换为 Constant。但需考虑:
收益可以写成:
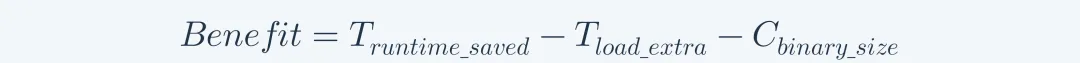
例如生成一个100 MB常量来节省一次轻量计算,可能得不偿失。
四、 Shape Inference 是约束求解
以二维卷积为例,输出高度为:
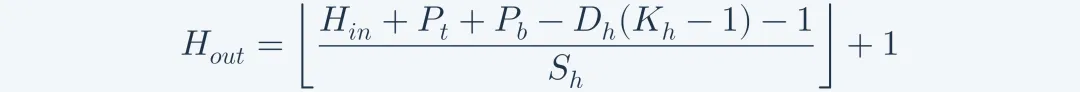
编译器不仅要算出一个数字,还要验证:
Shape 推导结果应包含 Known、Symbolic、Bounded Dynamic 和 Invalid 状态。
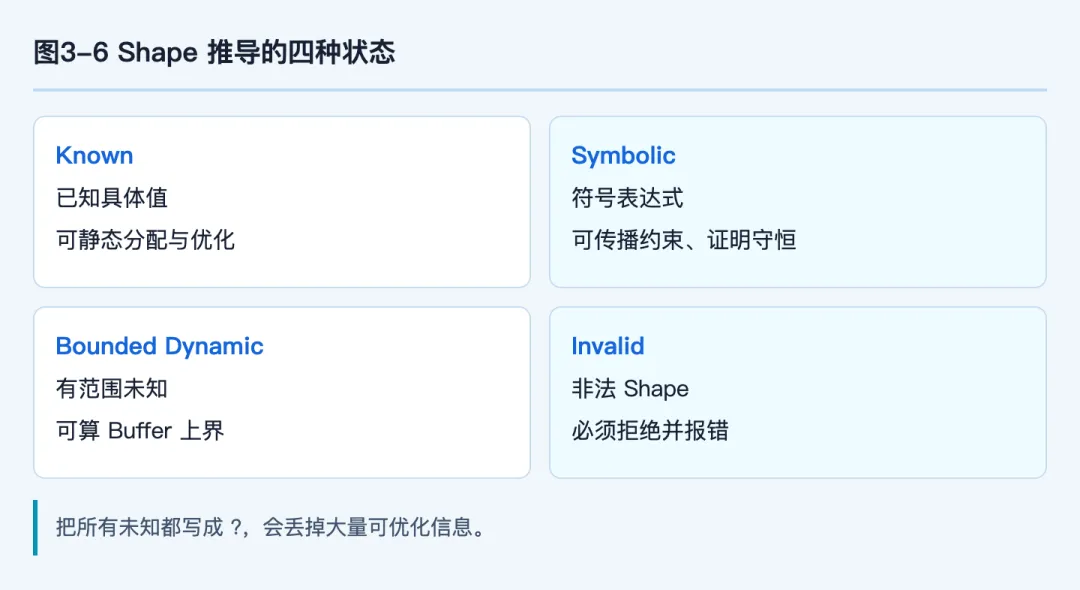
把所有未知都写成?,会丢掉大量可优化信息。
五、 Symbolic Shape 为什么重要
假设输入为[B,S,D],经过 Reshape 到[B,S,H,d_h],并满足:
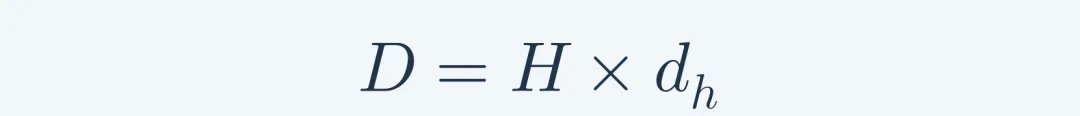
即使B和S未知,编译器仍可证明元素数量守恒、Head 维合法,并为多个算子传播相同 Symbol。
Symbolic Shape 让优化器可以:
六、 Layout 不仅是维度顺序
逻辑 Tensor 和物理存储应分开:
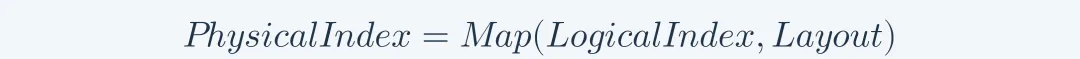
NCHW 到 NHWC 是 Permutation;NCHWc还包含 Channel Blocking;矩阵权重可能按 Tile 预打包,以匹配阵列读取顺序。
后端常希望:
如果每个节点各自选择最优 Layout,边界会产生大量 Reformat。编译器需要做全图 Layout Assignment。
七、 Layout 选择是图上的优化问题
设节点v选择 Layoutl_v,节点执行代价为C_v(l_v),边(u, v)的转换代价为R_{uv}(l_u, l_v),目标为:
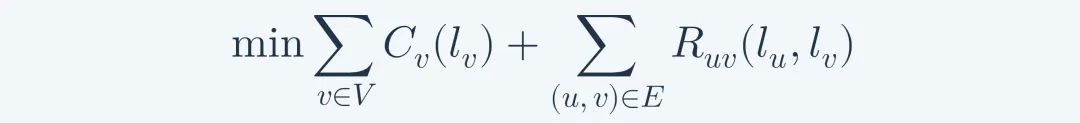
局部最快的 Kernel 不一定带来全图最快。例如某 Conv 使用 Blocked Layout 快0.2 ms,但前后各增加0.3 ms Reformat ,端到端反而慢0.4 ms。
这也是 Cost Model 必须参与 Layout 传播的原因。
八、 Broadcast 是常见语义陷阱
两个 Shape 按尾维对齐,维度相等或其中一个为1时可广播。对维度i:
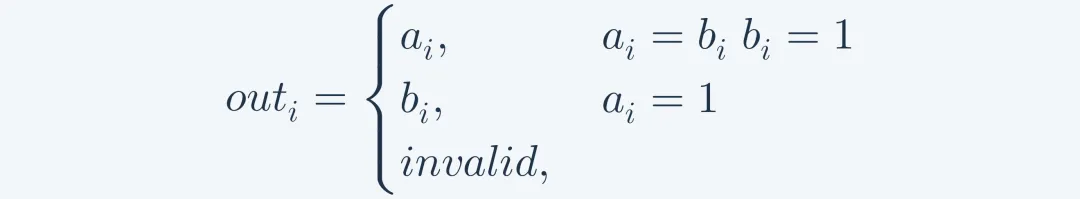
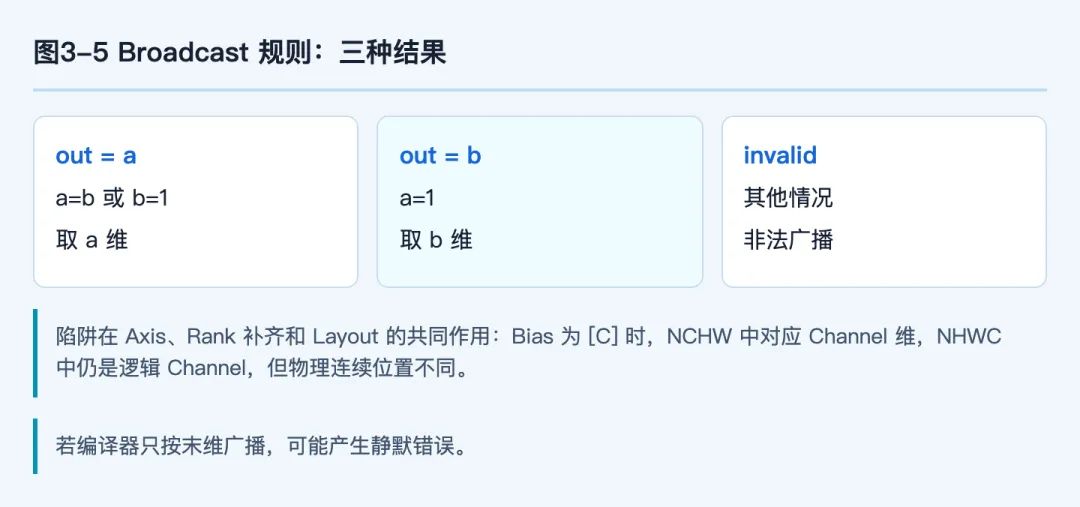
问题在于 Axis、Rank 补齐和 Layout 可能共同作用。一个 Bias 为[C],在 NCHW 中对应 Channel 维,在 NHWC 中仍是逻辑 Channel ,但物理连续位置不同。若编译器只按末维广播,可能产生静默错误。
九、 Alias 与 In-place 会影响图改写
高层 Tensor 看似不可变,实际 Bufferization 后可能共享底层存储。View、 Slice 和 Reshape 可能只改变元数据,不复制数据。
若两个 Tensor Alias 同一 Buffer,编译器进行 In-place 写入前必须证明不会破坏其他 Use。Live Range 重叠时,错误复用会造成与执行顺序相关的随机结果。
因此,图规范化不能只操作节点文本,还要维护 Use-Def、Side Effect 和 Alias 信息。
十、 Dynamic Shape 的工程策略
常见策略有:
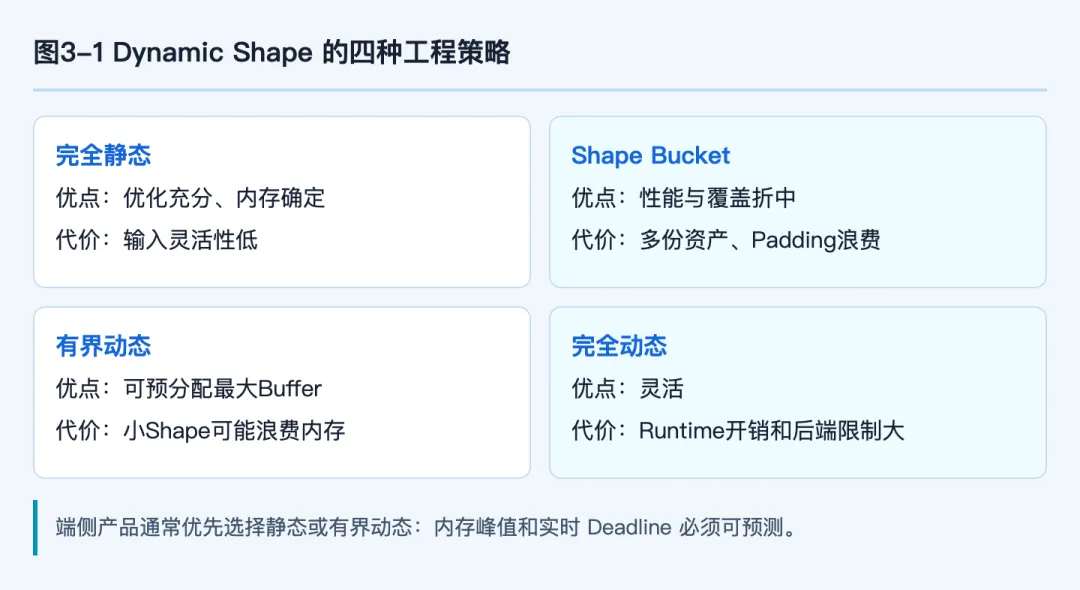
端侧产品通常优先选择静态或有界动态,因为内存峰值和实时 Deadline 必须可预测。
十一、如何验证规范化没有改坏模型
每个 Graph Pass 应具备:
不要只在完整模型失败后逐个猜 Pass。工具链应支持记录 Pass Pipeline,并二分定位首次产生数值偏差或非法 IR 的位置。
十二、一个 Transpose 风暴案例
假设前端模型使用 NCHW,目标 NPU 的 Conv 偏好 NHWC,而 CPU Fallback 使用 NCHW。图中有20层 Conv,其中一个中间 Resize 只支持 CPU。
局部贪心可能生成:

如果 Resize 前后的 Feature 为1 x 128 x 128 x 64、FP16,单个 Tensor 约2 MB。四次完整读写的流量约为:
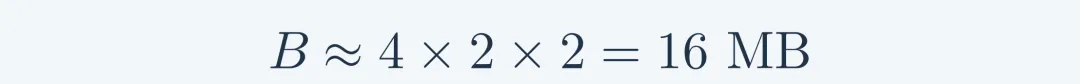
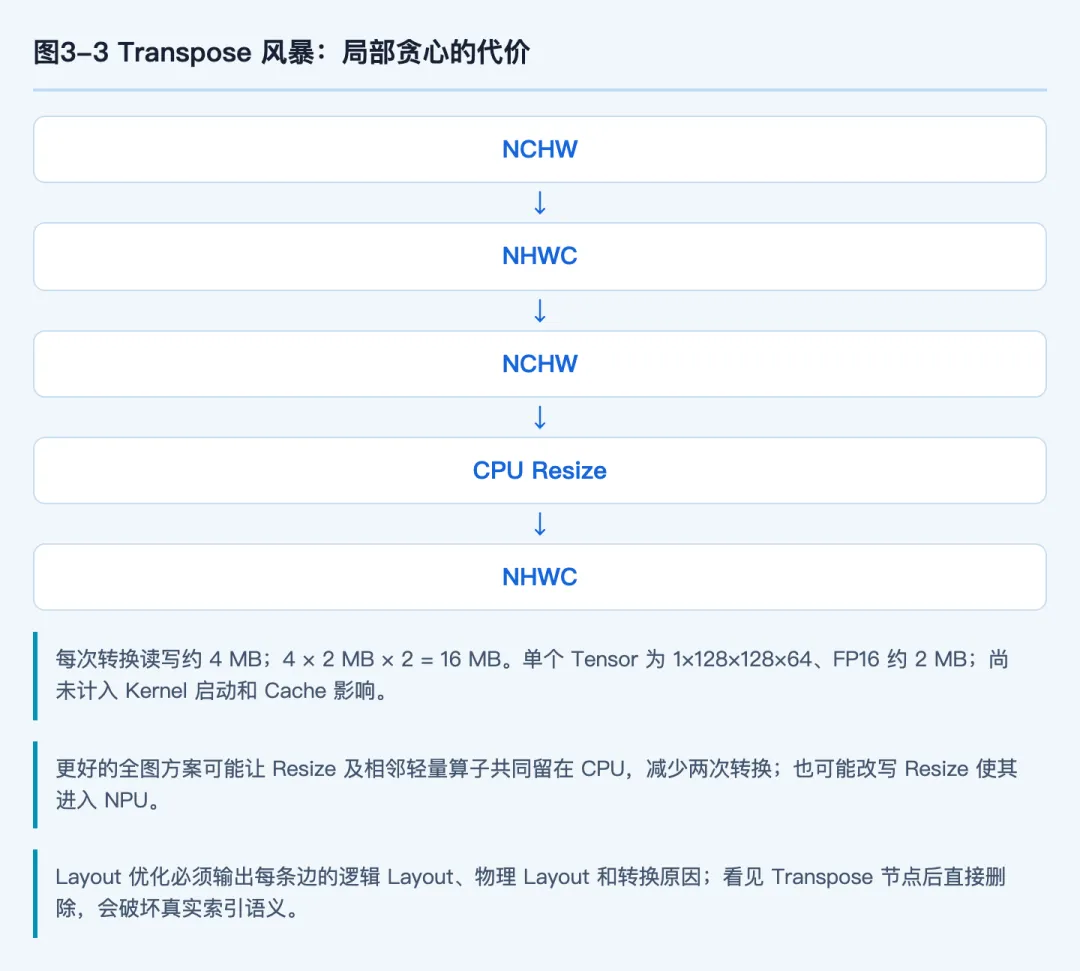
这还没有计入 Kernel 启动和 Cache 影响。更好的全图方案可能让 Resize 及相邻轻量算子共同留在 CPU,减少两次转换;也可能改写 Resize 使其进入 NPU 。
Layout 优化必须输出每条边的逻辑 Layout、物理 Layout 和转换原因。看见 Transpose 节点后直接删除,会破坏真实索引语义。
十三、 Dynamic Shape 怎样影响内存上界
设输入序列1 ≤ S ≤ 2048,某中间 Tensor 为[B, H, S, d_h]。若按最大值预分配:
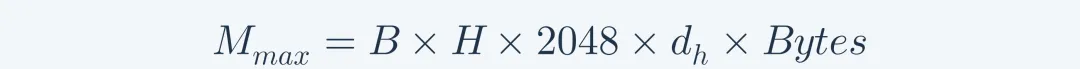
当真实S=128时,利用率只有6.25%。改用 Bucket {128, 512, 1024, 2048}可减少浪费,但会增加 Binary、Context 和测试组合。
Bucket 边界还影响 Padding 计算:S=513若进入1024计划,近一半 Attention 位置可能无效。Cost Model 应同时考虑内存、计算浪费、资产数量和命中分布。
十四、 Pass Pipeline 应该怎样审查
每个 Pass 记录:
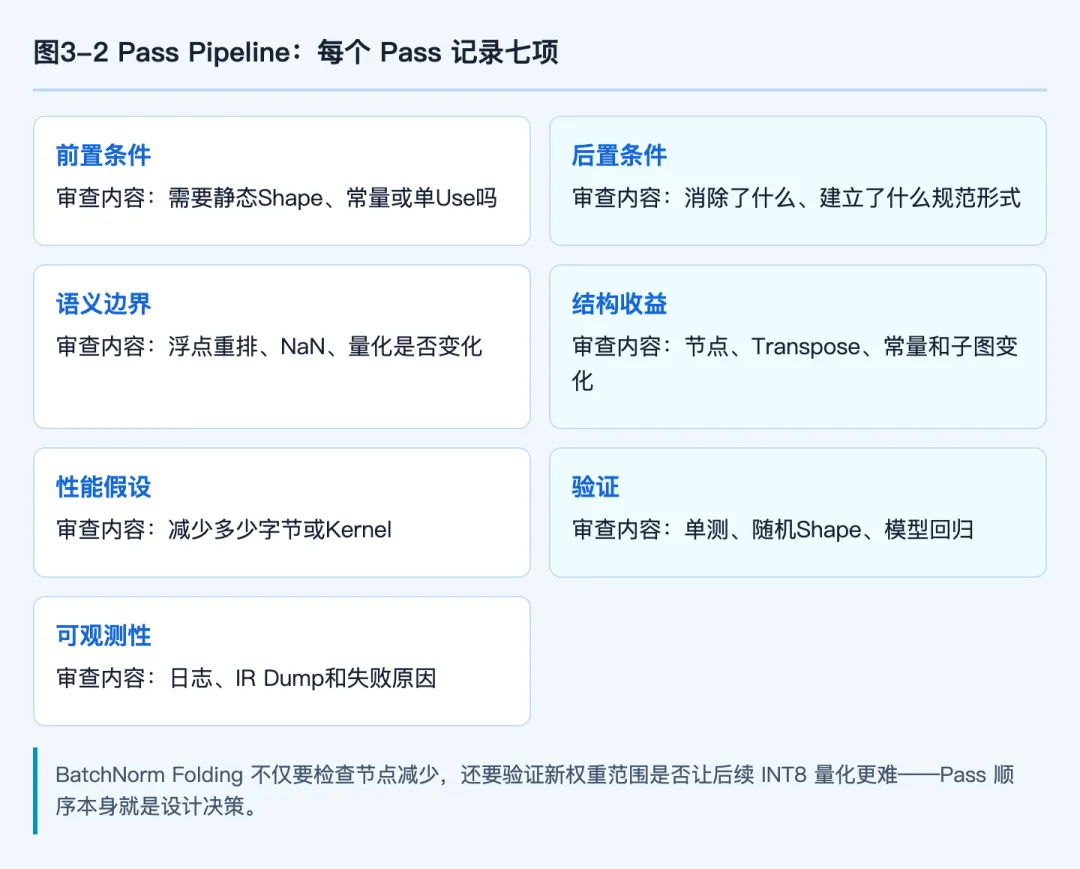
例如 BatchNorm Folding 不仅要检查节点减少,还要验证新权重范围是否让后续 INT8 量化更难。规范化 Pass 与量化 Pass 的顺序本身就是设计决策。
十五、前端完成度的退出条件
进入 Backend 前,图应满足:所有 Tensor 具有 Rank 和 DType ;动态维有范围或明确 Runtime 策略;Layout 语义可追踪;Quant 参数完整; Unsupported 控制流已处理;常量体积受控;每个节点通过 Verifier;Golden 输出仍在容差内。
如果这些条件未满足,后端性能问题通常只是前端语义债务的延迟暴露。
十六、 Pass 顺序为什么会改变结果
考虑 Conv-BatchNorm-ReLU 与量化。若先做 BatchNorm Folding ,权重变为:
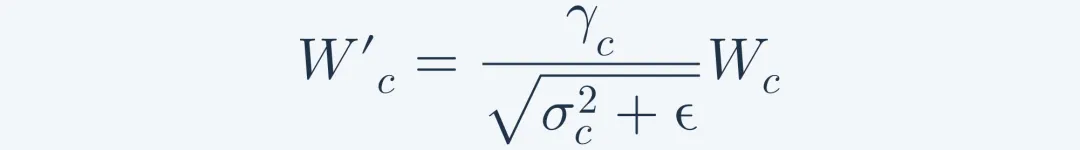
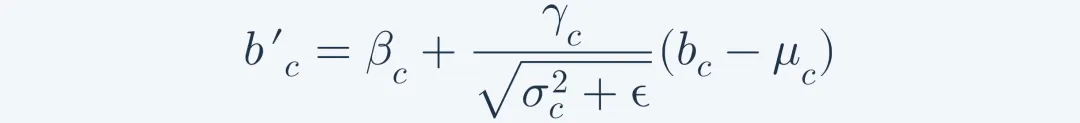
折叠后权重通道范围可能显著变化,随后 Per-channel 量化可以适应;若先使用 Per-tensor 量化再折叠, Scale 可能不再合理。类似地, Layout Assignment 发生在 Fusion 前后,也会改变 Pattern 能否匹配。
推荐把 Pass Pipeline 按阶段组织:
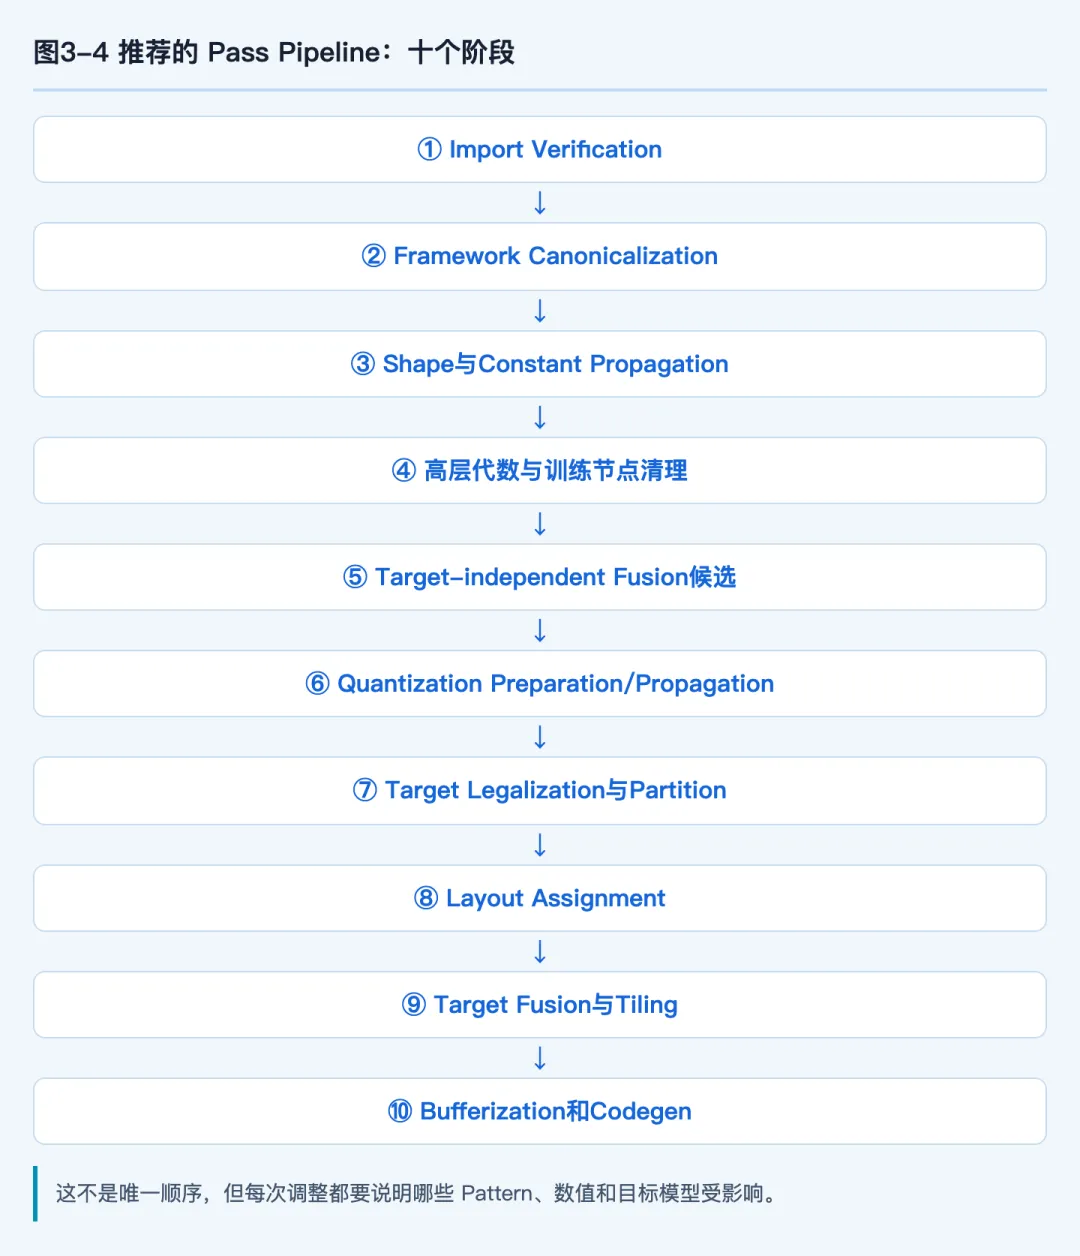
这不是唯一顺序,但每次调整都要说明哪些 Pattern、数值和目标模型受影响。
十七、 Shape 、 Layout 与 Quant 为何必须联合传播
假设 Activation 逻辑 Shape 为[N, C, H, W], Per-channel Quant Axis 为C。目标 Layout 改为 NHWC 后,物理 Axis 从索引1变为索引3。如果 Quant 只保存整数 Axis 而不绑定逻辑维度, Layout Pass 会造成错误。
更稳健的 IR 表达是将量化维关联到逻辑 Dimension Symbol ,再由 Layout Map 求物理位置:
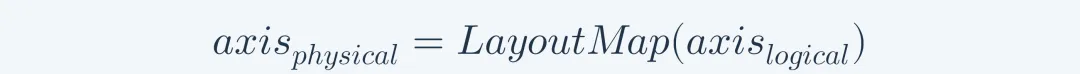
Blocked Layout 还可能把C分解为C_o, C_i。 Scale 究竟按完整C、外块还是内块应用,需要目标 Kernel 契约。于是 Layout 不是后端私有细节,Quant 也不是单独的类型标签。
十八、 Dynamic Shape Guard 怎样生成
编译器为优化计划建立前置条件,例如:
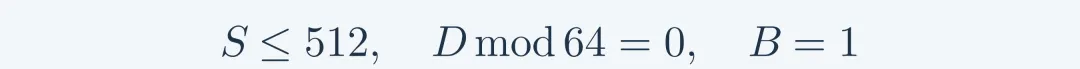
Runtime 执行前检查 Guard,满足时选择专用 Plan,不满足时选择通用 Plan 或拒绝。Guard 应由 Shape Constraint 自动生成,并包含清晰错误信息。
如果只在 Kernel 内部假定D%64 = 0,非法 Shape 可能导致越界;如果所有输入都走通用 Plan,又浪费静态优化机会。Guard 是静态优化与动态输入之间的正式契约。
十九、前端图质量怎样量化
除了节点数量,还可以统计:
这些指标能预测后端风险。图越规范,不代表节点越少,而是未知语义和隐式假设越少。
工程检查清单
结尾:图越干净,后端选择才越真实
规范化、Shape 推导和 Layout 治理看似属于编译器前端,却决定了后续 Pattern 能否识别、内存能否规划、后端能否覆盖。一个语义凌乱的图,即使交给强大的 NPU ,也只会把问题推迟到更难定位的阶段。
下一篇将讨论工具链最现实的边界:算子“支持”到底意味着什么,编译器如何分图, Fallback 为何常常比不支持本身更昂贵。
参考资料
参考链接
[1] MLIR Shape Dialect: https://mlir.llvm.org/docs/Dialects/ShapeDialect/
[2] MLIR Linalg Dialect: https://mlir.llvm.org/docs/Dialects/Linalg/
[3] MLIR Bufferization: https://mlir.llvm.org/docs/Bufferization/
[4] ONNX Shape Inference: https://onnx.ai/onnx/repo-docs/ShapeInference.html
--------------------------------
我是半川
一个偏爱在芯片底层与光影算法里死磕细节的工程师