ARTICLE · 1249855
会解释论文的AI,为什么未必能预测分子性质?
会解释论文,不等于能准确预测新分子的性质。本文从溶解度预测、模型评测和ChemCrow案例出发,梳理一个性质数值背后的数据、方法与实验依据,帮助读者判断AI给出的结果究竟能支持哪一步研究。

假设你正在读一篇分子研究论文,请AI解释作者为什么关注水溶解度。它把实验目的、研究方法和结论讲清楚了。接着,你给它一个新分子的结构,问这个分子在水里能溶多少,它又给出一个带单位的数。
两次回答都围绕分子,却需要不同的证据。解释论文,要回到原文检查有没有读错;预测新分子的性质,要看预测方法是否适合这个对象,以及它在独立数据和实验中表现怎样。
会解释论文,是有用的科研能力。要把一个预测数值用于下一步研究,还得弄清这个数是怎样得到的。
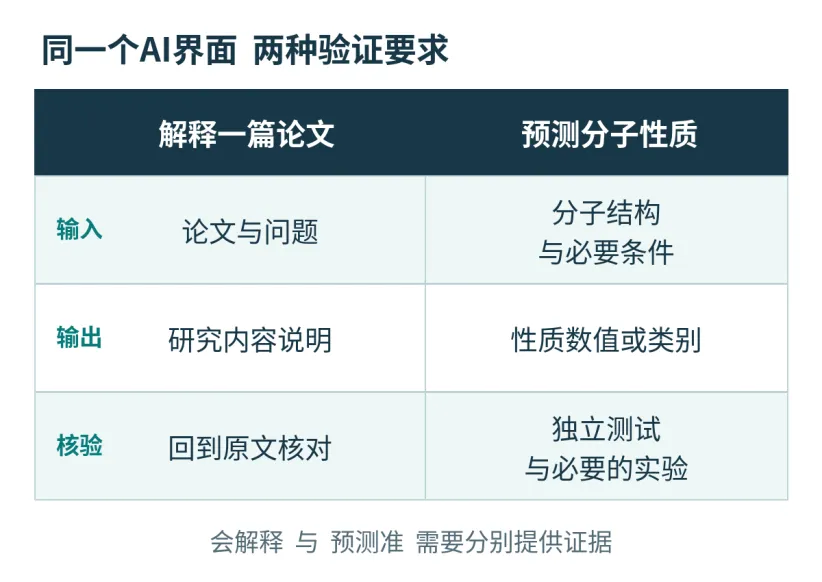
图1 解释质量与预测能力需要分别验证。图为本文绘制的任务对照示意。
先问这个数从哪里来
一个数出现在聊天窗口里,可能经过了不同的过程。AI可能从论文中找到了已有测量值,也可能调用软件做了一次计算,或者把分子结构交给预测模型,再转述模型返回的结果。只看最后一句回答,很难分辨。
如果数值来自文献,首先要确认论文研究的是同一个分子,测量条件是否相符。如果数值来自模型,则要追问模型学过什么数据、输出的性质怎样定义、对这类分子的误差有多大。数值来源不同,核验方法也随之改变。
这也是为什么“能给出答案”还不足以评价一个科研系统。研究人员真正需要知道的是:这个答案能支持哪一步工作。用它初步安排实验,与据此宣称一种性质已经得到证实,需要的证据并不相同。
预测溶解度
先把分子和条件说清楚
沿着开头的假设任务往下走。首先要把分子结构交代准确:有哪些原子,怎样连接,必要时还包括立体结构。研究中常用分子图或SMILES结构字符串表达这些信息。这里的字符串有明确的结构规则,不能用一段含糊的文字介绍代替。
接下来要说明“溶解度”对应什么条件。溶剂、温度、酸碱条件等都可能影响结果。一个只接收分子结构、没有把这些条件纳入输入的模型,学到的是其训练数据口径下的关系,不能自动给出任意条件下都适用的数值。
训练时受到什么约束,也会影响模型的能力。常见生成式语言模型在预训练中学习根据上下文预测后续词元,即文本被切分后的基本单位。指令训练和人类反馈可以进一步改善它遵循任务要求的表现。这些训练能帮助模型理解提问、组织回答,但具体的分子预测能力仍需单独检验。
性质预测模型则可以用“分子结构—已知性质”的成对数据学习。它先给出预测,再根据与参考值的差距调整参数。参考值可能来自实验,也可能来自某种计算方法;评价结果时,必须说明究竟在逼近哪一种参考。
2019年,Yang等人在Chemprop相关研究中评测了一种分子图模型。论文将原子与化学键信息用于性质预测,其中的ESOL水溶解度数据集包含1,128个化合物,采用均方根误差(RMSE)评价预测结果。这就把任务落实到了具体对象、目标和评测方法上。
这里还有一个容易漏掉的细节。DeepChem公开的ESOL数据文件,把测量目标标为以mol/L表示的溶解度的对数。因而看到一个误差数字时,还要确认它是在原始浓度上计算,还是在对数尺度上计算。误差指标的名字相同,并不表示数值可以直接横向比较。
RMSE可以理解为汇总一批预测偏差的指标,其中较大的偏差会受到更重的惩罚;在同一任务、同一口径和同一测试集上,数值越小通常越好。它描述的是这一批样本的整体表现,不能当成每个新分子的误差上限。
测试集里的新分子
到底有多新?
模型没有见过某个分子,不代表它从未见过与之很相似的结构。假设一个测试分子与训练分子只差一个局部基团,那么这次测试,与要求模型预测一类陌生结构,难度可能不同。
Yang等人的研究因此比较了随机划分与骨架划分。随机划分后,训练集和测试集可能包含骨架相同的分子;骨架划分则把具有同一骨架的分子放在一组,再分配到不同数据集,考察模型面对未见骨架时的表现。
对准备探索新结构的研究者来说,这个区别有实际意义。一份漂亮的随机测试成绩,未必能回答“换到我手上的这批新结构,还准不准”。应当让测试方式尽量接近准备使用模型的情境,并查看模型是否优于同条件下的简单基线。
骨架划分也不能包办全部验证。实验条件变化、测量噪声和数据覆盖不足,仍然可能影响结果。一次评测能支持的结论,受它使用的数据和任务范围约束。
一个真实案例:语言模型
怎样接上专业预测?
语言模型与性质预测模型可以放在同一个系统里协作。2024年发表于《Nature Machine Intelligence》的ChemCrow研究,提供了一个具体例子:研究者希望找到一个具有指定吸光特征的新分子,考察的性质是最大吸收波长,也就是测得的光谱中吸收最强的位置。
研究者设定的目标是369纳米。按论文所述,ChemCrow加载、清理和处理已有数据,训练并评估一个随机森林预测模型,再据此提出候选分子。随后,研究人员合成并分析这个分子,论文报告的实测最大吸收波长为336纳米。
这一过程里,语言模型负责组织任务、调用工具和整理结果,预测器负责根据数据估计性质,实验则检验候选分子实际表现。只说“AI回答了一个化学问题”,会把这些不同工作混在一起。
这组数字也提醒我们保留判断的尺度。336纳米相对369纳米目标偏离了33纳米,这是一个候选分子的目标偏差,不能当作模型在整个测试集上的平均误差,也不能把目标值直接当成模型预测值。
是否接受这个候选,还要看任务预先允许多大的偏差。研究完成了候选提出、合成与测量,值得讨论;它是否达到某项实际应用要求,则需要另外给出标准。单个案例也不足以证明,同一系统能稳定完成其他分子的同类任务。
这个例子说明了语言模型可以怎样参与科研:它能把人的问题接到数据和工具上,使预测过程更容易被调用和检查。科研结果的可靠性仍然取决于每个环节,包括输入有没有传错、预测器是否适用、实验条件是否一致。
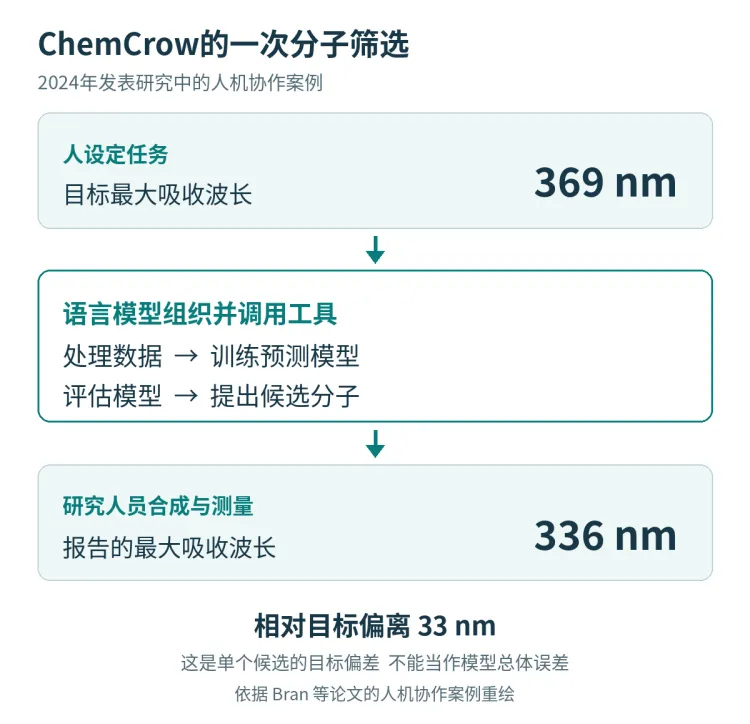
图2 369纳米是设定目标,336纳米是该研究报告的实测结果;33纳米为两者之差。
拿到结果后
该检查到哪一步?
首先检查解释是否忠于来源。论文中的假设、实验发现和作者推断,需要分别表达。引用能定位到原文,比一段听起来完整的解释更有助于复核。
再检查分子表示是否有效。结构字符串能够解析、原子连接符合所用规则,只能说明表示通过了相应检查;它不能证明这个分子稳定、可合成,更不能证明某项性质预测准确。
对于预测数值,要保留模型名称与版本、输入条件、目标定义、单位和独立测试依据。平均误差较小,也不能替一个明显超出训练数据范围的新对象作保证。模型没有提供可靠的不确定性信息时,应把这个缺口保留下来。
最后,让验证程度与用途相称。初步筛选候选,可以先比较模型在相近任务上的表现;若要宣称某个新分子确实具有某项实验性质,就需要相应实验支持。学习计算结果的模型,也应区分“接近参考计算”与“符合实验事实”。
这些判断并不取决于模型被叫作“大模型”“专业模型”还是“多模态模型”。能接收图片,增加了一种输入形式;经过专业训练,可能改善某项任务的表现。它们最终都需要拿出与具体用途相匹配的证据。
下一次看到AI报出一个性质数值,可以先找它背后的记录:这个数来自哪里,针对什么条件,拿什么检验。能沿着记录回到数据、方法和实验,才有条件判断它是否值得用于下一步研究。
[1] Brown, T. B. 等(2020)Language Models are Few-Shot Learners. NeurIPS 33.
用于说明自回归语言模型的预训练与任务评测。
[2] Ouyang, L. 等(2022)Training language models to follow instructions with human feedback. NeurIPS 35.
用于说明指令示范、人类偏好反馈与模型后续训练。
[3] Yang, K. 等(2019)Analyzing Learned Molecular Representations for Property Prediction. Journal of Chemical Information and Modeling, 59(8), 3370–3388.
见Methods、Table 4与Analysis of Split Type。相关模型为D-MPNN;ESOL数据集规模为1,128个化合物。
[3补] Yang, K. 等(2019)Correction to Analyzing Learned Molecular Representations for Property Prediction. Journal of Chemical Information and Modeling, 59(12), 5304–5305.
原论文勘误,阅读模型比较结果时应与原文一并参照。
[4] DeepChem公开数据文件 delaney-processed.csv.
见字段“measured log solubility in mols per litre”。数据源研究:Delaney(2004),DOI 10.1021/ci034243x。
[5] Bran, A. M. 等(2024)Augmenting large language models with chemistry tools. Nature Machine Intelligence, 6, 525–535.
见Human–AI collaboration与图3。作者公开稿可查阅 https://arxiv.org/abs/2304.05376 ,正文报告369纳米目标与336纳米实测结果。