ARTICLE · 1273187
教科书说发光方向改不了,AI用300次实验证明了相反结论
发光二极管照亮了整个世界,却始终没法像激光那样「指哪打哪」——因为自发辐射没有确定的相位,相控阵那套调控波前的办法对它天然失效。要让这类光源变得有方向性,工业界的答案是加透镜、加准直器、加反射杯,用笨重的封装把散开的光「收」回来。这篇论文提了另一条路:不外加光学元件,而是把透镜和光栅直接「写」进发光体内部的空间折射率分布里,并且——这一点更值得注意——这个答案是机器自己找出来的,人类事先并没有想到。
这篇工作同时站在两条互不相干的脉络的交汇处,因此它要解决的问题也是双层的。
物理这一层,讲的是如何控制自发辐射的远场分布。发光超表面由亚波长尺度的光学共振器阵列构成,其中嵌入了发光体(本文用的是 InAs 量子点),是一条被寄予厚望的技术路线。过去几年,人们已经证明:只要在超表面上施加空间周期性的折射率调制,也就是做出一条光栅,就能让发射光偏转到特定角度——其原理与动量匹配一致,光栅提供额外的动量,把原本困在衬底里、处于全内反射之外的光「捞」出来。问题恰恰出在「周期性」这三个字上。一旦折射率分布变成非周期的,现有理论和仿真工具就基本失效了,论文甚至在补充材料里专门用一节来说明这种模型的缺失。于是逆向问题摆在面前:如果我希望光往 30 度方向走,那个最优的空间折射率剖面究竟长什么样?这是一个在 3840 维空间里的搜索问题,解析解不存在。
方法这一层,讲的是自驱实验室(self-driving lab, SDL)本身的困境。SDL 的思路是把机器学习模型接进实验 loop,让算法自主决定下一次实验做什么。但作者指出,现有的 SDL 绝大多数停留在低维问题上——材料的配方、反应的温度与浓度、打印的参数,自由度通常在个位数到几十。原因很直接:当自由度超过 10³ 量级时,数据结构和结果都变得难以解读;而要真正做到高通量闭环,硬件成本又拦在那里。更深的矛盾在于,机器学习极擅长在高维空间里拟合相关性,却拙于外推和解释,在物理科学中往往表现为一个「黑箱」——它能告诉你这个配方好,但说不出为什么好,也无法写成一条方程。既然过去一百年科学研究的成功,靠的正是「提出假设—设计实验—验证—归纳规律」这套可解释的路径,作者提出的假设是:如果把科学方法本身实现成一个机器学习框架,就有可能得到可解释的发现。
这两个卡点在此合流:用一个会解释自己的自驱实验室,去攻克一个没有模型的逆问题。前者提供工具,后者提供试炼场。
整个系统的骨架可以用一句话概括:生成模型负责「想出人类想不到的实验」,主动学习负责「用最少的实验挑出最好的那个」,方程学习器负责「把结果翻译成人能读懂的公式」。三者串在一个真实的超快光学实验闭环上,而不是仿真里。
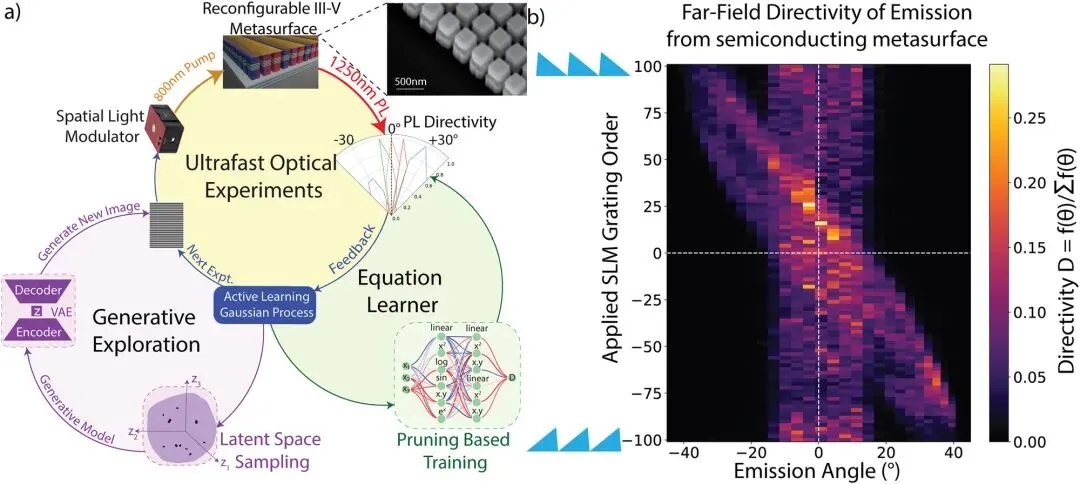
器件是在 GaAs 超表面上外延生长 InAs 量子点,下方配一层反射式分布式布拉格反射镜(DBR)。超表面经过设计,使得反射相位随局部泵浦强度的变化接近 0 到 2π 的完整覆盖——这是它能充当「任意相位元件」的前提。泵浦光源是 800 nm、40 fs、重复频率 1 kHz、能量密度 2–3 mJ/cm² 的飞秒脉冲,它通过自由载流子折射效应瞬时改变超表面共振器的局部折射率;这个改变是可逆的,弛豫时间在皮秒量级。泵浦的强度图样由空间光调制器(SLM)投影到超表面上,于是「一张灰度图」就变成了一片空间变化的折射率分布。发光则用锁相探测器扫描后焦面来采集远场分布,每个数据点重复测量 10 次以取得均值与标准差。
这套安排让问题可以被干净地表述为一个「图像进、图像出」的监督学习任务:泵浦图样是输入,远场强度分布是输出。值得注意的是,SLM 到超表面的成像系统本身会平滑掉超出衍射极限的高频成分,因此即便生成模型「想」出了物理上无法实现的高频图样,投影到器件上时也会自然被滤除——这为后面的实验有效性提供了一层保护。
高维的第一道难关是「实验做不完」。作者援引物理科学中的流形假设:一个表面上需要大量参数描述的复杂系统,其实可以用远少得少的独立参数刻画。落地上就是变分自编码器(VAE):编码器与解码器各用六层全连接网络,把长度 3840 像素的一维泵浦曲线映射到一个四维高斯潜空间。训练目标是标准的 ELBO 损失,由重建项(重建图样与真实图样的 L2 范数)与 KL 散度项(编码器学到的后验分布与标准正态先验的差异)组成。训练集共 5 万条一维图样,既包括基于光栅级次的周期图样,也包括含多频率成分以及线性、二次曲线的非周期图样。
这里有个容易被忽略但很关键的验证:作者用局部斜率分布来量化 VAE 的生成能力,发现它生成的泵浦图样在多样性上超出训练集(即当时的最先进水平)两个数量级。这等于说,模型不是在做插值式模仿,而是真的开出了一片人类没探索过的图样空间。后续的事实也印证了这一点——最优解并不在训练集里。
潜空间里的每一个点对应一条泵浦曲线,也就对应一次真实实验。主动学习要做的,是在有限预算下决定先做哪一次。具体做法是用高斯过程对「潜空间坐标 → 指向性」建模,输出预测值与不确定度;再用期望改进(Expected Improvement)作为采集函数挑选下一个实验点,其形式是在当前最优点的基础上最大化预测改进量的期望,从而在探索与利用之间取得平衡。工程上用 Ax 框架实现,初始数据集为 100 个 Sobol 采样点,随后最多执行 1000 次实验。
一个细节体现了这套系统的「实验感」:它并没有把测量当作无噪声的标签,而是把不确定度显式地喂进模型。指向性的相对误差由两部分合成——泵浦功率误差(含调制与激光测量)与探测器热噪声,按 ΔD/D = √[(ΔP/P)² + (ΔS/S)²] 计算。这让代理模型知道哪些点「测得不准」,从而避免被噪声误导。
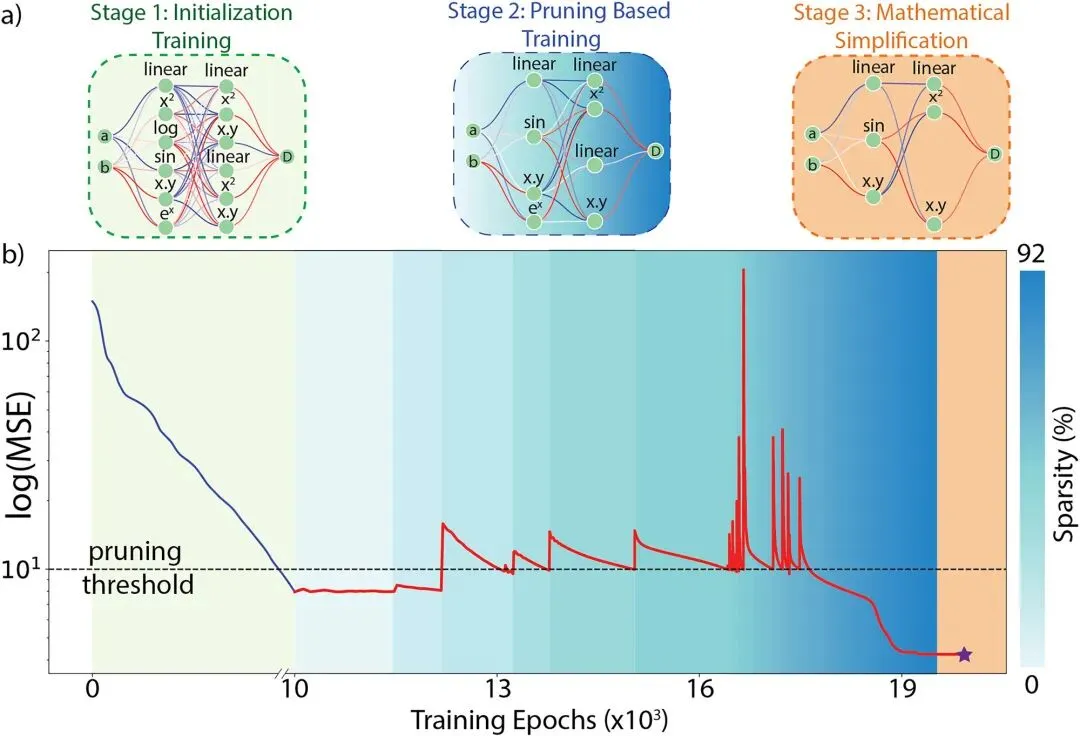
系统里最「反潮流」的一环是神经网络方程学习器(nn-EQL)。在深度学习普遍追求更大更深的时候,它追求的是可读。网络只有两层,激活函数不是 ReLU 或 GELU,而是一组从物理公式里借来的初等函数:sin、cos、exp、x²、乘积、对数。训练分三步走:先做一次完整拟合,把误差压到可接受水平;然后进入剪枝阶段,按「贡献度」逐个剔除最不重要的神经元——贡献度定义为权重值与上一层激活值的乘积,而非权重的绝对值,这是为了照顾 cos 这类非单调激活函数;剪到 90% 以上稀疏度、且损失不再上升为止;最后用 Sympy 之类的符号计算工具把剩下的网络「读」成一条人类可读的方程。
如果把这篇论文的贡献理解为「用 AI 把器件性能又刷高了一点」,那就完全错失了它的重点。它的价值分布在四个层次上,且逐层递进。
第一层是平台层面的整合。VAE、主动学习、方程学习这三样东西单独拿出来都不新鲜,但把它们串成一条闭环、并且闭环的另一端接的是一台真实的飞秒光学装置而非数值仿真,这在此前的纳米光子学工作里并不多见。作者在计算资源的调度上也做了务实安排:主动学习与方程学习跑在一台配四块 Tesla V100 的本地机器上,实验仪器则由另一台实验室计算机通过 Python API 控制,计算与测量解耦。
第二层是方法论上的分工。三个模块各自对应 SDL 的一个瓶颈——高维输入、实验成本、可解释性,形成了一种「生成负责想象力、主动学习负责经济性、方程学习负责可理解性」的结构。这不是简单堆叠,因为生成模型恰恰为主动学习提供了可搜索的低维流形,而主动学习产出的高价值样本又恰好落在方程学习器能够拟合的范围内。
第三层,也是最核心的一层,是物理上的新自由度。传统方案里,「转向」这件事只由折射率的空间梯度(一阶导,对应光栅项 b)负责,因为动量匹配只看这一项。而这套系统找出来的最优解,普遍带有显著的空间曲率(二阶导,对应透镜项 a)。也就是说,除了「往哪个方向推」,还可以「怎么弯」——后者被证明对远场指向性有一阶量级的影响。作者对此的表述很克制:这是一个此前未被认识的结构—性能关系。
第四层是性能。在不增加任何封装、不引入任何笨重光学元件的前提下,器件本身的发光指向性达到 67%,并能在 74° 视场内连续转向。作者指出这个数字在经典静态 LED 中属于最高之列,而后者通常要靠反射透镜和准直器才能做到同等的准直度。
作者没有一上来就放大招,而是先做了一次「能力体检」:让主动学习在已知的空间里搜索,看它能不能重新发现人类已知的最优解。答案是肯定的——在光栅级次这个单参数空间里,代理模型用比暴力扫描少一个数量级的实验次数,就找到了给定转向角下的最优级次。这一步的意义在于排除「优化器本身失效」这种低级失败,为后面的高维搜索建立了信誉。
随后才是真正的考试:把搜索空间换成 VAE 的四维潜空间,并且不提供任何先验知识——不给 VAE 的结构信息、不给噪声模型、不给历史结果。在两个方向(+26.6° 与 −26.6°)上各自跑 300 次闭环迭代。
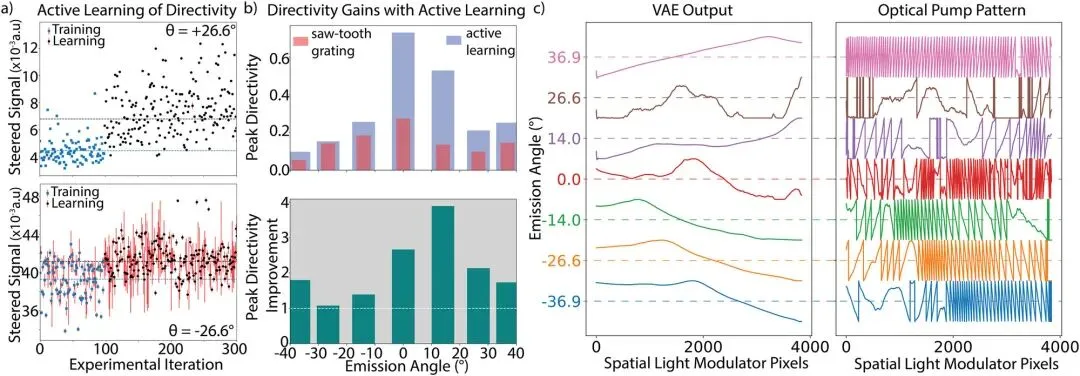
定量结果可以这样归拢:相对于当时最先进的锯齿光栅方案,各角度上的绝对指向性平均提升 2.2 倍,在 14.4° 处达到峰值收益 3.77 倍;绝对指向性峰值为 67%;整个优化在 约 300 次闭环实验内完成,覆盖 74° 视场。此外,学到的图样不含超出系统衍射极限的高频成分,这意味着它不是靠「作弊」式的高频噪声骗取指标,而是给出了一个物理上可实现、可复现的方案。
值得注意的是,图 1b 本身就是动机的一部分。在锯齿光栅下,一部分发射确实按动量匹配的预测移动了,但另一部分留在原地,形成 ±14° 的残余亮带。这个「不听话的部分」正是作者判断现有原理不完备的实验依据,也构成了后续用机器学习去补全的出发点。
肉眼看出曲线像抛物线,不足以构成科学结论。作者因此做了两级统计检验。第一级是 Spearman 秩相关系数,在 1 万条 VAE 生成曲线上平均,考察潜空间四个维度 z₁–z₄ 与四个物理特征之间的关系——空间曲率 a、空间梯度 b、平均泵浦强度 A、最大空间频率 ω。结果呈现出一种耐人寻味的格局:潜空间各维之间几乎完全正交(非对角块接近零),而它们与任一物理特征的单变量相关性普遍偏弱,只有 z₄ 与曲率、z₃ 与平均强度出现了中等强度的关联,z₄ 与最高空间频率之间也有一定耦合。
单变量弱相关,恰恰是第二级检验要解决的问题。作者引入 Sobol 敏感性指数,把「一个变量单独变化的影响」(一阶指数)与「该变量参与各种组合时的影响」(总阶指数)区分开来。对比结果非常鲜明:所有维度的一阶指数都很低,但总阶指数在曲率上达到 0.7–0.9,在梯度上 z₄ 也接近 0.7。这解释了一个表面上矛盾的现象——没有任何单一潜变量能决定指向性,但若干变量的组合可以。作者据此判断,主动学习找到的不是散落的若干好点,而是一个「高性能相关子空间」,且这个子空间与物理量之间存在可解释的对应关系。
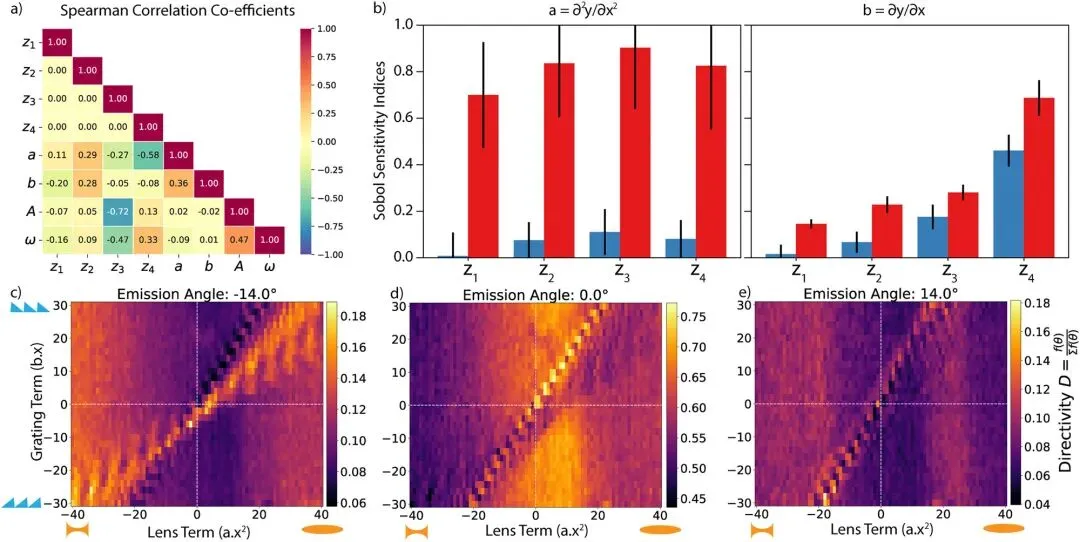
为验证统计结论而非停留在相关性层面,作者沿 a 与 b 两个轴做了一次完整的参数扫描,直接测量指向性。结果按象限呈现出强烈的对称破缺,而这正是全文与经典光学分歧最大的地方。
第一象限(正透镜 + 正光栅)能高效转向;第三象限(负透镜 + 负光栅)同样能覆盖完整视场。这两个象限的组合在性能上被作者判定为彼此等效。而如果按照傅里叶光学的直觉,人们会预期「正透镜先准直、再由光栅偏转」是最自然的方案,也就是正透镜配负光栅——但实验显示,这个第四象限的组合完全丧失了转向能力,对任何角度都无效;第二象限同理。更让人意外的是第三象限:一个发散性的负透镜,按常理只会让光更散,除非光源本来就是会聚的;但在这里,凹透镜加上额外的负级次光栅,却能把光稳稳送到远场指定方向。
对这种现象,作者给出的解释是倾向于物理机制而非数学巧合的:衬底中可能存在多条被俘获的发光通道,它们可以通过不同路径被耦合到自由空间,并沿测量方向输出;正负两种组合或许各自对应了其中一条通道的匹配条件。但作者本人也明确承认,要确认这一点还需要对系统做进一步建模。这句话很重要,它是全文最诚实的一处自我限定——象限不对称是被观测到的事实,其微观成因仍是开放的。
从这些扫描中,作者提炼出关于 0° 转向的一条方程:
这条式子之所以值得一提,不是因为它的精度,而是因为它的可读性:前项 0.18(a − 0.033b)² 直接写明了对空间曲率的二次依赖,正弦项则抓住了数据中周期性起伏的行为。对其它转向角重复同样流程,可以得到一组方程,它们共同构成一个描述该超表面发光的现象学母方程的一个子集。横向比较这组方程会发现一个稳定的趋势:随着转向角从 −36° 走到 +36°,使发光最大化的最优 a/b 比值在单调上升——这为「曲率是一个独立且连续可调的自由度」提供了又一层证据。
这篇论文的说服力很大程度上来自作者对自身局限的坦率。把这些限制梳理清楚,比记住那几个倍数更有价值。
其一,这是局部最优,不是全局最优。作者在正文中两处明确声明:受实验预算所限,主动学习达到的指向性极大值只是局部极大值,而非优化问题的全局解。这意味着 67% 这个数字是「在 300 次实验内能做到的最好」,而不是「这个器件物理上的天花板」。换一种初始化、换一个采集函数、换一条采样路径,很可能到达别处。
其二,控制维度其实只有一维。VAE 生成的是长度 3840 的一维曲线,随后沿正交方向重复 2160 次铺成 3840×2160 的图像投影到器件上。这个「重复」操作意味着折射率分布在纵向是均匀的,因此系统只能在一维平面内左右转向,无法同时控制方位角,也无法实现真正的二维聚焦或任意波前整形。论文中所说的「任意远场控制」,实际达成的是「任意一维转向角」,两者之间还有相当距离。
其三,方程是现象学的,不是第一性原理的。式 (1) 及其同类,本质上是对「输入特征 → 指向性」这一映射的紧凑拟合,它建立在四维潜空间与四个手工定义物理特征(曲率、梯度、平均强度、最高频率)的对应之上。它能告诉你 a 和 b 怎么配比,却不能从麦克斯韦方程组推导出为什么。配合前面提到的「象限不对称机制尚待建模」,可以说这套系统提供的是一种高度结构化的经验规律,其解释力强于黑箱,但仍弱于理论。此外,方程的有效范围大致限于 ±36° 的转向角与这一特定器件,跨器件的迁移性尚无验证。
其四,论文内部的数字口径并不完全统一。摘要把成果概括为「峰值指向性最高提升约四倍、达 77%,覆盖 74° 视场,约 300 次实验」;引言中则表述为「相比最先进器件提升一个数量级,在 80° 宽视场内达到 67%」;而正文实验部分给出的平均值是 2.2 倍、峰值 3.77 倍、绝对值 67%、视场 74°。这几组数字各自有其参照对象(77% 与 67% 的差别可能源于是否把未转向的残余计入分母,80° 与 74° 的差别则对应器件能力与优化覆盖范围),但读者若只取摘要,容易得到偏乐观的印象。引用时以正文数据为准更稳妥。
至于未来方向,作者给出的路径是方法论外溢:既然这套「生成—选择—解释」的框架并不依赖具体材料,它有理由被搬到其它物理科学问题上,用来突破人类直觉与既有理论框架的束缚。从更具体的角度看,这条路线接下来要回答的至少有三件事——把一维图样扩展到二维以实现完整的波前控制;把曲率项写进正向设计工具与仿真器,让「透镜 + 光栅」成为可被常规光学设计流程调用的元件;以及在闭环里加入光谱与时间分辨信息,让优化目标从单一的指向性扩展到效率、带宽与调制速度的多目标权衡。数据与代码均已公开(Zenodo 与 GitHub),这些工作并不存在获取门槛。
如果只从这篇论文里带走一句话,或许不是「AI 让 LED 更亮了」,而是:当搜索空间足够大、人类直觉的覆盖范围又足够窄时,让机器去提假设、做实验、写方程,可能比让人类去猜更有效率。而真正让这个结论站得住的,不是 67% 这个数字,而是那条能被抄在纸上的 ax² + bx——它把一次「黑箱的胜利」变回了一个可以被讨论、被质疑、被继续推进的物理命题。
论文全文:
https://www.nature.com/articles/s41467-025-66916-0