ARTICLE · 1293065
美国教育系统人工智能工具采用状况:分层图景、应用场景与制度落差——一项基于2026年公开资料的阶段性文献汇编
美国教育系统人工智能工具采用状况:分层图景、应用场景与制度落差
——一项基于2026年公开资料的阶段性文献汇编
说明
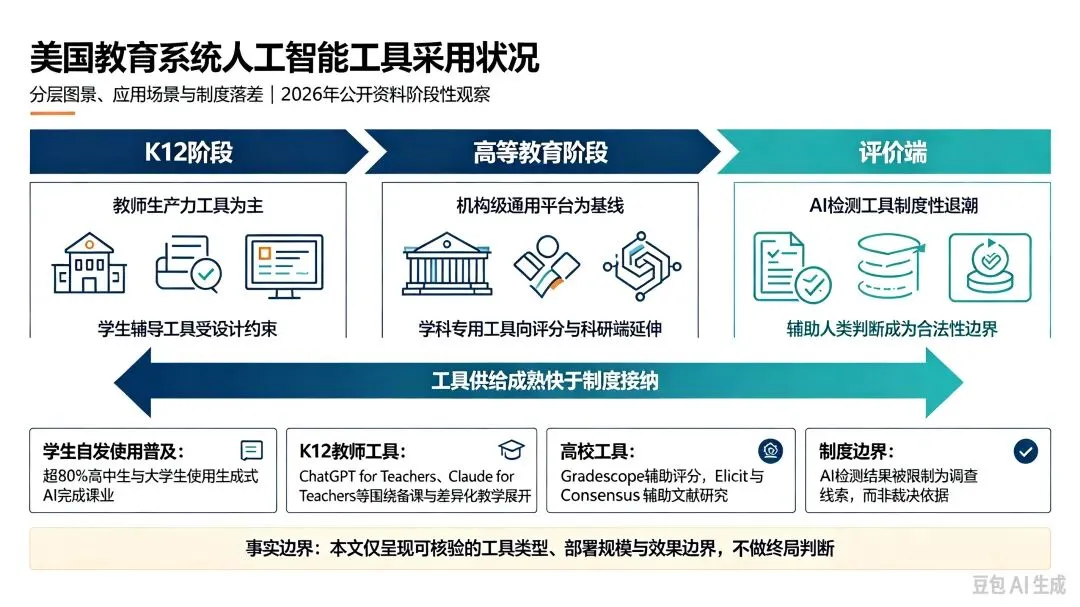
本文为阶段性事实汇编,按学段与功能场景,系统梳理美国教育系统人工智能工具的实际采用状况。汇编整合截至2026年10月公开可核验资料,包含联邦/州政策文件、高校官方公告、同行评议研究、NBER工作论文、权威教育媒体报道。
核心限定:学生自发使用生成式AI已高度普及,但制度化嵌入课程、评价体系的进度不均衡,州际、校际差异显著。本文不做“终局性判断”,仅呈现可核验的工具类型、部署规模、公开披露数据与已识别的效果边界;凡涉及具体产品,均标注产品名称,便于后续对照核验与修正。
目录
一、引言:工具供给的成熟度与制度接纳的节奏落差
二、学生自发使用与制度覆盖之间的结构性缺口
三、K12阶段:教师生产力工具为主体,学生辅导工具受设计约束
四、高等教育阶段:机构级通用平台为基线,学科专用工具向评分与科研端延伸
五、评价端:AI检测工具的制度性退潮
六、效果边界:可获取证据所显示的限制
七、参考文献
一、引言:工具供给的成熟度与制度接纳的节奏落差
美国教育系统对人工智能的采用并非单一同步进程。以工具类型作为观察单位,可以识别出清晰的产品分层结构:K12阶段以教师生产力工具为主,学生端辅导工具在多数部署方案中被刻意设计为“引导式、不直接输出答案”;高等教育阶段以机构统一采购、全校分发的通用大模型平台作为基础配置,并叠加作业评分、文献研究等学科专用工具,向教学与科研环节延伸;评价端的AI文本检测工具,则因为准确性缺陷与制度纠错,出现明显收缩。三层演进并不同步,工具供给成熟速度显著快于配套制度规则的形成,形成可观测的制度落差[1][2]。下文按该分层展开。
下表按使用主体、应用目的分类梳理美国教育场景下AI工具的部署情况,所有内容均来自可核验公开资料,仅记录现状,不做趋势预判与价值评判。
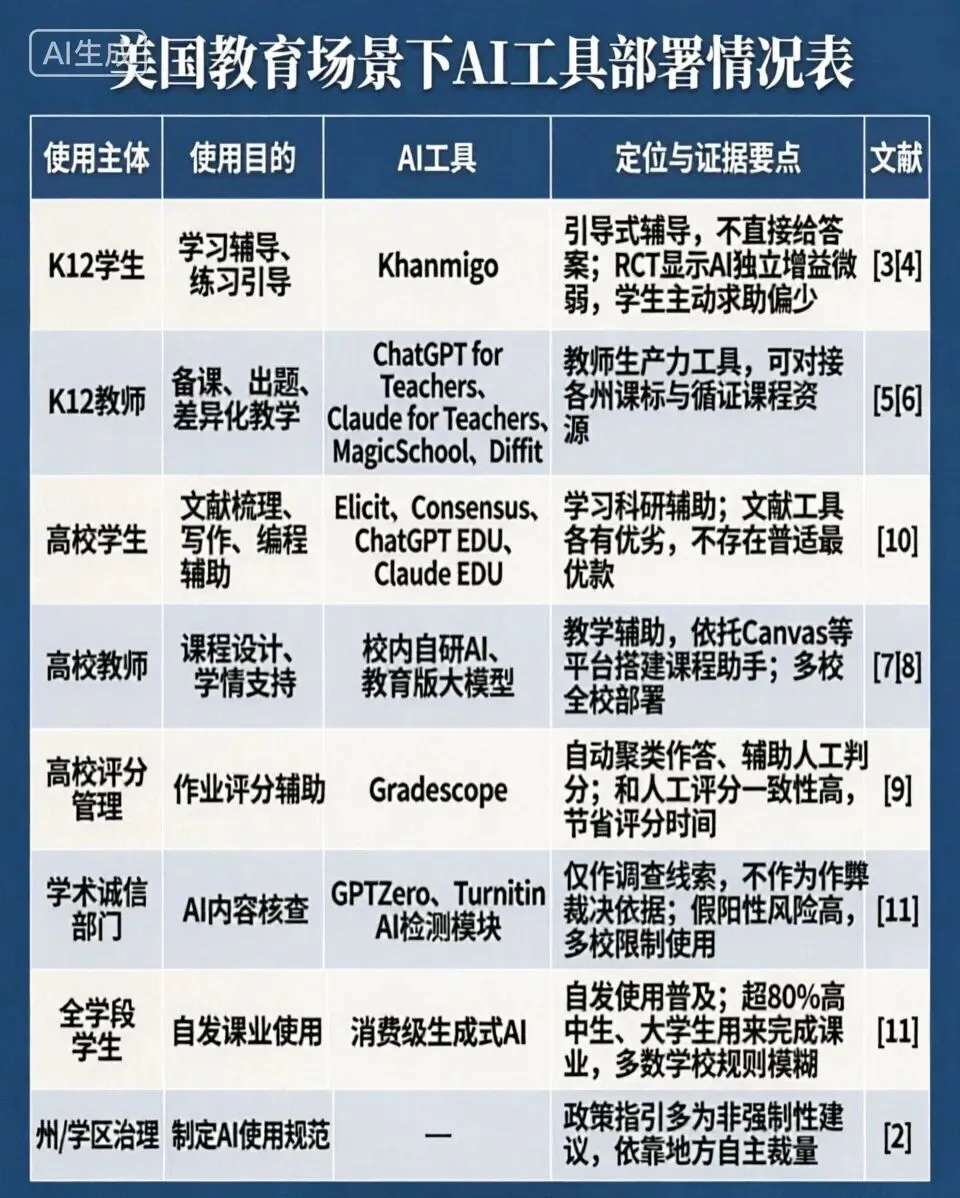
表注:本表汇总美国K12至高等教育阶段AI工具应用场景与实证证据,仅呈现可核验事实,不做价值判断;编号对应文末参考文献清单。
二、学生自发使用与制度覆盖之间的结构性缺口
学生端自发使用行为已经接近饱和,但制度覆盖并未同步跟进。斯坦福HAI《2026 AI Index Report》教育章节指出:超过80%美国高中生与大学生已经使用生成式AI完成课业相关任务;仅约半数初高中制定成文AI政策,其中仅6%教师认为校内AI规则清晰、具备可执行性。学生主要用途为检索资料、作文修改、头脑风暴、概念理解,并非系统性替代完整学习过程[1]。
州级政策文件数量持续增加,但普遍约束力有限。CRPE针对20个早期采纳州的专项审查显示:20州之中,16州发布的AI指导文件全部属于非约束性指引,学区实践仍然高度依赖地方自主裁量,也就是美国传统地方分权(local control)模式;仅有少数州(如俄亥俄、田纳西)通过立法,要求学区自行制定AI使用政策,突破纯指引性质[2]。该格局意味着,绝大多数K12场景下,AI既没有被全面禁止,也尚未被正式纳入教学与评价的核心制度主线。
三、K12阶段:教师生产力工具为主体,学生辅导工具受设计约束
K12最突出结构特征:面向教师的生成式AI工具,在部署规模、功能成熟度上,已经超过面向学生的教学辅导工具。教师端工具栈围绕四类任务组织:备课、差异化学习材料生成、评分反馈、课堂运营,并非单一全能产品。
Khanmigo是同时覆盖学生端与教师端的代表性产品,但其严格随机对照试验揭示了关键效果限制。学生端采用苏格拉底式引导辅导:数学、科学题目不直接给出答案,通过交互式提示引导学生自主推导;写作模块作为教练,从提纲到终稿提供反馈。
核心实证:田纳西州Hamilton County 18所初中,为期两个学年的整群随机对照试验(NBER工作论文 One Click Away: AI Tutoring with Khanmigo in a Two-Year School Experiment):96%学生至少尝试过一次Khanmigo,但中位学生仅在约1/3练习日使用;错题练习会话中仅17%学生会主动向AI发送消息;学生发送消息大多只是直接答案或点击预设提示,仅很少部分包含实质性数学推理。试验测得每学期数学成绩提升1.3个全国百分位,全年效应量约0.06–0.08个标准差,全程高参与子组效应量0.14 SD;研究作者明确指出,该增益与原版Khan Academy纯练习平台的增益相近,AI辅导层没有产生独立的额外显著增益,核心瓶颈是学生求助行为(help-seeking)不足,而非模型本身能力不足[3][4]。
教师通用工具中,ChatGPT for Teachers是覆盖面最广产品。OpenAI将其定位为独立于消费版ChatGPT的教育工作空间,承诺教师数据不用于模型训练,功能聚焦备课、命题、代课材料、差异化任务设计。截至2026年8月,该项目覆盖美国30个州、100余家K12机构,服务超过30万名教育工作者;对认证K12教师免费开放至2028年6月;本轮新增55个学区合作方,包含全美20个最大公立学区中的五分之一[5]。
Claude for Teachers于2026年7月正式推出,差异化设计是通过Learning Commons连接器接入美国全部50州学术课程标准,以及标准之下的前置技能层级,并对接OpenSciEd、Illustrative Mathematics等循证课程资源;同时支持与ASSISTments、Brisk Teaching、Diffit、MagicSchool等既有K12教学工具互操作[6]。
其余细分K12专用工具功能边界更窄:MagicSchool提供80余项教师专用功能与聊天机器人Raina,北卡罗来纳州2026年预算列入250万美元专项支持;Brisk Teaching以浏览器插件形式嵌入Google Docs、Slides,在原有办公工作流内完成反馈、改写、分层,官方披露使用教师超过60万;Diffit专注单篇教学材料,一键生成多阅读难度层级版本。
四、高等教育阶段:机构级通用平台为基线,学科专用工具向评分与科研端延伸
高等教育AI采用已经越过个别教师自发试用阶段,进入机构统一采购、全校分发模式。多所大学技术栈呈现趋同特征:同时部署多款主流大模型平台,并且把AI素养模块作为访问前置条件或配套要求。
UT Austin(德州大学奥斯汀分校) 是典型案例:教务长办公室维护《AI for Teaching & Learning Toolkit》,向全体师生免费提供Claude EDU、ChatGPT EDU、Microsoft 365 Copilot;同时部署校内自研UT Sage,教师可在Canvas学习管理系统内,基于课程内容创建学科专属AI辅导机器人[7]。
加州州立大学系统(CSU)与OpenAI合作,是目前规模最大的全机构部署之一:通过ChatGPT EDU,为23个校区约46万学生、6.3万教职工开放访问权限,是全美首个全系统部署ChatGPT Edu的公立大学系统[8]。
圣路易斯华盛顿大学工具栈包含Claude EDU、Gemini、Gemini Notebook、Copilot Chat以及校内自研AskWashU;学生访问Claude前,必须完成校内AI素养课程模块。斯坦福大学自2026年6月30日起,面向全体教职员工、学生、博士后开放ChatGPT EDU,同时提供Google Gemini Enterprise与Claude for Education。
评分专用工具代表为Gradescope:核心AI能力并非自动打分,而是答案聚类分组——对手写/纸质作业相似答案自动聚类,教师只需对一组样本判定,批量应用到整组。一项2026年对照研究,以本科数学三门课程6922份作答为样本:Gradescope与人工评分精确一致率99.91%,99.95%分数落在±5分区间;平均评分时间节省22.2%,在计算密集型工作表场景最高可达35.1%。研究明确界定定位:AI是辅助人类评分者,不能替代教师最终判断,完整功能需要机构授权许可[9]。
科研文献端,Elicit与Consensus在2026年工具评估文献中被确认分工:Elicit面向结构化文献综述工作流,检索海量论文与临床试验记录,支持提取研究方法、研究发现、跨文献对比;Consensus聚焦从同行评议文献提取直接结论、汇总证据一致性,定位快速证据核查,而非完整综述生产。发表于《Canadian Journal of Information and Library Science》2026年第49卷的混合方法研究,对Elicit、SciSpace、Consensus系统比较,结论为三类工具各有优劣,不存在普适最优工具,适用性取决于研究类型;美国多所高校图书馆已经将两款工具纳入师生AI科研工具导引[10]。
五、评价端:AI检测工具的制度性退潮
与教学、科研端工具制度化推进相反,AI文本检测工具在2026年出现明确制度收缩。Inside Higher Ed 2026年8月报道记录多项证据:OpenAI、Writer、Copyleaks、GPTZero、CrossPlag等检测工具,多项独立研究证实结果不稳定,对人类原创文本产生假阳性,并且对非英语母语写作者存在系统性偏见;部分假阳性误判已经引发学生起诉大学。耶鲁、范德堡、约翰斯·霍普金斯、印第安纳大学出台学术诚信政策,禁止把AI检测结果作为认定作弊的唯一证据;至少十余所高校,包括西北大学、乔治城大学、纽约大学,直接停用Turnitin内置AI检测模块,该模块实际假阳性率显著高于厂商最初披露水平。Turnitin官方也将AI检测结果定位为调查起点、参考线索,不是最终判定证据[11]。
该退潮的制度含义在于:AI检测工具始终没有获得和Gradescope评分辅助、Elicit文献工具同等的制度合法性。后者以“辅助人类判断”为设计前提并被纳入机构工具包;检测工具则被制度性地从“裁决工具”降级,甚至直接清退。
六、效果边界:可获取证据所显示的限制
严格实证研究呈现一致信号:工具可及性,不会自动转化为学生使用;学生使用,也不会自动转化为学习增益。Khanmigo田纳西整群随机对照试验是典型例证:高可及性条件下,学生主动求助行为仍然非常有限,学习增益主要来自结构化练习本身,并非AI辅导独立效应,作者将约束归结为求助行为(help-seeking),不是模型能力缺陷[3]。Gradescope的证据从另一维度印证:高评分一致性、时间节省,是建立在“AI辅助人类评分者”制度安排下实现,脱离教师最终判断则不成立[9]。
该格局和制度观察互相印证:工具供给扩张,并没有同步改写教学、评价、科研治理底层规则;在绝大多数场景,AI仍然是可选辅助、受约束的增量工具,尚未替代原有教育体系主线。
七、参考文献
[1] Stanford HAI. (2026). 2026 AI Index Report, Chapter 7: Education and Skills. Stanford Institute for Human-Centered AI. https://hai.stanford.edu/ai-index/2026-ai-index-report/education
[2] Harrison, D., & Dusseault, B. (2026). States and AI: An Early Look at How States Are Approaching AI in Education. Center on Reinventing Public Education (CRPE).
[3] Oreopoulos, P., & Low, N. (2026). One Click Away: AI Tutoring with Khanmigo in a Two-Year School Experiment. NBER / EdWorkingPapers, AI26-1551.
[4] Stanford SCALE Initiative. (2026). One Click Away: AI Tutoring with Khanmigo in a Two-Year School Experiment. SCALE Initiative, Stanford University.
[5] OpenAI. (2026, August 26). Bringing ChatGPT for Teachers to more U.S. school districts. OpenAI Official Blog.
[6] Anthropic. (2026, July 14). Introducing Claude for Teachers. Anthropic News.
[7] University of Texas at Austin, Office of the Executive Vice President and Provost. (2026). AI for Teaching & Learning Toolkit: Tools.
[8] California State University. (2025). CSU Announces Landmark Initiative to Become Nation’s First and Largest AI-Empowered University System. CSU Chancellor Office; OpenAI. (2025). OpenAI and the California State University system bring AI to 500,000 students & faculty.
[9] Chiang, S. L. (2026). Comparative Effectiveness of AI Tools in Enhancing Feedback Quality and Efficiency in Undergraduate Mathematics Assessments.
[10] University of Washington, Information School. (2026). Assessing the effectiveness of AI tools (Elicit, SciSpace, and Consensus) in literature review and research. Canadian Journal of Information and Library Science, 49(1), 99–111.
[11] Bush, K. (2026, August 5). AI detectors are out, new approaches are in. Inside Higher Ed.
整理者:张铁光教授,剑桥大学博士,国际教育研究者