ARTICLE · 1294025
AI 模型到底谁更强?从 AA v5 榜单聊聊评测与实际应用
最近,Artificial Analysis 发布了 Intelligence Index V5。
这次升级不只是榜单换了几个名次,而是连评测体系也进行了调整:新增两套评测、升级三套评测,四大能力类别统一调整为各占25%。与此同时,60%的综合指数权重已经来自使用私有测试集或保留答案的评测。
以前我可能只是大概的看一下最新的榜单是什么样子的,具体的评测逻辑没有深入的研究过。本周结合V5的发布,想通过这篇文章,从最新榜单出发,一层一层拆解下 Artificial Analysis V5 背后的评测体系。
一、先看榜单:V5发布后,哪些模型排在前面?
截止20261101最新数据
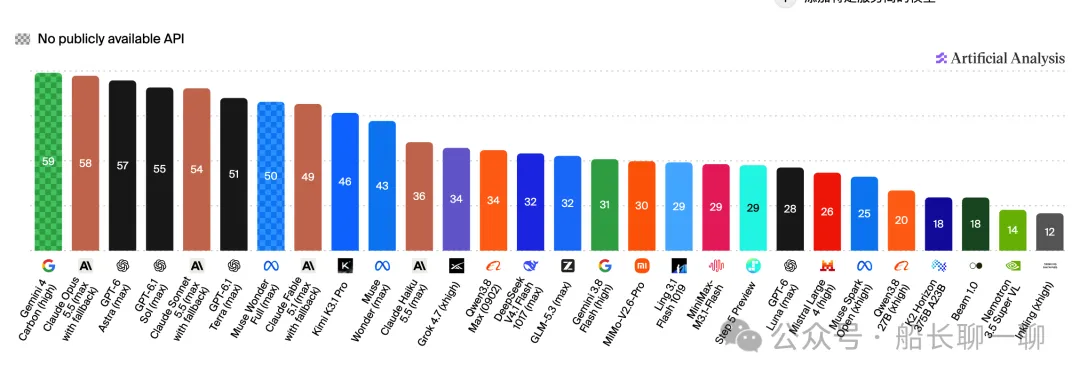
从这组数据中,可以先观察到一些个现象。1、谷歌又把第一拿回来了****Gemini 4 Carbon 以 59 分登顶。不过目前它还没有全面开放。
2、开源模型和闭源模型差距拉大****这次更新后,Kimi K3.1 Pro 的排名下滑,开源权重模型与头部闭源模型的分差也明显扩大。 此前差距只有几个点,现在已经到了两位数。 这说明,在复杂编程、科学研究和长程智能体任务上,头部闭源模型仍然有明显优势。
二、Artificial Analysis Intelligence Index 到底是什么?
首先 Artificial Analysis 是一家专注于人工智能模型评测与分析的平台。Artificial Analysis 的** Intelligence Index**也就是我们常说的“AA智能指数",它表示对跨任务模型能力的综合衡量,反映了当今现实世界的使用情况。
Artificial Analysis的工作不只是给大模型排个名,而是从多个维度评估AI系统,包括:
智能与质量: 模型能否完成知识、编程、科学等任务。
速度与性能: 模型生成答案有多快,用户需要等待多久。
价格与成本: 完成任务需要花多少钱。
实际使用体验: 通过API调用模型时,用户实际获得的性能如何。
官方还会对闭源模型和开放权重模型进行测试,并将不同类型的评测结果分别呈现。
这里有一个容易混淆的概念。Artificial Analysis 的 Intelligence Index,并不是整个网站唯一的榜单,而是其中专门用于综合比较大语言模型能力的一项指数。不能把 Intelligence Index 的排名直接理解为一个模型在所有AI能力上的排名。
它是怎么给模型打分的?
要想更好的理解它的打分逻辑,可以参考官方的评测方法论,篇幅问题就不详细展开了,后面有时间也会单独总结下。
简单理解分为以下四步:
第一步:设计或选取评测任务。
不同任务用于测试不同能力,例如修改代码、执行软件操作、分析科学问题,或者回答知识问题。
第二步:让不同模型完成相应任务。
根据评测设计,模型可能只需要输出一个答案,也可能需要调用工具、运行代码、操作终端,最终提交完整的任务结果。
第三步:按照预先定义的规则评分。
有些任务可以通过程序检查结果是否正确;有些任务需要依据评分标准,由评判模型比较结果;还有一些任务要求多个检查条件全部通过。
第四步:把不同评测结果整合成综合指数。
V5采用四大能力类别的加权结构,再根据各项评测在类别中的权重计算最终得分。
这里需要注意:不同评测的原始分数并不一定采用相同的计量单位。
例如,代码任务可能采用通过率,知识工作任务可能采用Elo评分,而知识准确性任务可能采用正确率与幻觉率。
因此,不能直接把某个模型在一项评测中的80分,与另一项评测中的60分进行横向比较。
最终的 Intelligence Index 是经过既定方法整合的综合指标,而不是所有原始成绩的简单算术平均。
其中的指标计算口径简单了解下,便于综合衡量在不同场景下模型的选择。
每任务成本: 完成一项 Artificial Analysis Intelligence Index 任务的加权平均成本(美元)。计算方式为:将输入 token、缓存 token 和输出 token 的价格分别乘以整个工作负载中消耗的相应 token 数量,按然后按一定规则加权,再除以任务数量。
每任务耗时: 完成一项 Artificial Analysis Intelligence Index 任务的估算加权平均耗时。
首 Token 延迟: 从向服务或系统发送请求到接收到响应的第一个 token 所经过的时间(秒)。对于会返回推理 token 的推理模型,这里指第一个推理 token。
首个答案 Token 延迟: 从向服务或系统发送请求到接收到响应中第一个答案 token 所经过的时间(秒)。对于推理模型,该 token 出现在任何“思考”时间结束之后。
输出速度(每秒输出 token 数): 在收到第一个 token 之后,平均每秒接收到的 token 数量。
生成 100 个输出 Token 的总响应时间: 生成 100 个输出 token 所需的秒数,基于 TTFT 与输出速度合成计算,以确保最大的可比性。
端到端响应时间: 接收完整响应所需的总时间,包括输入处理时间、模型推理时间和答案生成时间。
缓存命中率: 可缓存输入 token 中由服务商提示词缓存提供的比例,以服务商 API 在多轮智能体编程会话中报告的数据为准。我们根据每个端点的近期测量结果报告其代表性缓存命中率。
平均推理 Token 数: 推理模型在给出答案之前输出“推理”token 所花费的时间。
三、V5版本的核心:四大类别各占25%
这次升级最重要的变化之一,是将综合指数划分为四个类别,每个类别占25%。
在此之前,许多人看大模型排行榜,最关注的可能是数学考试、知识问答和编程题的成绩。
但V5的设计明显更加重视实际任务的完成情况。
例如:
能不能把一份资料整理成完整的分析报告?
能不能在现有软件项目中修复一个复杂Bug?
能不能使用终端完成一套科学研究任务?
当模型不知道答案时,能不能避免编造?
这些问题分别对应四大类别中的不同评测。
接下来,我们就按照这个顺序逐一拆解。
四、第一类:知识工作,占综合指数的25%
知识工作类别包含三套评测:
这三项分别测试AI的知识工作能力、软件操作能力和长文档理解能力。
1. AA-Briefcase:AI能不能完成一份真正的工作成果?
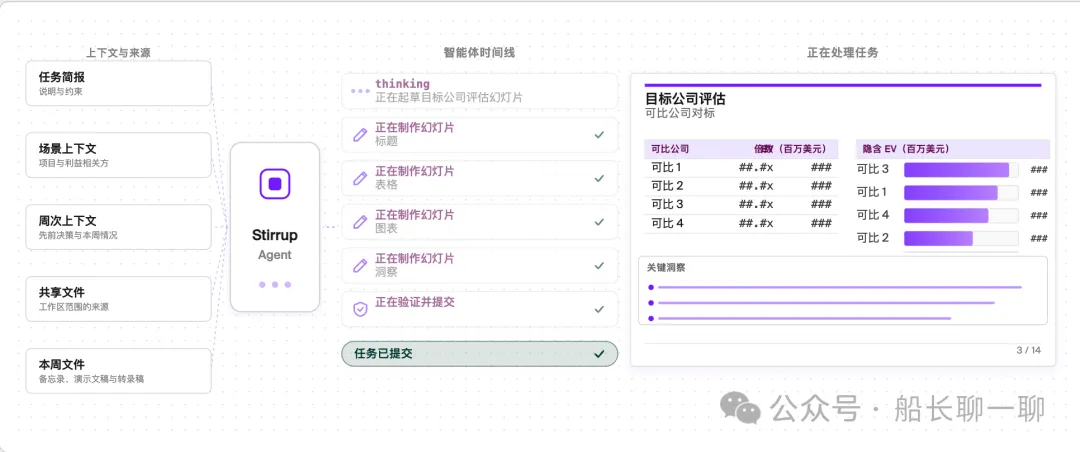
AA-Briefcase v1.1(Agentic Knowledge Work Benchmark):是 Artificial Analysis 自行开发的智能体知识工作评测,它一共分为4大场景, 91 项任务,与传统的问答测试不同,在不同场景中,模型必须完成真实的专业工作流程。每项任务都需要生成成果,并依据检查项量表进行评分。
数据集结构:
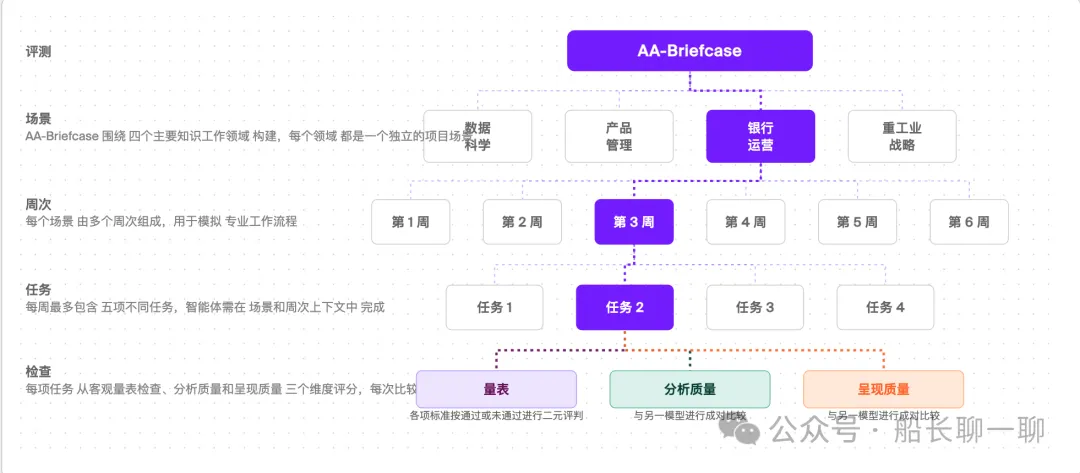
任务内容:模型面对的是需要完成的工作任务,最终需要提交相应文件,而不是只输出一段文字,
举个例子:如果让AI分析一家公司,最终结果可能需要包含数据处理、分析结论和完整的交付文件。
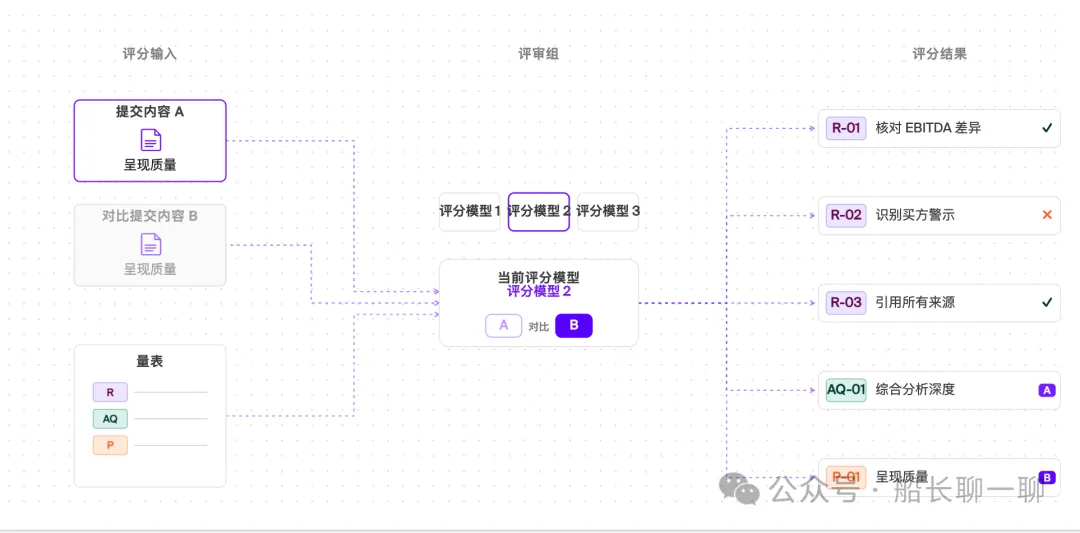
一个模型可能能够写出漂亮的结论,却没有正确处理原始数据。另一个模型可能分析正确,但报告结构混乱,难以交给同事使用。AA-Briefcase试图将这些因素都纳入评估,这类测试的价值在于:它不只看AI说得对不对,还看AI交付的工作成果好不好。
提交的任务产物示意如图(来源官方案例):
评分与记分:
官方采用综合Elo评分,将任务完成情况、分析质量和呈现质量结合起来。评分与记分如下:
各个模型在该基准下的表现(截止20261101):
AA-Briefcase Elo下,
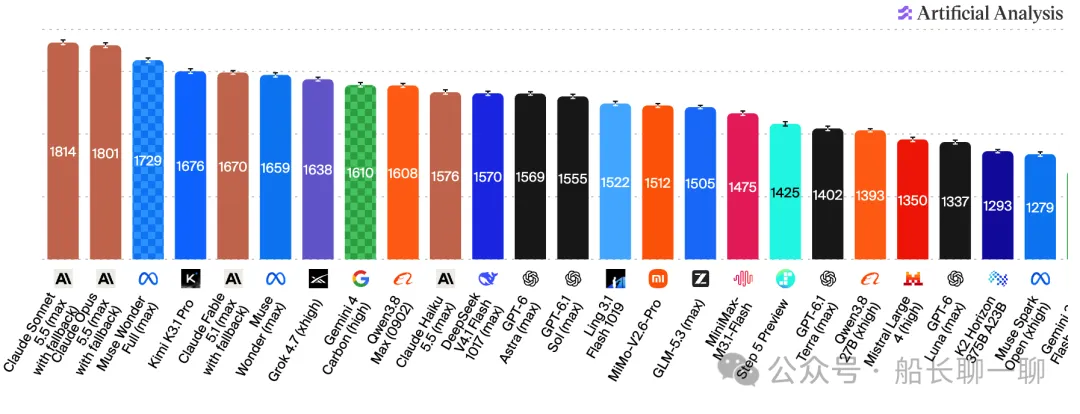
国产模型表现:TOP15的分别是
Kimi K3.1 Pro(第4)
Qwen3.8 Max (0902)(第9)
DeepSeek V4.1 Flash 1017 (Max)(第11)
Ling 3.1 Flash 1019 (第14)
MiMo-V2.6-Pro (第15)
选型分析:
TOP的还是Claude 系列,故对应日常办公的场景,如果用不了国外模型的可以选择Kimi K3.1 Pro
2. AutomationBench-AA:AI能不能真正操作软件?
**AutomationBench-AA(Agentic SaaS Workflow Benchmark):**AutomationBench,衡量智能体在模拟 SaaS 应用环境中完成任务的能力;AutomationBench-AA 的主要指标是模型在不触发安全规则违规的情况下,平均完成每项任务目标的比例。
数据集:共包含 657 任务,涵盖六个业务领域:财务、HR、营销、运营、销售和支持,在模拟应用程序环境中运行,其中包括 Gmail、Google Sheets、Slack、Salesforce、Zendesk、Jira 和 HubSpot 等产品
实现逻辑:
将每个 AutomationBench 断言分类为目标(必须由智能体实现)或护栏(最初通过且不得被智能体破坏)
使用对最终环境状态的编程检查来对目标和护栏进行评分。 AutomationBench-AA不使用单独的LLM评委进行评分
对于主要得分,如果模型违反任何护栏,则任务将收到 0 分。如果没有违反护栏,任务将收到模型完成的目标的百分比。出错的任务也得 0 分
每项任务都属于一个业务域,因此域细分是任务集的互斥子集。应用程序故障并不相互排斥:一项任务可能涉及多个应用程序,因此其目标和护栏断言可能会影响多个应用程序
综合说明:它主要评估AI通过REST API完成SaaS软件工作流的能力,REST API可以简单理解为:软件向外提供的一组操作接口,允许程序读取数据、创建记录、修改状态或执行其他操作。因此,这项测试不只是让AI回答「应该怎么做」,而是要求它通过工具完成相应操作。例如,在一个业务系统中,任务可能涉及查找记录、更新信息,或者按照特定条件完成一系列操作。评测主要检查最终操作是否成功。
各个模型在该基准下的表现(截止20261101)
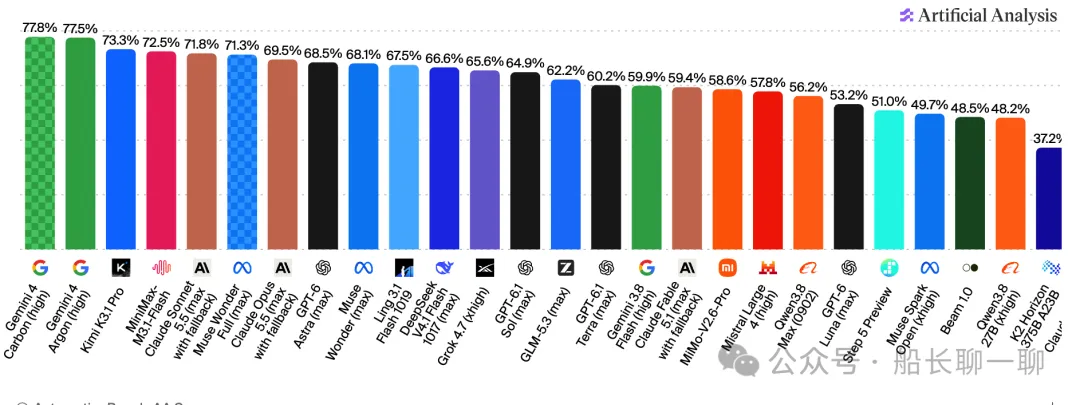
进TOP15的国产模型分别是:
Kimi K3.1 Pro(第3)
MiniMax-M3.1-Flash(第4)
Ling 3.1 Flash 1019 (第10)
DeepSeek V4.1 Flash 1017 (Max)(第11)
GLM-5.3 (Max)(第14)
选型分析:
Gemini4 登顶TOP1,对应一些自动化的场景或运维的场景,如果用不了国外模型的可以选择Kimi K3.1 Pro和MiniMax-M3.1-Flash(性价比更高)
3. GDP.pdf:AI真的读懂了一份长文档吗?
GDP.pdf 是 Surge AI 推出的基准,用于评估基于长篇 PDF 文档的真实专业工作。其 100 项任务涵盖 10 个领域、4,592 页源文档和 1,275 条细粒度评分标准。
方法论:
模型需要根据一份较长的PDF材料回答开放式问题,最终结果由评分标准和大模型评判机制进行评估。
这类测试与普通的知识问答存在明显区别。普通问答考查的是模型能否利用已有知识回答问题。而基于长篇PDF的任务更强调:模型能否找到相关材料、理解上下文,并且给出有依据的答案。部分任务还涉及PDF页面中的图像内容。例如,一份报告中可能包含几十页的文字、图表和数据。用户问的并不是一个常识问题,而是「根据这份报告,哪些因素导致了某项指标发生变化」。
如果AI只凭自身已有知识回答,而没有准确理解文档中的信息,就可能给出看似合理、实际上与材料不符的结论。
这也是长文档理解评测的意义。
评审: GPT-5.6 Luna (medium) 独立评审每个标准。每次调用都会收到任务提示、参赛者答案和一项标准,但不会收到源 PDF 或参赛者身份。仅当每个标准都有结论时,才会接受任务评分。将错误、缺失尝试和终端输入失败评分为零。
成本与速度的统计范围:公布的成本仅包含被评估模型的调用,不包含评审模型调用、PDF 预处理和 OCR。我们根据输出 Token 用量和模型输出速度估算每项任务的耗时。该估算不包含评审调用、PDF 预处理和 OCR,因此并非端到端评估耗时。
各个模型在该基准下的表现(截止20261101)
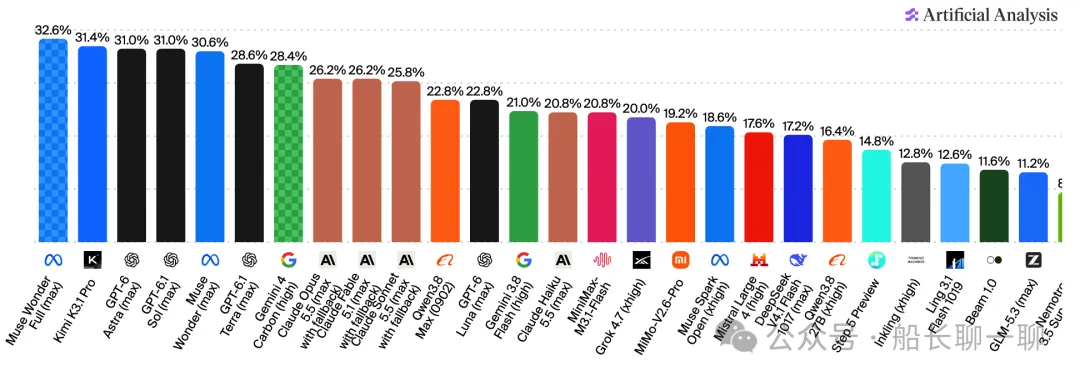
进TOP15的国产模型分别是:
Kimi K3.1 Pro(第2)
GLM-5.3 (Max)(第11)
MiniMax-M3.1-Flash(第15)
选型分析:
muse系列和GPT系列 表现不错,对应一些文档处理和翻译的场景,没必要使用国外的模型,Kimi K3.1 Pro是你的首选。用claude 的模型更是杀鸡用牛刀。
五、第二类:编程,占综合指数的25%
V5的编程类别由两套评测组成。
两者虽然都涉及编程,但关注的重点并不相同。
1. FrontierCode 2.0(新增):代码能运行,就算完成任务了吗?
FrontierCode 2.0是V5新增的评测集,由Cognition 与开源仓库维护者共同构建的编程基准测试。每项任务要求智能体对一个真实的开源仓库进行修改,基准测试衡量该修改是否足以被维护者合并。
方法论:
评估全部 132 项任务,每项任务尝试 3 次,在 Stirrup 框架中运行智能体。智能体启动 Shell 命令后,命令会在后台持续运行。FrontierCode 验证器使用任务的测试和评分细则为每次尝试评分。使用 GPT-6 Luna (medium) 作为 LLM 评判模型,任一阻断性检查未通过,或被 轨迹扫描器标记为查找解答的尝试,得分为 0。其他尝试根据评分细则的各项标准获得加权得分。先对每项任务的各次尝试取平均,再以相同权重对各任务得分取平均。
综合说明:为什么这项测试值得关注?因为真实软件开发并不是一道道独立的编程题。程序员经常需要在已有项目中修改代码,同时遵守原有的接口、架构和行为约束。
例如,修复一个Bug时,模型可能确实解决了表面问题,却破坏了另一个模块的兼容性。从单个功能看,修改似乎是正确的。但从整个项目看,这次修改并不合格。FrontierCode 2.0试图通过更贴近真实开发的任务,评估模型能否完成符合工程要求的代码修改。它仍然有局限:132项任务无法覆盖所有语言、项目和开发场景,而且评分规则本身也会影响结果。所以,它是一种更接近真实开发的评测方式,而不是对AI编程能力的终极判断。
各个模型在该基准下的表现(截止20261101)
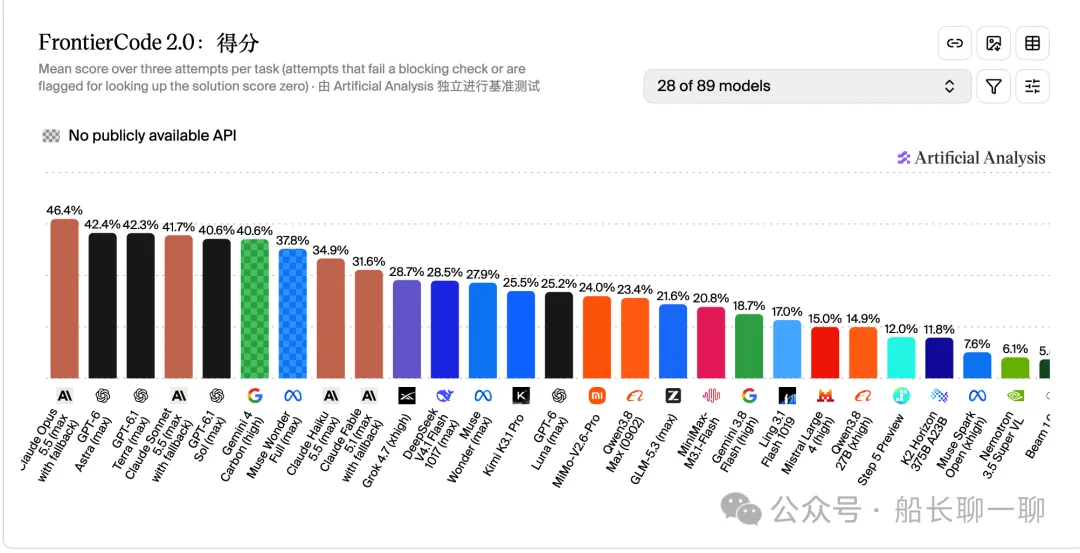
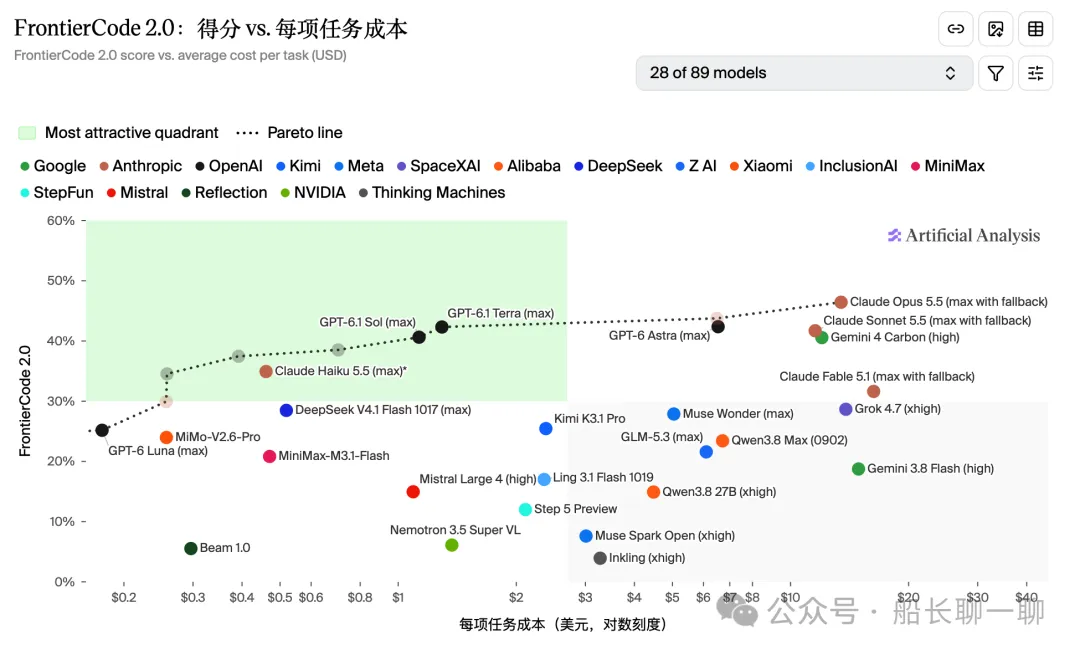
进TOP15的国产模型分别是:
DeepSeek V4.1 Flash 1017 (Max)(第11)
Kimi K3.1 Pro(第13)
MiMo-V2.6-Pro(第15)
选型分析:
头部基本被claude系列和GPT系列霸占,国产模型表现一般,我常用GLM5.3也没有上榜。故对应代码功能迭代的场景,无法使用国外的模型的情况下, DeepSeek V4.1 Flash和Kimi K3.1 Pro可以尝试下。
2. Terminal-Bench 4.0:AI能不能独立完成终端任务?
Terminal-Bench 4.0 是一项难度更高的智能体终端基准,由 Laude Institute、斯坦福大学研究人员和开源贡献者共同开发。其 66 项任务涵盖软件、机器学习、科学、运维、安全、硬件和媒体。智能体在终端中完成任务,只有所有测试都通过时,任务才算通过。
**综合说明:**与只要求模型输出代码的测试不同,终端任务通常需要模型根据目标自行采取行动。它可能需要读取文件、运行命令、修改配置、执行程序,并根据执行结果继续调整。
例如,一个任务可能要求模型配置某个运行环境,或者让一组程序按照指定条件正常运行。模型不仅需要知道应该怎么做,还需要正确执行,并且确保最终结果满足任务要求。Artificial Analysis采用测试套件检查任务是否通过,并将pass@1作为评分指标。官方方法页列出了66项任务,每项运行三次。
这里需要区分两个概念。
运行三次,意味着评测会重复尝试任务;pass@1则关注单次尝试能否成功,而不是允许模型无限次尝试,直到碰巧完成。这种设计更接近实际使用中的一个问题:如果把任务交给AI,它能不能在一次执行过程中把事情做好?
各个模型在该基准下的表现(截止20261101)
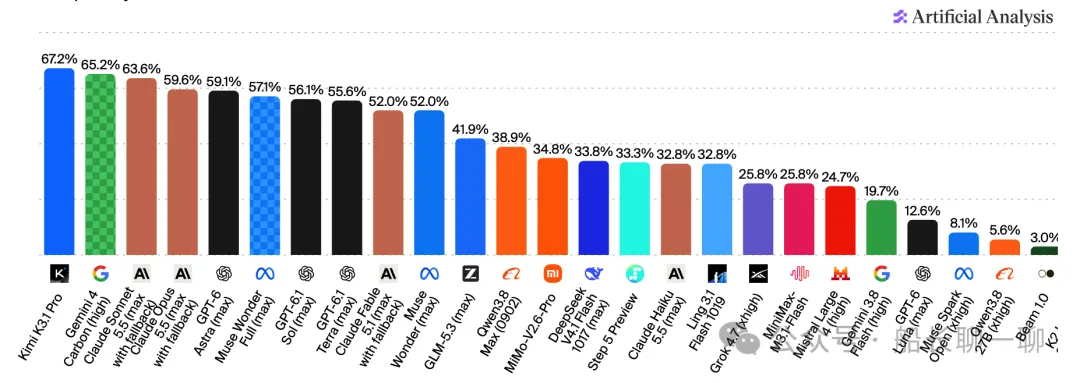
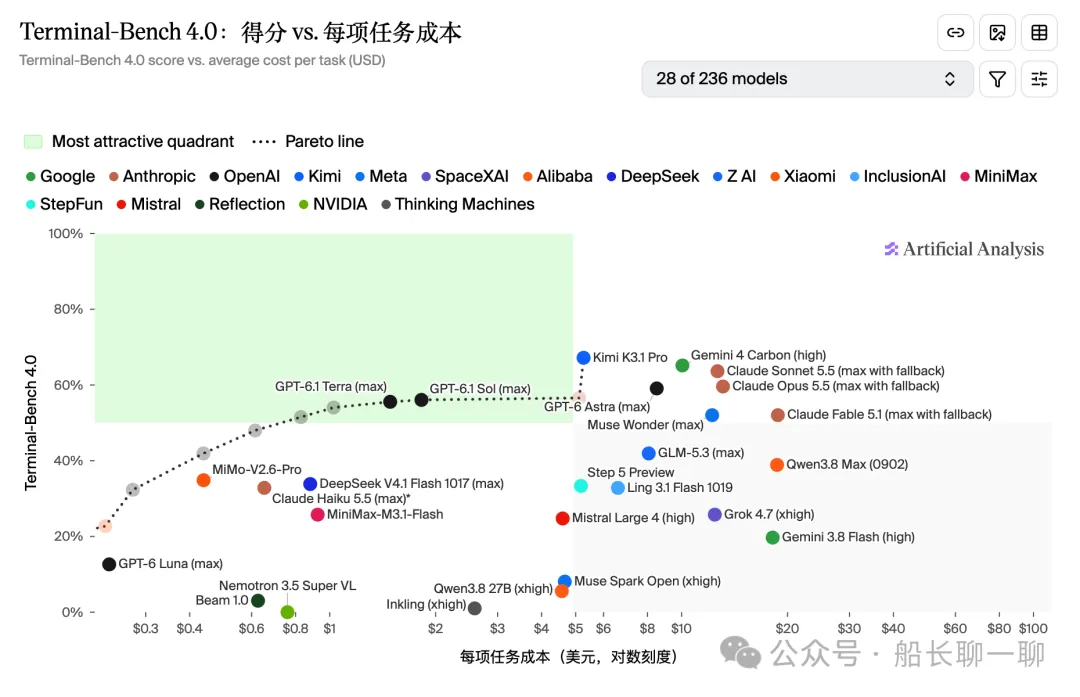
进TOP15的国产模型分别是:
Kimi K3.1 Pro(第1)
GLM-5.3 (Max)(第11)
Qwen3.8 Max (0902)(第12)
MiMo-V2.6-Pro(第13)
DeepSeek V4.1 Flash 1017 (第14)
Step 5 Preview(第15)
选型分析:
Kimi K3.1 Pro登顶,国产模型表现较好,6个模型入围TOP15。故对应喜好终端编码的的程序员,无法使用国外的模型的情况下, Kimi K3.1 Pro和GLM-5.3可能是更好的选择。
六、第三类:科学,占综合指数的25%
科学类别同样包含两套评测。
这两项分别从研究流程和高难度物理推理两个角度评估模型。
1. Terminal-Bench-Science(新增):从回答科学问题到完成科学研究
Terminal-Bench-Science是V5新增的评测集。由斯坦福大学研究人员与 Terminal-Bench 和 Harbor 团队共同开发的开放学术合作项目。它汇集了全球各地机构科学家的贡献,包含 70 个源自真实科研实践、经专家精选和审核的研究工作流任务。包含 19 个生命科学、17 个物理科学、17 个数学科学、9 个工程科学和 8 个地球科学任务。每个任务都有自己的一组测试。智能体在终端中完成研究工作流,只有所有测试都通过时,任务才算通过。
**综合说明:**为什么科学研究需要单独设计这样的评测?因为知道某个科学定律,与真正完成一项研究任务,是两回事。科学研究可能涉及数据处理、程序编写、实验结果分析和计算验证。模型需要将多个环节连接起来,才能得到符合要求的结果。
例如,面对一组科学数据,模型可能需要编写代码进行处理,运行分析程序,再根据结果完成计算。
如果最后的结论正确,但中间的计算流程存在问题,或者结果无法通过规定的测试,也不能直接视为任务成功。
V5将这项评测赋予15%的权重,说明科学研究工作流在综合指数中占据了相当重要的位置。
各个模型在该基准下的表现(截止20261101)
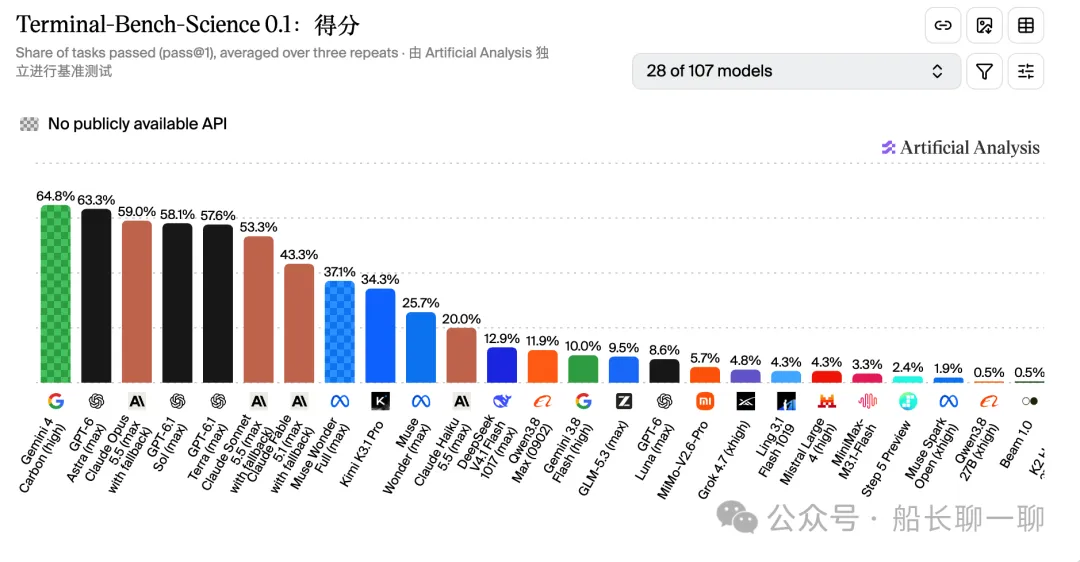
进TOP15的国产模型分别是:
Kimi K3.1 Pro(第9)
DeepSeek V4.1 Flash 1017 (Max)(第12)
Qwen3.8 Max (0902)(第13)
GLM-5.3 (Max)(第15)
选型分析:
这个榜单有点意思,Gemini 4 登顶,虽然TOP15国产模型有4个进入,但是和头部模型的差距还是挺大的。故对应一些科学研究的的场景,无法使用国外的模型的情况下, Kimi K3.1 Pro和DeepSeek 可能是更好的选择。
2. CritPt v2 Hard Subset:为什么只留下40道题?
CritPt v2是一套面向高难度物理问题的评测。由尚未发表的科研级物理问题组成的基准,题目由 60 多名在职物理研究人员编写。V5没有直接使用全部70道研究级物理题,而是选取了其中40道更难的题目。
官方说明,这40道题是从原有70道题中筛选出来的:在V5发布时,已有7个前沿模型在剩余30道题的全部五次尝试中都成功解答,因此这些题目不再进入该指数使用的困难子集。
评测在离线Python沙箱中运行,并提供代码执行工具。每道题运行五次,使用官方评分服务,并采用pass@1评分。
**综合说明:**这里有两个重要的评测设计思路。
第一,评测题目需要保持足够的区分度。
如果最强的模型已经能够稳定解决某些题目,那么这些题目可能越来越难以区分领先模型之间的能力差异。
第二,科学推理不一定只靠自然语言完成。
在复杂物理问题中,模型可能需要编写程序进行数值计算或符号运算。
提供代码执行环境,可以让模型借助工具完成计算,而不只是依靠语言模型内部生成答案。
不过,40道题仍然只是一个有限的样本。它能够反映模型在这组高难度物理任务上的表现,却不能代表全部科学研究能力。
各个模型在该基准下的表现(截止20261101):
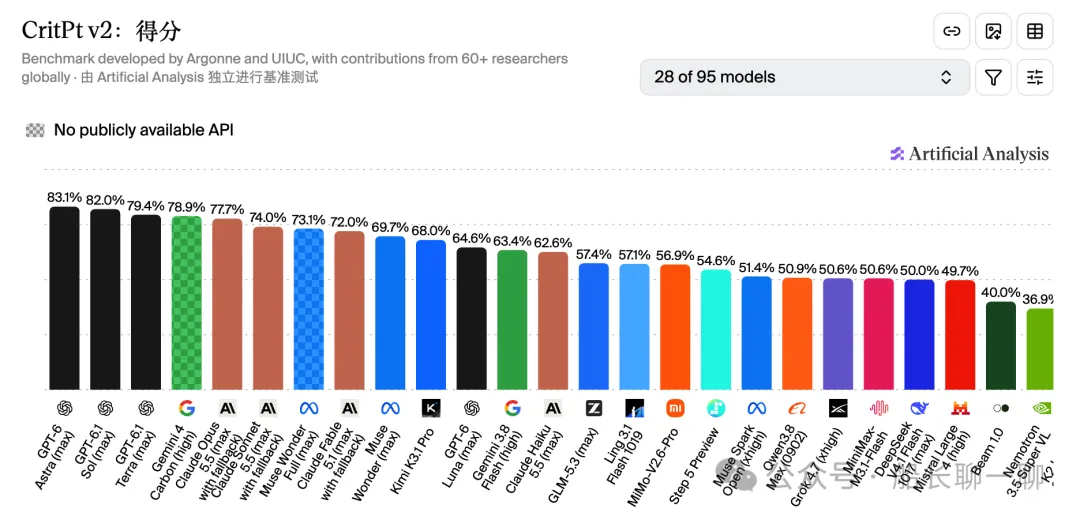
进TOP15的国产模型分别是:
Kimi K3.1 Pro(第10)
GLM-5.3 (Max)(第14)
Ling 3.1 Flash 1019(第15)
选型分析:
TOP3都是GPT系列,国外的模型在科研能力上突出更明显,国内只有 Kimi K3.1 Pro挤进了第10。
七、第四类:通用能力,占综合指数的25%
最后一类是通用能力,由两套评测组成。
这两套评测看起来都像知识考试,但设计目标并不完全相同。
1. AA-Omniscience v1.1:不知道答案时,AI会怎么做?
**AutomationBench-AA(Knowledge and Hallucination Benchmark):**由Artificial Analysis开发的知识与幻觉评测。V5使用的版本,数据集经过清理和更新:移除了已经饱和或公开的题目,增加新题,并修订存在歧义或错误的题目。
**方法论:**该基准测试由涵盖 42 个主题的 3,000 个问题组成,包括商业、人文与社会科学、健康、法律、软件工程以及科学、工程和数学。
使用AA-Omniscience 净得分对模型进行评分,该指标为正确答案评分,为幻觉反应扣分,并保持弃权中立,奖励对错误猜测的弃权。
每个答案均分为CORRECT、INCORRECT、PARTIAL_ANSWER或NOT_ATTEMPTED 基于模型的响应和参考答案。使用GPT-5.6 Luna (medium)作为评审模型。
**综合说明:**这套评测包含3,000道开放式问题。
它将正确率与非幻觉表现分别纳入综合指数:
正确率占10%。
非幻觉表现占5%。
因此,这套评测并不是简单地统计模型答对了多少题,而是进一步关注模型在不知道答案时的表现。
为什么要这样设计?
因为大模型有一个长期存在的问题:即使缺少可靠依据,也可能生成听起来非常合理的答案。
对于用户而言,最危险的情况未必是模型直接说不知道,而是模型编造一个看似正确的事实。
AA-Omniscience试图同时衡量知识能力与回答可靠性。
当然,准确率与幻觉率也不能完全概括模型的可靠性。模型是否能够正确表达不确定性、是否会在特定领域犯错,以及错误会造成多大影响,仍然需要结合具体场景判断。
各个模型在该基准下的表现(截止20261101):
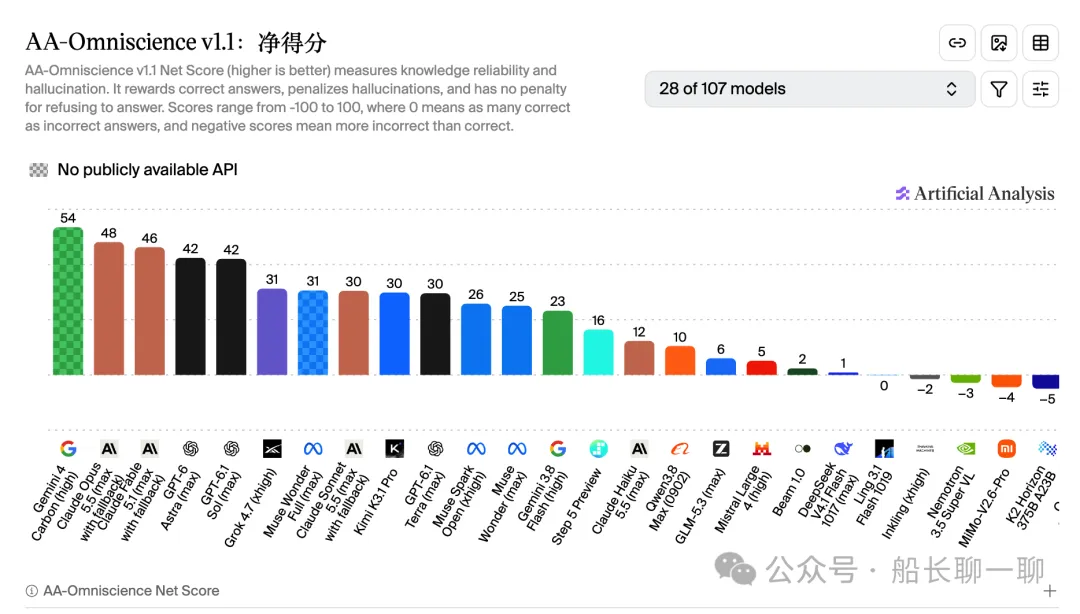
进TOP15的国产模型分别是:
Kimi K3.1 Pro(第9)
Step 5 Preview(第14)
选型分析:
Gemini 4 登顶,TOP15国产模型只有Kimi和Step 5进选,国产模型在通用能力上相比国外顶尖模型差距挺大的。
2. HLE-Diamond:为什么还要保留高难度知识考试?
HLE-Diamond:是 Humanity's Last Exam 的精修版本,共有 1,000 道题,由 Center for AI Safety 和 Scale AI 发布。原始题目经过一年的清洗与修订,并吸收了研究社区的意见。数据集包含 500 道推理题和 500 道知识题,其中 272 道包含图片。模型需要给出开放式答案,再通过答案匹配评估机制判断结果是否正确。
综合说明:
为什么不只使用真实工作任务?
因为工作流测试与知识推理测试关注的能力并不相同。一个模型可能擅长调用工具、修改代码和执行任务,但在某些高难度知识问题上仍然表现不佳。反过来,一个模型也可能具备很强的知识储备,却不擅长将知识转化为实际行动。HLE-Diamond试图从另一个角度检验模型的知识与推理能力。
它与AA-Omniscience之间也存在区别:
AA-Omniscience更关注知识准确性、错误回答与幻觉。
HLE-Diamond更关注高难度问题的正确解答情况。
两者结合,可以从不同角度评估模型的通用能力。
各个模型在该基准下的表现(截止20261101):
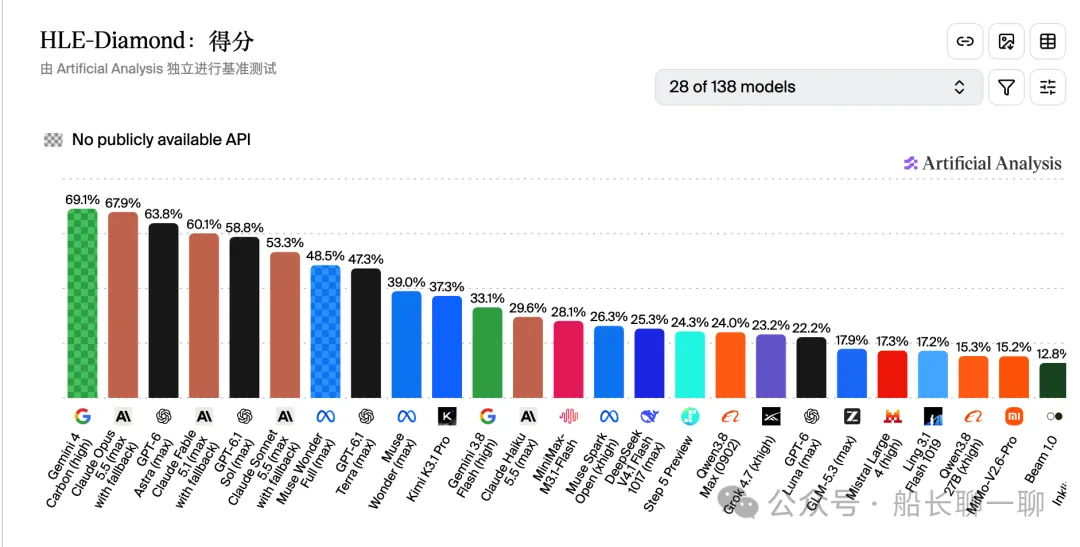
进TOP15的国产模型分别是:
Kimi K3.1 Pro(第10)
DeepSeek V4.1 Flash 1017 (第10)
选型分析:
Gemini 4 登顶,TOP15国产模型只有Kimi和DeepSeek 进选,结合AA-Omniscience评测集的结论,对应一些通用能力的业务场景,无法使用国外的模型的情况下, Kimi K3.1 Pro和DeepSeek 可能是更好的选择。
八、9套评测集放在一起,V5究竟想衡量什么?
到这里,我们已经拆解了全部四大类别和9套评测集。
把它们放在一起,可以发现V5并不是用一种测试方法衡量所有模型能力,而是组合了几种不同的评测思路。
这套体系的设计思路比较清晰:既评估模型知道多少,也评估模型能做什么;既关注单项答案是否正确,也关注完整任务能否完成。
但这并不意味着9套评测已经覆盖了大模型的全部能力。
官方明确说明,Intelligence Index主要以英文文本任务为基础。多语言能力、视觉理解、语音输入等能力另有单独的评测。
因此,V5的综合分数更适合用于比较模型在这套评测体系中的总体表现,而不是作为衡量所有AI能力的唯一标准。
九、V5升级了什么?为什么不能简单比较V4和V5?
最后,再回到这次升级本身。
V5主要进行了以下调整:
这意味着,V5不只是重新排列了模型名次,而是改变了衡量模型能力的部分标准。
尤其值得注意的是,60%的综合指数权重来自使用私有测试集或保留答案的评测。其目的,是降低公开题目被模型训练数据覆盖后,对评测结果造成的影响。
但私有测试集并不意味着绝对公平。
它可以减少题目污染的风险,同时也会让外部研究人员更难完整检查题目和复现全部结果。
因此,理解V5时,需要同时关注两件事:
一是模型在新评测体系中的成绩。
二是这套评测体系本身的设计、权重和局限。
如果没有第二层理解,单看排名,很容易把一个综合指数误解为模型全部能力的绝对排名。
十、最后:大模型排行榜,应该怎么看?
Artificial Analysis V5最值得关注的地方,不只是谁拿到了第一名,也不是某个国产模型与榜首相差多少分。
真正值得关注的是:大模型评测正在越来越重视真实任务的完成情况。
从真实代码仓库,到科学研究工作流,再到完整的知识工作任务,评测的重点逐渐从「能不能给出正确答案」,扩展到「能不能完成一项复杂工作」。
但我们也需要记住,任何综合指数都包含评测者的设计选择。
选哪些题目、给不同能力多少权重、如何判断任务成功,都会影响最终排名。
所以,看榜单时,最好同时问三个问题:
第一,这个模型的综合分数是多少?
帮助我们快速了解它在当前评测体系中的总体表现。
第二,它在哪些具体评测中表现更好?
帮助我们判断它是否适合编程、知识工作、科学研究或其他具体场景。
第三,这些分数是如何测出来的?
帮助我们理解排名的含义,也避免把一次评测结果当成绝对结论。
毕竟,榜单的价值不只是告诉我们谁更强,更重要的是帮助我们理解:AI的能力究竟在什么地方,又还有哪些地方没有做好。
而这,才是研究Artificial Analysis V5真正有意思的地方。