ARTICLE · 1309149
OpenAI 神秘「双模型」闪现 API 又秒撤:下一代 GPT-6.2 的痕迹,藏不住了
OpenAI 神秘「双模型」闪现 API 又秒撤:下一代 GPT-6.2 的痕迹,藏不住了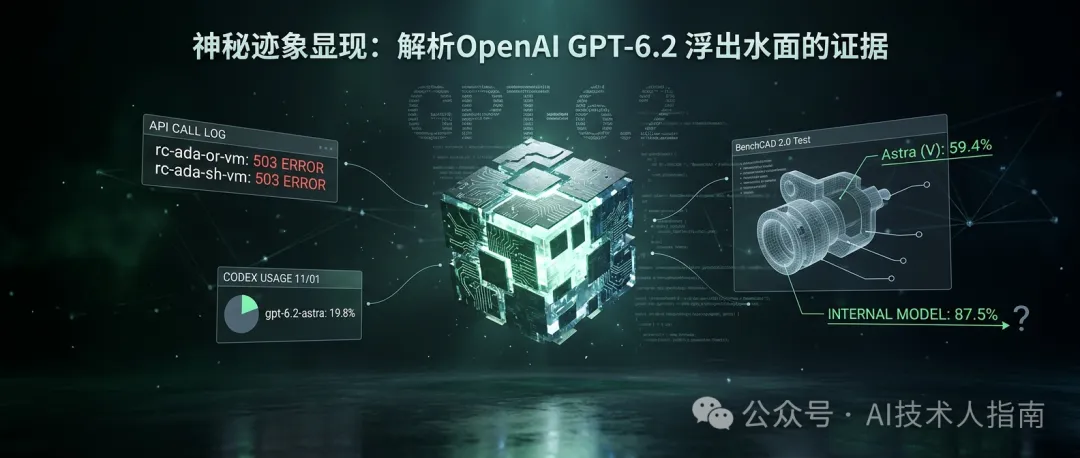
朋友,这几天 AI 圈的信息密度有点超载。 先是 Codex 负责人 Tibo 在社交平台丢出一句法语暗号「Le GPT Fat」,直译过来是「胖版 GPT」,评论区当场失控。接着在 11 月 4 日前后,两个从来没在官方文档里出现过的模型 ID,出现在 OpenAI API 的模型列表里,几分钟之后又被撤掉,手快按下调用的开发者,全部撞上 503。 再然后,OpenAI 官博不动声色地上了一篇硬件工程长文《加速物理世界的工程研发》。文里第一张跑分图上,一个署名为「内部模型」的东西,把自家现役主力按在了下面。 三件事挤在同一个时间窗里发生。它们是不是同一件事的三个侧面?我的答案是:很可能是,但目前没有任何一条能证明是。这篇文章想做的不是替你下结论,而是把线索拆开,一条条告诉你哪部分是板上钉钉的,哪部分只是开发者的想象。 最抓眼球的是那两个 ID: 它们出现在 OpenAI 官方 API 的模型列表里,停留了几分钟,然后消失。这段时间内发起调用的开发者,收到的不是 404,而是503。 这两个错误的差别值得多说一句。404 的意思是「我们这儿没这个东西」;503 的意思是「这东西在,但它现在不接客」——通常出现在网关已经把路由挂上、后端资源池还没准备好,或者被人为限流的时候。也就是说,一个模型 ID 如果只是笔误,你会拿到 404;你拿到 503,说明路由那一层是真的配过。 这次抓包不是一个人看到的。开发者 Pankaj Kumar、Pradeep Kapoor,加上自动化追踪账号 AI Tracker Bot,三条相互独立的记录能对上,所以「这两个 ID 确实在官方 API 里短暂存在过」这一层,是站得住的。 但再往下就没那么确定了。这两个 ID 到底是什么意思,OpenAI 一个字都没解释过。后面我们会专门用一章,把「已经发生」和「大家猜的」分开摆。 如果说 API 闪现只是露了个脸,那第二条线索就是留下了脚印。 从 2026 年 11 月 1 日起,陆续有开发者在 Codex 的用量统计面板里,看到一个独立列出的条目:gpt-6.2-astra。注意这里有个很容易被忽略的细节——模型选择器里显示的仍然是 GPT-6 Astra,但用量明细里,6.2 已经单独占了一行。 开发者 Token Gremlin 晒出的账单显示:gpt-6.2-astra 占 19.8%,旧版 gpt-6-astra 占 80%。目前能查到的最早截图,发布于 11 月 1 日 07:37 UTC。 为什么我一直说这条比截图更硬?因为截图可以 P,账单不行。账单是计费系统按实际调用量算出来的,模型 ID 是后端回填的字段,不是用户手写进去的。一个人可以截错图、认错版本,但计费系统不会替一个不存在的模型算钱。 不过也得把话说全:这条线索只能证明「存在一个叫 gpt-6.2-astra 的计费实体,并且已经在承接真实流量」,它不能证明这个模型已经对外开放,也不能证明发布时间。 第三条线索最不像爆料,因为它来自官方博客本身。 那篇《加速物理世界的工程研发》里,第一张跑分图是BenchCAD 2.0榜单。 这份基准的设定挺狠:100 道真实案例,要求模型一边写代码、一边调用物理工程知识,把 3D 零件和装配体重建出来,还要理清 PCB 电路板上错综复杂的连接关系。 它难的地方不在于「知不知道」,而在于「做不做得成」。公差算错、装配干涉、走线间距不够,任何一项崩了,整个答案就废掉。这类任务没法靠语言流畅度糊过去,模型必须真的能在环境里跑脚本、改参数、看结果、再改。 需要提前说明的是:BenchCAD 2.0 是 OpenAI 自建、自评的基准,结果没有经过第三方独立复现。 同一张表里并列了两个对象。 现役主力GPT-6 Astra,从最低推理档一路拉到第五档,得分停在59.4%。 另一个署名「内部模型」的未公开模型,最低档就是75.8%,继续加算力,峰值到87.5%。 BenchCAD 2.0 的第一作者 Haozhe Zhang 公开评论,说从 0.594 到 0.875 的跨度令人震撼。 这里有个读法要提醒:一个是「加满算力才到 59.4」,一个是「起步就 75.8」。两个数字严格说不在同一个坐标上,不能直接换算成「下一代强了 28 个百分点」。但方向是一致的,而且这个方向比数字本身更重要——新模型在最省的档位上,就已经超过了现役模型的最贵档位。 网友 Prinz 按 Astra 的 API 价格估了一笔账:这个内部模型单题大约 11 美元,就能拿到起步档的高分;大约 37 美元做深度思考,能交出接近工业级的结果。 这是估算,不是官方定价,别当报价单看。但它的意义在于提供了一个量级感:如果「AI 做工程设计」的单题成本能压到十几美元,那这件事就从 demo 变成了可以算 ROI 的生意。 这一章是全文最重要的部分。上面三条线索,加上社区里流传的各种版本,混在一起已经很难分清。我按可信度分三层摆。 社区对那两个 ID 做了逐段拆解: 这一整段没有一条来自 OpenAI。它是社区按命名习惯做的反向工程,逻辑说得通,也符合历史行为模式,但「说得通」不等于「是」。 还有一个流传很广的名字:gpt-6.2-betelgeuse(参宿四,简称 Bel)。 来源是 10 月 29 日前后一张 Discord 截图,一个叫 Internal Tracker 的机器人发出模型更新通知,列出 gpt-6.2-betelgeuse - INTERNAL。 至于 Bel 的参数规模 10 万亿到 12 万亿、Artificial Analysis 智能指数 72 分、API 定价每百万 Token 输入 20 美元输出 100 美元——这些全部是匿名爆料,没有任何官方或可靠信源支撑。 这类数字最容易传播,因为它最具体;也最该被打问号,同样因为它最具体。一个没有出处的精确数字,可信度不比一句「大概很大」更高。 OpenAI 至今没有承认过 gpt-6.2 的存在。 把这两块分开看,你会发现能确定的东西其实不少,但和「GPT-6.2 要来了」之间,还隔着好几步。 假设我们对所有推测都不采信,只承认 A 层。那这件事依然说了三句有分量的话。 过去两年,大模型的能力展示主要发生在文本里:写得多好、答得多准、推理链多长。而 BenchCAD 2.0 这类基准考的是另一件事——能不能在一个环境里连续操作,把一件有物理约束的事做完。 这个转向是有门槛的。会写代码和会在沙盒里跑代码、看报错、改参数、再跑一遍,是两种能力。后者要求模型能承受失败、能读环境反馈、能在多轮里保持目标不漂移。这也是为什么「双虚拟机」这个猜测虽然没被证实,却让人觉得很合理——它描述的是执行侧的结构,而不是模型侧的参数。 有意思的是,这次最亮眼的成绩不在代码竞赛,也不在数学题,而在「重建 3D 零件、理清 PCB 走线」这种传统上被认为太脏、太细、太不性感的活上。 这说明评价重心在移动:从「会不会说」往「能不能交付」挪。对做实际业务的人来说,这其实是好消息——能被验收的 AI,才真的能进流程。 无论是 API 里那两个带 vm 后缀的 ID,还是 BenchCAD 里必须调脚本才能拿分的设定,都指向同一个方向:隔离执行环境正在从「工程细节」升级成「产品的一部分」。 以前沙盒是平台方自己操心的事,现在它会出现在模型 ID 里、出现在基准设计里、出现在计费粒度里。对做 Agent 的人来说,这意味着「怎么设计边界、怎么限权、怎么留痕」会变成和 prompt 一样重要的基本功。 说点能落地的。 第一,别把闪现的 ID 当 API 文档用。每次这类事件之后,都会有人连夜写适配代码、抢首发教程。但一个还没被官方承认的模型 ID,随时可能改名、改签名、改计费方式。真要动手,等文档,别等截图。 第二,值得学的是「沙盒边界怎么划」,不是「哪个模型更强」。前者能沉淀成你的架构能力,后者三个月就过期。如果你在做 Agent 产品,现在就该想清楚:哪些操作允许自动执行、哪些必须人批、出错时怎么回滚、日志留到什么粒度。 第三,对内容创作者来说,判断力比速度值钱。这次事件里,最先传播的版本已经把推测写成了事实,把传闻写成了参数表。跟着转当然有流量,但读者记住的是「谁说得准」,不是「谁说得早」。分层标注看起来啰嗦,长期看是资产。 我不打算在这里替它定一个发布窗口。那种判断听着爽,但准确率和抛硬币差不多,而且很容易让读者在真消息来的时候失去分辨力。 更实用的做法是给自己定三条处理原则: 一是分层的习惯。看到任何一条技术爆料,先问三句:这是谁记录的?这是谁解读的?这是谁证实的?三个答案经常是三个人。 二是给「具体数字」多加一道检查。参数规模、跑分、定价这类信息,越具体越容易被当成事实转发,也越容易是编的。没有出处的精确,是可疑的信号,不是可信的信号。 三是把注意力放在结构上,而不是版本号上。版本号会变,6.2 可能最后叫别的名字,甚至可能根本不存在。但「执行侧被单独建模」「沙盒成为产品的一部分」「工程能力重新成为评价核心」这些结构性的变化,不会因为一个名字的改变而消失。 所以这篇的结论很简单:OpenAI 大概率在准备点什么,但「GPT-6.2」这个具体名字,目前还只是社区的叫法,不是官方的说法。 真正值得记住的,不是那个版本号,而是这三天里露出来的三个痕迹——它们共同指向一个方向:AI 正在从「能说」走向「能做」。这件事,比任何一个型号都更值得我们盯住。 本文基于公开信息与社区记录整理。文中涉及的模型代号解读、参数规模、发布时间均属推测或未证实传闻,已逐项标注层级;最终以 OpenAI 官方发布信息为准。
一、信号一:API 里那两个闪现又消失的 ID
rc-ada-or-vm rc-ada-sh-vm
二、信号二:Codex 用量面板里的 19.8%,比截图更硬的证据
三、信号三:官博那张跑分图,自家旗舰被「内部模型」按住了
1. BenchCAD 2.0 考的不是聊天,是造零件
2. 59.4% 对 87.5%,差在哪
3. 一笔成本账
四、哪些是事实,哪些是想象
1. 【A 层】已经发生、可以核实的
官方 API 模型列表短暂出现 rc-ada-or-vm、rc-ada-sh-vm 两个从未公开的 ID,几分钟后撤回,期间调用方遇到 503 容量受限错误 这次抓包由 Pankaj Kumar、Pradeep Kapoor 与 AI Tracker Bot 分别记录 此前 Codex 负责人 Tibo 发过暗号「Le GPT Fat」 自 11 月 1 日起,多位开发者在 Codex 用量统计面板看到独立列出的 gpt-6.2-astra;Token Gremlin 的账单中它占 19.8%,旧版占 80%;最早截图发布于 11 月 1 日 07:37 UTC 官博同期上线硬件工程长文《加速物理世界的工程研发》,含 BenchCAD 2.0 榜单:Astra 最高档 59.4%,内部模型 75.8% 至 87.5% 第一作者 Haozhe Zhang 就 0.594 到 0.875 的跨度公开评论 网友 Prinz 基于 Astra 价格估算出单题 11 美元与 37 美元两档
2. 【B 层】开发者推测,OpenAI 一个字没解释过
rc 被解读为 Release Candidate(候选发布版)。理由是 OpenAI 过往确实常在正式官宣前 24 到 48 小时,在生产 API 网关上做短暂挂载测试 ada 被解读为本代模型的内部代号 or-vm 被解读为负责任务拆解与全局调度的「大脑虚拟机」 sh-vm 被解读为在隔离沙盒里跑命令行、写代码、开软件的「手脚虚拟机」 由此推论:这代模型是冲着长链路 Agent 任务设计的
3. 【C 层】未证实传闻:参宿四
4. 四条必须写明的边界
网上流传的「已确认」,来自爆料者自己,不是官方表述 BenchCAD 2.0 是自建自评的基准,结果未经第三方独立复现 那个「内部模型」没有任何官方命名、参数、发布时间信息 整件事的本质是:已发生的现象(ID 闪现、日志出现、博客发布)+ 未证实的解读(架构含义、参数规模、发布时间)