ARTICLE · 1367903
PDF 等文档转 Markdown 喂大模型,省手动整理
MarkItDown 是微软开源的一个 Python 小工具,把各种格式的文件转成 Markdown,交给大模型和文本分析流程使用。仓库在 https://github.com/microsoft/markitdown,README 说自己和 textract 接近,但更在意保住标题、列表、表格、链接这些文档结构。能转的包括 PDF、PowerPoint、Word、Excel、图片、音频、HTML、CSV/JSON/XML、ZIP、YouTube 链接、EPub 等。
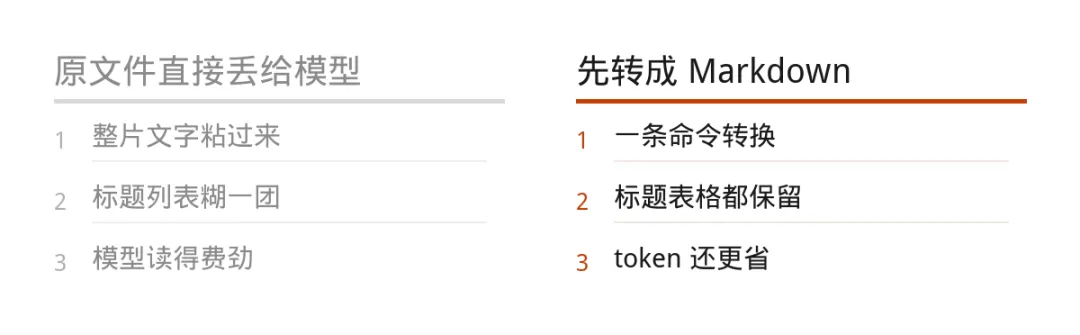
因为主流大模型本来就熟悉 Markdown。README 的判断是,GPT-4o 这类模型原生就会写 Markdown,回答里常常自己带上格式,说明训练时见过大量这类文本。另一个好处是 Markdown 标记少,接近纯文本,占用的 token 也少。
它要解决的是文档结构丢在转换里的问题。转出来的东西如果是一整片没有层次的文字,标题、表格、列表全糊在一起,模型读起来就吃亏。它把结构保留下来,输出的文本算不上精美,但结构信息还在。
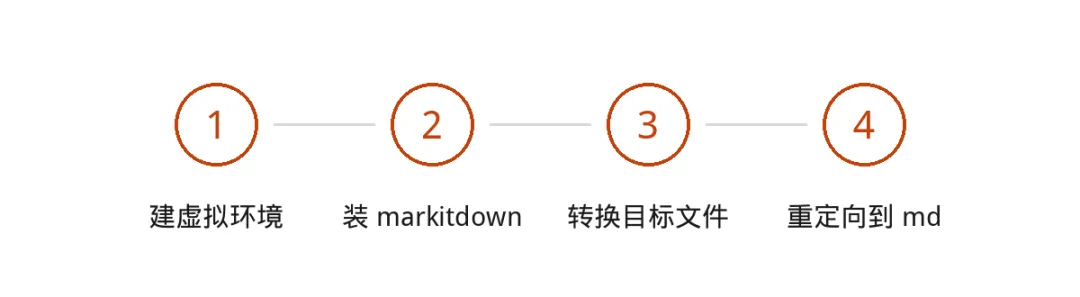
前提是 Python 3.10 到 3.14,建议放在虚拟环境里,免得依赖打架。
转一个文件,重定向到 md 文件就行,也可以用 -o 指定输出路径,或者走管道。
不想一次装齐所有格式的依赖,可以只挑要用的。可选依赖按格式拆开,有 [pptx]、[docx]、[xlsx]、[xls]、[pdf]、[outlook]、[az-doc-intel]、[az-content-understanding]、[audio-transcription]、[youtube-transcription],还有一次装全的 [all]。
靠的是按格式拆分的可选依赖,每种文件交给对应的包去解析。所以装什么决定能转什么,没装的那类文件自然处理不了。想从源码装也可以,克隆下来用 -e 装 packages/markitdown。
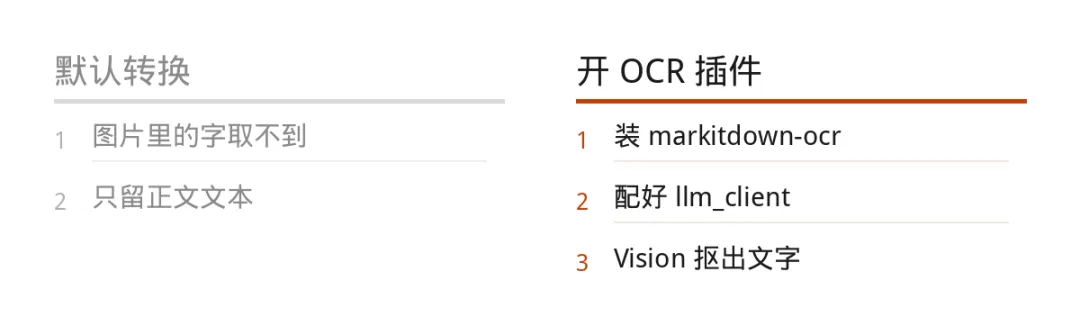
插件是另一条路,默认是关的。先用 --list-plugins 看装了什么,再用 --use-plugins 打开。以 markitdown-ocr 插件为例,它给 PDF、DOCX、PPTX、XLSX 加上 OCR,用 LLM Vision 从内嵌图片里取文字,沿用已有的 llm_client 和 llm_model 配置,不需要另装机器学习库或二进制依赖。没传 llm_client 时插件照样加载,但 OCR 会被静默跳过,退回内置的转换器。
图片描述和语音转写这两项依赖网络上的托管服务,不是本地算出来的。要更高质量的转换,还有 Azure Content Understanding 这条路,能带结构化的字段抽取和可配置的分析器。
首先要清楚它的输出是给机器看的。README 讲得直白,结果常常还算能读,但目标是喂给文本分析工具,要给人看的高保真排版,它不是合适的选择。
其次是权限。它用当前进程的权限做读写,和 open、requests.get 一样,进程能碰到的资源它都能碰到。在不可信的环境里得先把输入清洗干净,尽量调范围最窄的函数,比如 convert_stream 或 convert_local。
具体功能上也有已知的毛病。有 issue 报的是 PPTX 里的组合图表,标签会标错,而且后面几个图的数据会被丢掉。版本更新里,v0.1.8 是一批小补丁和 bug 修复的合集,常规输入下的输出和行为跟 v0.1.7 基本一致,v0.1.9 把读 HTTP 响应的块大小从 512 字节提到了 64 KB。
所以它适合的场合很清楚:手上有一堆格式乱七八糟的文件,想让模型直接读。真要交付一份给人看的文档,别指望它。
小佳教学