ARTICLE · 1383838
数据分析提示模板 —— 从「帮我分析一下」到能直接进决策会的结论
第13集|数据分析提示模板 —— 从「帮我分析一下」到能直接进决策会的结论
第13集 · AI智能体落地实战笔记系列
配套阅读:第12集 评估集怎么建 · 第8-11集 系统提示词管理
配套视频(全 1 集)
第13集《数据分析提示模板:分析结论不能直接进决策会》
视频详情见我的视频号。
开篇:为什么「帮我分析一下」产出的是废话
几乎每个人第一次用大模型做数据分析,都这样问:
「帮我分析一下上个月的销售数据。」
然后你会得到一段这样的东西:
「从数据可以看出,上个月销售额整体呈上升趋势,环比增长约 12%。这表明市场需求旺盛,公司策略较为有效。建议继续保持并进一步加大投入。同时也要注意可能存在的风险,如增长放缓迹象,建议建立预警机制……」
这段话有一个致命问题:它没有告诉你任何能拿去做决定的事。
具体拆开看:
每一个结论都缺一个「可执行的落点」。
更麻烦的是第二层问题:这段话你没法验证。
如果模型说「增长 12%」,你没法知道它是从哪张表算的。如果它说「需求旺盛」,你没法知道依据是销量、客单价还是订单数。一个不能被追溯的分析,等于没有分析——因为没人敢在决策会上引用它。
这篇要解决的问题
一篇数据分析提示词,要同时解决三件事:
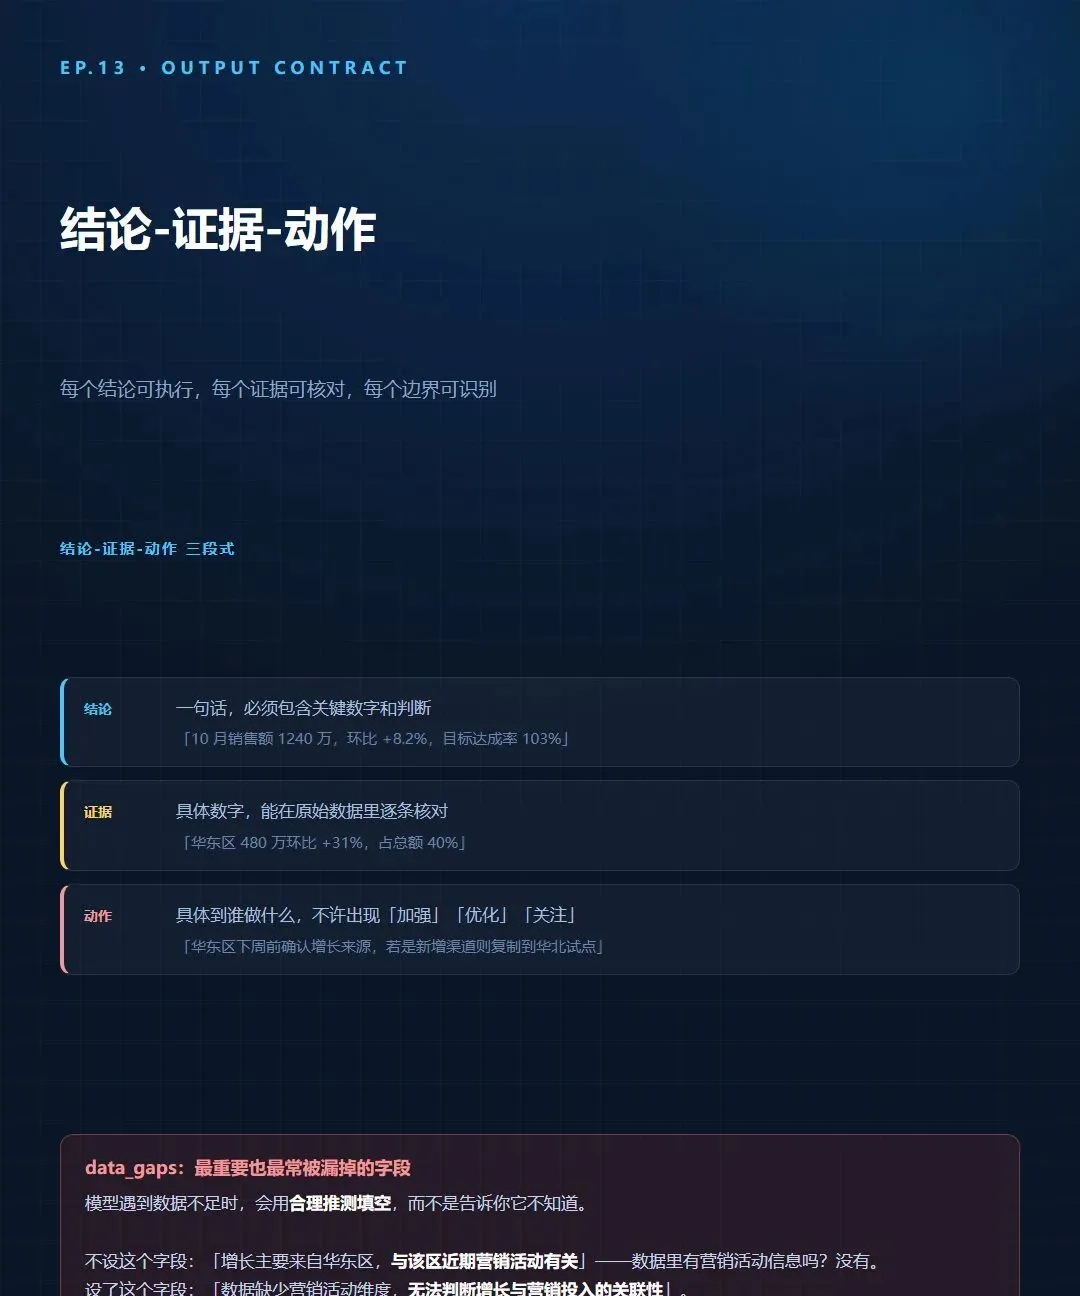
结论可执行——每个判断都落到具体数字和具体动作 过程可追溯——每个结论都能指回原始数据的哪一行 边界可识别——模型不确定的地方要明确标出来,而不是编一个
我给出一个完整的模板,包含:
三层结构(角色 / 契约 / 示例)怎么写 「结论-证据-动作」三段式的输出格式 五种必须让模型标注的不确定性 六个直接可抄的提示词片段 一套能用的数据分析评估集
一、先看清数据分析提示词的特殊之处
在给模板之前,先说清楚数据分析这个任务跟前面几篇讲的有什么不一样。
1.1 三个特征
第三条尤其关键。
我见过一个团队做数据分析提示词,评审模型的 rubric 是「风险识别是否完整」。结果模型学会了多报——每个指标都附一句「需关注」「建议核查」。业务方看烦了,直接不看。
修法是反过来:明确写「不确定就标不确定,不要编」。并且在 rubric 里给「诚实标注不确定性」加分,给「泛泛的风险提示」扣分。
1.2 一个反直觉的结论:数据分析不需要「聪明」,需要「 disciplined」
我测试过同一份销售数据,三种提示词:
加角色设定只带来了长度,不带来可执行性。而结构化模板在更短的前提下,可执行性翻了两倍。
原因不玄学:「深入分析」对模型来说没有可执行指令,它只会用更多的话重复已知的东西。而「每个结论必须给出对比基准和具体数字」是可判定的,模型必须照做。
数据分析提示词的价值不在「让模型更聪明」,在「让模型的输出能被检验」。
二、三层结构:角色、契约、示例
回到第6集讲的三层提示词(任务层 / 格式层 / 示例层),这里按数据分析的场景具体化。
2.1 第一层:任务层——说清楚「你是谁,要判断什么」
关键:任务层要包含判断基准。
TASK_LAYER = ”””你是我们的销售运营分析师,向运营负责人汇报。【本次分析要回答的核心问题】{核心问题}【判断基准】- 环比基准:与上个月同期对比- 同比基准:与去年同月对比- 目标基准:月度目标 {target_amount} 元【重要原则】- 只使用【数据】部分提供的信息,不要引入外部信息- 每个结论必须给出具体数字支撑- 不确定的地方标注「数据不足」,不要推测”””
为什么要有「判断基准」:没有基准,模型只能描述趋势;有了基准,模型才能判断好坏。
# ❌ 没有基准”分析上个月销售情况”# ✅ 有基准”分析上个月销售情况。目标 1200 万。判断标准:达标率 ≥95% 为达成,85%-95% 为接近,<85% 为未达成。”
这一句话能提升输出的可执行性一半以上。因为它把「涨了 12%」翻译成了「达成了吗」。
2.2 第二层:格式层——输出契约(本模板的核心)
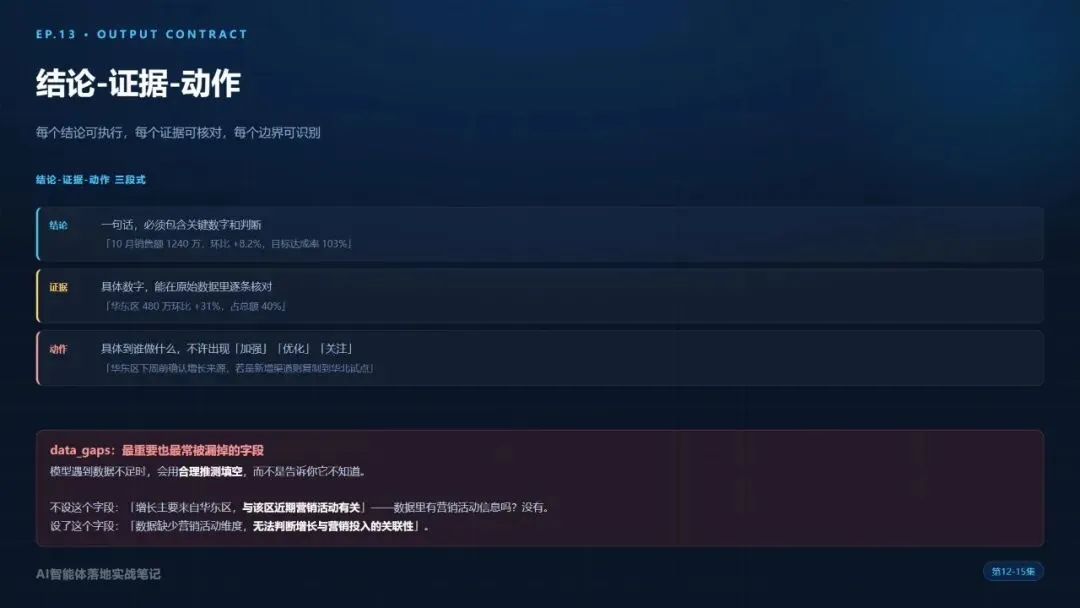
这是决定成败的一层。输出契约要把「结论-证据-动作」三段式写死。
FORMAT_LAYER = ”””【输出格式】严格按以下 JSON 结构输出,不要有任何额外文字:{{”summary”: {{”verdict”: ”<一句话结论,必须包含关键数字和判断>”,”confidence”: ””,”confidence_reason”: ”<为什么是这个置信度>”}},”metrics”: [{{”name”: ”<指标名>”,”value”: ”<数值 + 单位>”,”compare”: ”<对比基准和差值>”,”status”: ”<达成 | 接近 | 未达成 | 恶化>”}}],”findings”: [{{”conclusion”: ”<发现,一句话>”,”evidence”: [”<支撑这个发现的具体数字,引用【数据】中的字段>”],”action”: ”<建议动作,要具体到谁做什么>”,”confidence”: ””}}],”data_gaps”: [”<数据里没有但影响判断的信息,例如:无法区分新老客户>”]}}”””
四个字段各自的作用:
①verdict+confidence+confidence_reason
confidence_reason 是最容易被忽略但最有用的字段。
# ❌ 只给置信度”confidence”: ”medium”# ✅ 给置信度和理由”confidence”: ”medium”,”confidence_reason”: ”总销售额可确认,但增长集中在两个大客户,无法判断是普遍增长还是结构性波动”
只给置信度,模型会随便填。给了理由,你才能判断它对不对。而且业务方看理由比看标签有用得多。
②metrics里的compare
每个指标必须带对比。不是「销售额 1200 万」,而是「销售额 1200 万,环比 +12%,同比 -3%,目标达成率 100%」。
强制模型做对比,是让它从「描述」走向「判断」的最有效手段。
③findings里的evidence和action
evidence 要求引用具体数字——这是防幻觉的关键。
# ✅ evidence 是数组,每项都是具体数字”evidence”: [”华东区销售额 480 万,环比 +31%,占总销售额 40%”,”华北区销售额 210 万,环比 -8%”]
如果模型编了数字,evidence 会露馅——因为你可以在原始数据里逐条核对。
action 要求具体到「谁做什么」:
# ❌ 模糊”action”: ”加强华东区运营”# ✅ 具体”action”: ”华东区:查清 +31% 来自新增渠道还是存量复购,下周前给出结论;如果是新增渠道,复制到华北区试点”
判定标准:一个动作如果不需要任何人做任何具体的事,它就不是动作,是废话。
④data_gaps
这个字段是整份模板里最重要的一个,也是最常被漏掉的。
”data_gaps”: [”数据只有总销售额,没有客户数,无法判断是客户变多还是客单价变高”,”没有退款数据,可能有订单在退款期后被退回”]
为什么要单独列:模型有一个很强的倾向——遇到数据不足时,它会用合理推测填空,而不是告诉你它不知道。
不设这个字段,它会写:
「销售额增长主要由华东区贡献,这与该区域近期的营销活动有关。」
「与营销活动有关」——数据里有营销活动信息吗?没有。这是编的。
设了 data_gaps,同样的情况它会写:
「数据缺少营销活动维度,无法判断增长与营销投入的关联性。」
这就是「诚实」和「听起来很专业」的分界线。
2.3 第三层:示例层——给格式示例,不给推理过程
回到第5集的结论:推理模型上,示例只示范输出格式,不写推理过程。
EXAMPLE_LAYER = ”””【输出示例】(只示范格式,不要模仿推理过程)输入数据:{{”month”: ”2026-10”, ”target”: 12000000, ”regions”: {{...}}}}输出:{{”summary”: {{”verdict”: ”10月销售额 1240 万,环比 +8.2%,同比 +1.1%,目标达成率 103%”,”confidence”: ”medium”,”confidence_reason”: ”总额与目标可确认,但缺少客户数与退款数据,无法判断增长的性质”}},”metrics”: [...],”findings”: [{{”conclusion”: ”增长完全由华东区贡献”,”evidence”: [”华东 480 万环比 +31%”, ”华北 210 万环比 -8%”],”action”: ”华东区下周前确认增长来源;若为新增渠道,复制到华北试点”,”confidence”: ”high”}}],”data_gaps”: [”缺少客户数”, ”缺少退款数据”]}}”””
注意示例里的data_gaps是有值的。如果你的示例里 data_gaps 是空数组,模型会学「这个字段通常可以留空」。
2.4 完整模板
把三层拼起来:
DATA_ANALYSIS_PROMPT = f”””{TASK_LAYER}【数据】{json.dumps(data, ensure_ascii=False, indent=2)}{FORMAT_LAYER}{EXAMPLE_LAYER}”””
三、五个必须让模型标注的不确定性
上面讲了 data_gaps 和 confidence。这一节把它们展开——这五个是数据分析里最常见的五种「编造」。
3.1 数据缺失
# 模型容易做的”整体来看,数据表现良好。虽然缺少退款数据,但预计影响有限。”# 应该做的”data_gaps”: [”缺少退款数据,无法判断净销售额”]
「预计影响有限」是最危险的输出。它把一个事实上的空白包装成了一个结论。
3.2 相关性当因果
# 模型容易做的”conclusion”: ”华东区增长是因为新品上市”,”evidence”: [”华东区销售额环比 +31%”, ”新品在华东区于上月上市”]# 应该做的”conclusion”: ”华东区销售额环比 +31%,同期该区有新品上市”,”evidence”: [”华东区销售额环比 +31%”, ”新品上市日期:2026-10-05”],”confidence”: ”low”,”action”: ”确认新增销售额中新品贡献占比,暂无因果证据”
「因为」和「同期」的区别,就是幻觉的分界线。数据里有时间共现,不等于因果。
如果你的业务场景确实需要因果判断(比如要知道该不该加大新品投入),那数据里必须有实验或对照组——提示词解决不了数据本身没有的因果性。
3.3 数字精度幻觉
# ❌ 数据里只有整数,模型给出小数”value”: ”1234.56万”# ❌ 模型自己算错了”value”: ”1240万”# 实际数据是 1238.5
防法:在格式里要求「数字必须直接引用数据字段,不要自己计算」,复杂的计算放代码里做。
FORMAT_LAYER = ”””【数据使用规则】- metrics.value 必须直接引用【数据】中的字段值,不要四舍五入或自行换算- 如果需要计算(环比、同比、达成率),在 value 后用括号标注计算式:”value”: ”1240万 (环比 = (1240-1155)/1155 = +7.4%)””””
要求标注计算式,有个额外好处:你一眼就能看出它算错了。
3.4 样本量不足
# 模型容易做的”conclusion”: ”新品用户复购率显著高于老用户”# 实际上新品用户只有 3 个# 应该做的”conclusion”: ”新品用户复购率高于老用户”,”evidence”: [”新品 3 人复购 2 人”, ”老用户 240 人复购 150 人”],”confidence”: ”low”,”data_gaps”: [”新品用户样本仅 3 人,不足以支撑统计结论”]
凡是「显著」「明显」「远高于」这类词,都要追问一句:样本多大?小样本上的差异不是差异,是噪声。
3.5 数据本身有问题
# 模型应该发现的”data_gaps”: [”华南区数据缺失(原始 CSV 该行为空)”,”10 月 15 日有一条订单金额为负,疑似退款未剔除”]
最后这条尤其重要。脏数据是常态,模型如果不去看有没有异常值,它算出来的所有指标都是错的。
在任务层加一句:
”在分析前先检查数据本身的异常:缺失值、负数、重复记录、量纲异常。发现后不要自行修正,列入 data_gaps。”
这一句能挡掉大量后患。
四、六个可直接抄的提示词片段
上面讲的是原理。下面这六个片段是「换个场景就能用」的模块化组件。
4.1 片段一:反问澄清
用户的问题往往不明确。与其猜,不如让它先问——但要限制只问关键问题。
CLARIFY_PROMPT = ”””在开始分析前,检查以下三项:1. 【判断基准】是否明确?(对比对象、目标值)2. 【分析维度】是否明确?(时间范围、拆解维度)3. 【数据完整性】是否足够支撑结论?如果某项缺失且会实质影响结论,输出澄清问题(最多 3 个),不要开始分析。如果缺失项不影响核心结论,直接开始分析,在 data_gaps 中说明。输出格式:{{”need_clarification”: true, ”questions”: [”<问题1>”], ”analysis”: null}}或{{”need_clarification”: false, ”questions”: [], ”analysis”: {{...}}}}”””
限制「最多 3 个」很重要。不限制的话模型会问出 10 个问题,用户直接放弃。
4.2 片段二:异常检查
ANOMALY_CHECK_PROMPT = ”””在分析前,先对【数据】做完整性检查:检查项:- 缺失值:哪些字段有缺失,涉及多少条记录- 异常值:负数、零值、超出合理范围(如金额 > 1000 万)- 重复:完全重复的记录- 量纲:同一字段的单位是否一致(万元 / 元混用)- 口径:日期范围是否完整(有缺失的天数吗)输出所有发现的问题,按影响程度排序。不要自行修正。”””
4.3 片段三:口径对齐
数据分析里最隐蔽的错误是口径不一致。
ALIGNMENT_PROMPT = ”””【口径确认】本报告使用以下口径,请确认你的理解与之一致:- 销售额:{销售额口径,如「下单金额,不含退款」}- 时间:{时间口径,如「按下单日期归属,非支付日期」}- 客户:{客户口径,如「按支付账号去重」}- 环比:{环比口径,如「与上一个自然月对比」}如果【数据】的字段无法支撑上述口径,列入 data_gaps 并在结论中降级表述。”””
举个真实例子:如果销售团队说的是「下单金额」而财务说的是「支付金额」,两个部门的「增长 12%」完全对不上。口径不对齐,后面所有分析都是扯皮。
4.4 片段四:分层拆解
DECOMPOSITION_PROMPT = ”””按以下顺序拆解,每个层级都要给出贡献度和变化方向:1. 总量:整体是多少,同比环比如何2. 一级拆解:按 {拆解维度1} 分(如:区域/产品线/渠道)3. 定位到贡献最大的 1-2 个分支4. 对贡献最大的分支做二级拆解【要求】- 每层都要给「贡献度」(该分支变化占总变化的比例)- 如果所有分支同向,说明是普遍性变化- 如果分支分化,明确指出是结构性变化”””
「贡献度」这个字段很关键。它让分析从「哪里涨了」变成「是谁贡献了这个增长」。
4.5 片段五:反证
FALSIFICATION_PROMPT = ”””在给出结论前,对每个候选结论做一次反证检查:对每个结论问:1. 有没有另一种解释也能产生同样的数据?2. 这个结论依赖哪些假设?假设不成立会怎样?3. 如果这个结论是错的,我会看到什么现象?(可观测的证伪信号)如果一个结论经不起反证,把它降级为「可能」并降低 confidence。”””
这一段能过滤掉大部分「听起来对」的分析。很多结论经不起「有没有别的解释」这一问。
4.6 片段六:行动清单
ACTION_PROMPT = ”””把 findings 转成行动清单。每条行动必须有:- 负责人(角色,不是具体人名)- 动作(具体到能直接开始做)- 期限(相对期限,如「本周内」)- 依赖的前置结论(哪条 finding 支撑它)- 优先级(按「影响大小 × 确定性」排序)【禁止】- ”加强”、”优化”、”关注” 这类不可执行的词- 没有期限的动作- 没有依赖关系的孤立动作(每条都要能追溯到某个 finding)”””
最后那条「禁止」清单很关键。「加强运营」这种话 AI 很爱写,但没有任何人知道从哪下手。
五、把模板组装起来:一份能直接跑的代码
前面四节是零件。这一节把它们拼成可以复制就跑的实现。
5.1 模板文件拆分
不要把所有提示词写成一个字符串。拆成几个文件,改起来快,也方便不同场景复用。
prompts/├── data_analysis/│ ├── task.py# 任务层│ ├── format.py# 输出契约│ ├── example.py# 示例层│ └── modules/# 可选模块,按需拼│ ├── clarify.py│ ├── anomaly.py│ ├── alignment.py│ ├── decomposition.py│ ├── falsification.py│ └── action.py
5.2 各层代码
# prompts/data_analysis/task.pyTASK_LAYER = ”””你是我们的{role},向{audience}汇报。【本次分析要回答的核心问题】{question}【判断基准】- 环比基准:{mom_basis}- 同比基准:{yoy_basis}- 目标基准:{target_basis}【重要原则】- 只使用【数据】部分提供的信息,不要引入外部信息- 每个结论必须给出具体数字支撑- 不确定的地方标注「数据不足」,不要推测”””
# prompts/data_analysis/format.pyFORMAT_LAYER = ”””【输出格式】严格按以下 JSON 结构输出,不要有任何额外文字:{{”summary”: {{”verdict”: ”<一句话结论,必须包含关键数字和判断>”,”confidence”: ””,”confidence_reason”: ”<为什么是这个置信度>”}},”metrics”: [{{”name”: ”<指标名>”,”value”: ”<数值 + 单位>”,”compare”: ”<对比基准和差值>”,”status”: ”<达成 | 接近 | 未达成 | 恶化>”}}],”findings”: [{{”conclusion”: ”<事实陈述,不含'所以/因此/建议'>”,”evidence”: [”<支撑这个发现的具体数字,引用【数据】字段>”],”action”: ”<建议动作,具体到谁做什么>”,”confidence”: ””}}],”data_gaps”: [”<数据里没有但影响判断的信息>”]}}【数据使用规则】- metrics.value 必须直接引用【数据】中的字段值,不要四舍五入或自行换算- 需要计算时(环比、同比、达成率),在 value 后用括号标注计算式- conclusion 只能是事实陈述,不得包含因果推断或建议”””
5.3 组装器
# prompts/data_analysis/builder.pyimport jsonfrom pathlib import PathBASE = Path(__file__).parentMODULE_ORDER = [”alignment”,# 口径确认(必须在最前)”anomaly”,# 异常检查”clarify”,# 反问澄清”decomposition”,# 分层拆解”falsification”,# 反证”action”,# 行动清单]def load(name):return (BASE / f”{name}.py”).read_text(encoding=”utf-8”)def build_prompt(data, question, role=”销售运营分析师”,audience=”运营负责人”,mom_basis=”与上个月同期对比”,yoy_basis=”与去年同月对比”,target_basis=”月度目标(见数据中的 target 字段)”,modules=None):”””组装完整的数据分析提示词modules: 启用哪些可选模块,默认全开。第一轮调试建议只开 alignment + anomaly。”””parts = []# 1) 任务层task = load(”task”)parts.append(task.format(role=role, audience=audience, question=question,mom_basis=mom_basis, yoy_basis=yoy_basis, target_basis=target_basis,))# 2) 可选模块(口径在最前)use = modules if modules is not None else MODULE_ORDERfor m in use:parts.append(load(”modules”) / m if False else load(f”modules/{m}”))# 3) 数据parts.append(”【数据】\n” + json.dumps(data, ensure_ascii=False, indent=2))# 4) 格式层parts.append(load(”format”))# 5) 示例层parts.append(load(”example”))return ”\n\n”.join(parts)
5.4 计算与解读分离
这是第 6.3 节那个坑的解法。计算在代码里做,模型只解读。
# analysis/stats.pydef compute_stats(data: dict) -> dict:”””所有指标计算在这里做,模型只负责解读”””total = data[”total”]target = data.get(”target”)stats = {”total”: total,”target”: target,”achievement_rate”: round(total / target, 4) if target else None,”mom”: None,”yoy”: None,”by_region”: [],}prev_total = data.get(”prev_month_total”)if prev_total:stats[”mom”] = {”prev”: prev_total,”delta”: total - prev_total,”pct”: round((total - prev_total) / prev_total, 4),}last_year = data.get(”last_year_total”)if last_year:stats[”yoy”] = {”last_year”: last_year,”delta”: total - last_year,”pct”: round((total - last_year) / last_year, 4),}# 分区域贡献度prev_regions = data.get(”prev_by_region”, {})for name, val in data.get(”by_region”, {}).items():prev = prev_regions.get(name)entry = {”region”: name, ”value”: val}if prev:entry[”delta”] = val - preventry[”pct”] = round((val - prev) / prev, 4) if prev else Noneentry[”contribution”] = (round((val - prev) / (total - prev_total), 4)if prev_total and total != prev_total else None)stats[”by_region”].append(entry)return stats
然后调用:
# main.pyimport jsonfrom analysis.stats import compute_statsfrom prompts.data_analysis.builder import build_promptraw = json.loads(Path(”data/october.json”).read_text(encoding=”utf-8”))stats = compute_stats(raw)prompt = build_prompt(data=stats,# ← 传算好的统计量,不是原始数据question=”10月销售未达成目标,请分析原因并给出下一步动作”,)# 调模型response = call_model(prompt, model=”gpt-5”, response_format=”json”)result = json.loads(response)
关键点:data=stats而不是data=raw。
这样模型看到的是「销售额 1240 万,环比 +7.4%,华东区 480 万贡献度 62%」这样的已算好的统计量,而不是一堆原始数字让它自己算。
5.5 加一层结果校验
模型输出的数字,要跟代码算的对得上。对不上就是幻觉,当场拦下。
# analysis/validate.pydef validate(result: dict, stats: dict):”””校验模型输出里的数字是否与统计量一致”””errors = []# 1) 校验 metrics.valuefor m in result.get(”metrics”, []):name = m.get(”name”, ””)# 从统计量里找对应项if name in stats and isinstance(stats[name], (int, float)):claimed = extract_number(m.get(”value”, ””))if claimed is not None and abs(claimed - stats[name]) > 0.01:errors.append(f”指标「{name}」模型给出 {claimed},实际 {stats[name]}”)# 2) 校验 findings.evidence 里引用的数字known = collect_all_numbers(stats)for f in result.get(”findings”, []):for ev in f.get(”evidence”, []):for num in extract_numbers(ev):if not close_to_any(num, known, tol=0.001):errors.append(f”结论「{f.get('conclusion', '')[:20]}…」的证据 ”f”引用了数字 {num},但统计量里没有这个值”)return errorsdef main():...result = json.loads(response)errors = validate(result, stats)if errors:print(”⚠ 输出与数据不一致:”)for e in errors:print(” -”, e)# 生产环境:直接拒绝,走人工sys.exit(1)
这一层校验是模板之外最有价值的一层。
第 2.2 节讲 evidence 能防幻觉,但那是软的——你还要人工核对。validate() 是硬的——程序直接核对。
组合起来的效果:
evidence | ||
validate() | ||
5.6 调用侧的三道防线
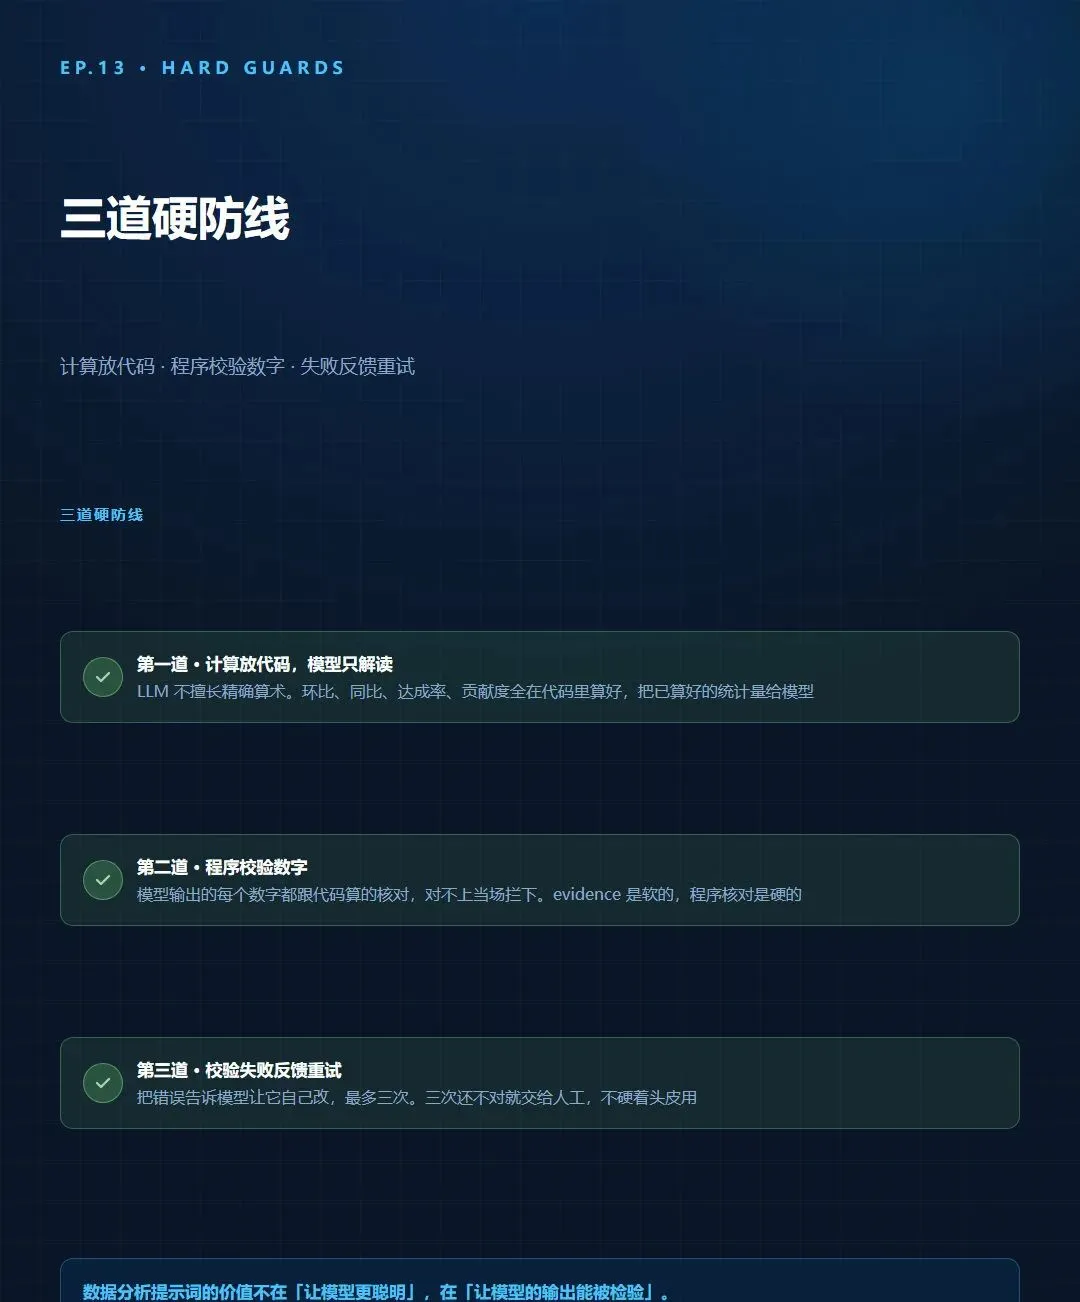
最后,把整套东西在调用侧收紧:
# analysis/pipeline.pydef analyze(raw_data, question, model=”gpt-5”):”””完整分析流程:算 → 生成 → 校验 → 重试”””stats = compute_stats(raw_data)prompt = build_prompt(data=stats, question=question)for attempt in range(3):response = call_model(prompt, model=model, response_format=”json”)result = json.loads(response)errors = validate(result, stats)if not errors:return resultprint(f”第 {attempt+1} 次校验失败:{errors}”)# 把错误反馈给模型让它自己改prompt += f”””【校验错误,请修正】你的输出中有以下数字与提供的数据不符:{chr(10).join('- ' + e for e in errors)}请重新输出完整的 JSON。evidence 中的每个数字都必须能在【数据】中找到。”””stats[”_retry_count”] = attempt + 1# 三次都不对 → 交给人工,不硬着头皮用raise ValueError(”三次校验均失败,需人工介入”)
「三次校验失败就交给人工」这个设计很重要。不要因为模型一直不达标就降低校验标准——那等于把校验变成摆设。
六、一套能用的数据分析评估集
按第12集的三级演进,给一套数据分析场景的具体配置。
6.1 分桶
数据分析的桶按「数据质量」分,不按「业务类型」分——因为脏数据是最大的风险源。
DATA_BUCKETS = {”干净完整”: 25,# 无缺失、口径清晰”有缺失”: 20,# 部分字段缺失”有异常值”: 15,# 含负数、极值、重复”口径模糊”: 15,# 时间范围/口径不明确”小样本”: 15,# 分组后样本量很小”多维交叉”: 10,# 需要多维度拆解}
6.2 rubric
DATA_RUBRIC = ”””你是数据分析质量评审专家。评估一份数据分析报告的质量,1-5 分。【5 分】结论可直接用于决策:- 每条 conclusion 都能在数据中找到对应的具体数字- 每条 action 具体到可执行(谁、做什么、何时)- 所有不确定处都在 data_gaps 中明确标注- 每个指标都给出了对比基准- confidence 与 confidence_reason 匹配(理由确实支撑那个置信度)【4 分】结论基本可用:- 证据齐全,但个别 action 稍笼统- 不确定处标注基本完整【3 分】有明显缺陷:- 缺少对比基准,或- 存在没有证据支撑的结论,或- data_gaps 遗漏了影响判断的重要缺失【2 分】只有描述没有判断:- 大量使用”趋势良好””表现不错”这类无基准描述- 缺少 action 或 action 不可执行【1 分】不可用:- 数字与数据不符,或- 存在编造的因果关系,或- 格式不符合契约【硬性要求】- 不因表达流畅、排版美观加分。只评估”结论能否支撑决策”。- 数字与原始数据不符是严重问题,出现即判 1 分。”””
6.3 人工金标准的判分要点
给数据分析做金标准时,判断依据要写「哪里不合格」,不是「哪里好」。
GOLD_DATA = [{”id”: ”da_003”,”input”: ”分析 10 月销售数据”,”data”: {”month”: ”2026-10”, ”total”: 1240, ”regions”: {...}},”human_score”: 2,”human_reason”: ”结论说'增长因新品上市',但数据里没有新品维度,属于编造因果;””华东区那条 action 是'加强运营',不可执行”},{”id”: ”da_011”,”input”: ”分析各渠道转化”,”data”: {...},”human_score”: 4,”human_reason”: ”漏检了'新渠道样本仅 8 个'这个 data_gap,””但其余部分证据齐全、动作具体”}]
注意da_003的 2 分和da_011的 4 分。这两条覆盖了两个最常见的扣分点:编造因果、action 不可执行。
七、六个必须避开的坑
7.1 坑一:给数据不给口径
表现:数据给全了,结论也生成了,但结论和业务方对不上。
原因:口径不一致。比如财务的「销售额」是支付金额,销售的是下单金额。
解法:4.3 的口径确认片段,放在提示词最前面。
7.2 坑二:不设 data_gaps 字段
表现:输出读起来很专业,但把所有不确定的地方都用合理推测填满了。
解法:data_gaps 是必填字段,且在 rubric 里给「主动标注不确定性」加分。
一个反向验证方法:把你的评估集里的 data_gaps 全删掉,看分数会不会涨。如果涨了,说明你的 rubric 在奖励「说得圆满」而不是「说得准确」。
7.3 坑三:让模型自己算数
表现:模型给出一个看起来合理但算错的百分比。
原因:LLM 不擅长精确算术,尤其在多步计算时。
解法:计算放代码,模型只做解读。
# ✅ 正确分工stats = compute_stats(raw_data)# 代码算环比、同比、贡献度prompt = build_prompt(stats, raw_data)# 模型只解读
如果必须在提示词里让模型算,要求它标注计算式(3.3 那招),你一眼能验。
7.4 坑四:示例给了推理过程
表现:示例里写了「因为 A 所以 B」,模型学的不是格式,是那个推理套路。
原因:这是第5集讲过的——推理模型会照抄你示范的思考路径。
解法:示例只给输出结构,不要在示例里展示推理过程。
7.5 坑五:把「结论」和「建议」混在一起
表现:findings 里既有发现又有建议,评审模型无法判断哪个是事实、哪个是主张。
解法:分离。
{”findings”: [{”conclusion”: ”事实”, ”evidence”: [...], ”action”: ”建议”}]}
conclusion 只能是事实陈述,不能包含「所以」「因此」「建议」。建议只能出现在 action 里。
7.6 坑六:不做异常检查
表现:数据里有一条负数金额,模型直接算进总额,你拿到的报表是错的。
解法:4.2 的异常检查片段,放在分析之前。
7.7 对照表
八、一页纸总结
核心原则
数据分析提示词的价值不在「让模型更聪明」,在「让模型的输出能被检验」。
三个检验标准:结论可执行(落到数字和动作)、过程可追溯(证据能核对)、边界可识别(不确定要标出来)。
三层结构
verdict/metrics/findings/data_gaps | ||
四个必填字段
confidence_reason—— 只给置信度模型会乱填,给理由你才能验 metrics.compare—— 强制对比,是从「描述」到「判断」的开关 findings.evidence—— 引用具体数字,防幻觉的照妖镜 data_gaps—— 最重要,让模型说「我不知道」而不是编一个
五个必须标注的不确定性
数据缺失 · 相关性当因果 · 数字精度幻觉 · 样本量不足 · 数据本身有问题
三条最容易被跳过的检查
口径确认——放提示词最前面 异常检查——放分析之前 让模型输出计算式——方便你验它算得对不对
【AI智能体落地实战笔记】第13集。下一篇预告:合同审阅提示模板—— 为什么合同审阅是五个模板里风险最高的一个,以及「风险分级」这一层到底该怎么设计。