ARTICLE · 1396035
KV 和索引全卸载,长上下文解码吞吐翻近 5 倍
KV 和索引全卸载,长上下文解码吞吐翻近 5 倍把 KV 和索引一起赶出显存:XM-Sparse 让长上下文解码吞吐最高翻近 5 倍 arXiv:2611.22280 | 2026-11 | 系统·稀疏注意力·内存层级 | https://arxiv.org/abs/2611.22280作者:Yijun Sun、Xudong Liao、Zhuobin Huang、Kai Chen、Nikita Lazarev、Zhizhen Zhong(Netpreme、HKUST、NUS)| 17 Nov 2026(v1) 一句话导读 稀疏注意力的服务系统一直有个尴尬:计算只挑几百个 token,显存里却得老老实实存着全部历史。Netpreme 等人把 KV 缓存和索引缓存一起塞进 scale-up 内存池,再用一条融合 kernel 把"取数"藏进"算注意力"、用 GPU 发起的 DMA 提前把索引页搬到显存,在 128K 到 1M 的上下文上把解码吞吐最高做到 PCIe 方案的 4.98 倍。真正的洞察不是"内存更大了",而是——内存池把容量瓶颈解掉之后,卡脖子的仍然是显存,于是他们把最后两块占显存的大头也搬走了。 长上下文的显存之痛:算得少,存得多 先说清楚稀疏注意力在干什么。像 DeepSeek-V3.2、GLM-5 这类新一代模型,解码时不再让每个 query 和全部历史 token 做注意力,而是先用一套轻量"索引器"(indexer)给历史 token 打分,只挑出得分最高的那一小撮(论文里是 2048 个)来算注意力。挑出来的少了,计算量和 KV 访问的次数自然就降下来了,这是稀疏注意力能提升长上下文推理效率的根本原因。 但这里藏着一个反差极大的事实:这一步的 token 被跳过了,不代表它以后不会被用到。稀疏选择是"每步动态决定"的——这一轮没被选中的 token,下一轮可能就因为 query 变了而进入 Top-K。所以系统必须把完整 KV 历史都留着,随时待命。结果就是:计算省下来了,存储一点没省。KV 缓存随着上下文长度线性膨胀,GPU 显存(HBM)容量成了决定"能同时服务多少请求"的硬约束。论文一针见血地指出,即便用了稀疏注意力,服务系统仍要保留完整 KV 历史,HBM 容量始终是并发吞吐的天花板。 过去两年,业界的主流解法是"卸载"(offloading):把完整的 KV 缓存搬到主机内存(host memory),GPU 显存里只留两部分——一份"热 KV 缓冲区"(缓存最近常被调用的 token),以及完整的"K-index 缓存"(索引器打分要用的紧凑 key)。HiSparse、ECHO 都是这条路线上的代表。缺的 KV 条目在解码前按需要从主机内存现取。听起来很合理,但这条路被两件事卡死:PCIe 带宽太低,取一次数就把解码延迟拉长;主机内存容量有限,长上下文下能塞进去的请求数依然不多。两头一夹,解码吞吐上不去。 内存层级这条线:scale-up 内存池带来了新变量 XM-Sparse 的舞台是一种新硬件:scale-up 内存池。可以把它理解成——用 NVLink 这类高带宽互联,把一批专门的内存节点挂到 GPU 旁边,这些内存直接出现在 GPU 的地址空间里,GPU 可以点对点访问,不需要先经过主机内存中转。论文在表 1 里把几种方案摆在一起对比,差别一目了然。 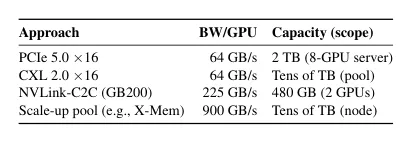
▲ 图2:四种内存扩展方案的带宽与容量权衡——PCIe 5.0 与 CXL 2.0 都是 64 GB/s,NVLink-C2C 是 225 GB/s 但只有 480 GB,而 scale-up 池(X-Mem)同时给出 900 GB/s 和几十 TB(对应原文第 3 页 Table 1) 数字很说明问题:PCIe 5.0 ×16 是 64 GB/s、单台 8 卡服务器 2 TB;CXL 2.0 把容量扩到几十 TB,但带宽还是 PCIe 那一档;NVLink-C2C(GB200)带宽升到 225 GB/s,容量却只有 480 GB。而 X-Mem 这类 scale-up 池给到每 GPU 900 GB/s、节点级几十 TB——带宽和容量同时松绑。论文提到,单个 X-Mem 节点设计上提供最高 24 TB 的 DDR5 和约 4 TB/s 的聚合内存带宽,加节点就能独立扩容容量和带宽。更有意思的是,池里的任意 GPU 都能通过 NVSwitch 访问任意内存节点。 于是作者提出那个核心问题:有了这么一块又大又快的外部内存,稀疏注意力服务的吞吐到底能推到多高?带着这个问题,他们先把现有方案放到这块硬件上做了一次彻底的"体检",结果发现了那个贯穿全文的关键转折。 核心洞察:容量瓶颈解掉后,卡脖子的仍是显存 作者用四个 B300 做解码、另外四个 B300 模拟 X-Mem 内存节点,跑 GLM-5.3、128K 上下文,把几种内存扩展配置摆到一起比。原文图 1 的结果很值得琢磨。 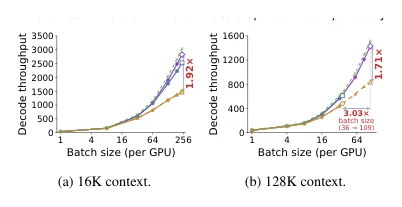
▲ 图1:不同内存扩展配置的解码吞吐。16K 下 scale-up 池是 PCIe 的 1.92 倍;128K 下 1 TB 容量把 batch 卡在 36,扩到 24 TB 后 batch 冲到 109(3.03 倍),scale-up 池此时是 CXL 的 1.71 倍(对应原文第 3 页 Figure 1) 分两种情况看。短上下文(16K)时,1 TB 外部内存已经够用,解码被 HBM 本身卡在每卡 241 个请求,这时 scale-up 池凭带宽优势拿到 PCIe 方案的 1.92 倍,再加容量也没用——因为 batch 已经到顶。长上下文(128K)时完全反过来:1 TB 池只能装下每卡 36 个请求的完整 KV,就算 C2C 带宽更高也使不上劲;把容量扩到 24 TB 后,batch 可以涨到每卡 109 个(3.03 倍)。此时 scale-up 池拿到 CXL 的 1.71 倍,吞吐已经达到"完全不卸载、只算不算搬"(compute-only)配置的约 94.2%。 但最关键的细节在这里:即便外部池有 24 TB,实际只用了大约 3 TB,GPU 侧却已经把 60 GiB 的 HBM 预算耗尽,batch 再也涨不上去了。换句话说,scale-up 池把"外部容量不够"这个瓶颈解决了,却把瓶颈原封不动地推给了 GPU 显存。论文给出的 takeaway 很干脆:想继续提吞吐,就得进一步卸载,把 HBM 腾出来给更大的 batch。这就是 XM-Sparse 全部设计的出发点——不是"用内存池替代显存",而是"用内存池的高带宽,去换 HBM 的容量"。 拆开两个缓存:一个怕延迟,一个怕带宽 要腾显存,得先搞清楚显存被谁占了。作者把现有系统里常驻 HBM 的两块状态——热 KV 缓冲区和 K-index 缓存——单独拎出来分析。原文图 2 显示,即便 KV 已经卸载,这些常驻状态连同模型权重仍吃掉约四成 GPU 显存。而在 128K 上下文下,仅 K-index 缓存一项就占了 DeepSeek-V3.2 约 33.7%、GLM-5.3 约 24.9% 的总 HBM。这两块正是可以进一步卸载的目标。 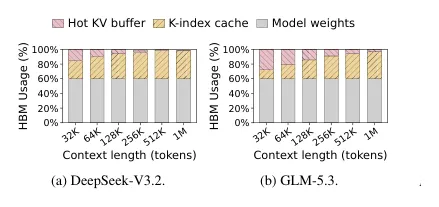
▲ 图3:显存占用分解示意——左为 DeepSeek-V3.2、右为 GLM-5.3,横轴是上下文长度,纵轴是 HBM 占比。热 KV 缓冲与 K-index 缓存这两块常驻状态是卸载的主要对象(对应原文第 4 页 Figure 2) 更重要的是,作者的洞察不止于"它们占地方",而是发现这两块缓存的访问模式截然不同,因而需要完全不一样的 I/O 手段。这构成了 XM-Sparse 设计的灵魂。 先看热 KV 缓冲区。现有系统习惯把它配成 Top-K 预算的 2 到 4 倍(选 2K token 就配 4K–8K 条目),目的是多缓存一些近期 token、降低缺失率。但在高带宽的 scale-up 环境里,这被证明是严重的过度配置。论文把缓冲缩到 2K,单请求显存直接省下 50%–75%;代价是缺失率从约 4%–10% 升到 25%,可在 128K、每卡 batch 64 的实测里,缺失率从 5% 抬到 30%,解码单步延迟只涨了 10.0%、吞吐只掉了 9.1%。 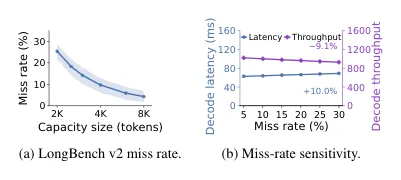
▲ 图4:热缓冲区的取舍。(a) 把缓冲从 2K 加到 8K,LongBench v2 的缺失率下降,但收益有限;(b) 128K、batch 64 下,缺失率 5%→30% 只让延迟 +10.0%、吞吐 −9.1%(对应原文第 4 页 Figure 3) 为什么缺失率涨这么多、性能却几乎不动?作者挖到了根因:KV 的按需取数受的是"延迟"限制,不是"带宽"限制。他们把 batch 从每卡 1 放大到 32(32 倍),取数的数据量同比膨胀,但平均 swap-in 内核延迟只从 74.1 微秒涨到 78.9 微秒(6.5%)。原因是现有 swap-in 内核每个请求只启动一个线程块、用 warp 顺序取数,SM 并行度极低,把延迟硬生生压在解码关键路径上;而且取回的 KV 要先存进 HBM、再读进共享内存参与计算,多了一次没必要的搬运。结论很明确:KV 取数需要的是低延迟、能跟计算重叠的机制。 再看 K-index 缓存,它走的是完全相反的路子。索引器每一步都要对所有历史 key 做一次完整扫描,这个访问顺序是可预测的、确定性的——这就意味着可以提前预取。但它的传输量极大:以 GLM-5.3、128K 上下文、单请求为例,完全卸载 K-index 每步要传约 363 MB,而 15% 缺失率下的 KV 缺失数据只有 15.7 MB,两者差了一个数量级。所以 K-index 卸载需要的是高带宽、且尽量不干扰计算内核的机制。 一个怕延迟、要能重叠;一个怕带宽、要少干扰——作者把这个差异总结成一句话:缩小热 KV 缓冲、卸载 K-index 缓存,都要求"低干扰、可重叠"的 I/O;KV 取数要低延迟,K-index 预取要高带宽。接下来他们把 GPU 原生的三种数据搬运方式挨个测了一遍,看谁适合干哪件活。 三种搬运方式的取舍:TMA 取数,DMA 预取 GPU 访问外部内存主要有三种方式:普通的 load/store 指令、张量内存加速器 TMA,以及 DMA。作者在并发解码(128K、batch 64)的情况下,分别测了它们的带宽和对解码吞吐的干扰,结果整理在原文图 5 里。 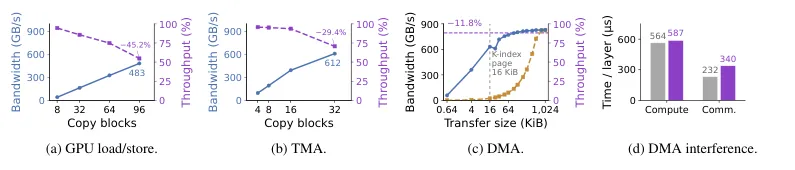
▲ 图6:GPU I/O 带宽与解码干扰。(a) load/store 达 483 GB/s 但吞吐掉 45.2%;(b) TMA 16 块达 394 GB/s 仅掉 6.3%;(c) DMA 小传输受 CPU 提交拖累,预排队执行才上量;(d) 大流量 DMA 主要干扰 NCCL 通信而非计算内核(对应原文第 5 页 Figure 5) load/store 简单粗暴:加 copy 块能提带宽,但会跟解码抢 SM 资源。656 字节的 KV 传输开到 96 块能到 483 GB/s,代价是并发解码吞吐暴跌 45.2%,单消息延迟却几乎固定在 3.8 微秒。TMA 聪明一些,能把 KV 直接抓进共享内存、在同一个内核里消费,省掉中间搬运:同样 656 字节,16 块就有 394 GB/s,吞吐只掉 6.3%;加到 32 块带宽冲到 612 GB/s,干扰也涨到 29.4%。TMA 延迟低、干扰适中,是按需 KV 取数的合适人选,但它发起传输也要占用 warp 和共享内存,不适合干高带宽的 K-index 预取。 DMA 走的是另一条路:CPU 驱动把传输命令入队、按门铃通知 GPU,由专门的 copy engine 搬数据,全程不占 SM。问题出在小传输上——对代表性的 16 KiB 索引页,CPU 连续提交只有 22.9 GB/s,而预排队执行(排除提交开销)能到 632 GB/s;提交率被限制在每秒约 140 万次。更妙的发现是干扰来源:1 GiB、约 808 GB/s 的大流量 DMA 会让解码吞吐掉 11.8%,拆分到内核级别后发现,主要是 MoE dispatch/combine 的 NCCL 通信内核时间涨了 46.2%,而计算内核只涨 4.1%。这说明 DMA 虽然不占 SM,却会跟模型通信抢 scale-up 互联的带宽。综合下来:TMA 适合低延迟 KV 取数,DMA 适合高带宽 K-index 预取,但 DMA 必须解决"提交太慢"和"跟通信抢带宽"这两个问题。 系统总览:把两个缓存都搬出显存 有了上面的判断,XM-Sparse 的整体架构就顺理成章了。它保留了模型的 token 选择和稀疏注意力语义,只改变数据的摆放位置和搬运方式:外部内存池给 KV 和 K-index 提供后备存储,HBM 里只留三样东西——热 KV 缓冲区、常驻的 K-index 页、可复用的 staging 缓冲区。每个请求、每个注意力层有一个热 KV 缓冲,容量启动时固定;新产生的缓存条目先写进 HBM,再异步传播到内存池。 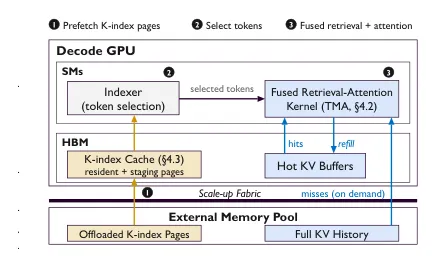
▲ 图7:XM-Sparse 系统总览。解码时 K-index 预取随层计算推进,索引器选完 token 后由融合内核按需取回缺失 KV 并算注意力;热缓冲命中直接复用,缺失走 scale-up fabric 从内存池取(对应原文第 6 页 Figure 6) 系统里有两个关键角色。一是缓存管理器(cache manager),维护两套缓存的数据映射和缓冲区分配,决定哪些 K-index 页常驻、哪些走 staging 区;调度器组 batch 时要先过它的显存容量和传输预算两道检查。二是两条数据通路:对动态确定的 KV 访问,用"融合检索 + 注意力";对可预测的 K-index 访问,用"预取"。原文图 6 把整个解码流程串了起来——K-index 预取和层计算并行推进,所需页就绪后索引器追加当前 token 的 key 并选 token,选出的 token ID 再驱动融合 KV 检索和注意力。下面分别拆解这两招。 第一招:融合 kernel,把"取数"藏进"算注意力" 热缓冲缩小意味着缺失变多,如果还按老办法——先单独跑一个 swap-in 内核把缺失 KV 全取回来,再开始算注意力——那段取数延迟就赤裸裸地暴露在关键路径上。光把两步"融合"成一个内核还不够,因为数据依赖还在。XM-Sparse 的做法是:给 KV tile 重排顺序,再把取数和计算流水起来。 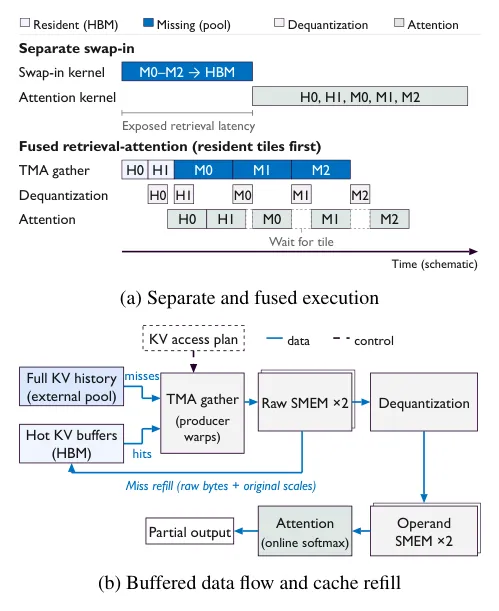
▲ 图8:融合 KV 检索与注意力。(a) 对比"独立 swap-in"与"常驻 tile 优先的 tile 级流水",后者把后续 tile 的取数藏在注意力计算后面;(b) 双缓冲共享内存里的数据流与热缓冲回填(对应原文第 7 页 Figure 7) 第一招叫"常驻优先遍历"。内核用在线 softmax 累加所选 KV tile 的注意力结果,但刻意把常驻在 HBM 里的 tile 排在前面遍历。这样,当计算在啃常驻 tile 时,缺失 tile 的取数就能在后台悄悄进行。选完 token 后,缓存管理器把命中项和缺失项分成两个列表:命中项指向 HBM 地址,缺失项指向内存池地址并带上回填槽位;内核把它们打包成 tile,逻辑顺序上常驻在前、缺失在后,再由 Split-K 切成连续片段交给各线程块并行。纯缺失的线程块先等第一个 tile 到齐,之后就用当前 tile 的注意力去重叠后续 tile 的取数,最后按 softmax 归一化统计把各片段的部分结果合并。 第二招是"tile 级流水"。内核把取数、反量化、注意力分给不同的 warp 和 warpgroup,用双缓冲的共享内存连接:producer warp 发 TMA 把数据从 HBM 或内存池抓进共享内存,远端 KV tile 直接从共享内存被消费、不必先落 HBM,反量化和注意力各管一段。只有当某个 tile 就绪,下游阶段才会消费它;缓冲区的数量决定了取数能"跑在前面"多远。还有个顺手的好处——回填热缓冲不需要再读一次内存池:内核在反量化时把原始量化字节直接写进指定槽位、保留原尺度,省掉一整趟搬运。论文的实现基于 SGLang,约 8K 行 Python 与 C++/CUDA 代码,包含改造过的 FlashMLA 内核。 第二招:GPU 发起的 DMA,再加优先级调度 K-index 卸载里,页级粒度会产生大量小传输,CPU 提交会拖垮吞吐。XM-Sparse 的解法是把"生成传输命令"这件事挪到 GPU 上,但保留批级的 CPU 发布。一个只占单个 SM 的 GPU producer 读取缓存管理器的拷贝列表,生成"内存池源页 → HBM 目的地址"的 DMA 命令,然后更新固定主机内存里的就绪计数器;CPU worker 轮询这个计数器,把就绪的命令批次批量发布到 copy engine 队列并按下门铃,copy engine 负责搬数据并回报完成。这样一来,CPU 的工作量从"按页"降到"按批",数据搬运交给 copy engine,彻底绕开了提交速率的天花板。 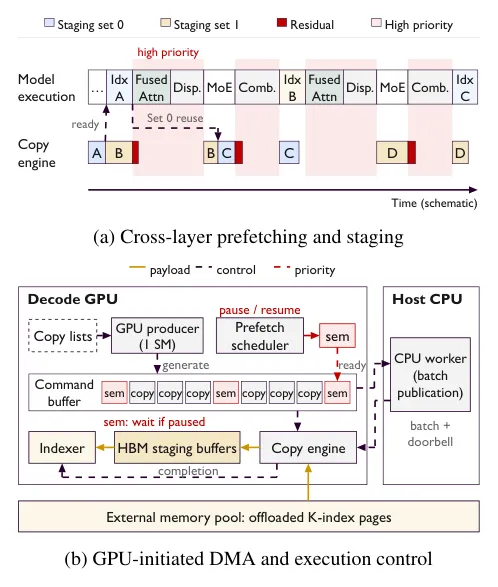
▲ 图9:K-index 预取。(a) 跨层 staging 复用与优先级调度,重复的字母表示同一层预取的片段、红色尾部表示暂停后仍在途的传输;(b) GPU 生成命令、CPU 批量发布、copy engine 搬数据的分工(对应原文第 7 页 Figure 8) 光快还不够,不能添乱。前面测过,K-index 预取的流量会跟按需 KV 取数、模型通信抢 scale-up 互联带宽。于是作者加了优先级调度:在融合注意力、MoE dispatch、MoE combine 这三类操作期间暂停预取,操作结束再恢复。实现上很轻巧——模型 CUDA 流上的内核在这些受保护操作前后更新 GPU 内存里的信号量,producer 在命令批次开头和 DMA 命令流的固定间隔插入"等待信号量"命令,copy engine 到检查点就暂停,已经在途的传输正常完成。因为 copy engine 直接读信号量,暂停和恢复都不需要 CPU 往返。此外,缓存管理器采用按需分配、两组 staging 缓冲交替复用,并用"上一步解码耗时"作为传输预算来判断一个新请求能不能进 batch,超预算的请求继续排队。 实验怎么搭:两个大模型,从 16K 到 1M 测试平台是一台配两颗 Intel Xeon 6767P、2 TB 主机内存、8 张 B300(每卡 268 GiB HBM)的服务器。每张卡有 900 GB/s 单向 NVLink 5.0 带宽和 PCIe 5.0 ×16(每方向 64 GB/s)。四张卡跑解码实例,另外四张卡充当 X-Mem 虚拟机的内存节点;超过 1 TB 物理内存的部分靠重复映射成更大的虚拟地址空间来模拟。模型选了 DeepSeek-V3.2 和 GLM-5.3,都用 FP8 权重、DP4 注意力、EP4 MoE,Top-K 都是 2048;两者一个关键区别是 K-index 是否跨层复用——DeepSeek-V3.2 不复用,GLM-5.3 复用。 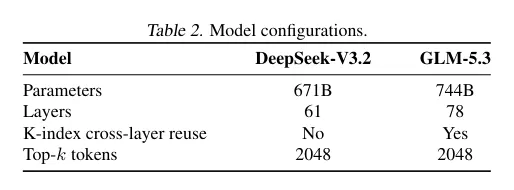
▲ 图10:两个评测模型的配置对比。DeepSeek-V3.2 为 671B 参数、61 层、K-index 不跨层复用;GLM-5.3 为 744B 参数、78 层、K-index 跨层复用;两者 Top-k 均为 2048(对应原文第 9 页 Table 2) 请求从 LongBench v2 采样,输入长度覆盖 16K 到 1M、输出固定 128 token;默认每请求 4K 热 KV 缓冲、约 15% 缺失率,每解码卡给 60 GiB 常驻状态预算。基线有三个:开源的稀疏注意力卸载系统 ECHO、集成在 SGLang 里的生产级框架 HiSparse,以及把 HiSparse 的主机内存后端换成 X-Mem 的"朴素集成"HiSparse + X-Mem。指标是在相同 batch 下比较平均 token 间隔时间(TBT),同时报告每卡最高生成吞吐及对应 batch。需要说明的是,为了在物理内存限制下评估吞吐,吞吐实验采用固定 15% 缺失率和轮询专家路由。 结果一:延迟更低,吞吐全面领先 端到端结果如原文图 9。先看延迟:相比 ECHO,XM-Sparse 的 TBT 在 DeepSeek-V3.2 上降低 30.0%–56.0%、在 GLM-5.3 上降低 39.6%–66.6%;相比 HiSparse 则分别降低 7.4%–35.8% 和 9.5%–45.8%。大 batch 下,X-Mem 的高带宽压缩了 KV 传输时间;小 batch 下,融合靠重叠取数和计算改善了延迟。 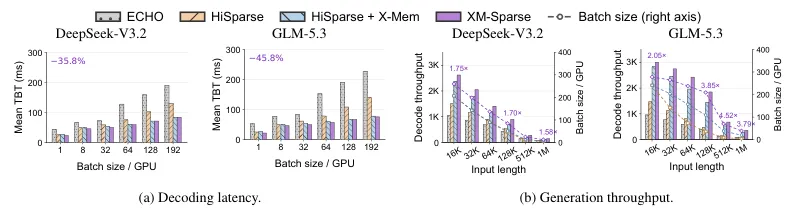
▲ 图12:端到端解码性能。(a) 相同 batch 下的平均 TBT,紫标给出相对 HiSparse 的降幅;(b) 16K 到 1M 各输入长度下的生成吞吐,虚线是每卡所选 batch,GLM-5.3 上相对 HiSparse 最高 4.52 倍(对应原文第 10 页 Figure 9) 再看吞吐,这是最亮眼的部分。相对 ECHO,DeepSeek-V3.2 上提升 1.72–2.50 倍、GLM-5.3 上提升 3.14–4.98 倍;相对 HiSparse 分别是 1.57–1.75 倍和 2.05–4.52 倍。这些收益主要来自 X-Mem 的高带宽,而它的大容量在长上下文下还支持更多并发请求。更公平的比较是跟同样用 X-Mem 后端的朴素集成比——这才扣除了硬件红利、只看软件设计:XM-Sparse 在 DeepSeek-V3.2 上领先 1.10–1.34 倍、GLM-5.3 上领先 1.06–1.29 倍。举个具体例子:128K 上下文的 GLM-5.3,所选 batch 从每卡 109 涨到 209,吞吐从 1437.9 涨到 1849.3 tokens/s/GPU。 结果二:上下文越长,优势越大 原文图 9(b) 里还有个趋势值得单独拎出来:上下文越长,XM-Sparse 相对基线的吞吐优势越明显。原因不难理解——上下文越长,完整 KV 历史越大,外部池的"大容量"和"腾出 HBM 换更大 batch"这两项收益就被放大得越厉害。在附录的 1M 上下文实验里,这个规律走到了极致。 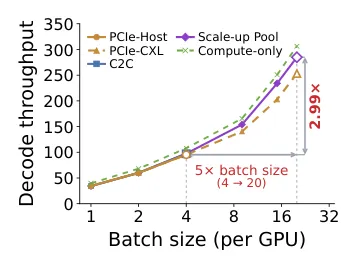
▲ 图15:1M 上下文下不同内存扩展配置的解码吞吐。1 TB 池只放得下每卡 4 个请求的完整 KV,扩到 24 TB 后可跑 HBM 受限的 batch 20(5 倍),吞吐是 PCIe-Host 的 2.99 倍(对应原文第 13 页 Figure 12) 1M 时,容量成了最紧的约束:1 TB 的池只够存每卡 4 个请求的完整 KV;扩到 24 TB 后,才能跑 HBM 受限的 batch 20,吞吐相应提升 2.99 倍、batch 增大 5 倍。这正是 XM-Sparse 把 HBM 腾干净的价值所在——长上下文场景下,每多腾出一点显存,都能直接换成几个并发请求。 消融:每一项设计到底值多少 作者用消融实验把收益拆账。表 3 显示两项核心优化各自的分量:关掉融合 kernel 时平均 TBT 是 25.93 ms,打开后降到 21.86 ms,改善 15.7%;K-index 卸载则在 128K 下把吞吐从 1437.9 抬到 1849.3 tokens/s/GPU,提升 28.6%——这部分几乎全部来自腾出 HBM 后 batch 从 109 涨到 209。 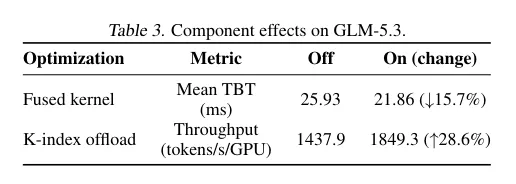
▲ 图11:组件消融表。融合 kernel 让平均 TBT 从 25.93 ms 降到 21.86 ms(↓15.7%);K-index 卸载让吞吐从 1437.9 升到 1849.3 tokens/s/GPU(↑28.6%)(对应原文第 9 页 Table 3) 定制 I/O 的价值在原文图 10 里更直观:128K、batch 209 的 GLM-5.3 上,GPU 发起且带优先级调度的 DMA 达到 1849.3 tokens/s/GPU,而 CPU 提交的 DMA 只有 33.5、基于 SM 的卸载是 1128.7——比后者高 63.8%。拆开看,GPU 侧生成命令削掉了提交开销,copy engine 搬运限制了 SM 争用,优先级调度又减少了对 KV 取数和模型通信的干扰。而且页越小,GPU 发起 DMA 的优势越大:16 KiB 消息下它跑出 624.0 GB/s,而普通 DMA 只有 22.4 GB/s;到 1 MiB 时两者才都逼近 830 GB/s——因为消息越大,提交开销越不重要。 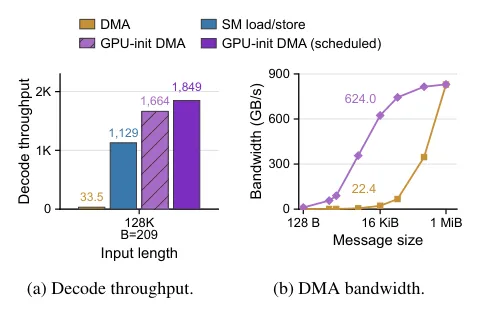
▲ 图13:GLM-5.3 在 128K、batch 209 下的卸载效果。(a) 带调度的 GPU 发起 DMA 达 1849.3 tokens/s/GPU,是 SM 方案的 1.64 倍;(b) 独立带宽随消息大小变化,16 KiB 时 GPU 发起 DMA 是普通 DMA 的近 28 倍(对应原文第 10 页 Figure 10) 两组敏感度测试进一步印证了设计的稳健性。其一是缺失率:从 0% 升到 40%,XM-Sparse 的平均 TBT 只从 72.09 涨到 84.98 ms(17.9%),而 HiSparse 从 72.36 一路涨到 250.17 ms;40% 缺失时 XM-Sparse 把 TBT 压低了 66.0%——因为多出来的 KV 流量走的是更高带宽的 X-Mem 通路。其二是热缓冲大小:把缓冲从 4K 缩到 2K,XM-Sparse 吞吐在 16K、32K 下分别涨 34.4%、32.7%,HiSparse 却跌了 23.2%、19.5%;16K 下 XM-Sparse 的 batch 从 278 涨到 507。同样是把缓冲缩小,一个借高带宽吃掉额外缺失、换到更大 batch,另一个被 PCIe 的缺失代价拖垮——高下立判。 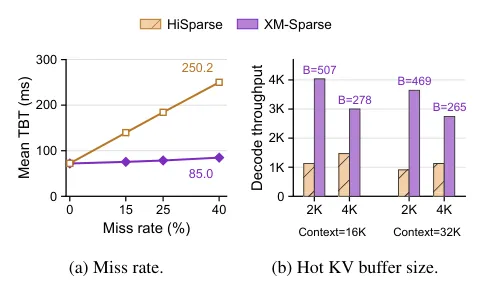
▲ 图14:GLM-5.3 敏感度分析。(a) 缺失率 0%→40%,XM-Sparse 的 TBT 只涨 17.9%,HiSparse 却涨到 250 ms;(b) 热缓冲从 4K 缩到 2K,XM-Sparse 吞吐反涨三成、HiSparse 下跌(对应原文第 10 页 Figure 11) 适用边界:这套方案不是万能的 先把边界讲清楚,免得神话它。第一,它强依赖 scale-up 内存池这类硬件——900 GB/s 级互联、节点级几十 TB 容量,还得是 GPU 地址空间可直接点对点访问的那类。没有这种硬件,特别是没有高带宽 fabric,"用带宽换显存"的前提就不成立。第二,论文的性能数字是在 X-Mem 虚拟机上"模拟"出来的:用四张额外的 B300 当内存节点,超过 1 TB 的容量靠重复映射模拟,吞吐实验还固定了 15% 缺失率、用轮询专家路由。这些是为了绕开物理内存限制的评测手段,真实部署的表现要看实际硬件和真实访问分布。 第三,它针对的是带 K-index 的动态稀疏注意力模型(如 DeepSeek-V3.2、GLM-5 系列), relies on 每层 Top-K 选择这一语义;换成稠密注意力或索引结构完全不同的模型,前提就变了。第四,它聚焦解码阶段(DP 注意力 + EP MoE),预填充(prefill)阶段不在讨论范围内。第五,工程门槛不低——要改 FlashMLA 内核、要写 GPU 发起的 DMA 库,约 8K 行代码,普通服务栈想抄这套作业并不轻松。最后,scale-up fabric 是与模型集合通信共享的,预取流量和 KV 取数、MoE 通信之间的争用只能通过优先级调度缓解,无法根除;调度检查点的间隔设置也是个需要按硬件调的旋钮。 还能怎么改:从这篇论文往前看一步 站在 XM-Sparse 的肩膀上,几个方向呼之欲出。一是把优先级调度做得更细:现在是按固定间隔插检查点、暂停整类操作,如果能根据实时带宽占用和通信内核的实际时序动态调整检查点,或许能进一步榨干 fabric 利用率。二是 DMA 提交率的天花板——每秒约 140 万次的限制说明小传输批次仍有优化空间,把更多控制逻辑固化到硬件或驱动里是可能的路。三是把这套"按访问模式定制 I/O"的思路推广到更多层级:HBM、scale-up 池之外还有 CXL、主机内存乃至 NVMe,多级缓存之间谁常驻、谁预取、谁按需取,是个更大的优化空间。 四是工作负载层面:论文用的是固定 15% 缺失率和采样自 LongBench v2 的输入,真实线上请求的缺失分布、请求长度混合、多租户争抢会复杂得多,缓存管理器按"上一步耗时"估传输预算的策略在抖动场景下是否稳,值得再验证。五是既然瓶颈已经从外部容量转到 HBM,那么模型权重、激活、KV、索引这几类状态之间如何动态分配那 60 GiB 预算,本身就是一个可以继续做的联合优化问题——论文里总缓存 HBM 几乎不变(64.2 对 64.3 GB),只是 K-index 与热 KV 之间挪了位置,这暗示预算分配的自由度还没被用尽。 小结 回到最初那个问题:有了又大又快的 scale-up 内存池,稀疏注意力服务的吞吐能推到多高?XM-Sparse 的回答分三层。第一层是诊断——内存池解掉了外部容量瓶颈,却把瓶颈推给了 HBM,而热 KV 缓冲和常驻 K-index 缓存正是最后两块显存大户。第二层是洞察——这两块缓存的访问模式相反:KV 取数动态、怕延迟,K-index 扫描确定、吃带宽,因此不能用同一种 I/O 对待。第三层是工程——KV 走 TMA 融合检索与注意力、tile 级流水把取数藏进计算,K-index 走 GPU 发起的 DMA 预取、再用信号量做优先级调度。三层叠起来,换来的是 128K 到 1M 上下文上相对 PCIe 基线最高 4.98 倍的解码吞吐、相对同平台朴素集成最高 1.34 倍的提升。 这篇论文真正的启发,也许不在某个具体的倍率,而在它示范的一种系统思路:当硬件把一层瓶颈抹平时,不要急着庆祝,而要去找那层新的瓶颈;当一个系统里存在多种访问模式时,与其用一种"万能"机制将就,不如为每种模式量身定制搬运方式。把"算得少、存得多"这个长期错配,用内存层级和精细 I/O 一点点纠正过来——这正是它让长上下文解码吞吐翻近 5 倍的底层逻辑。 论文原文:XM-Sparse: High-Throughput Sparse-Attention LLM Serving over Scale-up(arXiv:2611.22280),完整地址:https://arxiv.org/abs/2611.22280 一句话结论 · 欢迎直接转发 XM-Sparse 把 KV 缓存与 K-index 索引同时卸载到 scale-up 内存池:用 TMA 融合检索与注意力、用 GPU 发起的 DMA 预取索引,把长上下文解码吞吐最高提升 4.98 倍。 小哥的人工智能笔记 专注 AI 基础设施:推理加速 / 量化 / 训练系统 / AI 芯片。每天拆一篇 arXiv 硬核论文,只讲工程上真正有用的部分。 点击上方蓝字关注「小哥的人工智能笔记」 账号主页:https://mp.weixin.qq.com/mp/profile_ext?action=home&__biz=MzkzMTIzNDA2NQ==