 夜雨聆风
苦猿的大模型日记 · Day34 · 文档解析与切块实战-帮普通人把AI学进简历系列
前言:一场"理直气壮答错"的翻车现场
你把公司那份 30 页的 PDF 产品手册丢进 RAG,跑通了。
同事过来问:"X3 这款扫地机器人,退换货政策是几天?"
模型答得头头是道:"支持 15 天无理由退货。"
错。手册白纸黑字写的是 7 天。
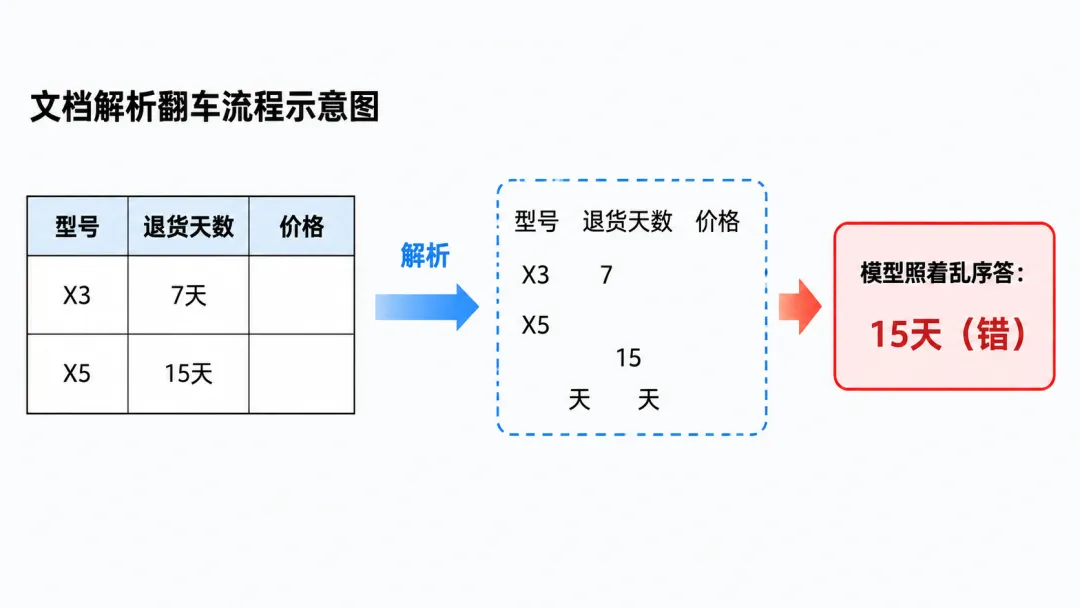
你不服,翻开 PDF 那一页——答案就在一张三列的表格里,X3 对应 7 天,隔壁 X5 才是 15 天,清清楚楚。
然后你打开自己入库的那份文本,愣住了:那张规规矩矩的表格,被解析成了一串上下错位、行列全乱的数字,X3 的"7"和 X5 的"15"挤在了一起,中间还塞进了半行页脚。
模型没有幻觉。它非常忠实地照着那坨乱序文本,答了一个理直气壮的错误答案。
垃圾进,垃圾出。
很多人 RAG 做不准,第一反应是换 embedding、加 reranker、上 Agentic 那一整套。但我想先泼一盆冷水:你的准确率天花板,在文档进库那一刻就已经定死了。检索层再牛,也捞不回一份在解析阶段就烂掉的文本。
前面几篇讲 RAG,我都是从"假设你已经有一份干净的文本"开始的。今天把这个假设拆掉。真实世界里,从一份 PDF、扫描件、Word,到一份"干净、可切、带结构"的文本,这中间全是坑。而这一步,恰恰是几乎所有教程都跳过的。
PART 01:被所有教程跳过的一步——文档进库之前发生了什么
打开任何一篇 RAG 教程,第一行代码几乎都长这样:
text = "这是一段已经准备好的干净文本..."
# 或者
docs = loader.load()  # 假装 load 出来就是干净的
默认文本已经干净。但你在真实项目里拿到的是什么?是一堆 PDF、扫描件、Word、Excel、还有从网页上扒下来的 HTML。
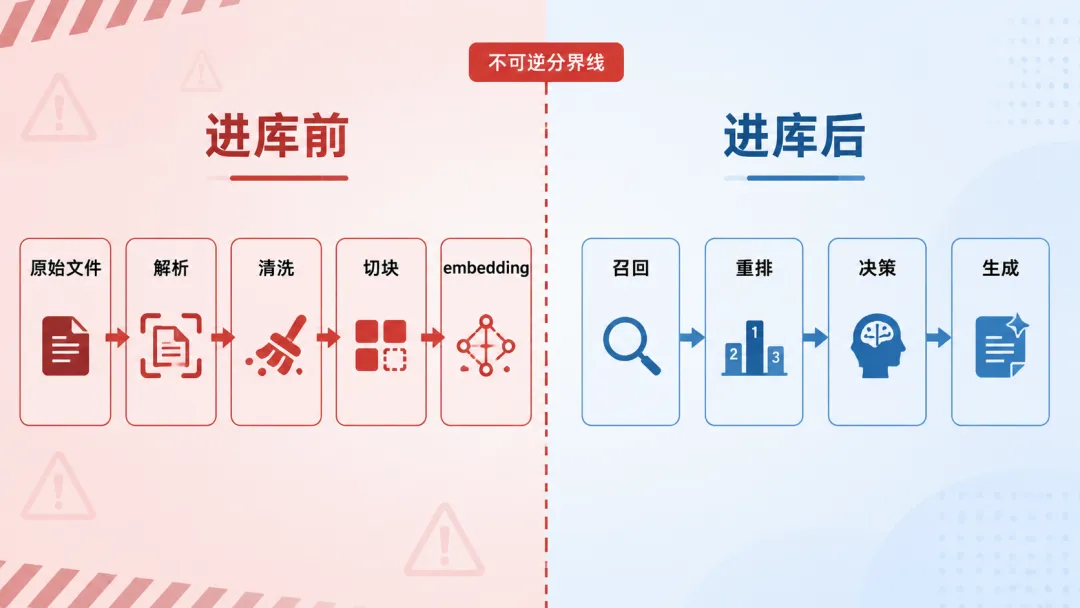
一条完整的 RAG 链路,其实分成两段。大多数人的注意力,全在后半段。
- 进库前
:原始文件 → 解析 → 清洗 → 切块 → embedding - 进库后
:召回 → 重排 → 决策 → 生成
进库后的每一步,网上有大把教程教你调优——换更强的 embedding、加 cross-encoder 重排、上多路召回。但进库前这一段,几乎是真空。
而这里有个残酷的事实:进库前的错误是不可逆的。
切错的块、丢掉的表格、错位的 OCR 文本,到了召回层你无从补救。更麻烦的是,你甚至不知道它错了——因为召回分数看起来一切正常。向量库不会告诉你"这个块是半张表格",它只会老老实实返回一个 0.87 的相似度,然后你对着这个漂亮的分数,百思不得其解为什么模型答得不对。
真实文档大致四种形态,各有各的坑。这是我们今天要打的战场地图:
- 电子版 PDF(有文本层)
:多栏乱序、页眉页脚噪音、表格被拍扁成一维 - 扫描件 / 图片 PDF(无文本层)
:必须 OCR,还得先做版面分析 - Office 文档(Word/Excel/PPT)
:样式不等于结构,合并单元格是灾难 - 网页 / Markdown
:HTML 标签噪音、标题层级信息容易丢
最贵的从来不是模型。最贵的是你没意识到自己喂了脏数据——因为脏数据不会报错,它只会让你在召回准确率上原地打转,怎么调都差一口气。
PART 02:解析实战——四类文档,四种武器(表格是重灾区)
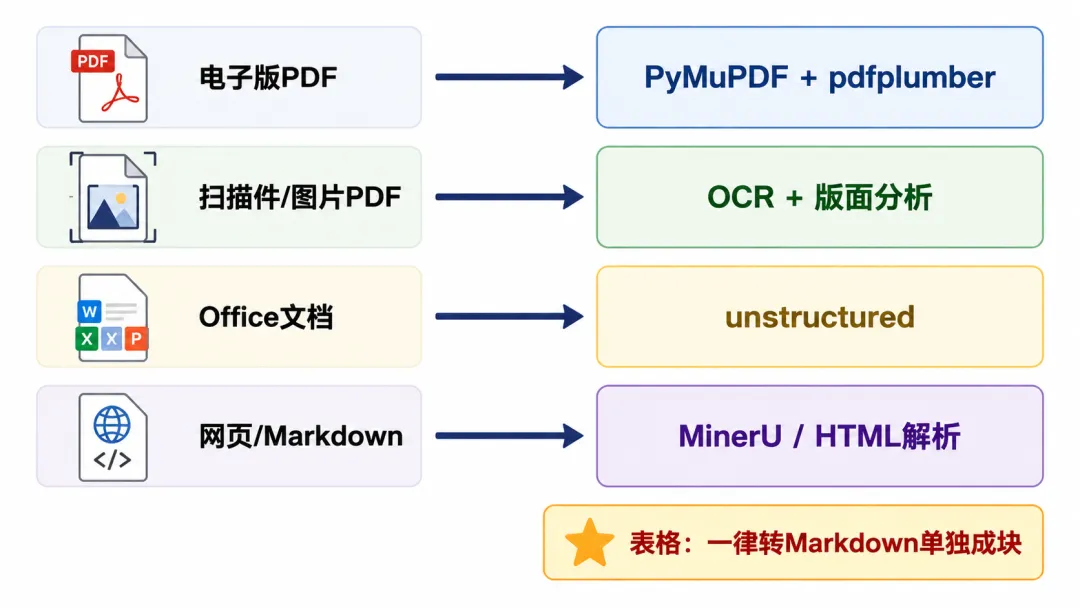
先记住一个原则:没有万能钥匙,按文档类型选工具。
武器一:电子版 PDF —— PyMuPDF 取正文,pdfplumber 抽表格
电子版 PDF 是最常见的,也最容易让人掉以轻心。很多人上手就是一个库梭到底,结果正文没问题,表格全乱。
正确的分工:正文交给 PyMuPDF(import 名是 fitz),它快、擅长纯文本;表格单独交给 pdfplumber,用它的 extract_tables() 把二维结构抠出来。
import fitz          # PyMuPDF
import pdfplumber

def parse_pdf(path: str):
    blocks = []

    # 1. 用 PyMuPDF 按页取正文(快)
    doc = fitz.open(path)
    for page_no, page in enumerate(doc):
        text = page.get_text("text")   # 保留基本阅读顺序
        blocks.append({"type": "text", "page": page_no, "content": text})
    doc.close()

    # 2. 用 pdfplumber 单独抽表格(保结构)
    with pdfplumber.open(path) as pdf:
        for page_no, page in enumerate(pdf.pages):
            for table in page.extract_tables():
                md = table_to_markdown(table)
                blocks.append({"type": "table", "page": page_no, "content": md})

    return blocks

def table_to_markdown(table: list[list]) -> str:
    """把二维表格转成 Markdown,保留行列对应关系"""
    if not table or not table[0]:
        return ""
    header = table[0]
    md = "| " + " | ".join(str(c or "") for c in header) + " |\n"
    md += "| " + " | ".join(["---"] * len(header)) + " |\n"
    for row in table[1:]:
        md += "| " + " | ".join(str(c or "") for c in row) + " |\n"
    return md
为什么非得两个库?因为 PyMuPDF 的 get_text() 遇到表格,会把它当普通文本按坐标顺序吐出来——那张退货政策表,就是这么被拍平成乱序数字的。而 pdfplumber 会分析线框和单元格边界,还原出真正的行列。
武器二:扫描件 / 图片 PDF —— OCR 加版面分析
如果 PDF 是扫描件、拍照件,或者干脆是图片,PyMuPDF 取出来是空的——因为它压根没有文本层。这时候必须上 OCR。
但注意,不是简单 OCR。直接对整页做文字识别,遇到双栏排版,会把"左栏第一行 + 右栏第一行"横着串起来读,语义彻底乱套。正确做法是先做版面分析(layout analysis):把页面切成标题、正文、表格、图片几个区域,再分区识别。
PaddleOCR 的 PP-Structure 就是干这个的:
from paddleocr import PPStructure

engine = PPStructure(show_log=False, lang="ch")

def parse_scanned_pdf(img_path: str):
    result = engine(img_path)        # 先版面分析,再分区 OCR
    blocks = []
    for region in sorted(result, key=lambda r: r["bbox"][1]):  # 按纵坐标排序,保阅读顺序
        rtype = region["type"]       # text / title / table / figure
        if rtype == "table":
            # 表格区域直接输出 HTML,保留结构
            blocks.append({"type": "table", "content": region["res"]["html"]})
        elif rtype in ("text", "title"):
            text = "".join(line["text"] for line in region["res"])
            blocks.append({"type": rtype, "content": text})
    return blocks
关键就是那句 sorted(..., key=bbox[1])——按区域的纵坐标排序,把阅读顺序捋直,双栏才不会串行。
武器三:懒人一体化 —— unstructured 与 MinerU
如果你不想为每种文档手写解析逻辑,有两个一体化方案值得认识。
unstructured 的 partition() 能自动识别文件类型并分流,输出一串带类别标签的 Element(Title、NarrativeText、Table、ListItem……)。类别标签很有用,后面切块能直接拿来做结构切分。
from unstructured.partition.pdf import partition_pdf

elements = partition_pdf(
    filename="manual.pdf",
    strategy="hi_res",              # 高精度模式,带版面分析
    infer_table_structure=True,     # 表格还原成 HTML
)

blocks = []
for el in elements:
    category = el.category          # Title / NarrativeText / Table / ListItem
    if category == "Table":
        # 表格取 HTML 而不是纯文本
        html = el.metadata.text_as_html
        blocks.append({"type": "table", "content": html})
    else:
        blocks.append({"type": category, "content": el.text})
MinerU 是另一个近来很能打的开源项目,专门把 PDF 转成结构良好的 Markdown,表格和公式的还原能力尤其强。文档偏学术、公式多的场景,可以优先试它。
重灾区专章:表格为什么必须被特殊对待
前面三种武器我都反复强调了表格。这里说透为什么。
表格是二维结构——行和列的交叉才有意义。而纯文本是一维的。你要是简单地把单元格 join 成一串,行列对应关系当场丢失。回到开头那张退货政策表:X3 那一行的"7",一旦脱离了"X3"这个行标签,就变成了一个悬空的数字,模型根本不知道它属于谁。
正确做法只有一个思路:把表格转成 Markdown 或 HTML,保留行列结构。这样 LLM 读到 | X3 | 7天 | ¥1299 | 这一行,才能理解"7 天对应的是 X3"。
还有一条铁律:一个块 = 一张完整表格 + 它的标题,绝不切开。这一点我们放到切块那部分再细讲,但你现在就要记住——表格是切块阶段的高压线。
PART 03:解析完还不够——那些让召回悄悄变脏的噪音
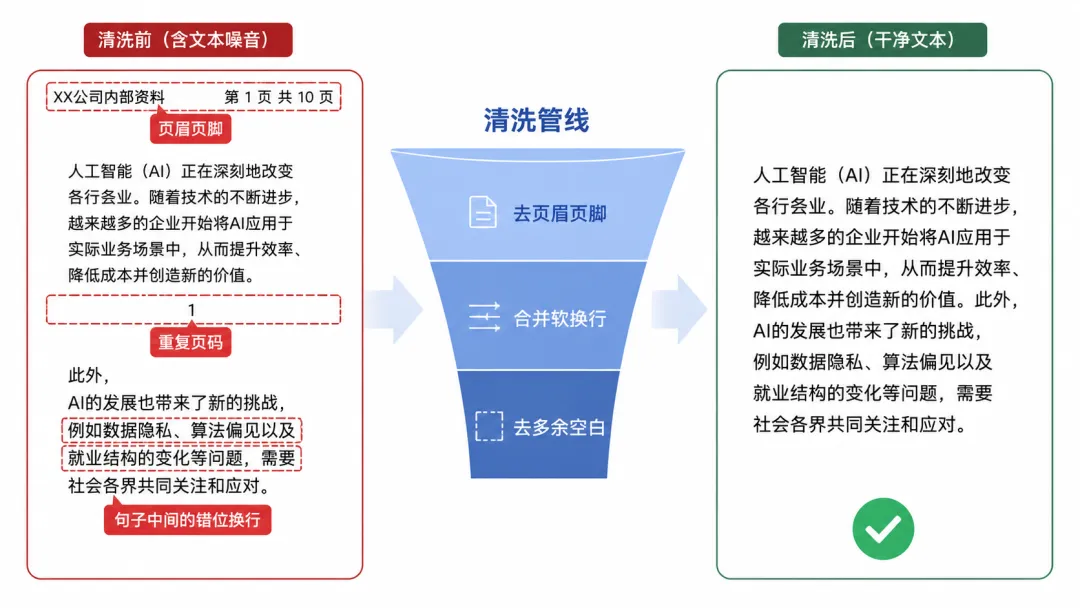
解析出文本,不等于干净文本。文本里往往还混着一堆你没注意到的噪音,它们不会让程序报错,只会悄悄拉低召回质量。
三类最高频的:
一是页眉页脚、水印、页码。这些东西每一页都重复出现。你把整本手册切块入库,"XX 公司版权所有 第 12 页"这种字符串会反复混进正文块里。embedding 一算,这些高频噪音稀释了真正的语义。
二是多栏错位。双栏排版的论文、手册,如果解析工具没处理好阅读顺序,出来就是左右两栏横着串行——读起来每一句都断头断尾。
三是软换行和断字。PDF 里一句完整的话,因为排版被物理换行拆成了好几行,\n 就这么混进了句子中间。切块和 embedding 都会被这些假换行干扰。
给一个可复用的清洗管线:
import re
from collections import Counter

def clean_text(pages: list[str]) -> str:
    # 1. 检测并去掉页眉页脚:出现在 >80% 页面的短行
    line_freq = Counter()
    for page in pages:
        for line in page.splitlines():
            line = line.strip()
            if 0 < len(line) < 40:          # 只看短行,正文长句不算
                line_freq[line] += 1
    threshold = len(pages) * 0.8
    headers_footers = {ln for ln, c in line_freq.items() if c >= threshold}

    cleaned_pages = []
    for page in pages:
        lines = [ln for ln in page.splitlines()
                 if ln.strip() not in headers_footers]
        cleaned_pages.append("\n".join(lines))

    text = "\n".join(cleaned_pages)

    # 2. 合并软换行:句子中间的换行去掉,段落间的保留
    #    规则:如果换行前不是句末标点,判定为软换行
    text = re.sub(r"(?<![。!?.!?:;\n])\n(?!\n)", "", text)

    # 3. 去多余空白和控制符
    text = re.sub(r"[ \t]+", " ", text)
    text = re.sub(r"\n{3,}", "\n\n", text)
return text.strip()但清洗要适度。这是个反直觉的点:过度清洗会把有意义的换行——列表项、代码缩进、表格分行——也一起抹平。所以清洗规则要跟着文档类型走:散文类可以放心合并软换行;代码文档、结构化手册,就得手下留情。
噪音的危害很隐蔽:它不改变召回分数的量级,但会系统性地拉低 top-k 的信噪比。你召回了对的块,可块里 30% 是页脚和乱序,喂给 LLM 就等于凭空多了 30% 的干扰。模型不是变笨了,是你给它的卷子上印了别的题。
PART 04:切块的真相——固定长度切块为什么必翻车
到了切块。之前我给过一个经验起点:中文场景 chunk_size=500、overlap=50。那个数字能让你"跑起来"。今天讲的是,它在真实文档上为什么会翻车,以及怎么救。
固定长度切块,有三宗罪:
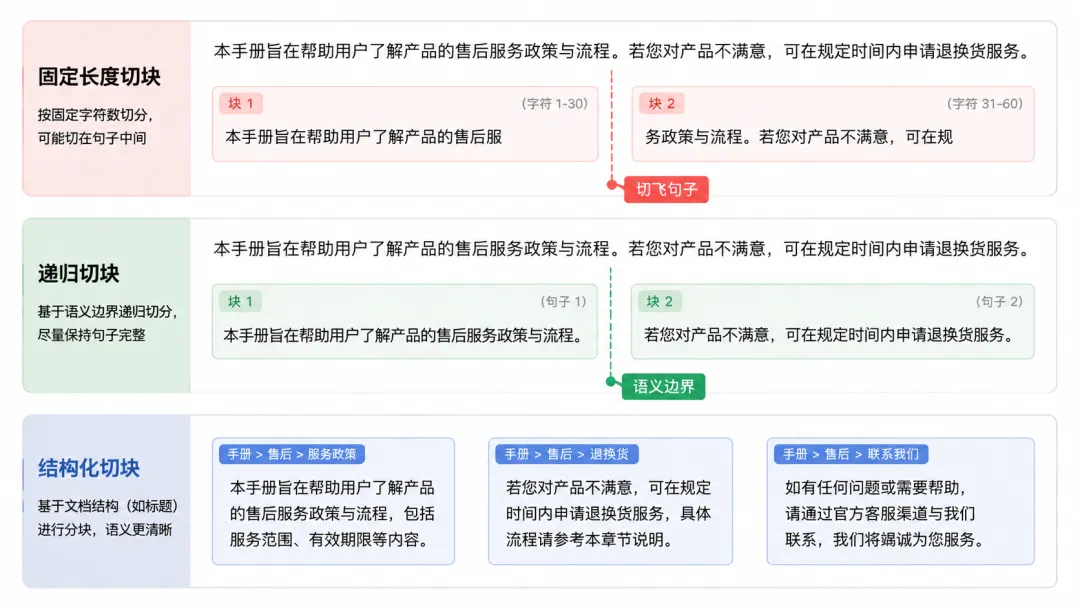
第一宗,切飞句子。500 字硬切,刀口正好落在一句话中间。前半句留在块 A,后半句去了块 B,两边都是残废的半句。
第二宗,切散表格和代码块。一张十行的表格,被从第五行拦腰斩断,变成两个"半张表"。召回到哪一半都答不全——这正是开头翻车现场的根因之一。
第三宗,切断上下文。标题"三、退换货政策"留在块 A,具体条款去了块 B。当你召回到 B,它是一段没头没尾的条款,模型不知道这属于哪一节、针对哪款产品。
对应三层补救,从轻到重。
第一层,递归切块。RecursiveCharacterTextSplitter 不再一刀切,而是按分隔符层级优先在语义边界下手——先试着按段落切,太长再按句子,再不行才按词。它治的是第一宗罪。
from langchain.text_splitter import RecursiveCharacterTextSplitter

splitter = RecursiveCharacterTextSplitter(
    chunk_size=500,
    chunk_overlap=50,
    separators=["\n\n", "\n", "。", "!", "?", ";", " ", ""],  # 中文友好的分隔符层级
)
chunks = splitter.split_text(text)第二层,按文档结构切。如果你在解析阶段保留了标题层级(还记得 unstructured 的 Title 类别、Markdown 的 # 吗),就能用 MarkdownHeaderTextSplitter 按标题切,每一块自动带上"标题路径"作为 metadata。它治的是第三宗罪。
from langchain.text_splitter import MarkdownHeaderTextSplitter

headers = [("#", "h1"), ("##", "h2"), ("###", "h3")]
md_splitter = MarkdownHeaderTextSplitter(headers_to_split_on=headers)
docs = md_splitter.split_text(markdown_text)

# 每个 doc 自带标题路径,例如:
# doc.metadata == {"h1": "产品手册", "h2": "售后服务", "h3": "退换货政策"}
# 召回时把这条路径拼回正文,模型就知道这段话的归属
这一步的价值常被低估:那条 产品手册 > 售后服务 > 退换货政策 的路径,等于给每个块贴了张身份证。召回时拼回正文,模型立刻知道"这段条款说的是退换货",第三宗罪当场化解。
第三层,语义切块。用 embedding 去算相邻句子的相似度,在"话题发生切换"的地方下刀。它最贴语义,但也最慢、最贵——每句都要过一遍 embedding。
from langchain_experimental.text_splitter import SemanticChunker
# 复用已有的 bge-m3 embedding
chunks = SemanticChunker(embeddings, breakpoint_threshold_type="percentile").split_text(text)但不是越高级越好。结构化文档——带清晰标题的手册、Markdown——用第二层的 header split 性价比最高,又快又准。只有那种一大段连绵不断的散文,才值得动用语义切块这把重武器。选型看文档,别无脑上最贵的。
PART 05:进阶——父子分块与 metadata,让"准"和"够"兼得
切块有个绕不开的根本矛盾:
块切小了,召回准,但喂给 LLM 的内容不够;块切大了,内容够,但召回被稀释、不准。
小块语义聚焦,一算相似度就命中,可就那么两句话,模型答不全。大块信息完整,可里面掺了太多别的内容,embedding 一平均,语义就糊了,该召回的时候反而排不上去。
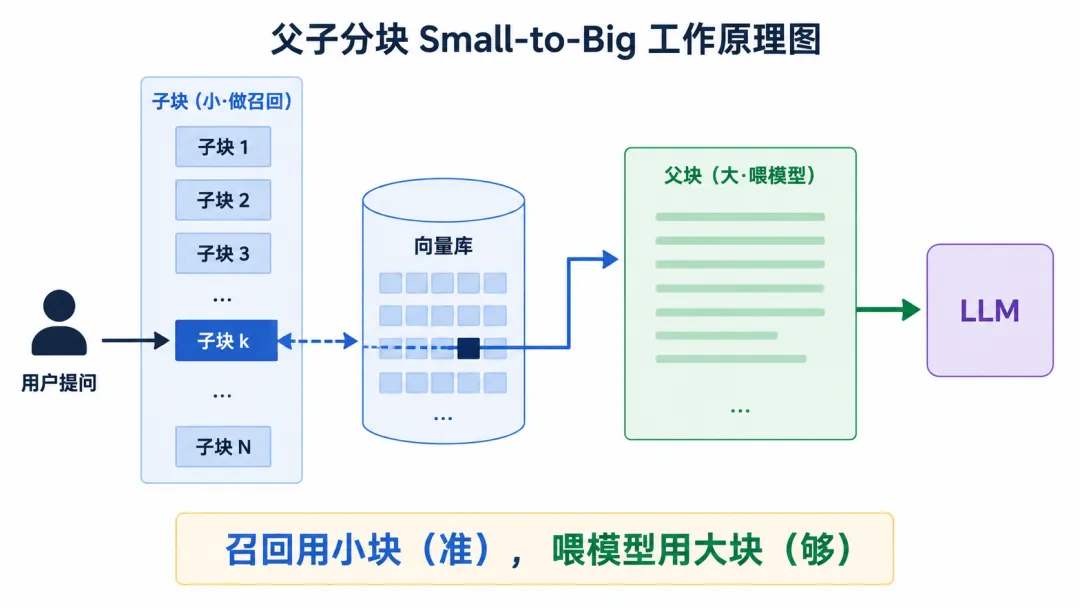
怎么破?父子分块,也叫 Small-to-Big。
思路很妙:召回用小块,喂给模型用大块。
- 子块(小)
:只拿来做 embedding 和召回。短、语义聚焦,召回准。 - 父块(大)
:一旦某个子块被召回命中,实际喂给 LLM 的,是这个子块所属的父块。上下文完整。
LangChain 的 ParentDocumentRetriever 把这套逻辑封好了——子块进向量库(Milvus),父块进 docstore:
from langchain.retrievers import ParentDocumentRetriever
from langchain.storage import InMemoryStore
from langchain.text_splitter import RecursiveCharacterTextSplitter

parent_splitter = RecursiveCharacterTextSplitter(chunk_size=1500)   # 父块,喂 LLM
child_splitter  = RecursiveCharacterTextSplitter(chunk_size=300)    # 子块,做召回

retriever = ParentDocumentRetriever(
    vectorstore=milvus_store,      # 子块的向量存这里(bge-m3 embedding)
    docstore=InMemoryStore(),      # 父块原文存这里
    child_splitter=child_splitter,
    parent_splitter=parent_splitter,
)
retriever.add_documents(docs)

# 召回时:用 300 字的子块匹配(准),返回 1500 字的父块(够)喂给 DeepSeek
results = retriever.invoke("X3 的退换货政策是几天?")表格和代码块,作为独立父块整体处理——召回到就整块给出去,绝不切开。这就是前面那条铁律的落地方式。
还有一件容易被忽略的小事:metadata 挂载。给每个块挂上来源文件、标题路径、页码、类型。它至少有两个用处:一是答完能溯源,告诉用户"这条来自手册第 12 页售后章节";二是召回时能做元数据过滤,比如只在"售后"章节里检索。
把全流程端到端串起来,就是这么一条链路:
原始 PDF
  → unstructured 解析 + 表格转 Markdown
  → clean_text 清洗页眉页脚/软换行
  → MarkdownHeaderTextSplitter 切出带标题路径的父块
  → RecursiveCharacterTextSplitter 切出子块
  → bge-m3 embed 子块
  → Milvus 存子块向量 + docstore 存父块原文
  → 召回子块 → 映射回父块 → 拼上 metadata → 喂 DeepSeek 生成
这条链路,进库前的每一步都在为进库后的准确率兜底。
PART 06:一份可复用的"解析→切块"检查清单
讲了这么多,压成一张上手就能用的清单。下次接到一份文档,照着走:
1. 先分类,别急着上代码。
有没有文本层?(PyMuPDF 取出来是空的,就是扫描件,得走 OCR) 有没有表格?(有就必须单独处理) 是不是多栏?(是就重点检查阅读顺序)
2. 按类型选解析武器。
电子版 PDF:PyMuPDF 取正文 + pdfplumber 抽表格 扫描件:OCR + 版面分析(PP-Structure) 懒得手写、类型杂:unstructured 或 MinerU 一体化
3. 表格一律转 Markdown/HTML,单独成块,绝不切开。
4. 清洗,但别过度。
去页眉页脚(按重复率检测)、合并软换行 清洗规则跟着文档类型走,代码/列表手下留情
5. 切块看文档结构。
结构化文档优先 header split,每块带标题路径 metadata 散文用递归切块,实在需要再上语义切块 每个块都挂上来源、页码、类型
6. 召回准但答不全,就上父子分块。
7. 上线前,务必抽检。
抽 20 个真实问题,人工核对召回块里的表格、关键数字对不对 别只看召回分数——分数漂亮不代表内容对,这正是这篇从头到尾在说的事
这七步走完,你的文本才算真正"配得上"后面那套花哨的检索。
结尾:胜负手在最不起眼的地方
我们太容易把注意力放在光鲜的环节——更强的模型、更花哨的检索、更复杂的 Agent。可 RAG 真正的胜负手,往往藏在一张没人愿意多看一眼的表格里,藏在"文档怎么变成文本"这最不起眼的一步里。
RAG 的准确率,不是在检索时挣来的,是在文档进库那一刻就定死的。
你喂给模型的每一份脏数据,都会在某个你看不见的地方,变成一个理直气壮的错误答案。
互动时间:你踩过最坑的一次文档解析是什么?是 PDF 表格错乱,是扫描件 OCR 串行,还是那些永远对不齐的多栏排版?评论区聊聊,我挑几个典型的下次专门拆。
下一篇,我们聊聊 RAG 到底该怎么评估——解析和切块做得好不好,光靠肉眼看两条召回是不够的,得有一套能量化的评测方法。
— END —
苦猿 · 帮普通人把 AI 学进简历