ARTICLE · 1037138
RAG 不是把文档交给大模型:从检索到可信回答
很多所谓的企业知识库采用同一条演示流程:上传 PDF,输入问题,大模型生成一段流畅回答。只要回答看起来合理,系统就被认为“已经能用了”。
真正进入业务场景后,这种判断远远不够。
企业需要的不是一段听起来正确的文字,而是:
找到了正确证据; 使用了当前有效版本; 没有超出证据范围; 数字和实体没有混淆; 可以引用来源; 不知道时能够拒绝回答; 效果可以被持续评估。
这才是 RAG 系统的完整问题。
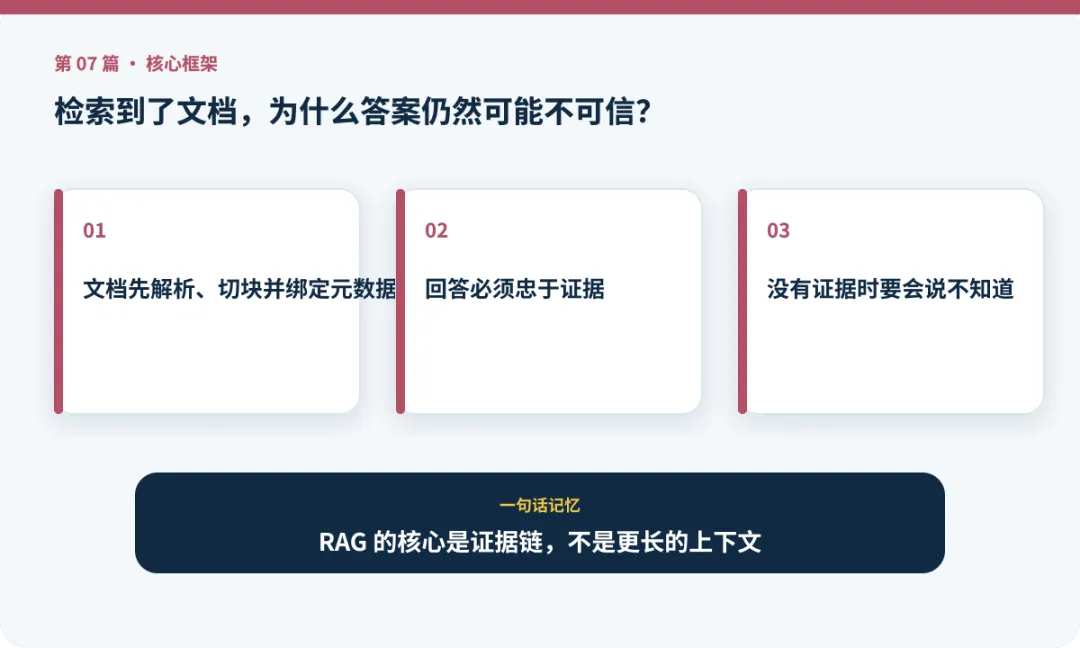
RAG 的核心是证据链,不是更长的上下文
一、RAG 的基本结构
RAG 是 Retrieval-Augmented Generation,即检索增强生成。
其中大模型只负责最后一部分。检索质量、内容版本、权限和证据组织通常决定了系统是否可靠。
二、RAG 与知识库的关系
知识库可以包含:
结构化实体和关系; 业务事件; 产品和客户文档; 数据表和指标定义; 规则与证据; 权限和版本。
RAG 是访问这些知识的一种方式。它不是知识本身,也不能替代主数据、时态模型和治理。
如果公司身份没有统一,RAG 可能把同名公司的资料混在一起;如果文档版本没有管理,RAG 可能引用过期价格;如果知识来源不清楚,模型就无法证明回答来自哪里。
三、文档进入 RAG 前发生了什么
1. 解析 Parsing
从 PDF、Word、网页和邮件中提取:
标题; 正文; 表格; 图片说明; 页码; 链接; 文档元数据。
解析质量常被低估。表格错列、页眉重复、扫描件 OCR 错误都会影响后续检索。
2. 切块 Chunking
文档通常需要拆成较小片段进行检索。切块过大,会混入无关内容;切块过小,会破坏上下文。
常见方法包括:
固定字符或 Token 长度; 按标题和段落切分; 按表格、条款和 FAQ 单元切分; 父子块; 根据语义边界切分。
展位销售政策适合按条款切分,产品参数表应尽量保持完整表格,客户会议纪要则可以按议题切分。不存在适合所有文档的统一块大小。
3. 元数据绑定
每个知识片段应携带:
DocumentID DocumentVersion ChunkID Title Section PageNumber EntityIDs ValidFrom ValidTo AccessLevel SourceURL元数据让系统能够按客户、届次、地区、文档版本和权限进行过滤。
四、结构化知识与文本证据应当协同
用户问题:
推荐三个适合 36 至 54 平方米泵阀展位的华东制造商,并说明原因。
一个稳健流程是:
结构化数据: 筛选地区、制造商角色、报名状态和展位面积 知识关系: 查询公司生产的产品类别及其行业归属 文本检索: 寻找海外拓展、新品发布和参展计划等证据 生成模型: 根据候选和证据生成解释不要让大模型从文本中重新计算本应由 SQL 或 Power BI 语义模型计算的金额、面积和转化率。确定性指标应由确定性系统产生,大模型负责解释和组织语言。
五、上下文不是越多越好
把大量文档全部塞进上下文会产生几个问题:
相关证据被噪声淹没; 冲突版本同时出现; 成本和延迟增加; 模型可能引用不重要片段; 权限控制更难验证。
上下文组装需要考虑:
相关性; 来源可靠性; 时间有效性; 内容去重; 证据多样性; Token 预算; 用户权限。
六、什么是幻觉
RAG 中常见的错误至少有四种:
检索幻觉
系统没有找回正确证据,却返回了看似相关的材料。
生成幻觉
证据没有说某件事,模型却自行补充。
归因错误
结论可能正确,但引用了不能支持该结论的来源。
实体混淆
把同名公司、品牌、子公司或不同届次的展位资料混在一起。
因此,仅仅要求模型“引用来源”并不能自动保证可信。必须检查引用是否真的支持对应陈述。
七、让系统学会说不知道
高质量 RAG 系统必须有无答案策略:
如果缺少支持证据:明确说明暂无可靠资料。 如果来源冲突:展示冲突并说明尚未确认。 如果问题超出权限:拒绝返回受限内容。 如果问题需要实时数据:转向业务系统查询。“不知道”不是失败,而是知识边界被正确表达。
八、RAG 应该评估什么
检索层
Recall@K; Precision@K; MRR 或 nDCG; 正确证据是否进入上下文。
生成层
回答是否忠于证据; 是否完整回答问题; 引用是否支持对应结论; 是否混淆实体和时间; 没有证据时是否拒绝回答。
业务层
销售人员采纳率; 查找客户资料所需时间; 推荐客户转化率; 错误答案导致的人工返工; 知识缺口被补充的速度。
一个回答语言流畅,可能在事实层完全错误;一个回答很短,却可能证据充分、风险更低。因此不能只用主观“看起来不错”评估。
九、建立最小评估集
可以先准备 30 至 50 个真实业务问题,每个问题保存:
QuestionID Question ExpectedEntities ExpectedEvidence RequiredFilters MustNotInclude ReferenceAnswer Reviewer问题应覆盖:
精确事实查询; 多条件客户筛选; 文档政策查询; 多跳关系查询; 时间敏感问题; 没有答案的问题; 容易混淆的同名实体; 权限受限问题。
每次修改切块策略、Embedding 模型、检索参数或提示词后,都重新运行同一评估集。这样才能知道系统是真的改进,还是只在几个演示问题上表现更好。
十、Power BI 可以成为 RAG 的评估中心
将每次问答记录为分析事实:
FactRAGEvaluation ----------------- RunID QuestionID SystemVersion RetrievedChunkCount RecallAtK FaithfulnessScore CitationCorrectFlag NoAnswerCorrectFlag LatencyMs ReviewerScorePower BI 可以比较:
不同检索版本的准确率; 哪类问题最容易失败; 哪些来源经常导致错误; 哪些客户资料存在知识缺口; 系统质量是否随时间退化; 响应速度与准确率之间的权衡。
数据分析师的优势正在这里体现:把 AI 系统从一次性演示变成可以度量、比较和改进的产品。
自测题
RAG 能否替代主数据管理? 为什么上下文不是越多越好? 有引用链接是否就能证明回答可靠? 数值指标应该由大模型重新计算吗?
参考答案
不能,错误实体身份会直接污染检索与回答; 过多上下文会增加噪声、冲突、成本和错误引用; 不能,还要验证引用内容是否真的支持对应结论; 已有结构化数据和语义模型时,应由确定性系统计算,大模型负责解释。
小结
RAG 的质量上限不由聊天界面决定,而由知识身份、文档版本、检索召回、上下文选择、引用验证和持续评估共同决定。
对于 Power BI 分析师,最大的机会不是学会调用一个模型,而是把熟悉的指标、数据质量和监控思维带入 AI 系统,让“回答得像”升级为“回答得有依据,而且效果可以被证明”。