ARTICLE · 1056514
外骨骼协议 UHP 开源,开源团队用源码自造 5545 个 RL 环境:战壕工程师与前沿开源实验室已经悄然完成了第二轮权力交接
单人月交 2500 个生产 PR 的战壕真相:外骨骼协议 UHP 开源,开源团队用源码自造 5545 个 RL 环境
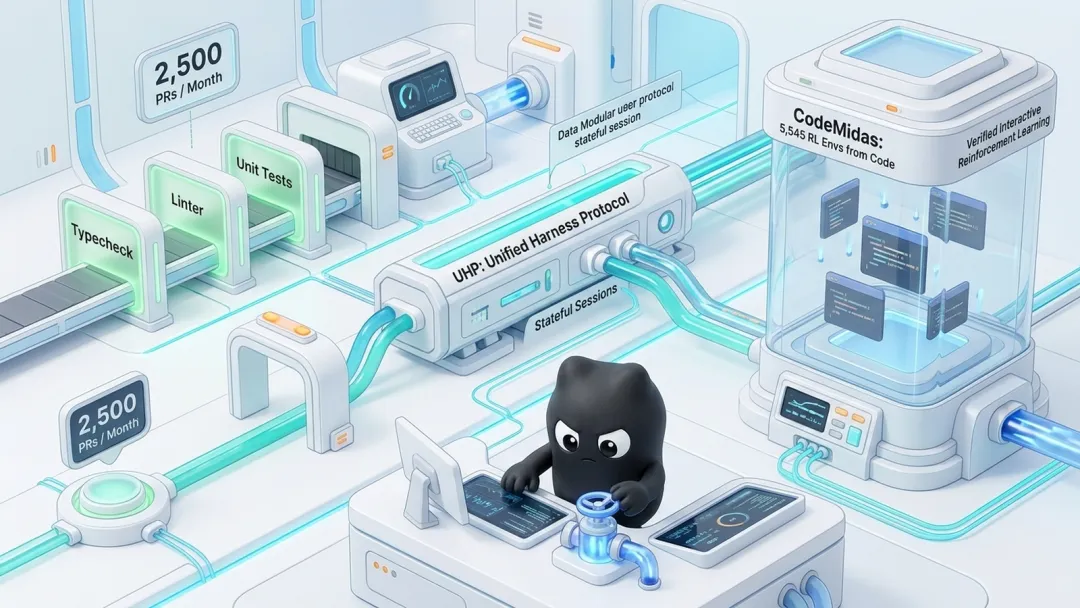
导读:当整个行业还在沉迷于“提示词工程技巧”和“给大模型打分”的内卷游戏时,真正的战壕工程师与前沿开源实验室已经悄然完成了第二轮权力交接。Lauren 披露了依托 Cursor Compile 达成单人月交付 2,500 个生产 PR 的工业流水线;Akshay 开源了统一外骨骼协议(UHP),彻底解耦模型路由与有状态运行时;Jev 创始人 Diogo 算清了账单——盲目切换模型导致缓存击穿、成本暴涨 49%,而读搜代码吃掉了 56% 的 Token;更具颠覆性的是,罗福莉团队的 CodeMidas 将 3,185 个开源代码库反向编译为 5,545 个可交互的强化学习验证环境,开源登顶的 MiMo-V2.6 确立了可验证任务与长时程策略的解耦范式。大模型的竞争终局,从来不是模型单体有多全能,而是外骨骼有多严密、物理环境有多真实。
今日主线
2026 年 9 月 22 日的技术共振,释放出极其清晰的结构性拐点信号:大模型应用正在经历从“模型中心主义(Model-Centric)”向“外骨骼中心主义(Harness-Centric)”与“可验证交互环境(Verifiable Environments)”的全面迁徙。
这一迁徙由四大互锁的支柱构成:
1. 工业交付流水线与外骨骼协议化:单人月交 2,500 个生产 PR 的核心不在于模型写代码有多神,而在于“带外物理 CI 断言(静态类型、Linter、单测)”剥夺了模型的自我审查权,并辅以 2 次自愈硬熔断;与此同时,开源统一外骨骼协议(Unified Harness Protocol, UHP)将无状态模型调用与有状态会话、容器隔离彻底剥离,终结了厂商捆绑; 2. 后训练强化学习重工业化与环境自动合成:Hugging Face 联合创始人 Thomas Wolf 深刻指出,在 RLVR(强化学习验证机制)范式下,高质量可交互环境的地位等同于当年的预训练语料。登顶开源榜首的 MiMo-V2.6 开源了 7,000 个真实环境,并确立 MixRL(代码工具可断言任务)与 MOPD(长时程主观策略)的解耦路线;顶会重磅论文 CodeMidas 更是实现了直接以源码为唯一输入,自动化萃取 5,545 个带沙箱物理断言的训练任务; 3. 从非结构化文本到拓扑图与双循环技能自演进:孙瑞团队开源的 GraphSkillEvo 废黜了单篇 Prompt 技能的粗糙形态,重构成有向无环图(DAG)并引入遗传变异算子,超越微软 SkillOpt;Elvis 团队的 SkillLift 通过双循环架构(内循环冻结 Rubric 成对排序零 Rollout 成本,外循环低频校准),大幅砍掉 40%–70% 的自进化 Token 开销; 4. 决策层去神化与端侧极速物理核对:16.5k 样本严格检验彻底戳破了 Jev 决策模型的概率校准神话,证明其优势在于基座语言泛化而非玄学;端侧 27ms / 60fps 极速决策模型与混合 Computer-Use 框架(RecreationWorld)纷纷落地,将人机焦点主动让渡、写前预演与写后读回校验焊死在最前线。
一、 单人月交付 2500 个生产 PR:带外物理断言与原子切片流水线
在软件工程的真实战壕里,阻碍智能体落地的从来不是生成速度,而是审查成本。
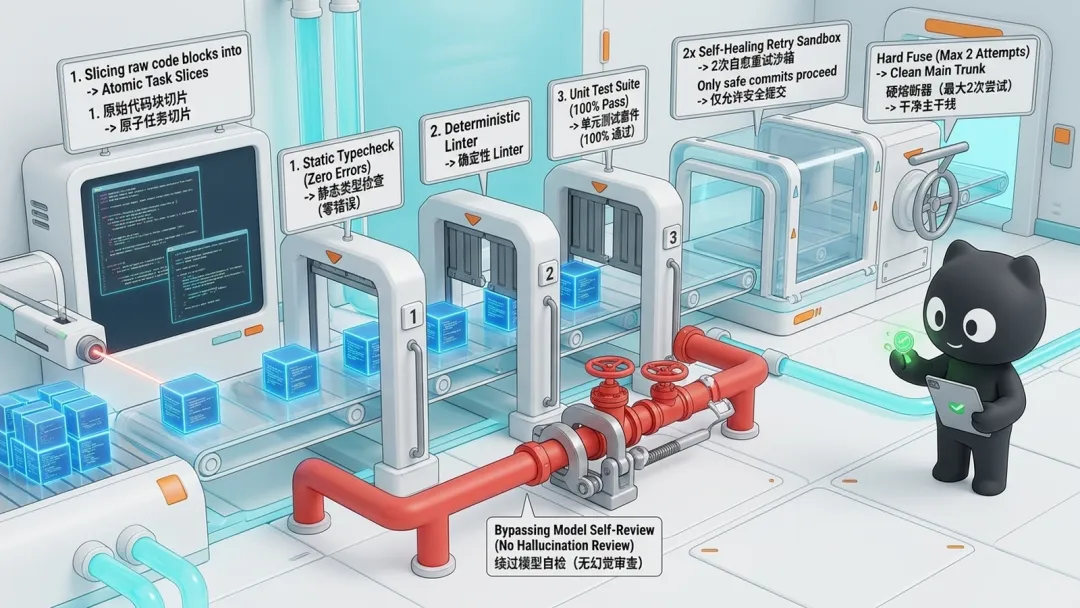
Lauren(@poteto)今日披露了其自动化代码流水线 Cursor Compile 的底层工程拓扑。在这套系统下,单名工程师在单月内合并了超过 2,500 个生产级别 PR,其系统核心并非依赖更强、更贵的大模型,而是三个冷酷的物理工程约束:
1.1 原子化任务切片(Atomic Task Slicing)
将大需求拆解为仅包含单个函数变更、单个依赖升级或单条逻辑补丁的极小任务单元。极小的上下文窗口使得模型不需要在长时程推理中抗衡注意力衰减,执行准确率呈现断层式上升。
1.2 彻底剥夺模型的自我审查权(Bypassing Model Self-Review)
禁止使用“你检查一下刚才写得对不对”这种基于自注意力机制的自恋式 Prompt。在流水线中,唯一的审查神谕(Oracle)是独立运行在沙箱外的物理基础设施:
• 静态类型检查器(Typecheck Gate): exit_code == 0,不允许任何隐式类型妥协;• 确定性代码风格与语法分析(Linter Gate):零警告通过; • 既有单元测试集(Unit Test Suite):带覆盖率硬断言。
1.3 2 次自愈硬熔断(Two-Attempt Hard Fuse)
当代码未通过带外断言时,系统仅将真实的编译器报错日志回灌给模型进行最多 2 次原地自愈尝试。若第 2 次仍未通过,流水线触发硬熔断,立即丢弃该分支并生成带外审计告警,绝不允许智能体陷入无休止的“猜错-改错-引入新错”死循环。
这套体系在工程上宣告了一个朴素常识:智能体的可靠性,来自于宿主环境对它的物理防线,而不是它对自己的道德约束。
二、 统一外骨骼协议(UHP)开源:解耦运行时与守卫 Prompt Cache
当模型能力趋于同质化时,承载模型运行的“外骨骼(Harness)”便成为了系统架构的独立层级。
今日,Akshay(@akshay_pachaar)正式开源了 Unified Harness Protocol(UHP)。如果说 OpenRouter 统一了无状态的模型 API 转发,那么 UHP 则致力于成为智能体外骨骼领域的标准化基础设施。
2.1 无状态模型路由 vs 有状态外骨骼路由的彻底解耦
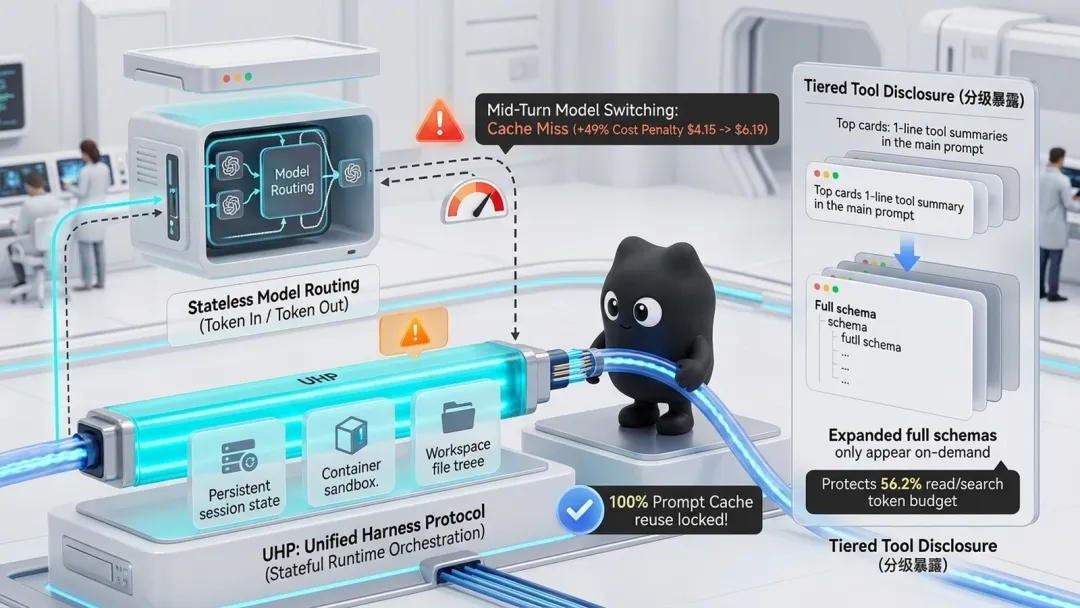
传统架构将工作区管理、会话历史、容器沙箱与模型 API 强行交织在一起,导致更换底座模型几乎需要重构整个运行时。UHP 在 OpenAI Responses 标准之上,抽象出三层核心契约:
• Session Layer:持久化状态机、多 Agent 协作上下文与分支树; • Streaming & Event Bus:细粒度操作事件(Tool Call、File Edit、Error Trace)带外广播; • Workspace Sandbox Provider:解耦本地文件系统、Docker 容器与云端瞬态执行环境。
2.2 盲目多轮切换模型:成本暴增 49% 的缓存陷阱
与此同时,Jev 创始人 Diogo Amogo 发布了长达 12 页的《Jev Harness 架构蓝图》,用极其详实的生产账单给热衷于“动态路由”的架构师浇了一盆冷水:
• 在实际工程开发任务中,阅读与搜索代码占用了 56.2% 的轮次和 46.5% 的 Token 开销,而真正的代码修改不足 10%; • 许多人为了降本,在多轮交互中频繁交替调用模型(例如思考用 Opus,读取用 Sonnet,编辑又切回 Opus)。实测证明,这种行为会彻底摧毁服务商的 Prompt Cache(提示词前缀缓存),导致输入 Token 无法命中缓存,单任务成本从 6.19,净亏损高达 49%!
2.3 分级工具暴露(Tiered Disclosure)
为保护脆弱的上下文窗口与缓存结构,成熟外骨骼必须实施“分级暴露”策略:主 Prompt 中仅保留每个工具的单行紧凑摘要;只有当决策路由命中该工具分类时,外骨骼才动态挂载该工具的完整 JSON Schema,严防 200 个 MCP 工具一次性撑爆上下文预算。
三、 源码反向生成 5545 个 RL 环境:CodeMidas 与开源强化学习工业化
如果说 2024 年是预训练数据的争夺战,那么 2026 年则是**强化学习可验证交互环境(Verifiable RL Environments)**的制高点争夺战。
今日,登顶 Artificial Analysis 全球开源大模型评测第一名(46 分)的 MiMo-V2.6 揭晓了技术底牌:开源了包含 7,000 个真实交互任务的强化学习集群,并与香港大学、清华大学联合发表顶会论文 CodeMidas (arXiv:2609.22068)。
3.1 突破 Commit/Issue 采样的贫瘠孤岛
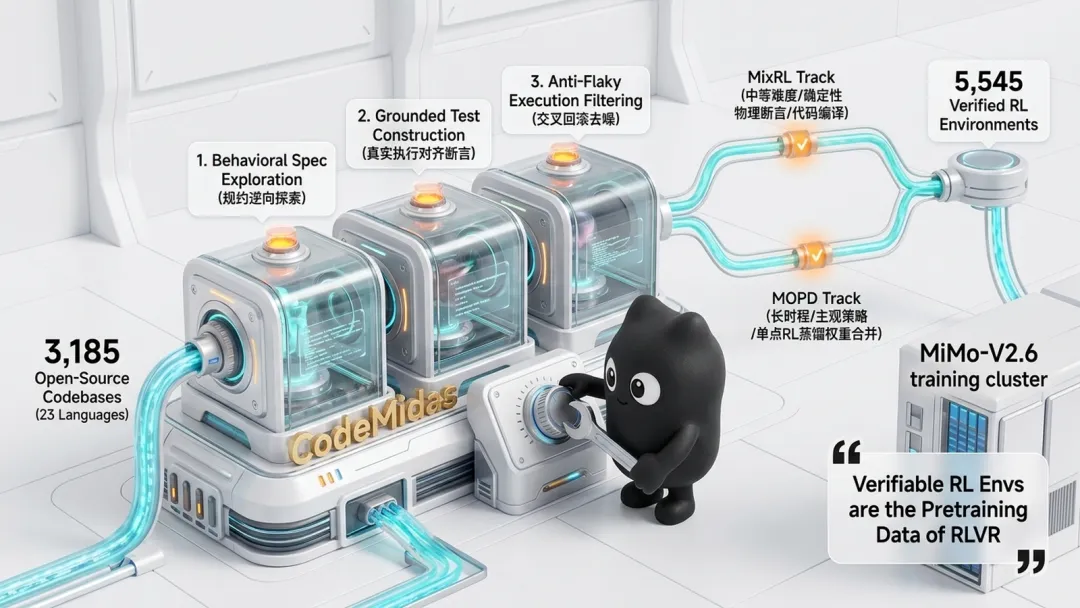
传统的代码 Agent 强化学习高度依赖 GitHub 的历史 Commit 和 Pull Request,不仅数据量极其稀疏,而且由于历史环境依赖缺失,绝大多数根本无法复现运行。CodeMidas 提出了一种革命性的端到端管线:以现有开源代码库的源码本身作为唯一输入,自生成带沙箱物理验证器的 RL 交互环境。
其流水线包含严密的三个阶段:
1. 行为规约探索(Behavioral Specification Exploration):分配 Agent 算力静态分析并探测代码库中已实现的核心功能与函数边界,逆向提取接口行为规范; 2. 物理执行对齐测试(Grounded Test Construction):以原始代码库的实际执行输出作为真实基准(Ground Truth),自动合成包含断言的单元测试套件; 3. 反作弊与 Flaky 交叉过滤(Execution Checks & Rollout Filtering):通过反复 Rollout 与扰动注入,剔除存在作弊可能、随机通过或由于网络延迟导致的 Flaky 任务。
3.2 规模化落地与架构解耦
该管线横跨 3,185 个开源仓库、23 门编程语言与 15 个技术领域,自动合成了 5,545 个高保真强化学习环境。在 MiMo-V2.5 上利用 GRPO 算法训练后,DeepSWE 飙升 +11.7%,ProgramBench 提升 +17%,Terminal-Bench v2.1 提升 +8.5%。
同时,MiMo 确立了关键的架构解耦原则:
• MixRL(混合强化学习):专门处理中等难度、能给出严格物理断言的确定性任务(代码编译、单元测试、精确工具调用); • MOPD(多目标后蒸馏):对于长时程交互或带有主观偏好的任务(如游戏策略、开放式设计),采用单点 RL 独立训练出策略权重后,再通过 MOPD 权重合并蒸馏回底座模型,有效避免了单一大一统 RL 训练时 Rollout 效率崩塌与样本陈旧问题。
Hugging Face 联合创始人 Thomas Wolf 给出定论:“可交互的开源验证环境,正是 RLVR 时代的新一代预训练数据集。”
四、 技能有向图与双循环演化:告别粗暴的提示词堆叠
长期以来,社区普遍将智能体技能(Agent Skills)理解为存放在 Markdown 文件中的纯文本 Prompt。然而,随着任务复杂度激增,这种粗放模式正在面临崩溃。
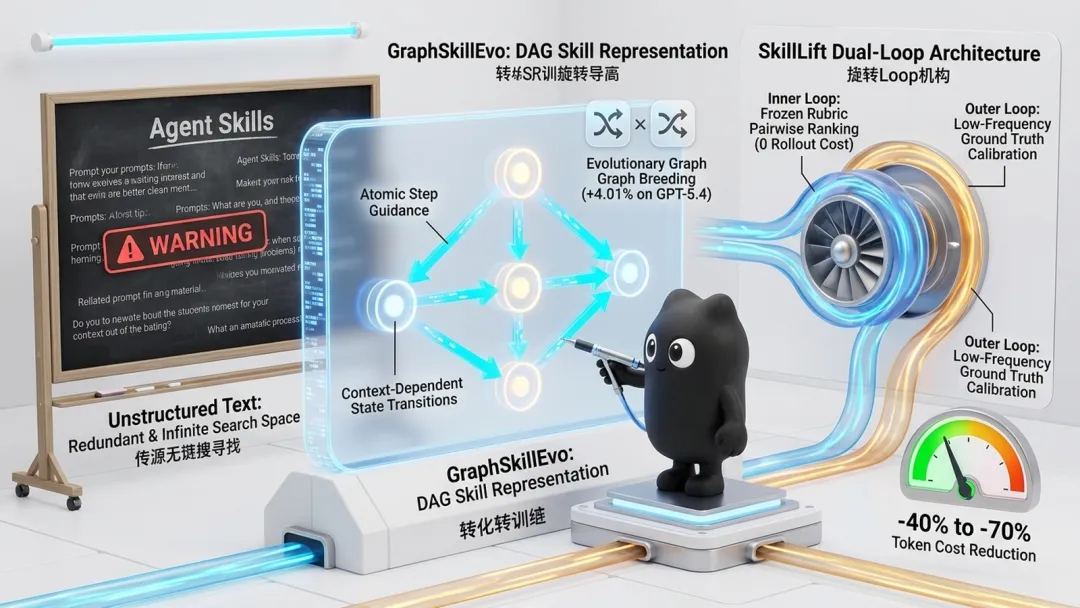
浙江大学与南洋理工大学孙瑞团队今日开源的顶会论文 GraphSkillEvo (arXiv:2609.21749),直击纯文本技能的两大阿喀琉斯之踵:
• 缺乏工作流拓扑:非结构化文本充斥着冗余描述,大模型在多步执行中极易迷失前置依赖; • 优化搜索空间爆炸:在无限的自然语言文本空间中,依赖 LLM 自身的“自我反思(Self-Refine)”极易陷入局部停滞与幻觉修补。
4.1 将技能重构为有向无环图(DAG)
GraphSkillEvo 将技能表征为显式图结构:
• 图节点(Nodes):封装原子执行动作及其局部强类型操作规则; • 有向边(Directed Edges):编码根据中间状态与外部反馈触发的条件跳转拓扑。
在这一表征之上,团队引入了基于种群的遗传算法算子(Mutation & Crossover):不同优质技能的有效执行子图可以交叉互换,故障分支可以就地诱变重构。实测显示,GraphSkillEvo 全面击败了微软昨天的文本优化器 SkillOpt,在 GPT-5.4-nano 上准确率净增 +4.01%,在 GPT-5.4 上提升 +1.76%。
4.2 SkillLift 双循环:技能自进化的降本奇迹
与此同时,Elvis 团队提出的 SkillLift 架构解决了自进化极其昂贵的 Token 痛点。传统自进化每迭代一次 Prompt 都需要去真实环境中跑一次端到端 Rollout,成本极其高昂。SkillLift 提出了巧妙的双循环分工:
• 内循环(Inner Loop):使用轻量级 Rubric 评测模型进行成对排序(Pairwise Ranking)。在冻结的 Rubric 下反复优化 Prompt 变体,端到端 Rollout 成本为 0; • 外循环(Outer Loop):以极低频率将内循环优选出的候选技能扔进真实测试集中进行 Ground Truth 校准,反向修正内循环的 Rubric 权重。
在 147 项复杂任务测试中,SkillLift 以节省 40%–70% 的 Token 开销,正面击败了消耗双倍算力预算的暴力自进化方案。
五、 混合 Computer-Use 与端侧极速决策:撕开 UI 幻觉的物理切口
在桌面自动化与操作系统智能体(Computer-Use Agent)领域,今天的最新进展正在终结“看似无所不能、实则一碰就碎”的表面繁荣。
5.1 RecreationWorld 揭露残酷真相:真实程序断言通过率仅 2.8%
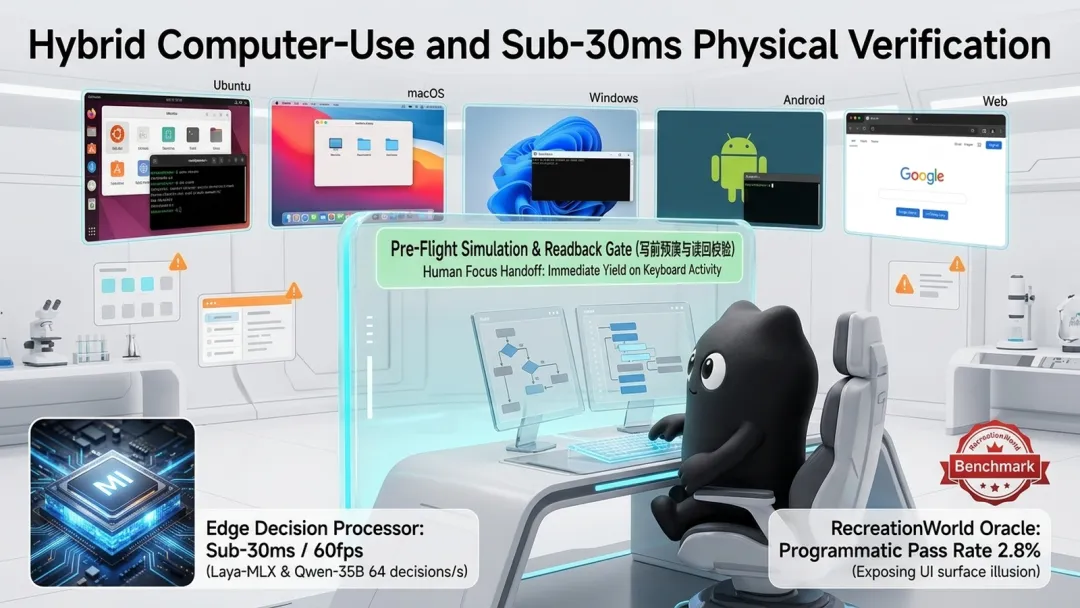
顶会论文 RecreationWorld (arXiv:2609.22000) 打造了首个横跨 Ubuntu、macOS、Windows、Android 与 Web 的混合计算机使用框架,并在统一 Harness 中将 GUI 视觉操作与终端 CLI 编码深度咬合。
其推出的 RecreationBench 针对 250 项复杂跨平台任务设置了带外隐藏的“物理程序断言(Programmatic Oracles)”。评测结果令人震惊:即便是业内最强旗舰模型,虽然整体视觉模仿得分能达到 58.1%,但在全量通过带外程序化物理断言的严苛测试下,通过率仅仅只有 2.8%!
这揭示了一个被广泛掩盖的事实:绝大多数 Computer-Use Agent 仅仅是在像素层面上“画出了相似的静态界面”,但底层的业务逻辑、数据持久化与动态状态机几乎全部处于崩溃状态。
5.2 落地规范:写前预演、读回核对与人机焦点让渡
开源社区项目 trycua/cua 与针对苹果生态的 mac-computer-use 今日给出了两项工业化避坑准则:
• Pre-Flight Simulation & Readback:执行破坏性写操作前必须进行预演,点击或写入完成后必须通过辅助功能树或截图读回校验,严禁“盲发指令就假定成功”; • Human Focus Handoff:一旦检测到人类用户的实体键盘或鼠标活跃,Agent 必须在 10 毫秒内挂起让出焦点,彻底消除人机争抢光标的灾难体验。
5.3 16.5k 样本去魅:小模型接管毫秒级决策
在决策模型方面,Han 针对 Jev 的 16.5k 验证样本进行了深入复核,证实其概率校准在 7/8 的数据集上发生严重漂移,所谓“概率推理玄学”本质依然是底座模型的语言泛化能力。这一去魅直接加速了开源替代方案的爆发:社区实测采用开源 Qwen-35B + SGLang 即可达成 64 次决策/秒;而在 Apple Silicon 上,基于 MLX 的 Laya 模型仅占 1GB 统一显存,即可在 27ms 内达成 60fps 的稳定控制。
六、 架构认知升维:模型权重 vs 外骨骼环境的定价权转移
站在 2026 年秋季的技术坐标系上,大模型工程的价值高地正在发生根本性的位移:
| 可靠性保障 | |||
| 运行时架构 | |||
| 技能组织形态 | |||
| 训练语料瓶颈 | |||
| 桌面交互落地 |
落地建议与工程清单
•实施带外物理门禁流水线:在智能体工作流中全面剔除“让大模型自我检查代码”的幻觉环节;强制引入独立的编译器、静态类型检查器(Typecheck)、Linter 与单元测试作为不可妥协的判定神谕; •排查多轮交互中的 Prompt Cache 击穿:审查当前系统是否存在多轮中盲目切换模型(Opus Sonnet Opus)的坏味道;统一上下文前缀结构,锁定 Prompt Cache 命中率以避免高达 49% 的无谓账单惩罚; •推行工具分级暴露(Tiered Tool Disclosure):在系统级 Prompt 中只提供所有工具的单行紧凑概要;仅当意图路由命中特定分类时,再动态挂载完整 JSON Schema,为代码阅读与搜索守护 56% 的 Token 预算; •重构长时程技能为 DAG 图结构:借鉴 GraphSkillEvo 思路,将超过 3 步的复杂技能重构为包含原子步骤与条件分支的有向无环图,彻底终结自然语言文本空间的组合爆炸难题; •部署端侧或本地极速决策层:对高频路由、方差敏感的决策任务,优先使用经过 SGLang / MLX 加速的小尺寸模型(如 Qwen-35B 或本地 4B/8B 决策模型),在 30ms 延迟与极低成本内完成确定性分流。
30 秒口述版
“单人月交付 2,500 个生产 PR 的秘密,从来不是大模型有多聪明,而是宿主环境用静态类型检查、Linter 和单测剥夺了它的自我审查权;UHP 外骨骼协议的开源,终结了频繁切模型反亏 49% 缓存的盲目路由;而 CodeMidas 直接用源码自造 5,545 个强化学习环境,印证了可交互验证环境才是 RLVR 时代的新预训练语料。工程的终局是确定性——把模型当无状态计算单元,把定价权还给外骨骼与物理断言。”