ARTICLE · 1056518
小米发布 CodeMidas:用仓库源码造 RL 训练题,DeepSWE 通过率翻倍
一句话讲清楚👉🏻 小米 LLM Core 与北京大学等团队发布 CodeMidas :把仓库里已经实现好的功能挖掉,让模型重写一遍,写没写对由代码自己跑出来判定,不需要 issue 、提交记录、已有测试或文档。这批任务一共 5,545 道,覆盖 23 种语言、 15 个技术领域;用它们做强化学习( RL )训练,五个外部编程基准全部上涨,其中 DeepSWE 的修复通过率从 10.0% 涨到 21.7%。
论文标题:CodeMidas: Scaling Agentic Coding RL Environments from Code Itself
论文链接:https://arxiv.org/abs/2609.22068
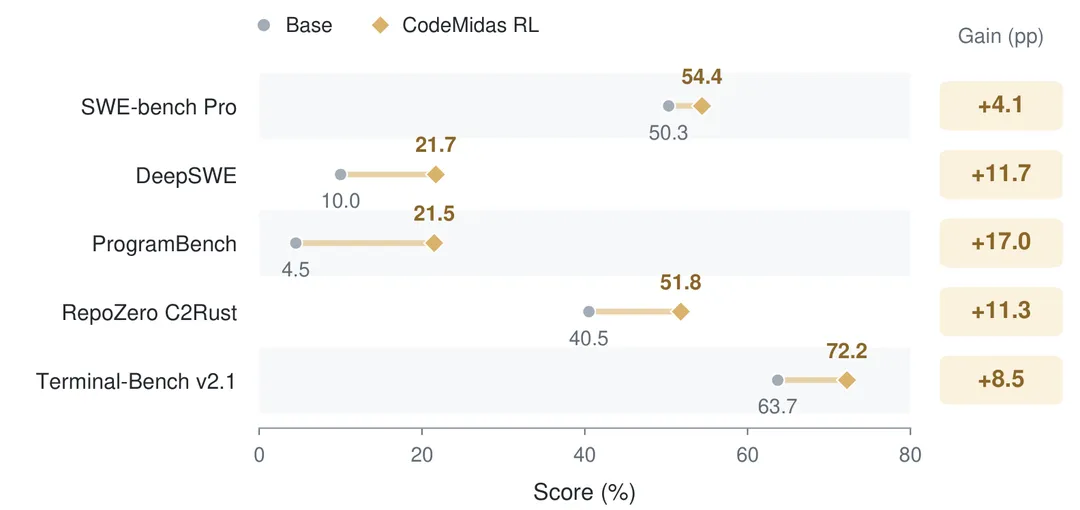
五个外部基准上的成绩变化,灰色是训练前的 MiMo-V2.5 ,金色是 CodeMidas 训练之后。从左到右依次是 SWE-bench Pro 、 DeepSWE 、 ProgramBench 、 RepoZero C2Rust 、 Terminal-Bench v2.1 ,纵轴是百分制分数,右侧标的是涨了几个百分点,也就是百分点差,不是百分比增幅。 ProgramBench 报的是 Almost Solved (通过至少 95% 的测试),其余四项报通过率。
训练任务从哪来,决定模型能学到什么
一个只有源码、既没有 issue 也没有测试的开源仓库,在现有的数据流水线里一道题也挖不出来。而这类仓库在开源世界里占了很大一块。论文没有给出占比统计,它说的是另一件事:现有方法的题库上限被开发记录卡住,能不能出题,先看有没有人把开发过程记下来。
给 Coding Agent (能自己读写代码、跑命令来完成开发任务的 AI 程序)做强化学习,任务和判分同等要紧。模型要练的是「在真实仓库里完成一段开发工作」,所以既要有大量真实仓库,每个任务还得配一个能自动判分的验证器:做对了给 1 分,做错了给 0 分,中间不需要人来看。
现成的做法是去挖开发过程留下的痕迹。 SWE-bench 把 GitHub 上的 issue 和对应的修复补丁配对; SWE-smith 围绕已有测试人为造出故障; R2E 把函数的说明文档改写成需求描述; MindForge 把文档和参考程序摆出来,让模型照着从零实现。四条路线各有取舍,共同点是把题库的上限交给了仓库的开发记录:痕迹写到哪里,题就能出到哪里,语言和技术栈也跟着这些项目走。下面那张表的最后一列就是这个差距:此前覆盖语言最多的流水线是 SWE-rebench V2 , 20 种;往下是 MindForge 的 15 种、 SWE-Hub 的 11 种,另外五条都只覆盖 1 种语言。
CodeMidas 换了一个起点:除了仓库源码本身,什么都不需要。它把「已经实现的功能」当成现成的题目。这块功能在仓库里跑得通,说明需求是明确的;把它的实现删掉,做题者要做的就是把这块功能重新写出来。原实现留下来当参考答案,对外接口定义了「必须提供什么」,执行原代码就能知道「正确的行为应该是什么样」。
好处是任务供给量跟着代码量走。代码仓库有成千上万个,而 issue 、测试和文档只在少数活跃项目里齐全。
代价也很实在。删掉一段代码容易,删干净、判公平很难。残留的编译中间文件、缓存副本、运行环境里预装的同一个库,都可能让模型跳过开发直接抄到答案。自动生成的测试也可能把写法当成需求,把行为正确但结构不同的实现判成错。这套流程的算力开销论文没有给,只能从候选数看出分量: 22,575 条候选最后只剩 5,545 道。哪一步最贵,正是想复现的人最想知道的数字。
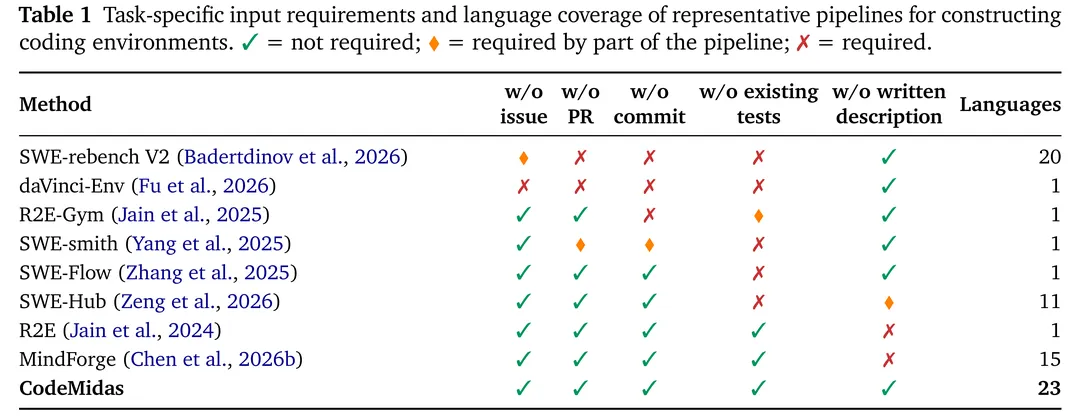
几条代表性流水线对输入的依赖对比,比的是「造题需要什么输入」,不是成绩。表头里的 w/o 是「不需要」的意思:✓ 表示这条流水线不依赖这类输入,✗ 表示必须依赖,♦ 表示只有一部分环节需要。最后一列是语言覆盖数。最后一行 CodeMidas 五项全为 ✓,语言覆盖 23 种,是表里覆盖面最广的一条。
一个任务是怎么造出来的
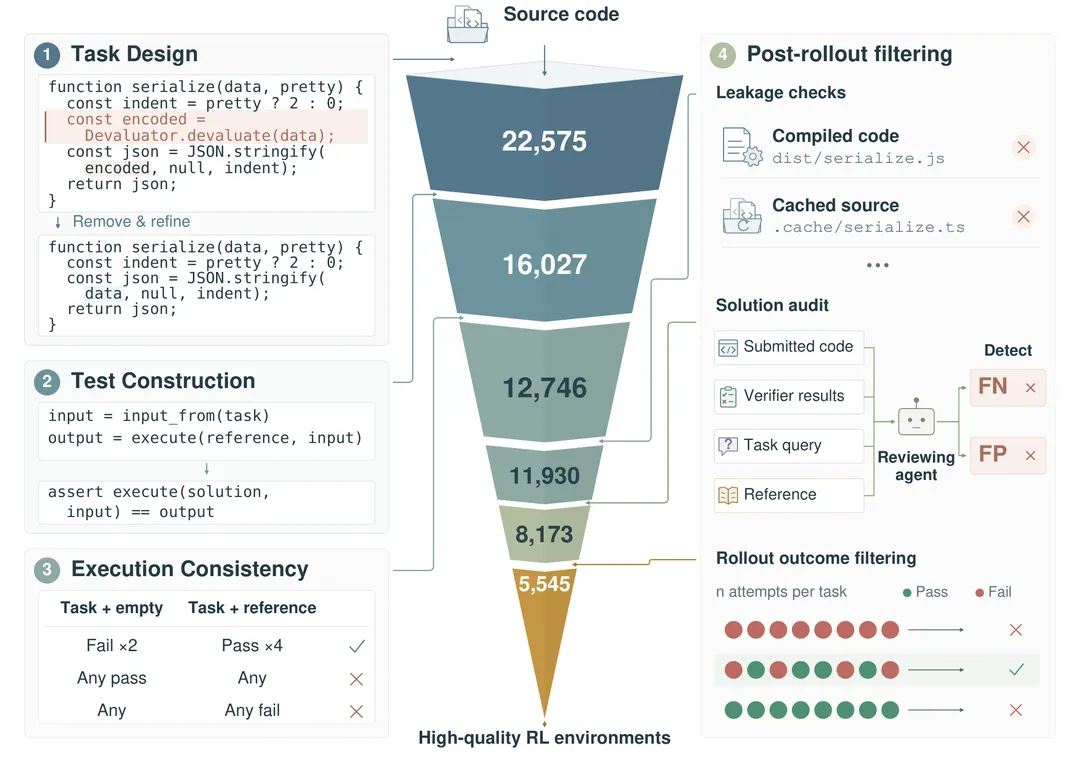
CodeMidas 的四个步骤:设计题目并改造代码起点、构造测试、准备环境并检查执行一致性、上线前过滤。左边的代码片段是第一步的例子,把 serialize 里那行 Devaluator 调用删掉,这块功能在起点代码里就不存在了。中间的金字塔是候选任务一路筛到最后剩下的数量,从上到下依次是 22,575 、 16,027 、 12,746 、 11,930 、 8,173 、 5,545 道。
整条流程的活儿都由 agent (在循环里自己调用工具、分多步完成任务的模型)来干。四步走完,超过四分之三的候选任务都没能留下。
先把功能从仓库里挖出来
负责造题的 agent 先读仓库结构和构建文件,找出有对外入口、结果可观测的功能。造题的 agent 会优先挑需要跨文件推理的功能:只改一行就能做完的任务,训练价值有限。
接口分三类,判分方式各不相同。命令行工具看进程输出和退出码;纯函数看返回值;有状态的库接口要看多次调用之间的状态变化,比如先写入再读回、用完要释放的资源有没有释放。
选定目标之后, agent 沿着对外入口和共享依赖把范围划出来,删掉核心实现,再调整周边代码,让剩下的部分能编译、能运行,只是缺了要考的那块功能。题面描述和保留多少代码是一起定的:题面写清输入、可观测行为和必须提供的对外接口,内部用什么算法、函数怎么拆分,留给做题者自己决定。
这里有一条界限划得准不准,直接决定后面的判分公不公平:接口和外部行为是硬要求,内部结构是自由的。
标准答案由执行原代码得出
测试由 agent 构造,但标准答案由执行决定。 agent 把题面里的行为要求映射成测试输入和边界情况,在留有原实现的副本上调用对外入口,把真实输出记下来当期望值。
题面规定的部分,检查条件就按执行结果写;题面没规定的部分,只检查明确写出来的约束。论文举了一个例子:可以要求抛出某类异常,但不锁定异常消息的具体措辞,否则一个措辞不同、行为正确的实现会被判失败。
紧接着还有一道复查: agent 逐条检查这些检查条件(论文里叫断言)里有没有题面没要求的限制,比如精确措辞、偶然的调用顺序、内部数据结构长什么样。发现之后换成行为层面的检查,同时保留题面明确要求的那些。如果一条断言只能依赖仓库内部的私有函数或变量、又找不到行为层面的替代写法,这个任务直接丢弃。复查完的测试会固定下来,之后判分只用这一份。
起点要干净,六个容器验一遍
运行环境从一个统一的 Docker 基础镜像开始, agent 按项目的声明装依赖、准备构建资源。清理环节针对所有会泄露答案的东西:编译生成的中间文件、缓存副本、造题过程留下的文件,还有仓库原有测试里覆盖这块功能的那部分。要保留的是依赖、测试用的样例数据和构建脚本,因为做题者需要在同一个环境里把自己的实现跑起来。
准备完之后,每个任务都要在训练时用的那套环境里跑六个干净容器:两个装挖空后的起点代码,必须都失败;四个装参考答案,必须都通过。前两个确认「起点确实做不出来」,后四个确认「题目有解、而且结果稳定」,避免同一份代码这次通过、下次失败。
最后一关:用模型的实际作答过滤
前面几步检查的是起点和参考答案,覆盖不到模型会怎么钻空子,所以正式训练前还要再筛三道。
先看泄漏。专门有一个 agent 扮演作弊者,在它看得见的整个环境里翻找:编译产物、缓存、造题过程留下的文件、运行环境里预装的同一个库。它要把每一条可疑路径和对应的命令输出记下来,再由另一个环节对照参考答案和判分程序判断:如果这些材料确实能让模型跳过开发直接拿到答案,这个任务就丢掉。
判分这一关查的是自动判分判得准不准。让一个 Coding Agent 每个任务做四次,再由另一个 agent 拿着任务描述、判分程序、参考答案和这四次完整的操作记录(提交的代码加上测试输出)逐条复核:这次提交有没有满足题面要求?判分结果对不对?它要标出两类错误,一类是错的实现通过了测试,一类是正确的实现被判失败。有这类缺陷的任务丢掉。
最后一道只看结果分布。用一个前沿模型每个任务试若干次,全过和全没过的都不要,只留既有成功也有失败的。全过说明任务对当前模型太简单,全没过说明太难、或者任务本身还有毛病。两种情况的共同点是:答对答错拿到的都是同一个分数,模型从中学不到东西。
5,545 道训练任务长什么样
经过这四步,数据集剩下 5,545 道训练任务,来自 3,185 个开源仓库,覆盖 23 种编程语言和 15 个技术领域。
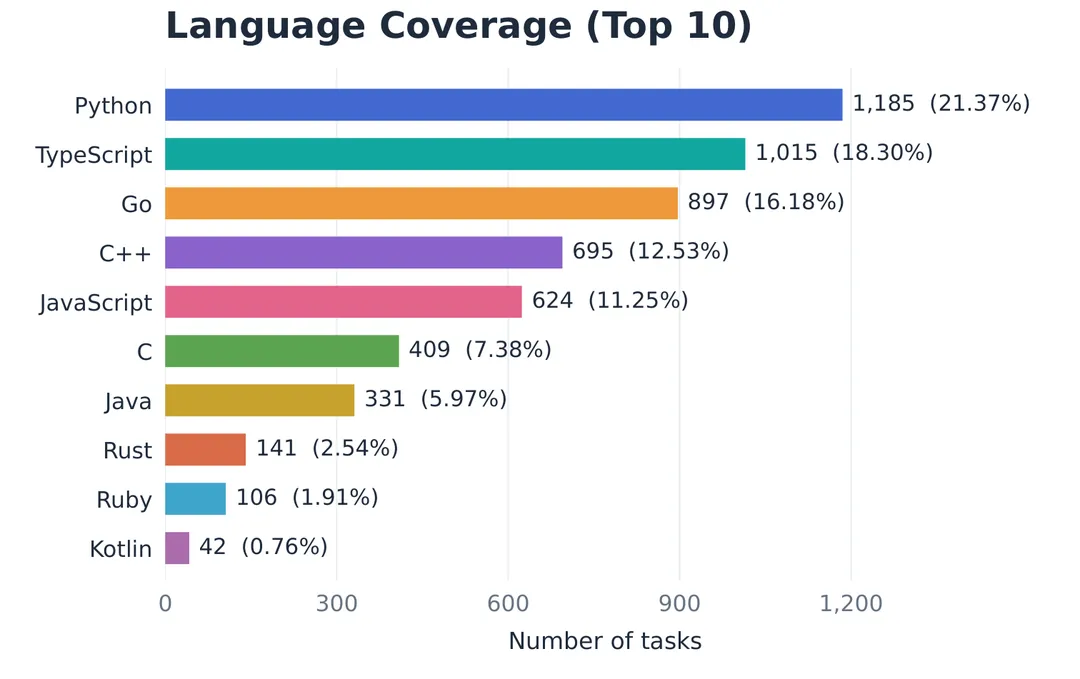
训练集的语言分布。任务继承它所属仓库的主要语言,前 10 名覆盖 5,445 道,占全集的 98.2%;完整数据集一共涉及 23 种语言。
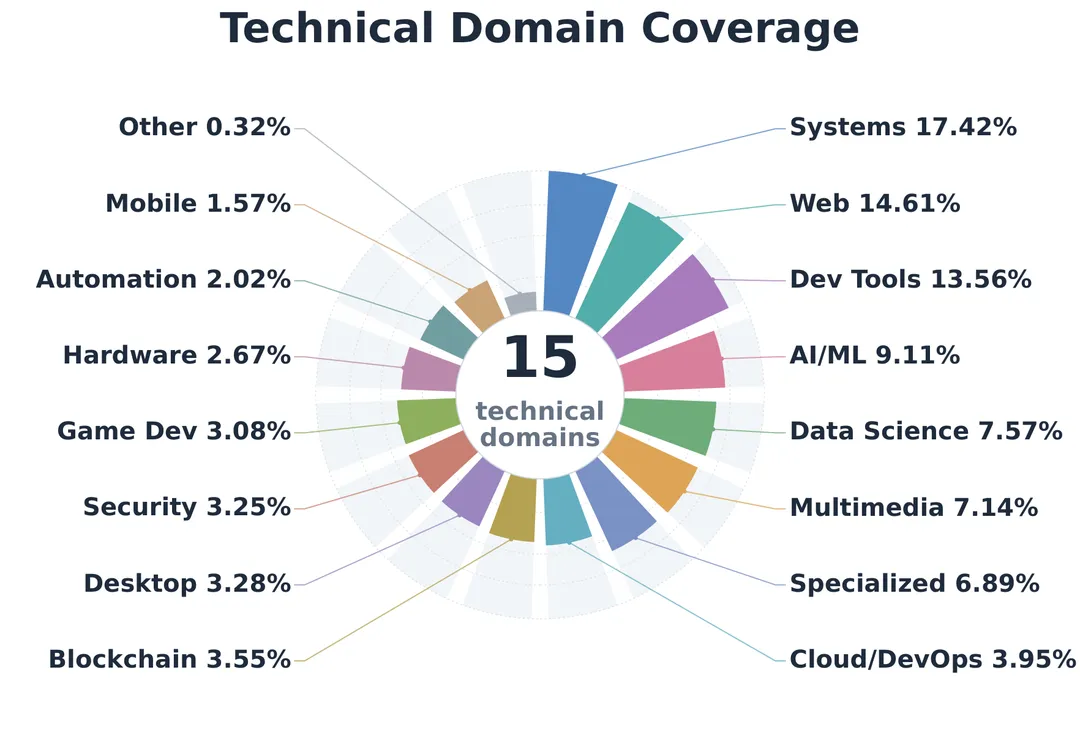
技术领域分布,共 15 个标注领域,另有 18 道任务( 0.32%)没有领域标签。条形长度按任务占比的平方根缩放,所以长短差距看起来比实际小。
语言上, Python 占 21.4%, TypeScript 18.3%, Go 16.2%, C++ 12.5%, JavaScript 11.3%,前五名合计接近 80%。领域上,系统软件 17.4%、 Web 14.6%、开发工具 13.6%、 AI/ML 9.1%、数据科学 7.6%、多媒体 7.1%、专用软件( Specialized ) 6.9% 是最大的七块,剩下八个领域各自占 1.6% 到 4.0%,包括云与运维、区块链、桌面、安全、游戏开发、硬件、自动化和移动端。
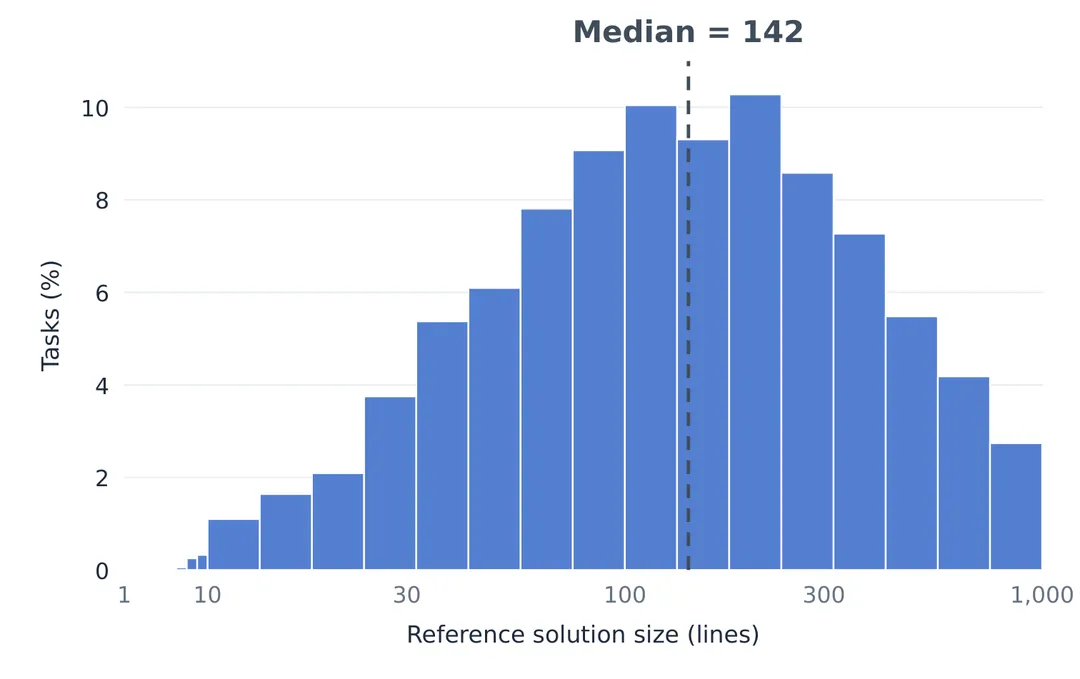
参考改动的大小分布。统计口径是参考答案里新增和删除的源码行,含注释与空行;横轴按行数分档,每档跨度按倍数增长,少量大改动因此不会把图挤扁。改动行数的中位数是 142 行,一半任务落在 66 到 305 行之间。
难度量级从这个分布能看出来:任务是真实仓库里的一块功能,改动往往跨文件。论文另外统计了涉及的文件数, 65.9% 的任务至少要动两个源文件。这个规模和常见的函数级、单文件级代码题不在一个量级,也是训练信号能用到仓库级评测上的一个前提。
训练出来的模型强在哪
训练用小米自研的 MiMo-V2.5 ,算法是 GRPO (一种强化学习算法:同一道任务的多条作答互相比较,好的加分、差的减分)。奖励只有 0 和 1 两种取值,由判分程序给出,没有单独的奖励模型。每题让模型做 32 次,单条作答的长度上限是 516,096 个 token ,一次任务最多 500 轮操作。评测里还有一个自建的 CodeMidas Val ,从这 5,545 道之外单独抽 200 道,每道做三次。
开头那张图是总览,对应的数字在下面这张表里。
变化一列是百分点差。表里 ProgramBench 一行不带百分号,因为它报的是 Almost Solved 分数,也就是通过至少 95% 的测试的任务占比;其余四项是通过率。
看这张表,更值得读的是哪些基准推得动、哪些推不动。有底子的两项几乎推不动: SWE-bench Pro 只挪了 4.1 个百分点, Terminal-Bench v2.1 挪了 8.5 个百分点,而它们的起点都在 50% 以上,说明模型本来就能做对其中一大半。
训练前几乎做不出来的 DeepSWE v1.1 和 ProgramBench ,变化幅度大得多:前者翻了一倍多,后者涨了近四倍。 RepoZero C2Rust 起点 40.5%,涨了 11.3 个百分点,任务是把 C 代码改写成 Rust 。换成相对增幅,重心就更清楚了: DeepSWE 涨 117%, ProgramBench 涨 378%, SWE-bench Pro 只有 8%。起点越低,这套训练数据顶得越高。这个分布和任务来源也对得上: CodeMidas 的任务都是「把一整块功能整个挖掉、重新实现」,模型要做的是把功能写回来,这和在已有代码里打个小补丁是两种难度量级。 Terminal-Bench 的起点已经不低,还能再涨 8.5 个百分点,说明这套数据的作用范围没有局限在仓库类任务上。
研究里还确认了训练集与 CodeMidas Val 、五个外部基准的任务集互不重叠,这是判断「有没有把训练题背下来」的前提。
训练过程里的曲线
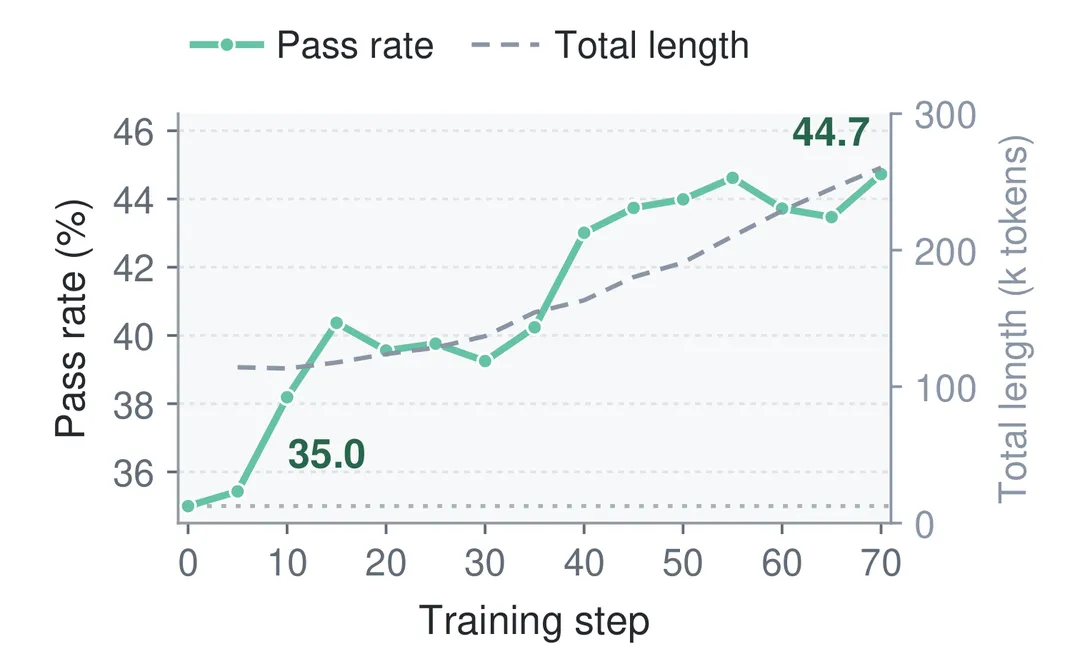
CodeMidas Val 上的学习曲线。绿色实线是平均通过率(左轴),灰蓝色虚线是平均总长度,单位是千 token (右轴),横向点线是训练前那个模型的通过率。
CodeMidas Val 上的通过率从 35.0% 升到 44.7%,从第 40 步往后,每个评测点都比训练前高出 8 到 10 个百分点。每次作答也在变长,平均总 token 数上升。论文把它解释为轨迹变长、更充分地用掉交互预算;论文没有单独报告平均轮数,所以「 500 轮的额度用得更满」只是与数据相符的一种解释。
更少但更干净的题
为了把「任务多」和「任务好」分开,研究做了四组对照。三个高质量子集分别取 1k 、 3k 和全部 5,545 道(论文简称为 5k ),其中 1k 和 3k 是从全集里随机抽的;另一组从清理和过滤之前的池子里随机抽大约 8,000 道,叫原生 8k ,它们带着编译残留和没复查过的测试。四组用同一套训练配置,评测点也取同一段。
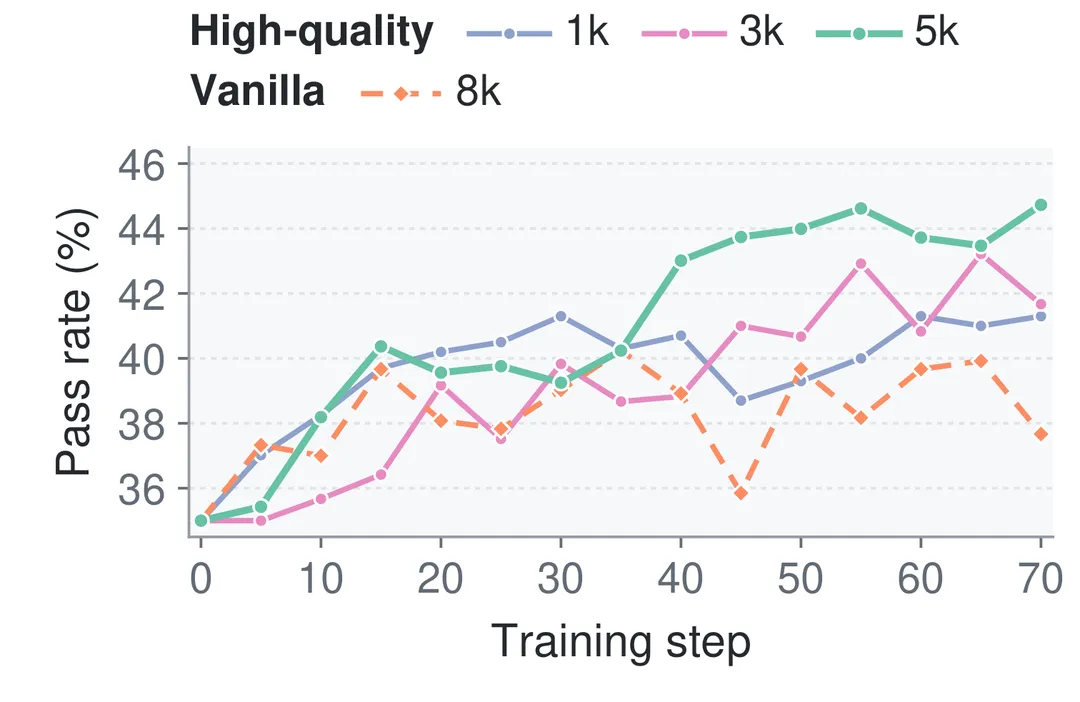
四组数据的通过率曲线:实线配圆点是清理后的 1k 、 3k 、 5k 三个高质量子集,虚线配菱形是过滤之前的原生 8k 。横轴从第 0 步到第 70 步,每 5 步一个评测点,没有做平滑。
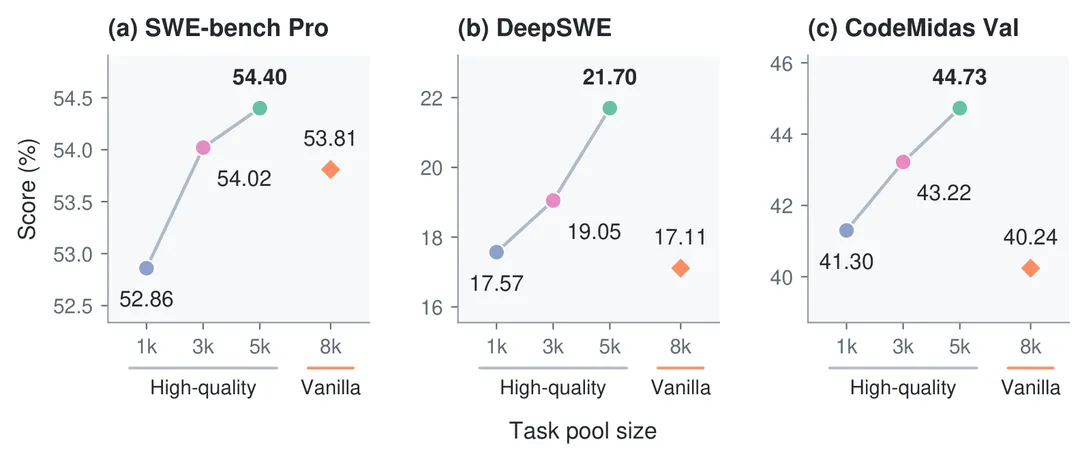
三个评测上的规模与质量对比。连线的圆点是 1k 、 3k 、 5k 三个高质量子集,菱形是过滤前的 8,000 道。三张子图的纵轴范围不同,不要横向比高度。
三个评测上都是单调上升,规模越大成绩越好。这里的 5k 就是前面主结果用的那 5,545 道任务,不是另一次实验。
和 8k 的对比更能说明问题:过滤前的原生 8k 在 CodeMidas Val 上是 40.24 、在 DeepSWE 上是 17.11 、在 SWE-bench Pro 上是 53.81 , 5k 分别高出 4.49 、 4.59 和 0.59 个百分点。连规模只有一半的 3k 子集,也在三项上全部超过 8k 。同样是 MiMo-V2.5 、同样的训练配置, 5,000 多道清理干净的任务打赢了 8,000 道没清理的。
脏题会直接教坏模型。题面漏了关键要求,模型答对也被判错;测试把某一种写法当成需求,行为正确的实现被判失败;环境里残留的编译产物和缓存,又让模型抄到答案就拿满分。这三种情况都会给出错误信号,而强化学习照着信号训练,好坏都会照单全收。清理和过滤花掉的那些算力,在这里换回了更少但更有效的样本。
训练出来的行为变化
研究量了三类行为在训练前后的变化,用它们解释成绩是从哪来的:改代码之前读文件、搜代码(探索),写代码时先在推理里打过草稿(起草),改完之后自己跑验证(自检)。
模型在动手改代码之前读得更多、搜得更多。写下的代码里,有更大比例是先在推理里打过草稿的(起草比例量的是「先想清楚再落笔」的程度:把每次写进文件的代码切成 16 个字符的小片段、每隔 4 个字符取一段,再看这些片段里有多少在动手写之前的推理里已经出现过。比例越高,说明代码是先想过再写下来的,训练后它从 0.358 升到 0.629 )。改完之后,它跑过的验证命令种类也变多了。
自检和成功率的关联是三项里唯一站得住的。看置信区间只看一点:它有没有跨过 0 。跨过 0 ,意味着单看这批数据没法排除「这点差异只是随机波动」,只能说还看不出差别;它不等于证明了没有差别。在同一道任务、同一个训练步骤的条件下,自己写了验证并跑过验证的作答,平均通过率高出 4.2 个百分点,区间是 1.8 到 6.6 ,没有跨过 0 。
自检可以直接分成「做过」和「没做过」,探索次数是一个计数,起草比例是一个比值,两者都没有天然的两分组,所以论文改用中位数切分:把同一个评测点上的作答按该指标排序,取中位数分成高低两组,再比两组通过率(没有记录到该行为的作答不计入)。探索次数这样比出来的差距是 +0.7 个百分点(区间 -1.9 到 3.7 ),起草比例是 +1.95 个百分点(区间 -0.04 到 3.96 )。两个区间都跨过了 0 ,只能说还看不出差别。
上面这两个「自检」量的不是同一件事:表里那一行数的是改完之后跑过多少种不同的验证命令;+4.2 个百分点这一项比较的对象是「自己写了验证并跑过」和「没写」这两类作答,和命令数量无关。
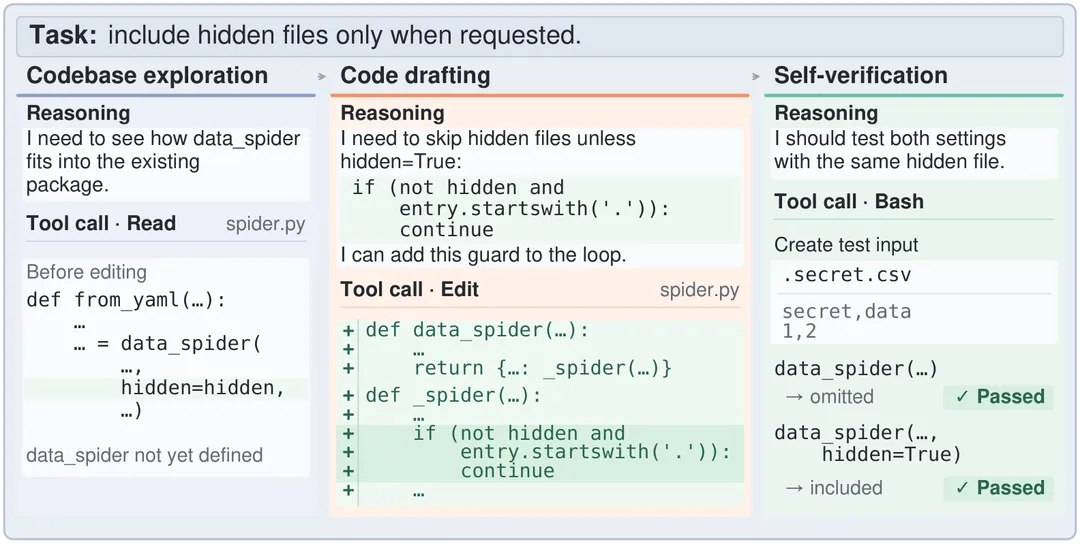
一次真实训练轨迹的片段,题目是「只在被要求的时候包含隐藏文件」,图中的文件名和函数名都来自这个示例任务。三列分别对应探索、起草和自检:先读调用方 spider.py ,确认代码里还没有 data_spider 这个函数;再写下隐藏文件过滤的判断,用编辑工具落到文件里;最后造了一个 .secret.csv 当输入,把默认和 hidden=True 两种情况各测一遍,两次都通过。绿色加号是新增的代码, Passed 表示实际行为与预期一致。
图上这次作答就是三类行为的顺序:先弄清调用关系,再写代码,写完自己验一遍。论文的措辞只是「与更高的通过率相关」。这个相关有两种解释:自检帮了忙,或者本来就好做的任务让模型有余力自检。要分开这两者需要额外实验,论文没有做。
这些行为变化也出现在没参与训练的外部基准上:
表里每一项都是训练前期到训练后期的变化:「探索次数」是改代码前读文件、搜代码的次数,「交互步数」是一次任务里模型操作的步数。 Terminal-Bench 的起草比例标的是「不适用」;论文只在表注里提到统计时排除了没有定义的测量,没有解释这一项为什么测不了。
交互步数的变化方向不一致:仓库修复从 37.3 步涨到 50.1 步, ProgramBench 从 155.1 步降到 122.8 步。论文只补了一句: ProgramBench 上探索变多的同时整体交互变短,没有继续拆解其中的因果。
这套方法没解决什么
结果分布过滤把「难度正好落在当前模型的能力区间」当成了保留条件。全过和全没过的任务都被丢掉,所以留下哪些任务,取决于用哪个模型筛、给它几次机会。换一个更强的模型或者换一笔更小的预算,留下的数据集就会变,这一点论文没有展开。
这也决定了它和 SWE-bench 那类固定题库的性质不同:这里的「难度合适」是相对某一代模型定义的,模型换代之后按同一套流程重筛,得到的题目会和上一代不一样,训练集因此更像消耗品,要跟着模型一起重造。
原生 8k 那组对照是从清理和过滤之前采样的,它同时缺了环境清理、六个容器的一致性检查和后面三道过滤。 5k 赢过 8k 说明整条流程有价值,但没有拆开算每一道检查各自贡献了多少。想照着做一个简化版本的人,很难判断哪一步可以省。
自检和成功率的关联是观察性的,不能读成因果。比较限定在同一道任务、同一次训练步骤内部,已经排除了任务难度和训练阶段的影响,但「模型在某一道任务上更愿意自检」和「自检让这道任务更容易做对」之间的先后关系,仍然没有被实验区分开。
训练只用了一个模型。 MiMo-V2.5 之外的基础模型能不能拿到同样的收益,没有证据。
判分完全依赖自动生成的测试,奖励只有 0 和 1 两种取值。测试写歪了,强化学习就会照着歪的标准训练。整套流程用一连串检查把这种风险压小,但没有人工复核这一关,也没有估计过滤之后还残留多少判错的测试。
训练用的仓库来自公开项目,其中不少热门项目的代码很可能在预训练语料里出现过;如果模型凭记忆就能写出被删掉的那块实现,训练就退化成了背诵。研究只验证了训练集与五个基准的任务集不重叠,没有讨论预训练语料这一层。有一处间接证据支持它确实学到了东西:如果提升主要来自背答案,换成另一套仓库的外部基准时成绩不该跟着涨,而这里五项都在涨。
最后是成本。候选从 22,575 条筛到 5,545 道,大约每 4 条候选才能得到 1 道可用任务,而每条候选至少要跑一遍代码探索和题面撰写、一遍测试构造与复查、六个容器的执行检查,再往后还有对抗采样(让一个 agent 扮成作弊者在环境里翻找答案)、四次作答复核和结果分布筛选。论文没有给出单条任务花掉多少 token 或多少钱,这个数字决定了这条路线对没有大集群的团队是否可行。数据集和训练代码也没有放出来,论文源码包里找不到本项目的仓库链接(参考文献里只有 MiMo-V2.5 的模型主页)。
照着这条路做,能直接复用的是前两道检查:查泄漏和查判分一致性都不依赖具体模型,搬到自家的数据流水线上就能用;难度分布那一道得换成你自己的模型重筛一遍。剩下要盯的只有一个数字:这两道检查的开销能不能再降一个量级。降得下来,代码仓库就是一座随取随用的题库;降不下来,它仍然只属于手上算力充足的团队。