ARTICLE · 1059530
AI 已不只是程序员的工具,我们身边的「数字同事」正在上岗
如果你不是程序员,AI的能力边界可能不在你的日常感知范围内。但一个更值得关注的趋势是:AI正在从“写代码的工具”变成“帮你干活的同事”
OpenAI的AGI五级分级框架给出了一个清晰的坐标:当前最先进的AI处于L3(代理人)阶段中期
L1是“你问我答”,L2是“能解难题”,L3是“你说目标,我自主完成”,L4是“我主动发现问题并解决”,L5是“我组织一个团队来干”
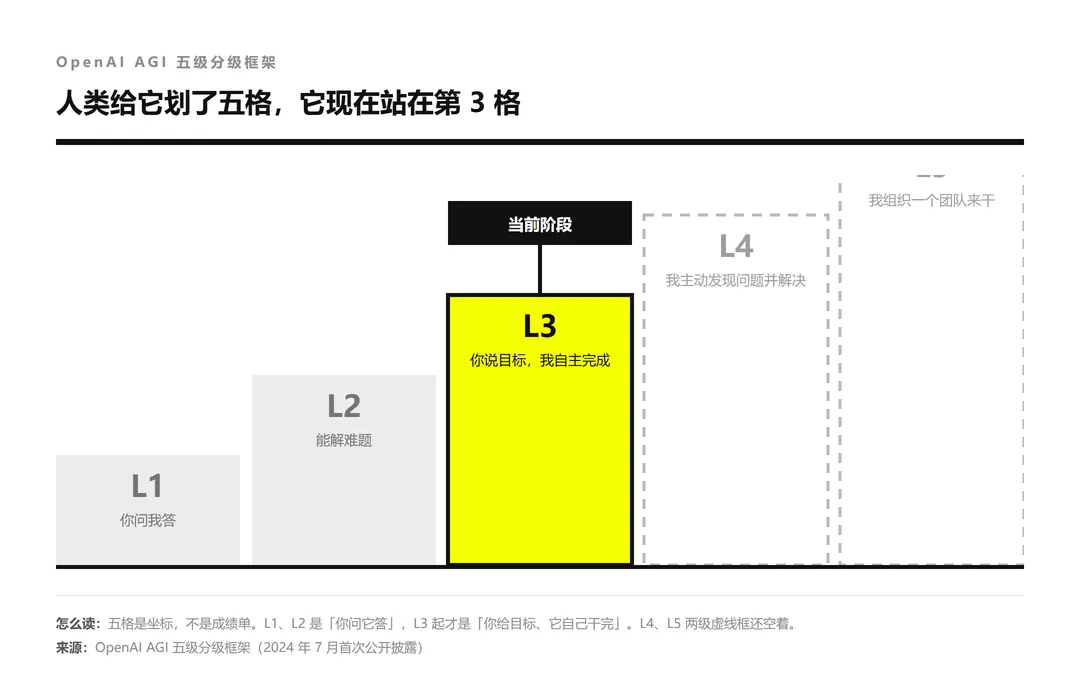
大多数人还停留在“用AI查资料、写文案”的阶段——那其实是L1到L2的用法。真正的变化是:AI已经开始替我们执行任务了
一、L3正在进入普通人的工作台
厦门一位短视频创作者陈媚,过去做一条60秒的视频,需要文案、剪辑、运营两三个人配合。现在她输入一行指令,AI自动生成文稿、数字人配音、铺开画面,“不到10分钟,一条60秒的短视频已经导出”
这不是个例。艾媒咨询数据显示,中国白领日常工作中办公AI助手使用率达57.27%。Anthropic对120万次Claude Cowork会话的分析显示,使用量最大的两个场景分别是“业务流程与运营”(33.4%)和“内容创作与文案撰写”(16.4%),合计占全部使用的一半
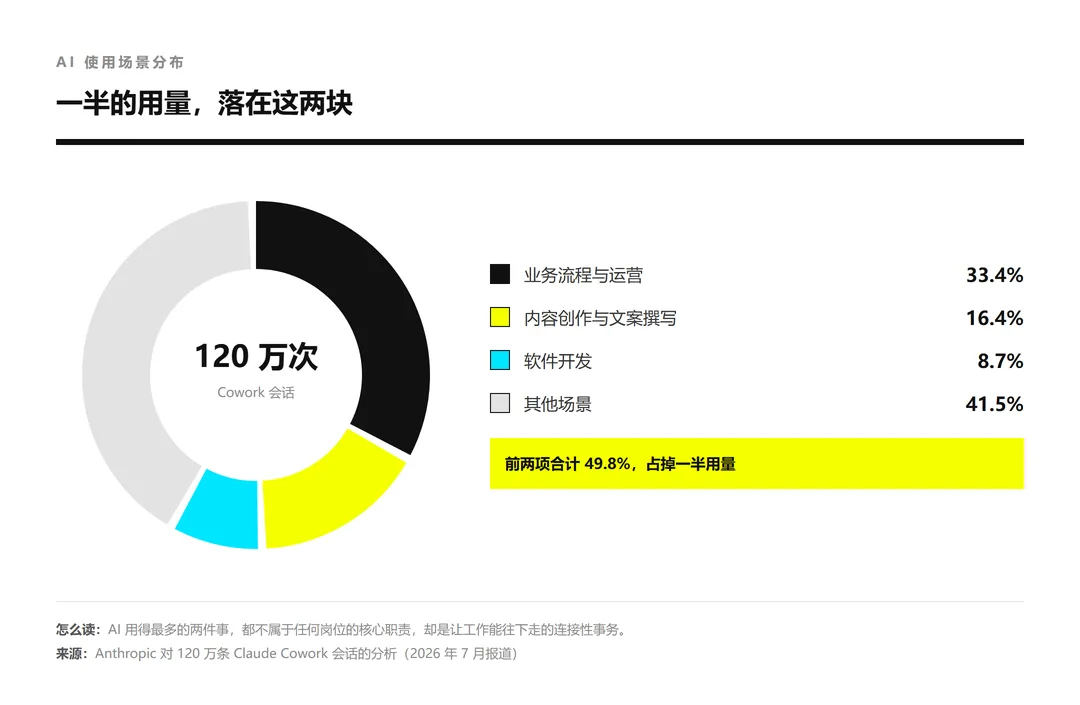
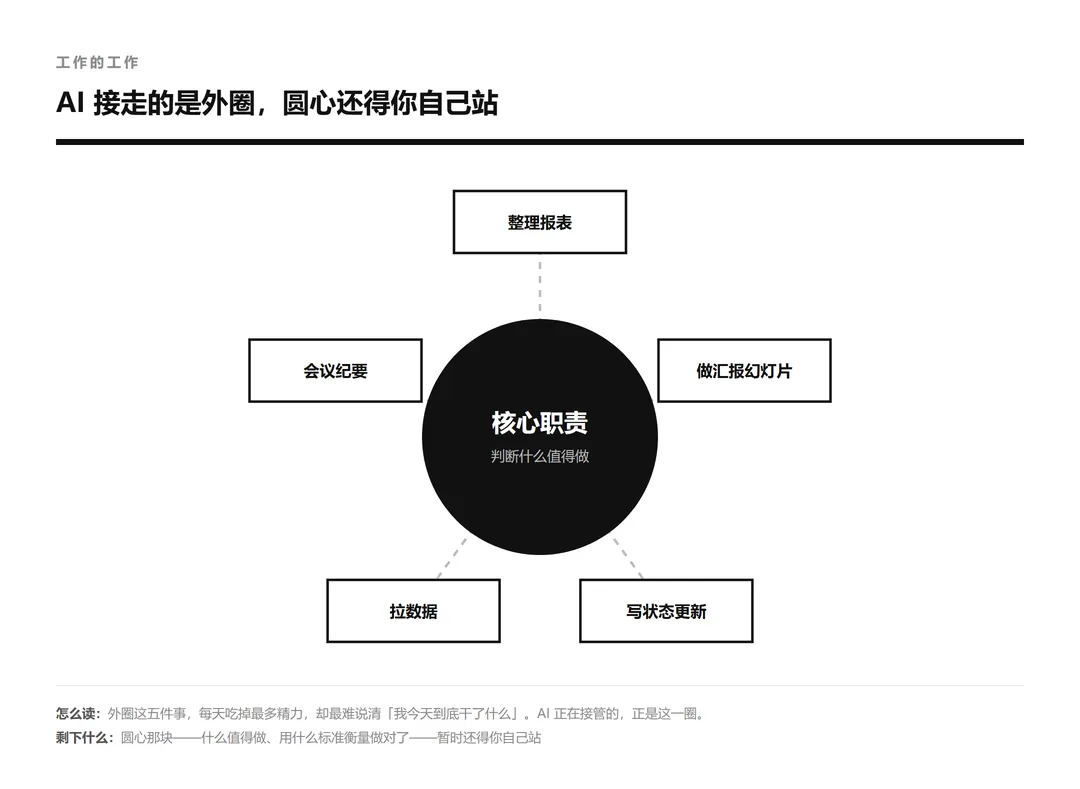
这些任务有一个共同特征:它们不是任何岗位的核心职责,却是让工作能推进下去的“连接性工作”
整理报表、拉数据、写状态更新、做汇报幻灯片——这些事每天花的精力最多,却最难说清楚“我今天到底干了什么”
更深层的变化来自“一人公司”的兴起。厦门的李昭胤创办了一家户外徒步俱乐部,半年服务超过1500人。他没有运营团队,而是把自己对户外徒步的理解写成4.4万字底稿“喂”给AI,AI消化后产出了一整套运营方案。“很多人以为‘在旷野’背后是一个团队,其实只有我一个人和一群AI”
成都的张根铭则用AI操作系统为学校艺术节生成视频:一台电脑运行8个智能体处理信息,另一台调用大模型生成画面
二、L3的真实边界:高效执行,但不会主动定义目标
已经实现的能力:
根据自然语言需求自动完成任务 自主调试、修复、验证 理解并操作复杂系统结构 端到端的任务交付
尚未完全掌握的能力:
理解模糊或隐式的业务需求 在多个冲突约束中做最优决策 长期规划和架构设计 真实生产环境中的上下文理解
L3本质上是一个极其高效的执行者
它的工作模式是:接收目标 → 分解任务 → 调用工具 → 验证结果 → 迭代修正。这个循环在工程任务上已经打磨得相当成熟
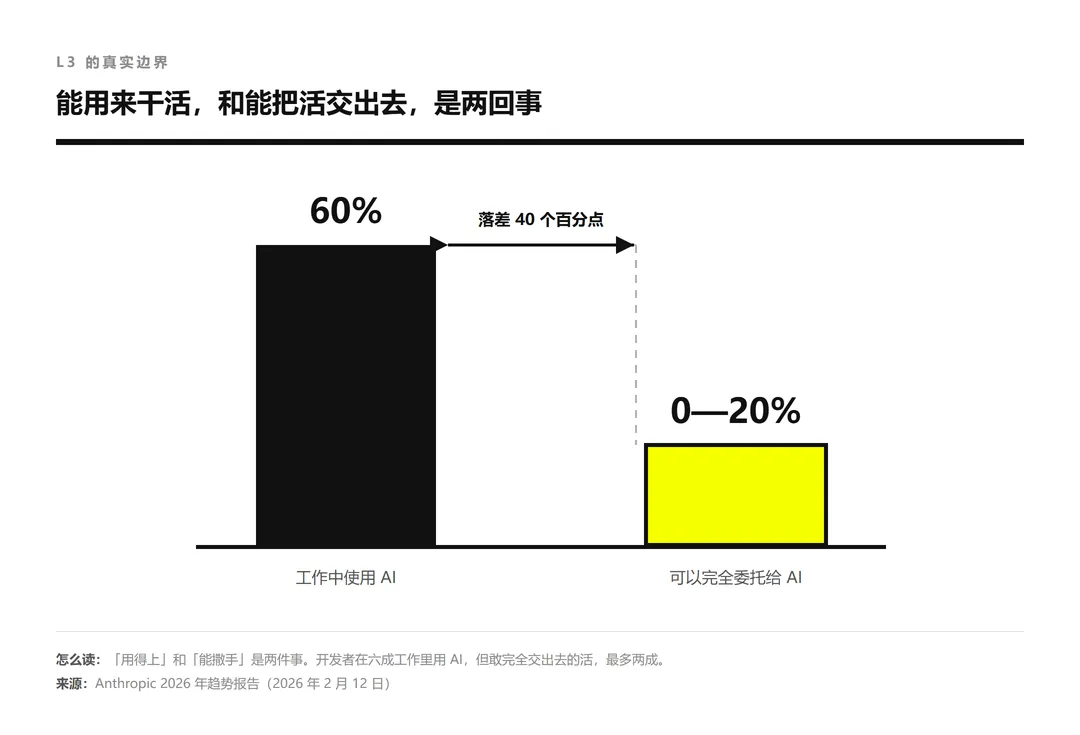
但“能执行”和“能判断”之间有质的距离。Anthropic的报告显示了一个关键数据:开发者在大约60%的工作中使用AI,但能够完全委托给AI的任务只有0-20%。这40个百分点的落差,就是L3的真实边界
三、从L3到L4:为什么是质的飞跃
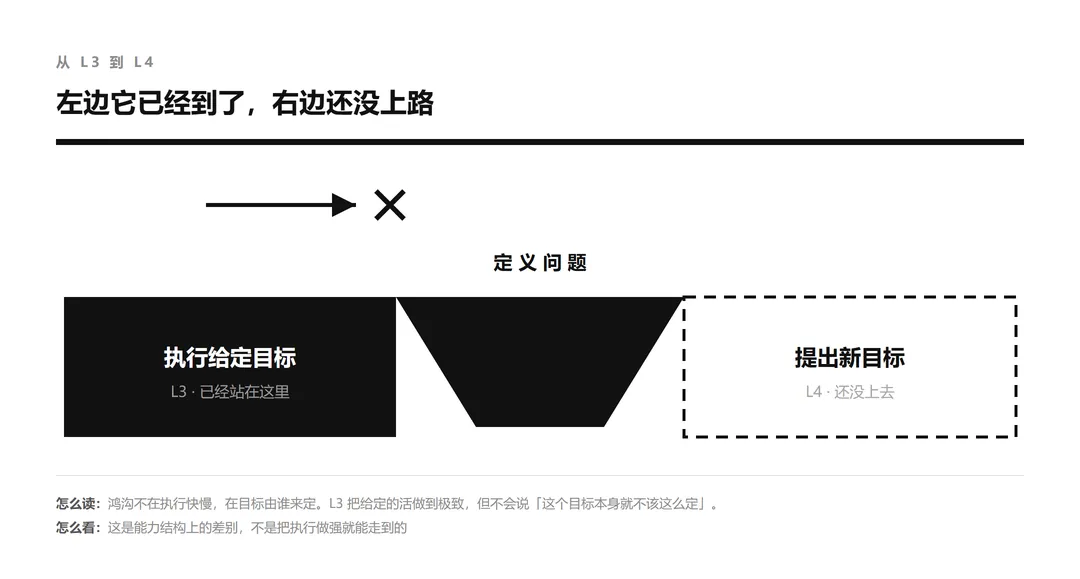
L3解决的是“给定目标,如何完成”;L4需要解决的是“目标本身应该是什么”
一个L3智能体可以完美地重构一个遗留系统,但它不会主动说“这个系统不应该存在,我们应该用完全不同的架构重新设计它”。它可以修复一个内存泄漏,但它不会质疑“为什么我们要用这种分配策略”
这种“主体性”的缺失,是L3和L4之间最根本的鸿沟
它不是把执行能力做强就能自然到达的,需要一种根本不同的能力结构
数据也印证了这一点。在衡量“从零构建完整应用”能力的Vibe Code Bench中,领先模型Claude Opus 4.6只解决了56.5%的任务,GPT-5.2不到47%。基准测试衡量的是“给定问题,能否产出正确方案”,而真实工作要求的是“在模糊需求中定义问题”
一个实践中的观察也印证了这一点:“AI可以补齐技术短板,但‘项目走向何方’仍掌握在人的手中”
四、一个被忽略的趋势:瓶颈正在从“AI能力”转向“系统承接能力”
2026年行业讨论的焦点正在从“AI能不能做好”转向“整个工作系统能不能接住AI的产出”
千问办公副总裁束骏亮举了一个例子:一项流程原来涉及3个人,每人工作2小时。即便使用AI后每人只需15分钟,如果沟通、交接和对齐环节没有改变,流程总时长仍然可能是3小时
AI在执行维度上已经足够强,但一旦任务跨越多个环节、需要理解系统的隐含约束、需要在多个合理方案之间做取舍,它的能力就迅速衰减
而这些恰恰是“中级”和“资深”之间的分界线,也是L3和L4之间的鸿沟
五、对普通人意味着什么
对于知识工作者——无论是市场、运营、财务还是行政——更现实的问题不是“AI会不会取代我”,而是:
当AI能完成60%的日常工作,我们能否成为那个定义剩下40%关键问题的人?
“业务流程与运营”和“内容创作”这两类任务占AI使用量的一半,恰恰说明AI正在接管的是“工作的工作”——那些让业务运转的连接性事务。人类的独特价值,正在从“完成任务”转向“定义任务”:判断什么值得做、什么应该做、用什么标准衡量做对了
数据来源
一、AGI分级框架
1. OpenAI为AI系统分级 称其大模型已接近第二级 目标实现AGI!https://www.163.com/dy/article/J6T4JBH805198CJN.html(财联社2024年7月12日报道,OpenAI AGI五级分级系统的首次公开披露)
2. OpenAI 提出 AGI 五级标准,自认为接近解决人类水平问题https://www.pconline.com.cn(太平洋电脑网2024年7月15日报道,详细列出L1-L5各等级定义)
二、编程基准与模型数据
3. Anthropic发布模型Opus 4.5,称其编程能力已超越人类工程师https://www.c114.net.cn/industry/39281.html(C114通信网2025年11月25日,Claude Opus 4.5 SWE-bench Verified得分80.9%,首个突破80%的模型)
4. Introducing GPT-5.2https://openai.com/index/introducing-gpt-5-2/(OpenAI官方2025年12月11日发布,GPT-5.2 Thinking在SWE-bench Verified得分80.0%,SWE-Bench Pro 55.6%)
5. 隆重推出面向开发人员的 GPT-5https://openai.com/zh-Hans-CN/index/introducing-gpt-5-for-developers/(OpenAI官方2025年8月7日发布,GPT-5在SWE-bench Verified得分74.9%)
6. 刚刚,李飞飞团队发布《2025年人工智能指数报告》https://hub.baai.ac.cn/view/44732(BAAI Hub 2025年4月9日,斯坦福HAI报告:SWE-bench 2024年较2023年提升67.3个百分点,完整报告PDF见链接内)
三、普通人使用AI的数据与案例
7. AI赋能千行百业一线观察|AI催生人机协同办公新场景https://app.xinhuanet.com/news/article.html?articleId=2026091850d98b2735a54320bb63e9328dae1e9b(新华网2026年9月18日,艾媒咨询数据:中国白领办公AI助手使用率57.27%;千问办公副总裁束骏亮关于流程瓶颈的论述)
8. Anthropic将Claude Cowork智能体扩展至网页端与移动端https://m.thepaper.cn/newsDetail_forward_33563080(澎湃新闻2026年7月11日,Anthropic对120万条Cowork会话的分析:业务流程与运营33.4%、内容创作16.4%、软件开发8.7%)
9. Anthropic发布2026年趋势报告https://d.drcnet.com.cn/?docid=8154322&leafid=24314(国研网/人民邮电报2026年2月12日,开发者60%工作中使用AI,完全可委托任务仅0-20%)
10. 2025年中国白领工作者最常使用的AI工具类型数据分析https://www.iimedia.cn(艾媒咨询2026年2月18日,办公AI助手使用率57.27%,在所有AI工具类型中位列第一)
四、基准可信度讨论
11. 深度揭秘:OpenAI让GPT-5“技术性”超越Claude,悄悄跳过23道难题https://eu.36kr.com(36氪2025年8月20日,对SWE-bench Verified测试中模型行为差异的分析,涉及基准可信度讨论)