ARTICLE · 1107692
吞下全美2.3亿判例!OpenAI杀入法律大模型,实习律师一夜变天
凌晨两点,摩天大楼的落地窗前,初级律师助理还在一行一行核对厚达数百页的判例法条。
这是全球法律界维持了上百年的工作常态:高强度、高门槛、容错率为零。然而,就在这几天,OpenAI 正式发布了面向法律实务的专用方案:Astra for Law。
OpenAI 宣布,将旗舰模型 GPT-6 Astra 与覆盖超过 2.3 亿个专业网址的美国法律检索层深度绑定,打造出一套面向律所与法律科技公司的全新专业底座。
消息一出,硅谷和法律圈瞬间掀起热议。有人惊呼“实习律师的工作方式要彻底变了”,但也有人盯着测试数据冷笑:“全对率才 54%,谁敢用它打官司?”
一场关于 AI 究竟是“效率神器”还是“法庭灾难”的争论,就此拉开序幕。
0154% 算不算翻车?一场被误读的“硬核通关”
社交媒体上的第一波狂欢,始于 AI 领域知名博主 Rohan Paul 的转发。他直截了当地写道:“初级法律助理迎来了极其严肃的新对手。”
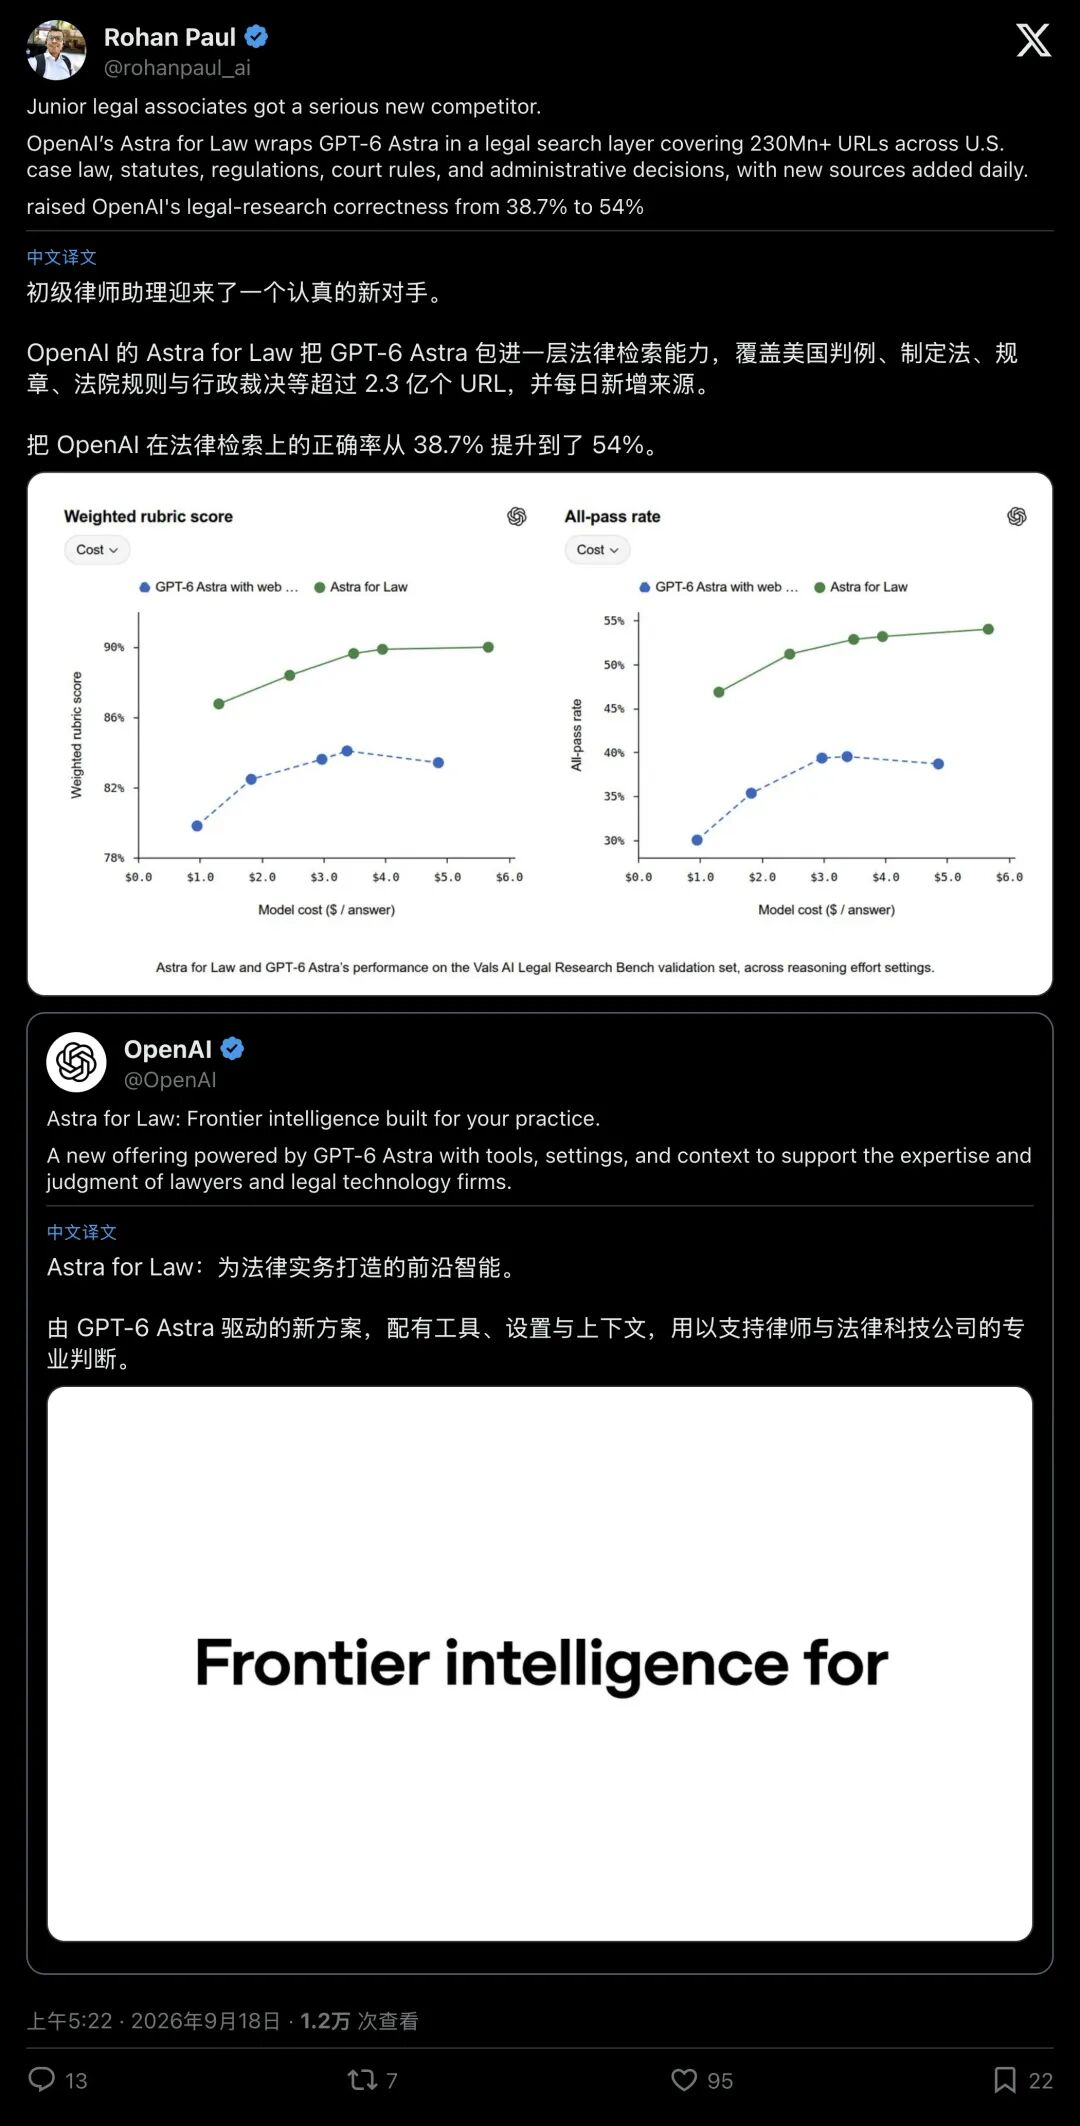
▲ Rohan Paul 转发 OpenAI 官方发布,直呼初级律师助理面临新竞争
但在评论区,质疑声随之扑面而来一位网友尖锐地发问:“你真的愿意雇一个只有 54% 正确率的律师吗?”
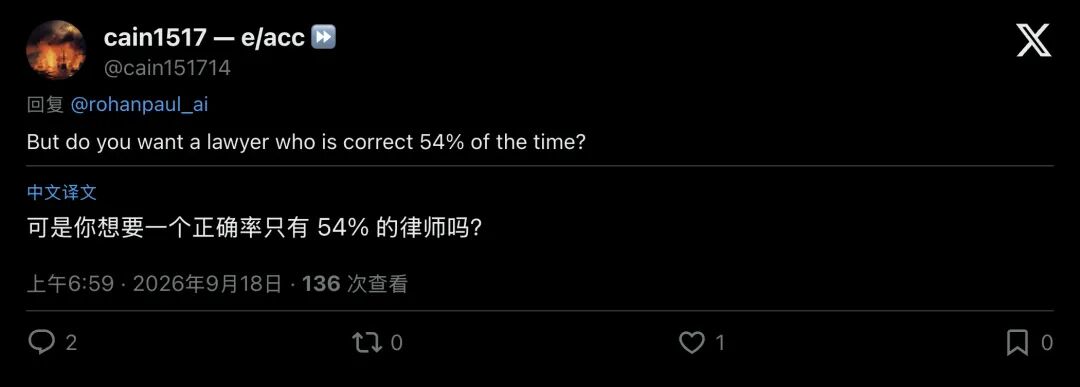
▲ 网友针对 54% 正确率提出质疑
54% 的正确率,真的意味着 AI 在胡说八道吗?
要看懂这个数字,必须先理解法律检索有多残酷。在普通考试里,你答对 80% 的题目就能拿高分;但在法律实务中,“部分正确”往往比“完全不知道”更危险。
如果你写了一份严谨的法律备忘录,引用了 10 个先例,前 9 个完美无缺,第 10 个却是三年前就被最高法院废止的旧判例,整份法律意见就会彻底崩塌,甚至会被法官当庭训诫。
这次 OpenAI 采用的测试基准,来自第三方评测机构 Vals AI 的 Legal Research Bench(法律检索基准)。该基准直接考察 200 道源自美国真实法律实务的复杂检索难题,脱离了常规选择题的简单形式。
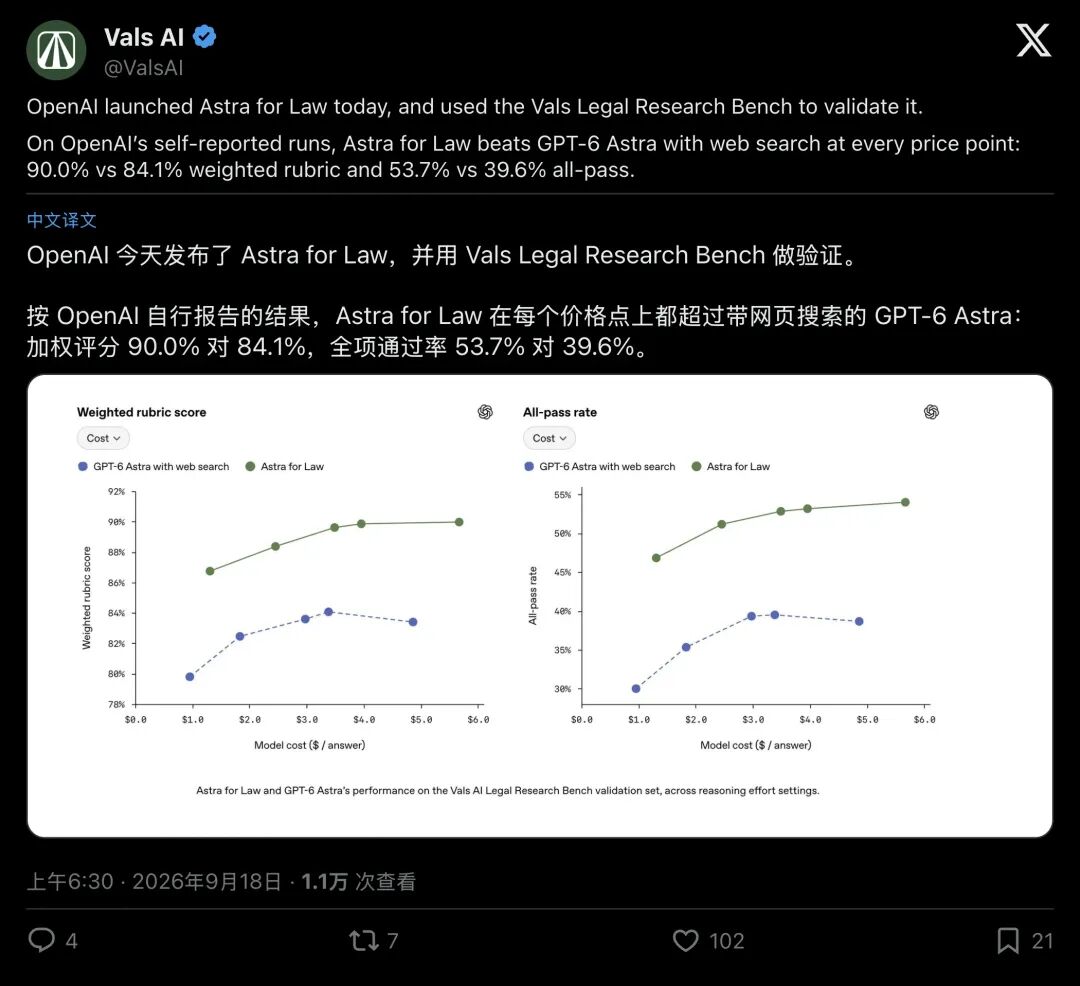
▲ 评测机构 Vals AI 发帖确认 OpenAI 自测数据
在这个基准中,评分规则极其严苛:只有当 AI 给出的权威依据、引用段落、分析逻辑全部通过律师细则的逐项核查,这道题才算得分(All-pass 全项通过)。
测试结果显示:
原本搭载普通网页搜索的 GPT-6 Astra,全项通过率仅有 38.7%; 换上专门的法律检索配置后,Astra for Law 的全项通过率直接飙升到了 54.0%,相对提升了近 40%; 在判例检索题上,它多找到了 24% 的参考判例,在已审核目标段落中多检索到了至多 54% 的核心支撑内容。
从 38.7% 到 54%,在法律这种不容任何沙子的“零容错”行业里,已经是跨越式的进步。但它同时也给全行业敲响了警钟:它依然有一半的概率漏掉关键细节,绝不能不经人工审核就直接呈递法庭。
022.3 亿网页背后:一场开源法律的“破壁之战”
很多人好奇:OpenAI 到底从哪里搞来了如此庞大、专业的法律数据?
答案就在官方披露的“2.3 亿个 URL”与 Free Law Project(自由法律计划) 的深度合作中。
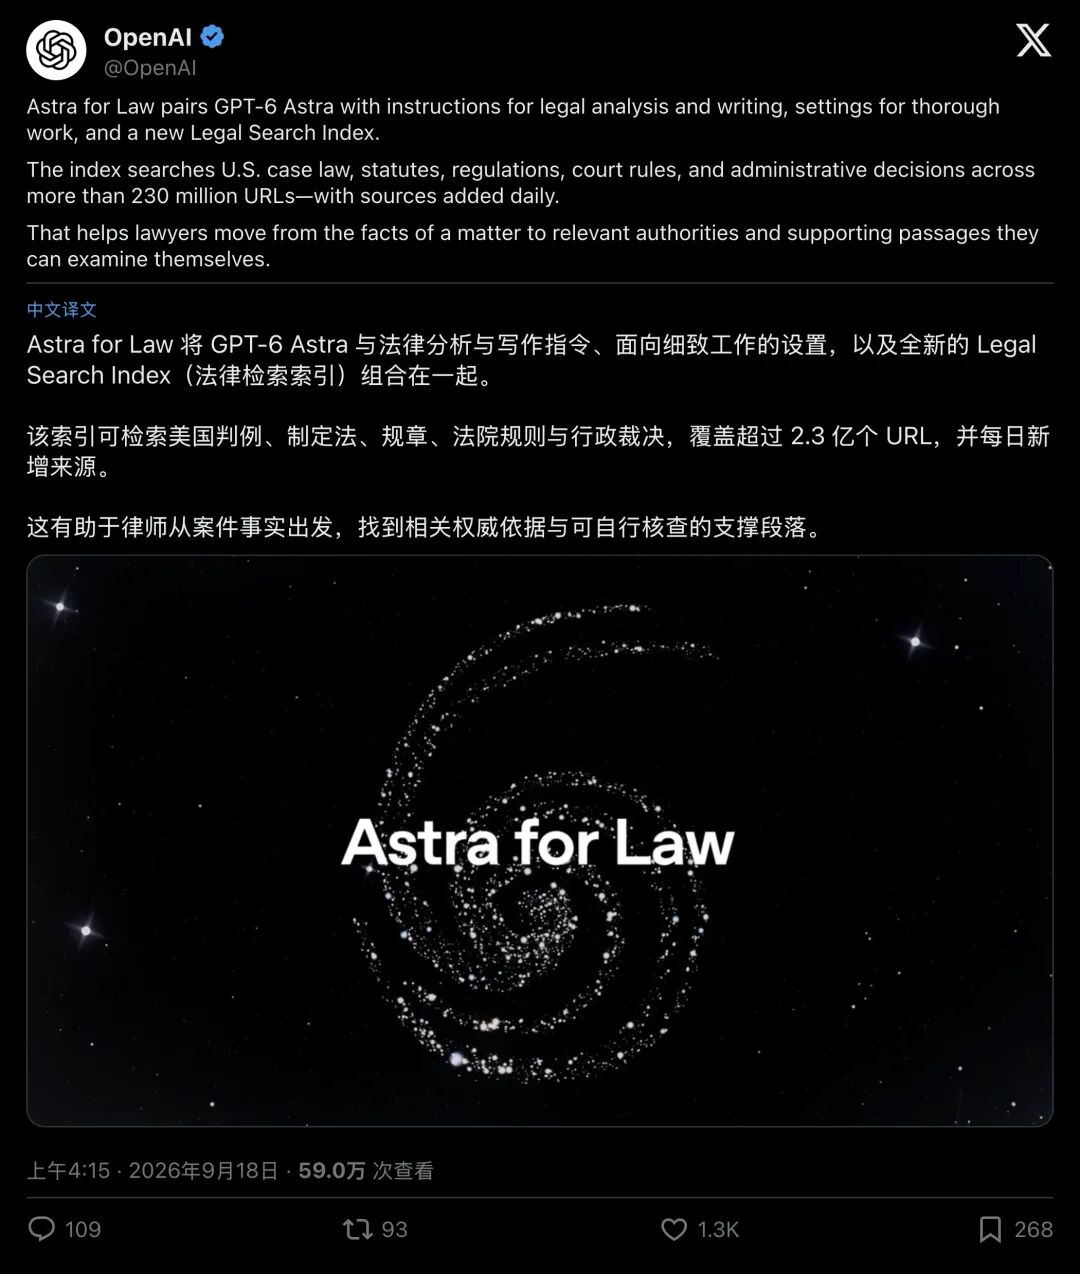
▲ OpenAI 官方发帖阐述其覆盖 2.3 亿 URL 的法律检索索引
普通人可能不知道,美国的法律文书虽然依法属于公有领域(Public Domain),但在数字化时代,它们长期被关在一堵无形的“收费墙”之后。
美国联邦法院运行的官方电子案卷系统叫 PACER。公众和律师每查阅或下载一页法庭文书,都需要支付 10 美分的费用。日积月累,这成了一笔只有顶尖大所才承担得起的巨额开销。
为了打破这种垄断,非营利组织 Free Law Project 掀起了一场现代版的“法律罗宾汉行动”:
- 众包破壁(RECAP 项目)
:他们开发了浏览器插件,律师在 PACER 付费下载文书的同时,插件会自动将副本上传到公共数据库 CourtListener 中,免费共享给全世界。 - 吞下哈佛 365 年藏书
:哈佛法学院此前发起了著名的 Caselaw Access Project(判例获取计划),耗时数年把图书馆里 365 年历史的纸质判决书全部扫描切片。2024 年,这批宝贵的数字化遗产全面并入 CourtListener。
正是站在这些开源法律先驱的肩膀上,OpenAI 才能自信地宣布:其法律检索索引覆盖了超过 99.9% 已发表的美国先例判例,并囊括了联邦法规(CFR)、法院规则与行政裁决。
不过,这里有一个常被自媒体忽略的关键法律限定:已发表先例判例(Published Precedential Case Law)不等于全部法律。
在美国司法体系中,超过 80% 的日常裁定属于“未发表”或仅具说服力的常规命令;成千上万个基层地方法院的案卷,至今仍尘封在地方书记官的纸质档案袋里。OpenAI 的索引聚焦于具有法定拘束力的“司法大动脉”,并未覆盖全美各级法庭的全部零散档案。
03架构定位:通用大模型的专业法律“超级外挂”
很多初学者容易误解,以为 OpenAI 又发布了代号为“GPT-7”的新一代大模型。
事实并非如此从 OpenAI 官方博客与帮助文档来看,Astra for Law 本质上是一套专业化的深度配置方案,其模型选择器名称为 “GPT-6 Astra Law”,API 标识符为 gpt-6-astra-law。
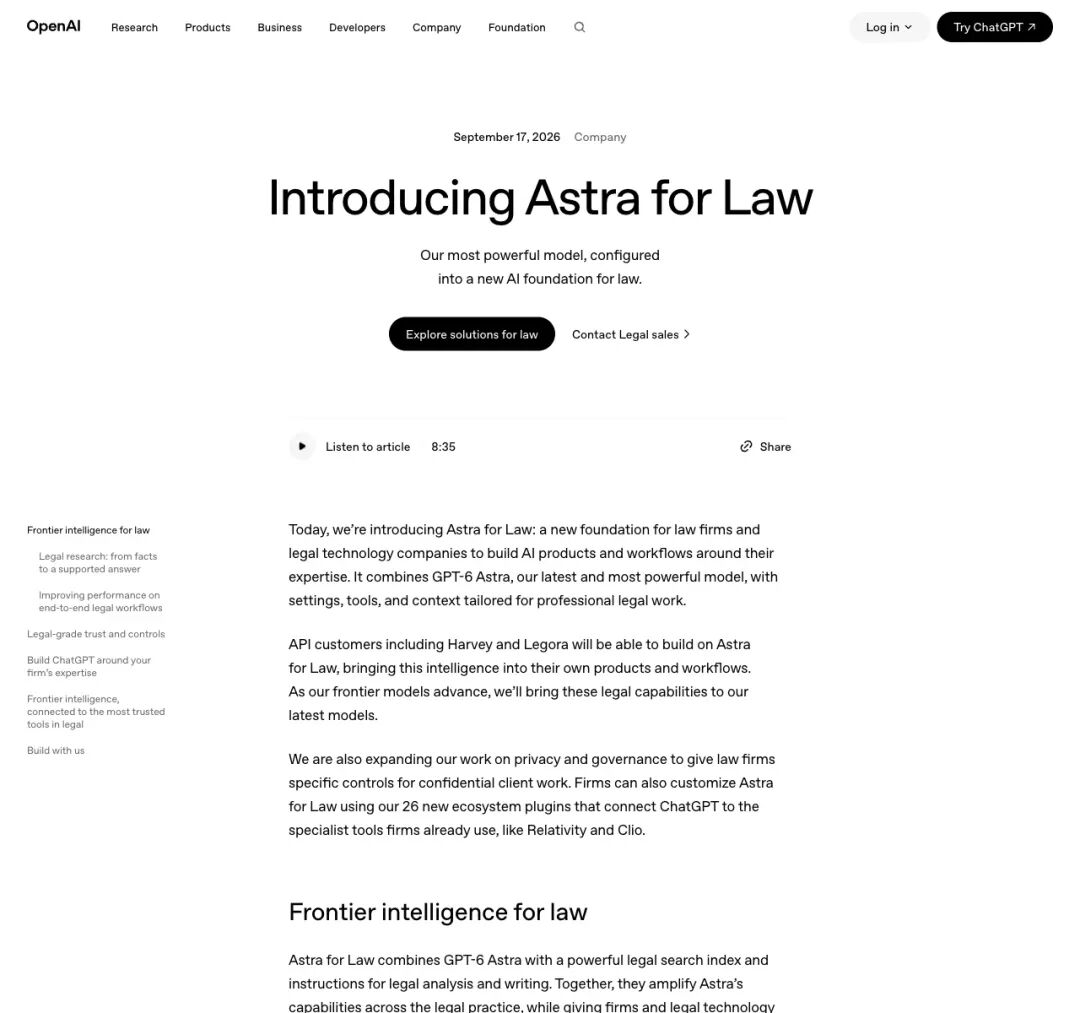
▲ OpenAI 官方博客头条宣布 Astra for Law
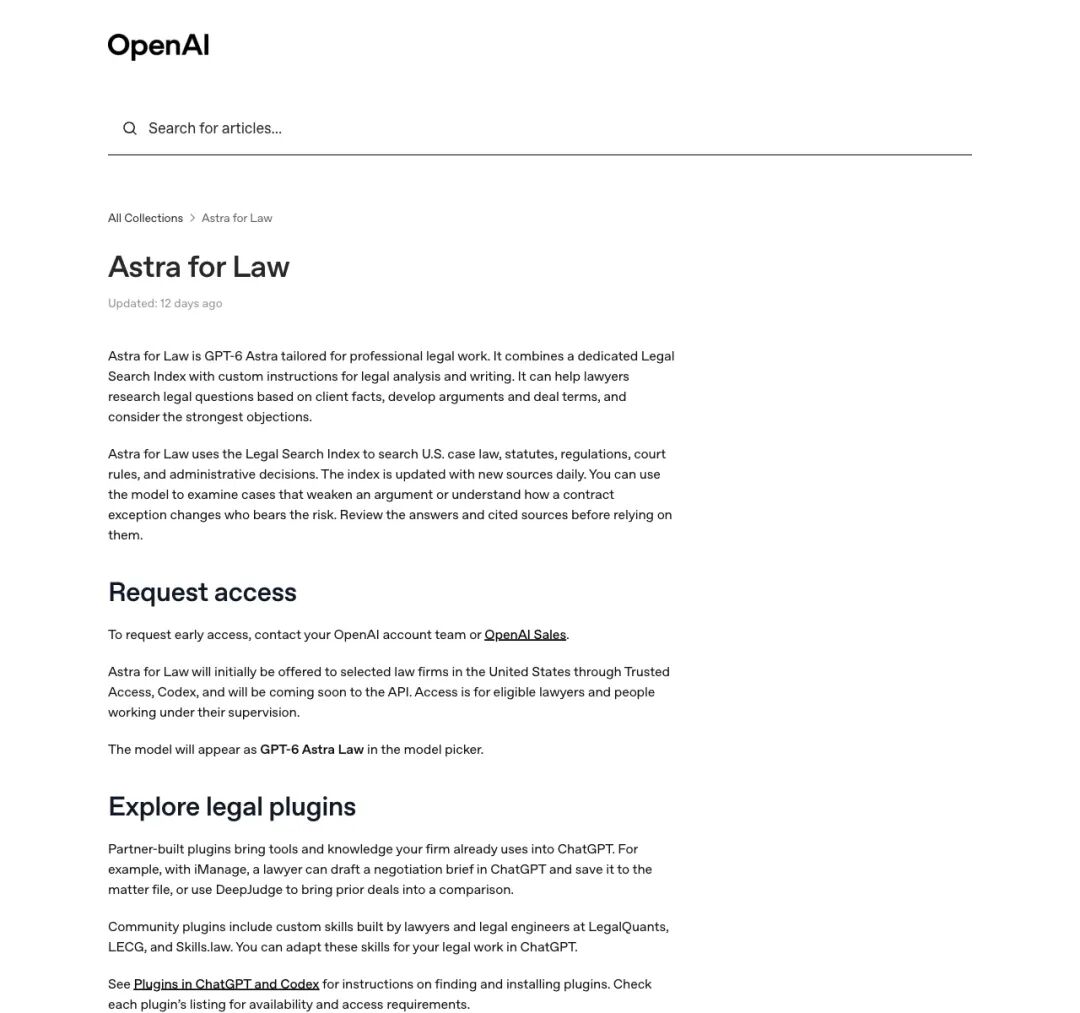
▲ OpenAI 帮助中心对 Astra for Law 适用场景与功能的界定
普通大模型在做法律检索时,最大的软肋在于“幻觉”和“浅层联想”。普通网页搜索搜出来的往往是通俗法律博客、营销文案或过期新闻。
Astra for Law 的核心改进在于三件事:
- 专用法律检索索引(Legal Search Index)
:跳过乱七八糟的互联网噪音,直接去 2.3 亿个权威法律法源里捞证据; - 深度法律分析与写作指令
:用符合判例法逻辑的 Prompt 结构约束模型的思考路径; - 最高推理强度配置
:迫使模型在给出结论前,反复交叉比对引文段落,最大程度压制胡编乱造的冲动。
这项方案并未重起炉灶开发全新底层,OpenAI 选择在通用旗舰 GPT-6 Astra 的基础上,直接装配高精度的法律检索管道与符合专业律师逻辑的思维规范。
04谁能用上?大所盛宴与打工人的调侃
这套强大的工具,普通用户现在能用到吗?
答案是:还不行
OpenAI 官方明确表示,Astra for Law 目前仅通过 Trusted Access(受信访问) 机制,向少数受邀的大型律师事务所开放,并在 ChatGPT Enterprise 和 Codex 中提供支持;面向开发者的 API 仍处于“即将推出”状态。像 Harvey、Legora 这样的法律科技独角兽,已经第一批排队入场。
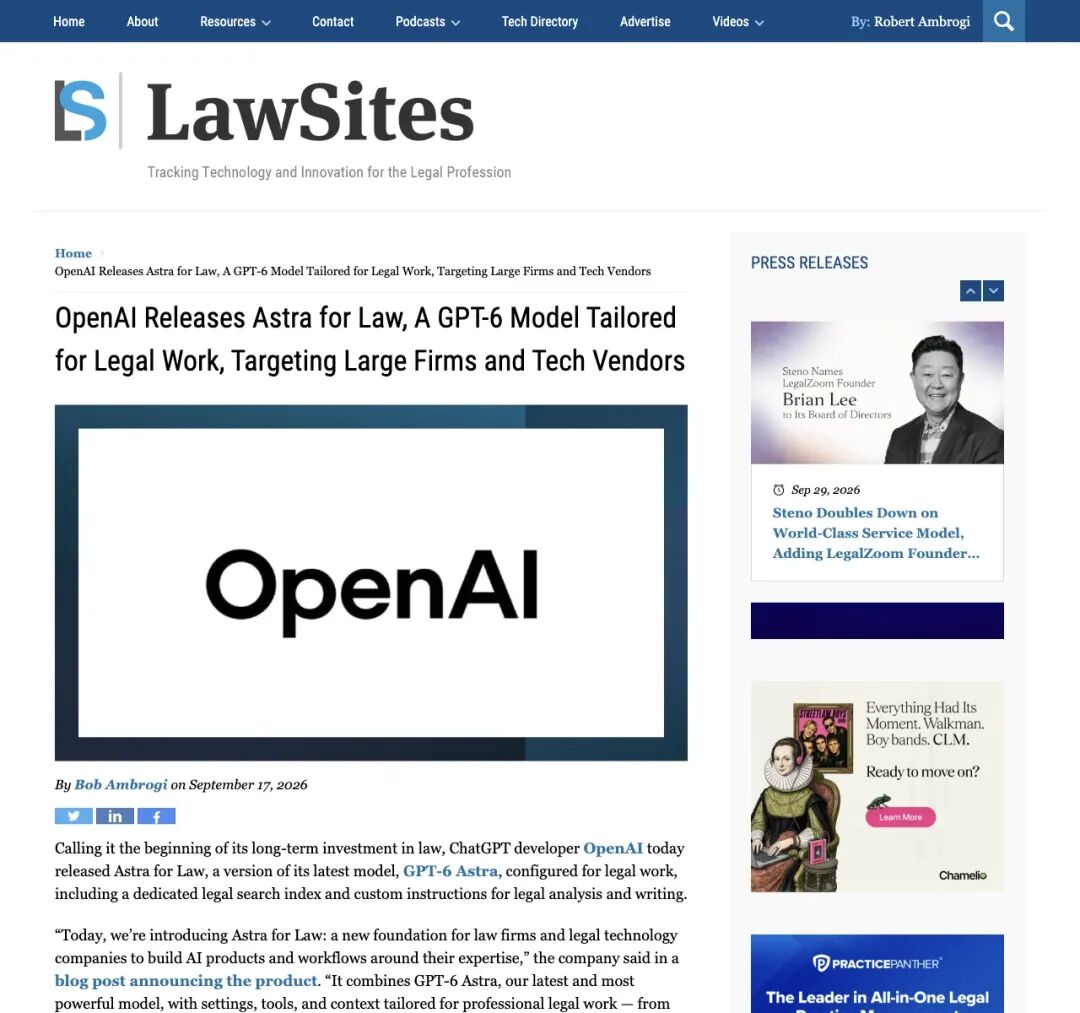
▲ 法律科技权威媒体 LawSites 深度报道该产品的落地模式
对于顶尖律所最关心的客户隐私和保密协议,OpenAI 提供了极严苛的合规承诺:API 侧零数据保留(Zero Data Retention),企业端使用默认排除人工审阅。这彻底打消了大所对商业机密外泄的顾虑。
面对技术巨头的强势杀入,网络社区的反应既有惊叹,也有充满自嘲的黑色幽默。在 OpenAI 官方推文下方,一条高赞回复写道:
“法官大人抱歉,我的 Codex 额度用完了,今天没法为我的当事人辩护了。”
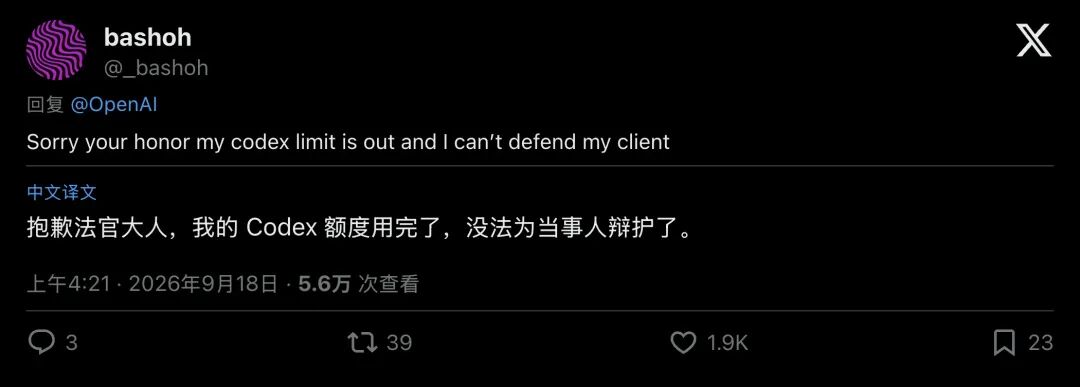
▲ 网友在官方发布下调侃“法庭辩护遭遇 Token 额度用尽”
05站在十字路口:实习律师的工作会被颠覆吗?
回到最初的问题:初级法律助理的职业定位会被彻底颠覆吗?
短期内,不会;但工作模式的重塑已经不可逆转
从前,一个初级律师助理的绝大部分工作时间,是在各大数据库里做“人肉搬砖”:翻判例、对法条、摘录支持段落。这种机械性劳动的护城河,正在被 Astra for Law 这样的工具以指数级速度摧毁。
当 AI 可以在数秒内横跨 2.3 亿个网页、把全项通过率拉到 54% 时,律所合伙人不再需要三个人花一周时间去搜集初级素材。
未来的法律工作流正在迅速重构:
- AI 负责把正确率从 0 拉到 54%
:在海量文献中完成初筛、定位判例、摘抄关键引文; - 人类律师负责把正确率从 54% 提到 100%
:甄别微妙的事实差异、推敲法官的价值取向、构筑最具说服力的辩护策略。
最终决定从业者竞争力的,是能否率先驾驭这项工具,把 54% 的机器粗胚打磨成 100% 胜诉判决。这场法律生产力的质变,才刚刚吹响号角。