ARTICLE · 1147198
8GB 显卡跑起 125B 大模型,从下载到接进 入Agent,全套流程真能走通?
老爸的Ai联萌
Strata 小白完整入门教程,8GB 显卡跑起 125B 大模型
从零开始,把 Strata 装到你的 Windows 电脑上,让它跑起 1250 亿参数的 Qwen3.8-Flash-Next,再当成免费的本地上游接进 Cursor 和 Claude Code。
跟着做完,你会有一个不联网也能用的大模型。
速览速览
下面这张表先把你想知道的都答完,后面每一章再展开。
| 你想知道的 | 答案 |
|---|---|
入门新手上路
完全新手就按第 1 章到第 9 章的顺序读。 第 1 到第 3 章决定你要不要装,第 4 到第 6 章是装的过程,第 7 章把它用起来,第 8、9 章是出问题时的落脚点。
这篇的成色先说清楚,因为两类内容来源不一样。
■ 速度数据和真机截图来自我自己这台机器,RTX 5090(32GB 显存)、Ryzen 9 9950X、96GB 内存,跑的是 Swift 1.5 的 IQ3_XXS 档位,运行日志里攒了 235 次推理记录。
■ 硬件门槛、安装步骤、接口这些,来自官方文档原文(README、docs/INSTALL.md、docs/MODELS.md 等)加上官方收录的社区实测。我本机是 5090,8GB、12GB 这些卡我没有,凡是不是我亲手测的,都会写明出处。
卡住了怎么办。 先翻第 9 章的常见问题表,八成的坑都在里面。还不行就去 GitHub 开 issue,附上 Strata 文件夹里的 strata-<模型>.log。别一看到报错就把整个项目删掉重来,重下一遍 70GB 才是真的亏。
01这个项目是什么
一句话,Strata 是一个只为 Qwen3.8-Flash-Next 这一个模型写的推理引擎,不做通用推理,也不是给 llama.cpp 套壳。
那要跑的模型有多大。Qwen3.8-Flash-Next 是 1250 亿参数的混合专家模型,里面装着 24,576 个小专家。它每生成一个词,真正干活的只有其中大约 10 个。
打个比方,它像一个几万人的顾问团。团里坐满了专家,可你眼前这道题,只需要其中几位出场。
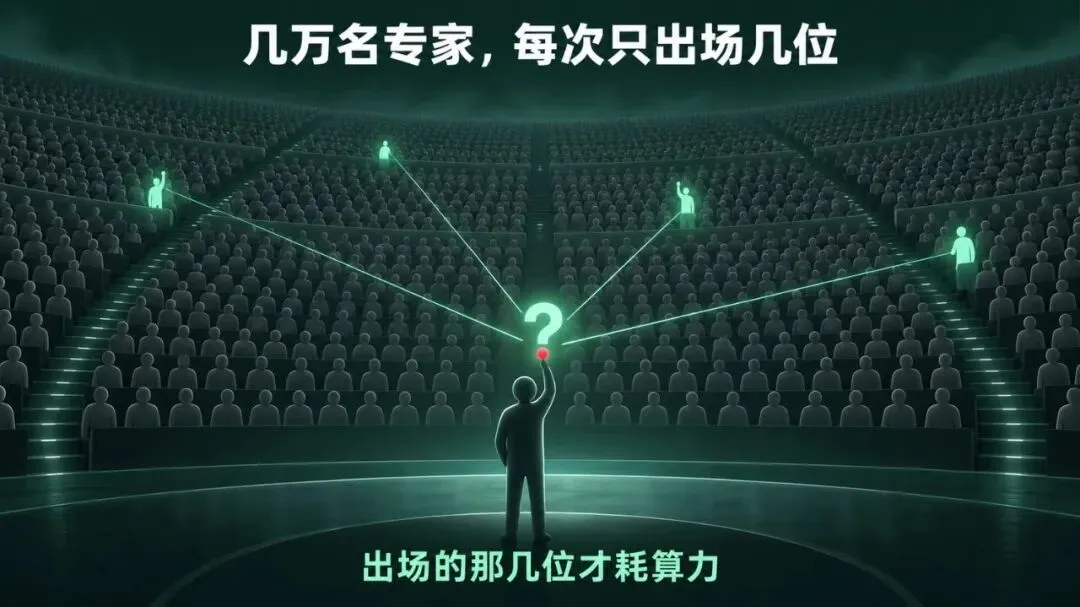
24,576 位专家里,每次只叫醒大约 10 位
Strata 的所有设计都围着这一点转。它把整台电脑拆成三层,各装一部分。
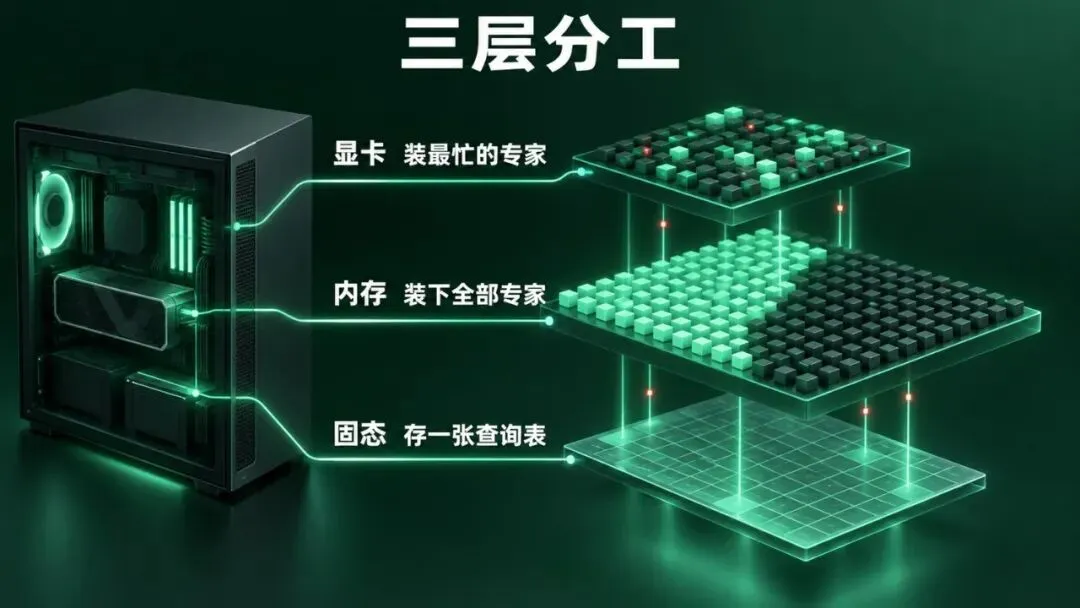
显卡装最忙的,内存装全部,固态当仓库
■ 显卡(8 到 32GB)只留最常用的那约 4,000 个专家,跑核心计算。
■ 内存加 CPU(32 到 128GB)装下全部 24,576 个专家,没进显卡的那部分由 CPU 接着算。
■ 固态硬盘(约 29GB)放一张查询表,用到才读。
在这之上还有第二层优化,叫猜词再批改。一个小帮手先猜出后面几个词,大模型一次性核对,猜对的一起留下。答案完全一样,速度快 1.6 到 1.8 倍。
装好之后你看到的就是下面这个面板,显存、功耗、磁盘读取、缓存命中率全是实时值。
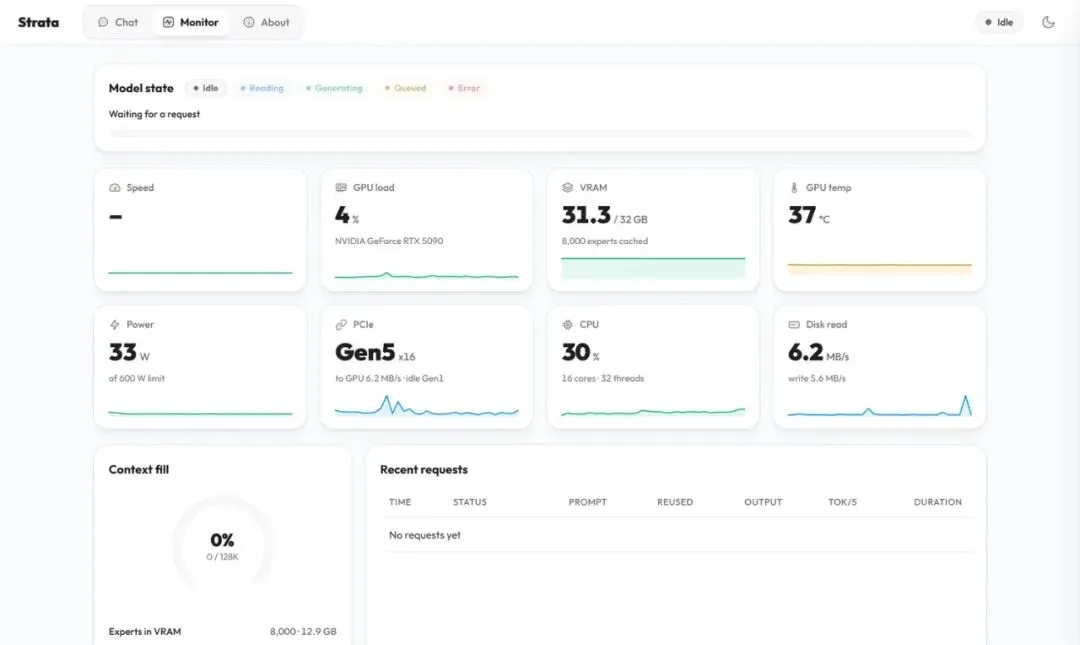
装好之后的本机监控面板
还有一条边界必须先说。它跑不了别的模型。 Llama 不行,DeepSeek 不行,Qwen 的其他尺寸也不行。引擎是照着这个模型的专家结构和那张 29GB 查询表专门做的,所以别指望装一个 Strata 就什么都能跑。
这个项目 9 月 24 日开源,到 10 月 7 日已经发了 44 个版本,Star 涨到 17,220。版本密说明两件事,真有人在用,而且它还在早期,有坑,但修得快。
02它能干什么,干不了什么
先看官方放在 README 顶上的那段演示。一句提示词,没有人工改一行代码,它写出了一个能开起来玩的体素宝塔庭院。
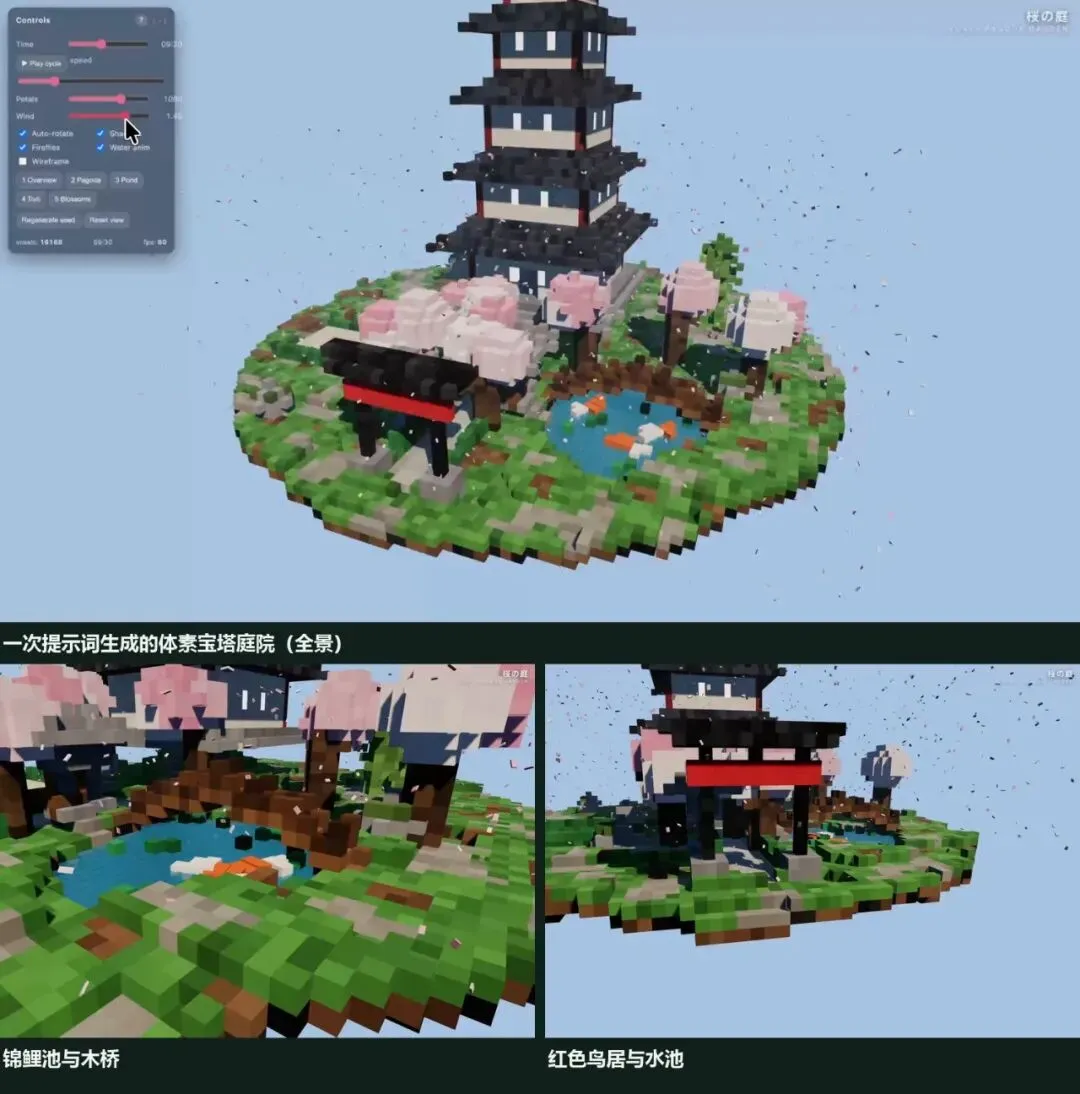
官方演示,一句提示词写出的体素宝塔庭院
注意左上角那个 Controls 面板,那是它写出来的应用自带的功能,能调花瓣数量、风力、萤火虫开关,还有五个预设机位。右上角挂着实时帧率。它交出来的是一份带交互、能调参、能直接打开玩的完整东西。
我自己也在本机试了一个。一段提示词、5,820 个 token、45 秒,生成了一个纯 Canvas 的城市夜景雨滴。
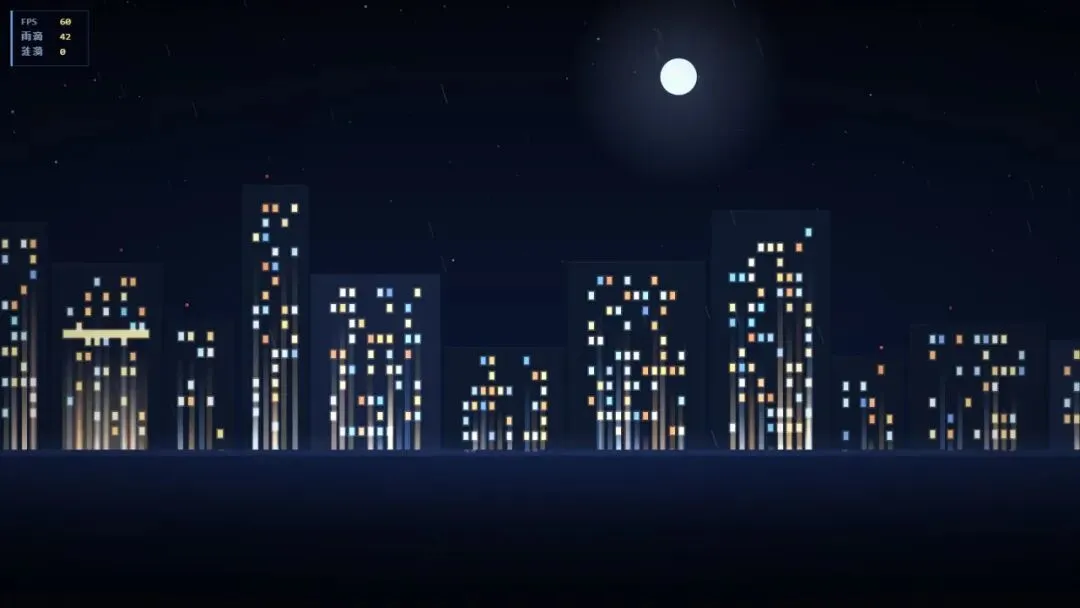
我在本机现场生成的,一段提示词 45 秒
日常真正用得上的活是这些。 写代码、改稿子、问答、翻译、总结长文档、把一堆零散需求整理成方案。这些活量大、重复、对速度不那么敏感,正是本地模型最划算的地方。
干不了的也说清楚。
■ 跑不了别的模型,只认 Qwen3.8-Flash-Next。
■ 一次只处理一个请求。 同时挂两个 Agent,后一个会排队。官方给了 "parallel": 2 的并发开关,但在 12GB 的卡上开了之后整轮请求会掉 11% 到 22%。它是单车道,快,但只有一条。
■ Mac 上用不了。 项目只支持 Windows 和 Linux,CPU 那层写死了 x86-64 加 AVX2。Apple Silicon 是 ARM64,这条路不在这套代码里。
03装之前先对表,你的电脑行不行
这是整篇最该逐行看的一章。显卡、内存、CPU 三样要一起看,缺一样都装不动。
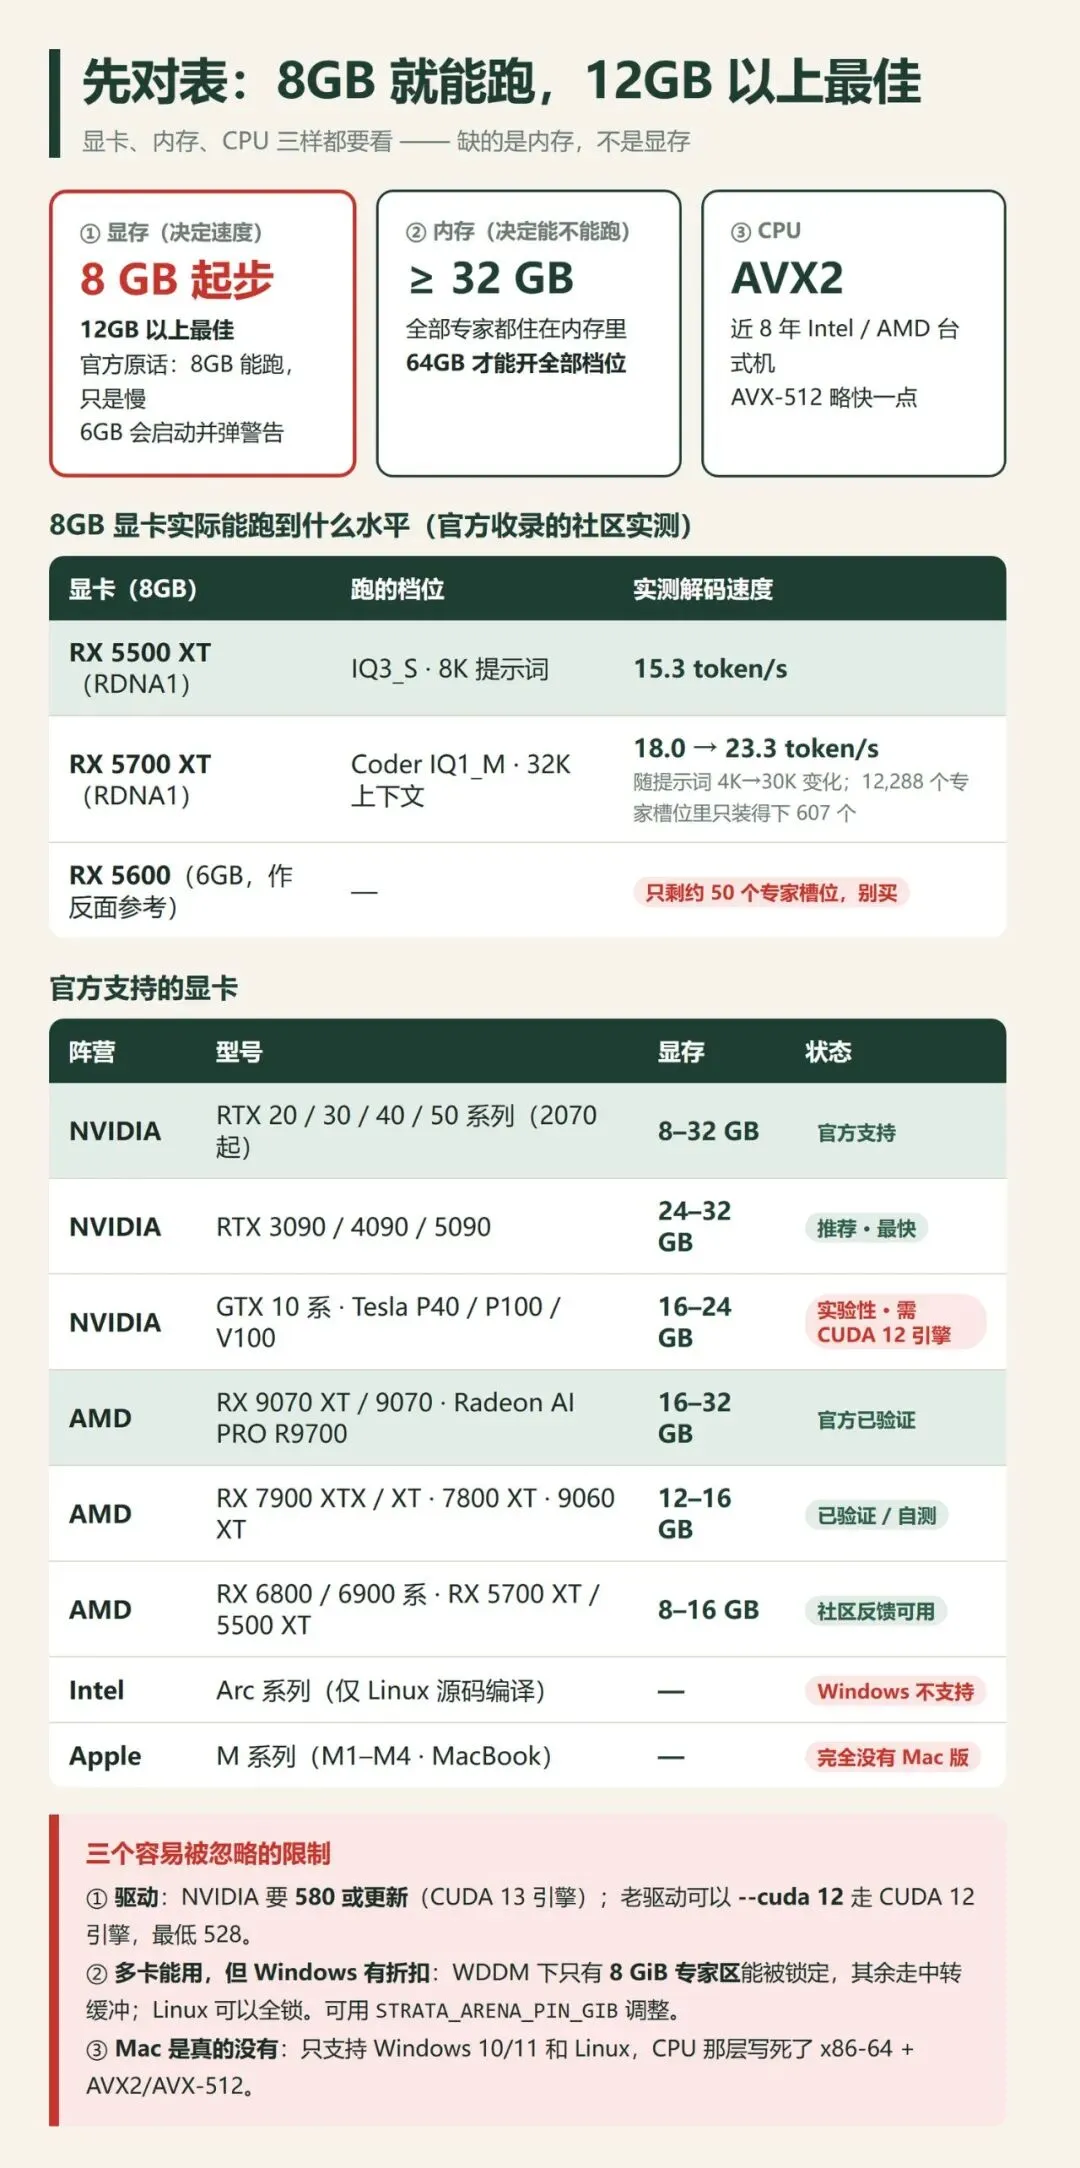
8GB 起步、12GB 以上最佳,以及 8GB 显卡的社区实测
先给官方原话。docs/INSTALL.md 的硬件表里,显卡那一栏写的是这样一句。
❝ 原文引用
NVIDIA RTX 20, 30, 40 or 50 series, 12 GB VRAM or more(8 GB runs, slowly)
翻译过来,官方推荐 12GB 以上,8GB 也能跑,只是慢。
安装程序自己也是这么判的。我跑过 START-HERE.bat --check,它对显存不足只给一句警告,不给拒绝。
❝ 原文引用
显存不足 12 GB 时,Strata 会照常运行,但大部分专家会留在 CPU 上,速度会很慢。
那 8GB 慢到什么程度。官方 docs/OLDER_GPUS.md 收了几条 8GB 卡的社区实测。
■ RX 5500 XT(8GB),IQ3_S 档位、8K 提示词,解码 15.3 token/s。
■ RX 5700 XT(8GB),Coder 档位、32K 上下文,提示词从 4K 加到 30K 时解码 18.0 / 20.3 / 23.3 token/s,12,288 个专家槽位里它只装得下 607 个。
■ 再往下就不好看了。6GB 的 RX 5600 只剩约 50 个专家槽位。所以 8GB 是条实际的分界线,6GB 别折腾。
这里先记住两个分工。
📍 划重点
内存决定能不能跑起来,显存决定跑得多快。
你内存不够,模型连加载都进不去,直接报错。内存够大但显存只有 8GB,那就是慢一点,但能跑。所以别以为内存加到 128GB 就能变快,32GB 和 128GB 的输出速度基本一样。显存这边正好相反,每多 1GB 显存,大约多缓存 700 个专家,也就是少一份要 CPU 代劳的活。
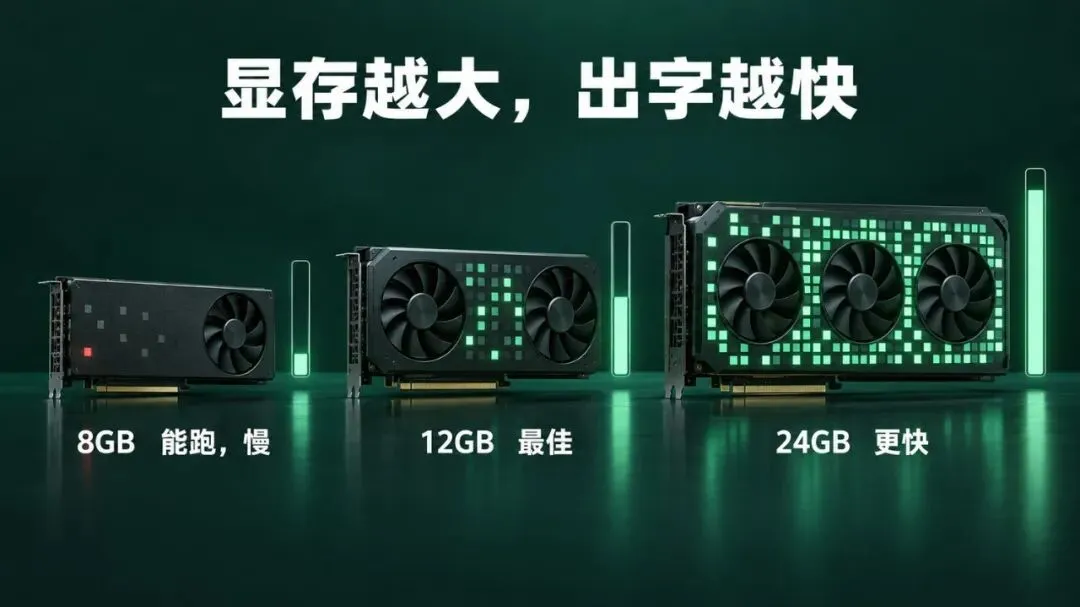
显存越大,能装进显卡的专家越多,出字越快
显卡白名单按官方文档整理。
■ N 卡,RTX 20/30/40/50 系列(2070 起)官方支持。GTX 10 系和 Tesla P40/P100/V100 属实验性通道,要走 CUDA 12 引擎。
■ A 卡,RX 9070 XT/9070、Radeon AI PRO R9700 官方已验证;RX 7900 XTX/XT、7800 XT、9060 XT 已验证或卡主自测;RX 6800/6900 系和 RDNA1 的 5700 XT / 5500 XT 有社区实测。
■ Intel Arc,目前只支持 Linux 源码编译,Windows 下菜单里一律显示不支持。
■ Mac,完全没有版本可用。
驱动是唯一需要你自己动手装的东西。 NVIDIA 要 580 或更新,走 CUDA 13 引擎;驱动老可以加 --cuda 12 走 CUDA 12 引擎,最低支持到 528。
硬盘要留够。 模型 70 到 80GB,草稿层约 6GB,要读图再加 1GB。另外有一条容易漏的,在支持 AVX-512 的 CPU 上选 Q2_0 档位,它会一次性再写一份约 40GB 的专家副本,9950X 这类 CPU 要注意。
最后给一句结论,按你的显卡对号入座。
| 你的显卡 | 体验 | 适合拿它做什么 |
|---|---|---|
04下载,以及选哪个档位
下载走 git clone,别下 ZIP。 地址是 github.com/Niko1221/Strata。差别在后面升级的时候会体现,clone 下来的版本能一条命令升级,ZIP 解压的不行,只能重新下。
国内下载是个现实问题,官方给了两条现成的路。
■ 模型文件走 ModelScope,命令里加 --source modelscope。官方 2026-10-05 在国内实测 11 到 14 MB/s,每个文件都按 ModelScope 公布的 SHA-256 校验过。
■ 或者设镜像,set HF_ENDPOINT=https://hf-mirror.com。同样校验、同样断点续传,中途断了重跑接着下。
关于模型文件放哪。 新版把它放在 Strata 文件夹旁边的 Strata-data 里,这样你换一个新的项目包,它能直接找到老模型、不用重下。想换盘就加 --data-dir E:\Strata-data。
接下来是选档位。进安装菜单会看到 Q2_0、IQ2_XS、IQ3_XXS、IQ3_S 这一串名字,它们是同一个模型的不同压缩档位。压得越狠越快,但越笨;压得越松越聪明,但越慢、越占空间。
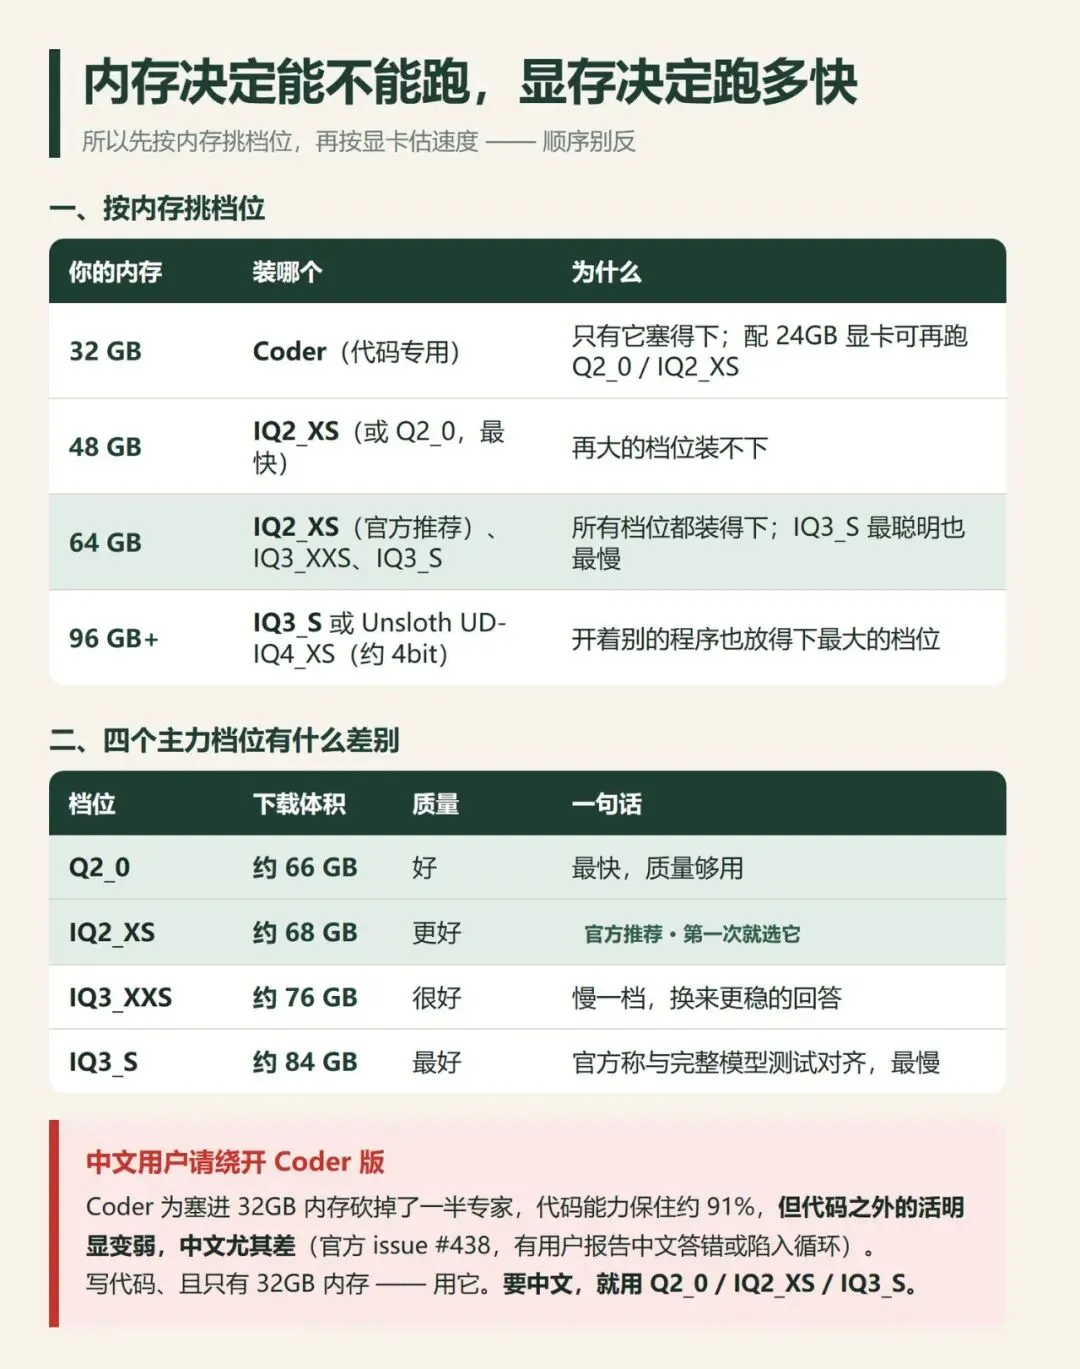
按内存选档位,以及四个主力档位的差别
第一次就选 IQ2_XS,这是官方推荐,也是平衡点。然后按内存对号入座。
| 你的内存 | 装哪个 | 为什么 |
|---|---|---|
| IQ2_XS | ||
档位具体吃多少内存,官方给了数。Q2_0 是 37.6GB、IQ2_XS 39.2GB、IQ3_XXS 47.0GB、IQ3_S 54.8GB,这是内存加显存的合计。判据是你的内存要比这个数多出 10GB 左右,那 10GB 留给 Windows 和你别的程序。
内存实在不够还有一条出路,官方叫低内存模式。内存装不下全部专家时,它改成从模型文件按需映射,内存里只留显卡装不下的部分。32GB 内存配 24GB 显卡能这么跑 Q2_0 和 IQ2_XS,配 12 到 16GB 显卡可以跑 Coder。代价是很多专家要从固态实时读,速度掉得厉害。用 --setup --low-ram on 可以手动开。
这里有一个中文用户必须知道的坑。 Coder 版是为了塞进 32GB 内存做出来的,它砍掉了一半专家,每层 512 个只留 256 个。代码能力保住约 91%,但代码之外的活明显变弱,中文尤其差。官方 issue #438 里有用户报告英文提问正常、中文答案出错甚至陷入循环。
你要中文,就别用 Coder。 老老实实选 Q2_0 或 IQ2_XS。只有你既写代码、又只有 32GB 内存,Coder 才是唯一选项。另外,从 v0.1.27 起 MTP 推测解码表已经包含全部中日文 token,中文输出比早期快了 15% 到 38%。
05动手装,三步走完
Windows 下就是三个动作,剩下的交给安装程序。这一步我写得细一点,因为会卡人的地方都在边上。
5.1 先把清单对一遍
| 项目 | 要求 |
|---|---|
5.2 第 0 步,先自检,别急着下载 70GB
解压之后、动手之前,先跑一条命令。
START-HERE.bat --check只看不装,几秒钟出结果。 它会告诉你显卡型号与显存、驱动版本、内存、CPU 支不支持 AVX2,最后按你的内存列出每个档位装不装得下。
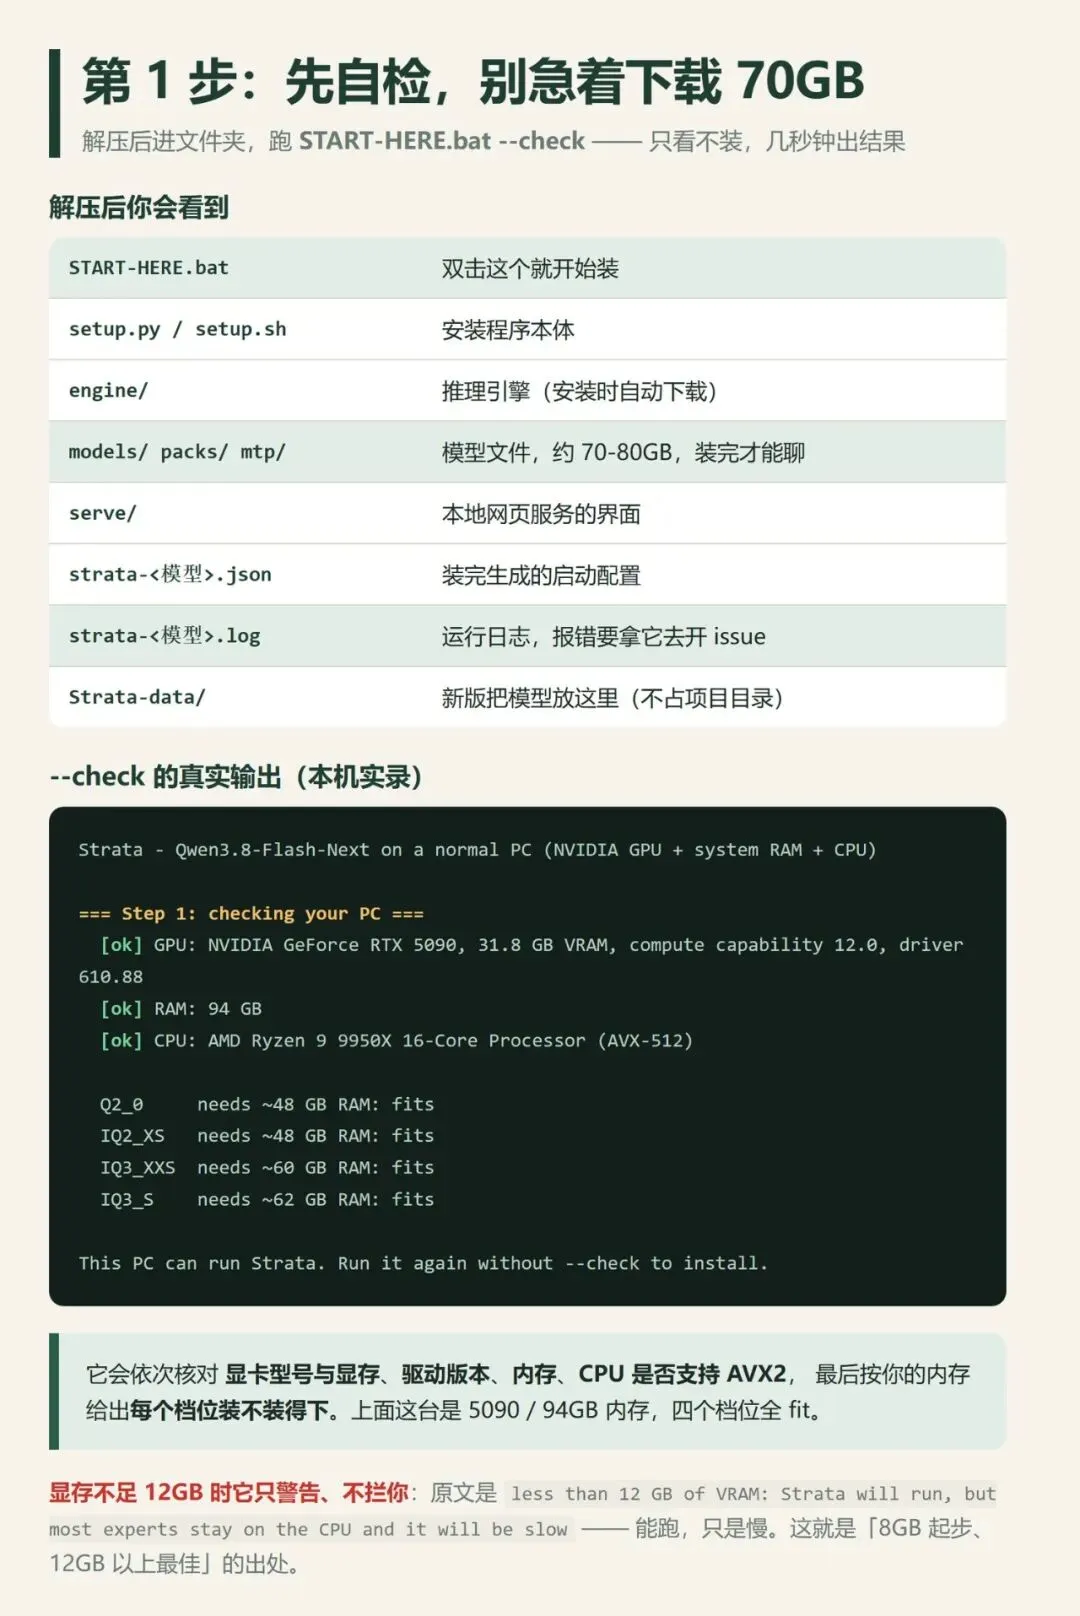
--check 的真实输出
看到什么算成功,三行都对上就算过。显卡那一行认出你的型号和显存,驱动那一行版本不低于 580,内存那一行数字和你实际装的一致。最后档位清单里,你要装的那个显示装得下。
驱动版本不够、CPU 太老、内存不够,都会在这一步告诉你,省掉白等 70GB 的时间。
5.3 第 1 步,下载解压
打开 github.com/Niko1221/Strata。页面上绿色那个 Code 按钮点开,选 HTTPS,把地址复制下来,在你准备放它的盘里执行 git clone <刚才复制的地址>。
别点 Download ZIP。 两种装法现在都能跑,但 ZIP 包没法自己升级,以后想更新只能重新下一次;clone 下来的跑一条命令就完事。
下完之后先确认文件夹里能看到 START-HERE.bat,看到了才说明这份是完整的。
国内下载模型时记得带上 --source modelscope,这一步在第 4 章说过。
5.4 第 2 步,双击 START-HERE.bat,回答 5 个问题
问题是依次弹出来的,每一步都带推荐值。下面是我本机跑出来的真实提问流程。
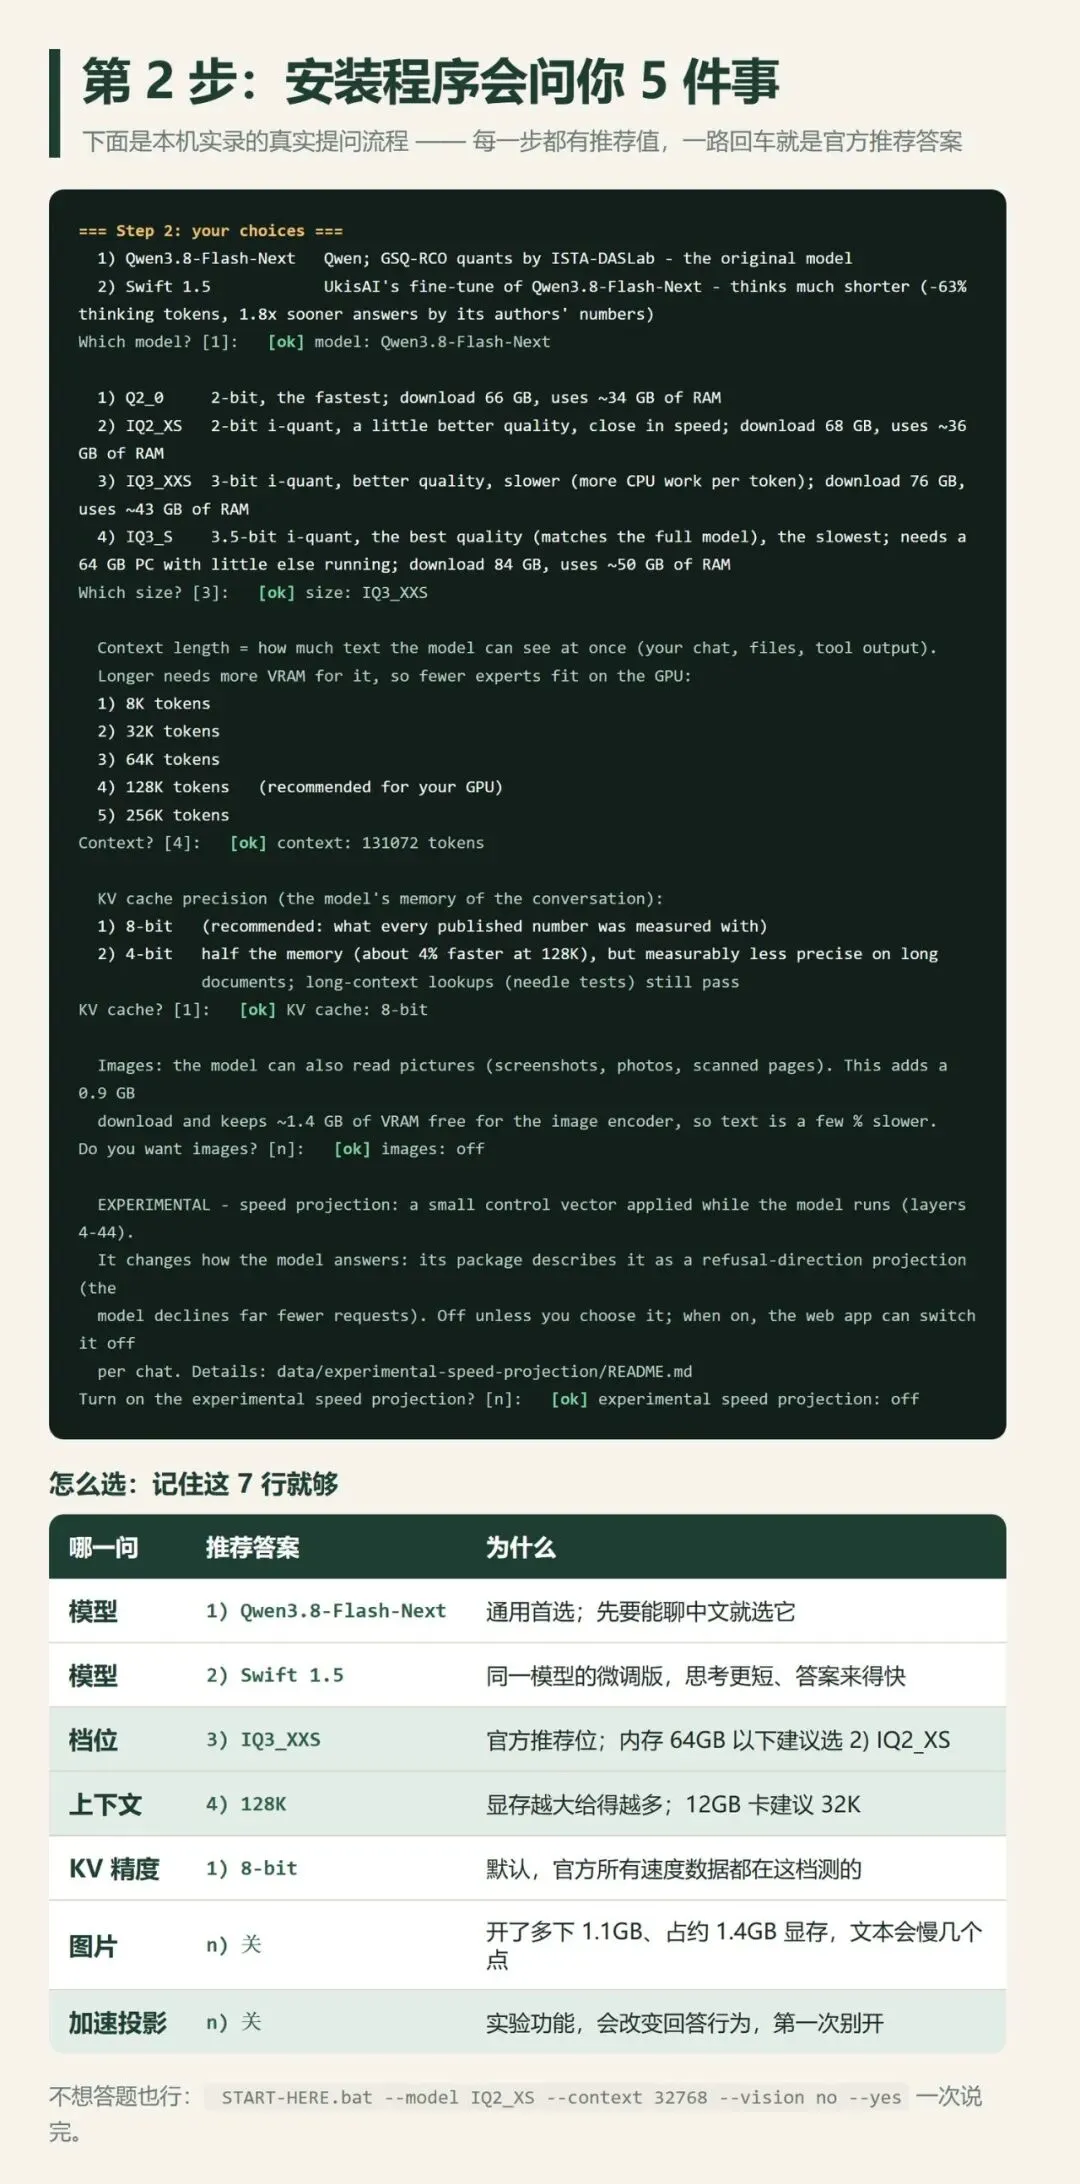
安装程序真实的五个问题
① 用哪个模型。 第一次选 1) Qwen3.8-Flash-Next,原版,通用首选。想要回答来得更快选 2) Swift 1.5,同一个模型的微调版,思考过程短很多。新版菜单里还会多出 Coder 和 Unsloth 的 4-bit 版。
② 装哪个档位。 这一问最要紧,答案在第 4 章那张内存表里。默认建议 IQ2_XS。
③ 上下文多长。 这个直接影响显存占用。上下文越长,KV 缓存越吃显存,能装进显卡的专家就越少。12GB 的卡建议 32K,大显存可以给到 128K 甚至 256K。
④ 要不要读图。 开了要多下 1.1GB,还要给图像编码器留约 1.4GB 显存,文本会慢几个点。不需要它读截图、读扫描件就别开。
⑤ 实验性的加速投影。 保持关闭。官方说明它会改变模型的内部表示和回答行为,包括显著减少拒答,这一点要当成有损优化来看。
不想答题也行,一次说完。
START-HERE.bat --model IQ2_XS --context 32768 --vision no --yes5.5 第 3 步,等它下载完,然后它自己起来
下载完它会把模型启动起来,浏览器自动打开 http://127.0.0.1:8080。
两个心理准备。第一,首次启动电脑会卡住 1 到 3 分钟,第一次更久,因为它在往内存里加载 35 到 55GB 并锁一部分给显卡。这是正常的,别关窗口,窗口上会显示它在干什么,超过 10 分钟没动静才需要处理。第二,模型文件大约 70GB,中途断了重新双击同一个文件会接着上次的进度继续。
看到什么算成功,浏览器里出现聊天窗口,随便问一句能出字,就算装完了。
5.6 怎么确认它真的在跑
回到第 1 章那张监控面板。显存占用上去了、专家缓存命中率有数、磁盘读取在读模型的那一刻有波动,三条对上就是真的在跑。
06装完第一件事,把设置调对
装好只是能跑,设置调对了才顺手。
6.1 先认识几个文件
后面所有设置都落在这些文件上,它们都在 Strata 文件夹里。
| 文件 | 干什么 |
|---|---|
strata-<模型>.json | |
run-<模型>.bat | |
strata-<模型>.log | |
strata-<模型>.shared-settings.json |
模型文件不放在一起,它们在 Strata 文件夹旁边的 Strata-data 里,占 70 到 120GB。这个数据目录的位置记在 %APPDATA%\Strata\settings.json。
6.2 最要紧的一个旋钮是上下文长度
默认值偏保守,改大到 64K 或 128K 之后,长文档、长代码文件才塞得进去。
代价是 KV 缓存吃更多显存。显存本来就紧的话,装了专家就装不下上下文,两头只能要一头。12GB 的卡建议先停在 32K,24GB 以上再往上加。
改法是重跑一次 SETUP.bat,给这个模型换一个上下文值。
重跑安装程序改设置时有一个坑。 它会重写自己管的那些键,包括 exe、args、port、gpu、host、api_key、vision;你自己加进去的键会保留,比如 sampling。但你手写进 args 里的引擎参数不会被带走,得重新加一遍。旧配置会留一份 .bak 兜底。
6.3 剩下几条按需开
想让它再快一点,跑 START-HERE.bat --calibrate。它会在你这台机器上实测几组引擎参数、留下更快的那套,大约 5 到 10 分钟,目前只有 N 卡支持。官方在 RTX 5070 上试出来的收益是 Coder 快 7%。
想让游戏和它共存,加 --vram-reserve-mib 2048,给别的程序留出 2GB 显存,默认只留 700 MiB。手动改的话,把 "--vram-reserve-mib", "2048" 加进配置的 args 列表,然后重启。
装了多个模型,双击 START-HERE.bat 它会问你要启动哪一个,也可以直接双击 run-<模型>.bat。
内存紧张就打开低内存模式,--setup --low-ram on。
想给手机或局域网另一台电脑用,跑 --setup --host 0.0.0.0 --api-key <密钥>,务必设密钥,不然同网段谁都能白用你的卡。
6.4 聊天记录存在哪
存在浏览器里,不在服务器,也不在 Strata 文件夹。换个浏览器或用无痕窗口打开就是一片空白,清掉站点数据也一样。别指望它像云端服务那样跨设备同步历史。
07接进你平时的工具,做出第一个作品
装完之后最有用的地方在这里。它提供 OpenAI 兼容和 Anthropic 兼容两套接口,你可以把它当成免费的本地上游,填进你已经在用的工具里。
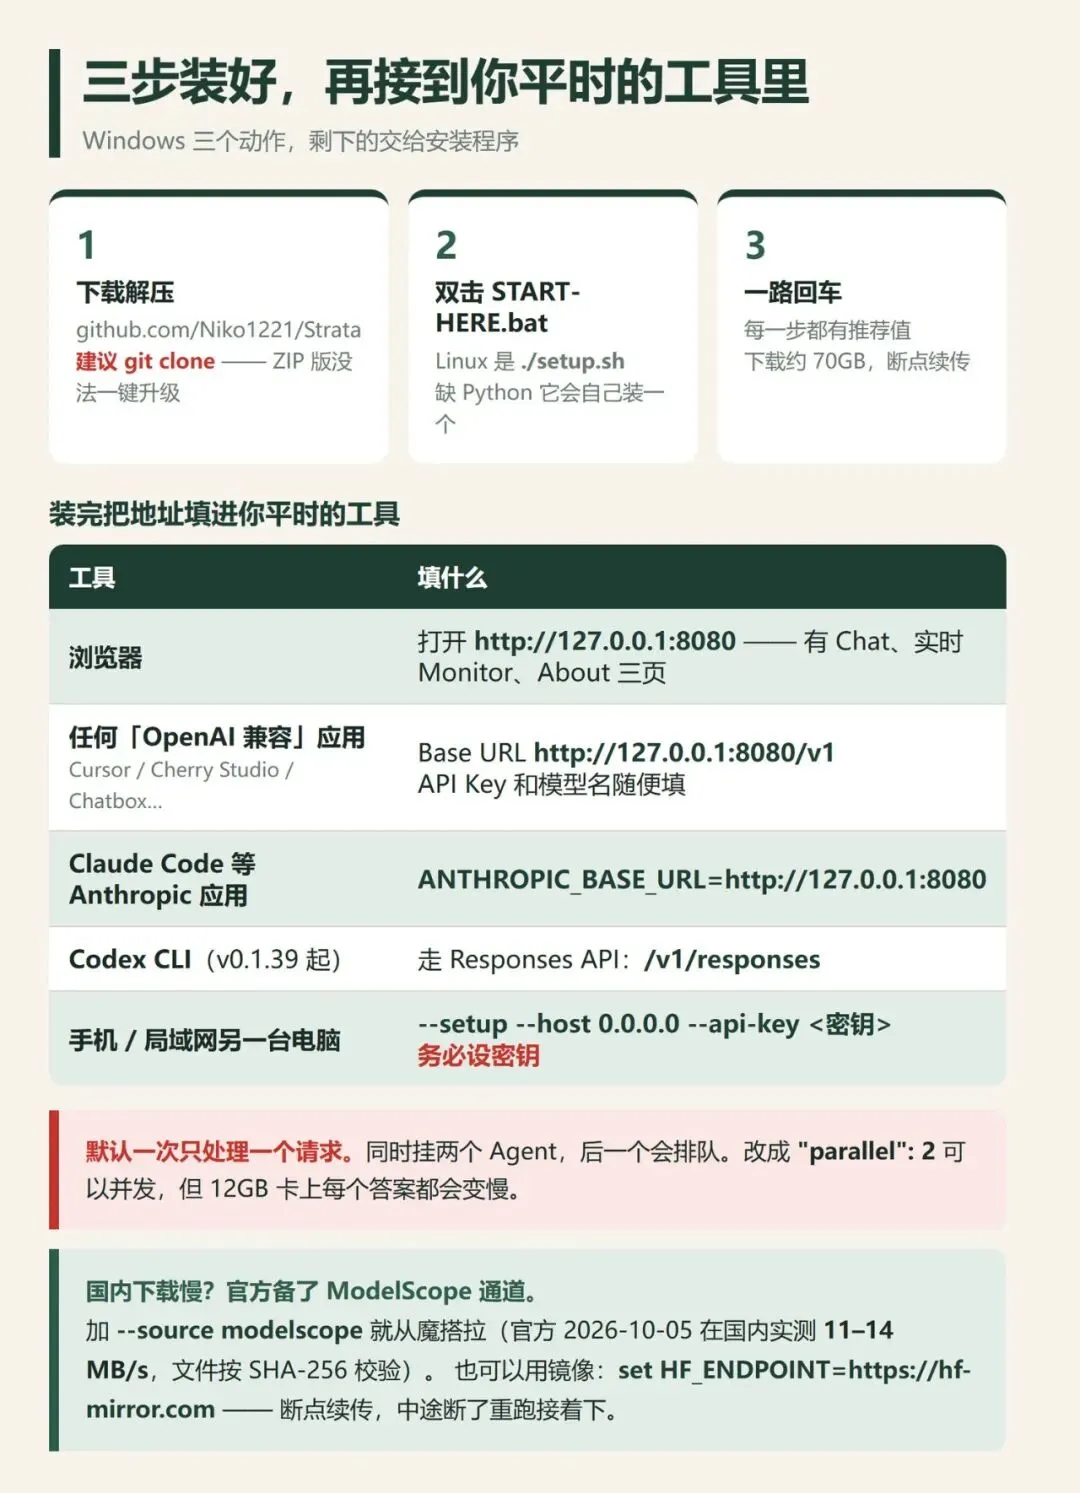
三步装完,再接到你平时的工具里
| 工具 | 填什么 |
|---|---|
http://127.0.0.1:8080,自带聊天窗口 | |
http://127.0.0.1:8080/v1,API Key 和模型名随便填 | |
ANTHROPIC_BASE_URL=http://127.0.0.1:8080 | |
/v1/responses | |
--setup --host 0.0.0.0 --api-key <密钥> |
模型名建议先查一下再填,比照抄旧教程里的名字稳妥。
(Invoke-RestMethod http://127.0.0.1:8080/v1/models).data | Select-Object id现在做你的第一个作品。 打开浏览器那个聊天页,让它给你写一个小工具,比如一个把文件夹里所有图片批量压到指定宽度的小脚本。把需求说清楚,让它一次给出代码,跑一遍,报错就把报错贴回去。
这件事的价值不在于那个脚本,在于你亲手验证了这条路是通的。之后你才敢把它填进 Cursor,让它去改你真实的项目。
08性能到底什么水平
先给个参照。1 token 大约是 0.75 个词。60 token/s,比多数人读字的速度还快。
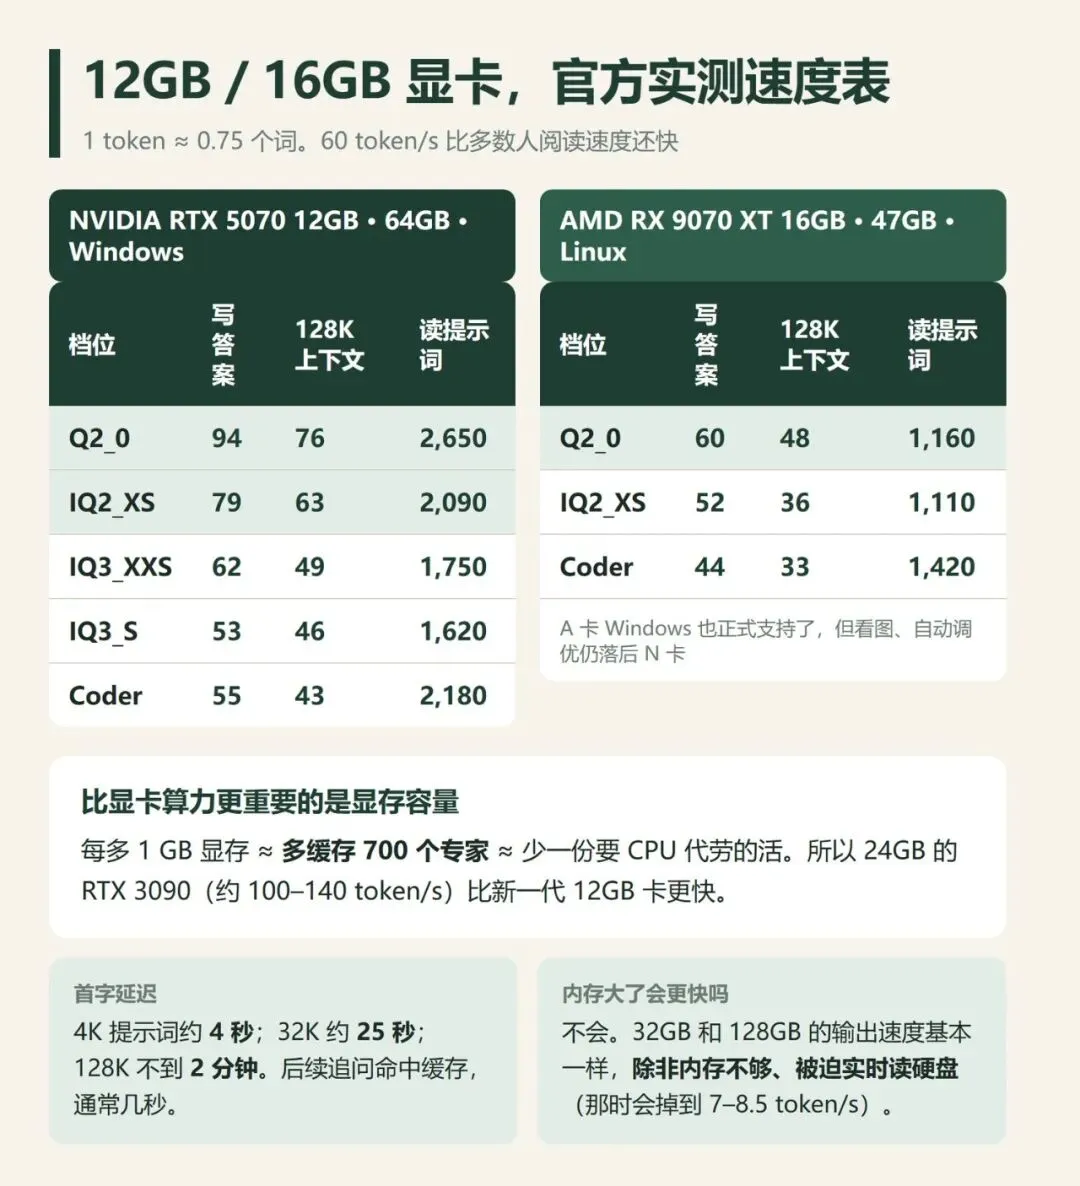
官方公布的速度对照
官方在 RTX 5070 12GB 加 Ryzen 5 7600 加 64GB 内存上实测,短对话写答案的速度是这样的。Q2_0 约 94 token/s,IQ2_XS 约 79,IQ3_XXS 约 62,IQ3_S 约 53。A 卡这边,RX 9070 XT 16GB 跑 Q2_0 约 60 token/s。
Windows 上的 A 卡从 v0.1.34 起也正式支持了,不再挂实验性的牌子。但生态上还有两处落后,Windows 下的 A 卡暂不支持图片输入,自动调优 --calibrate 目前也只在 N 卡上可用。
官方数字是官方数字,我在自己机器上又验了一遍。 RTX 5090、96GB 内存,跑的是 Swift 1.5 的 IQ3_XXS 档位,128K 上下文,一次运行留下 235 次推理记录。
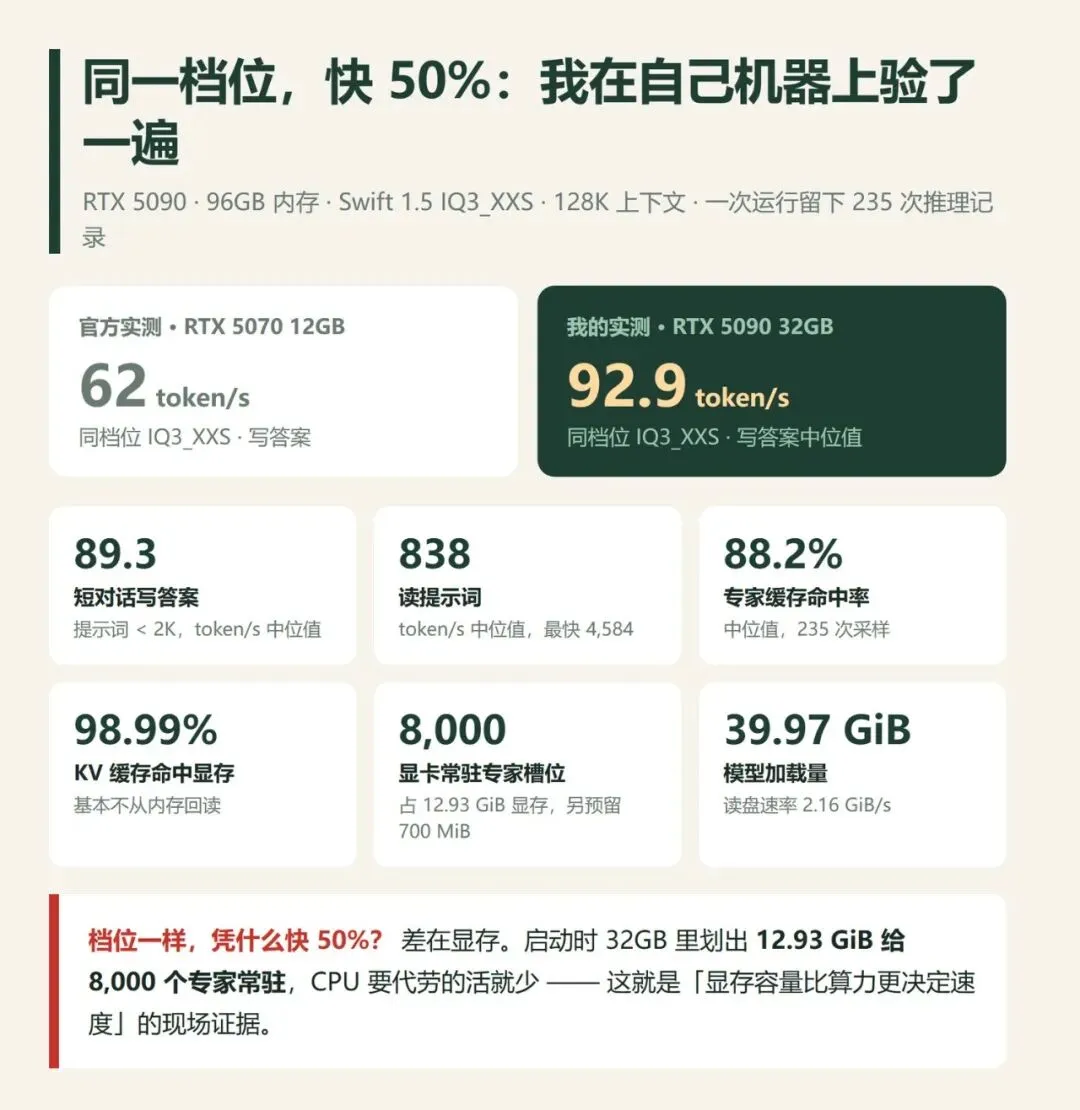
我在自己机器上的实测数据
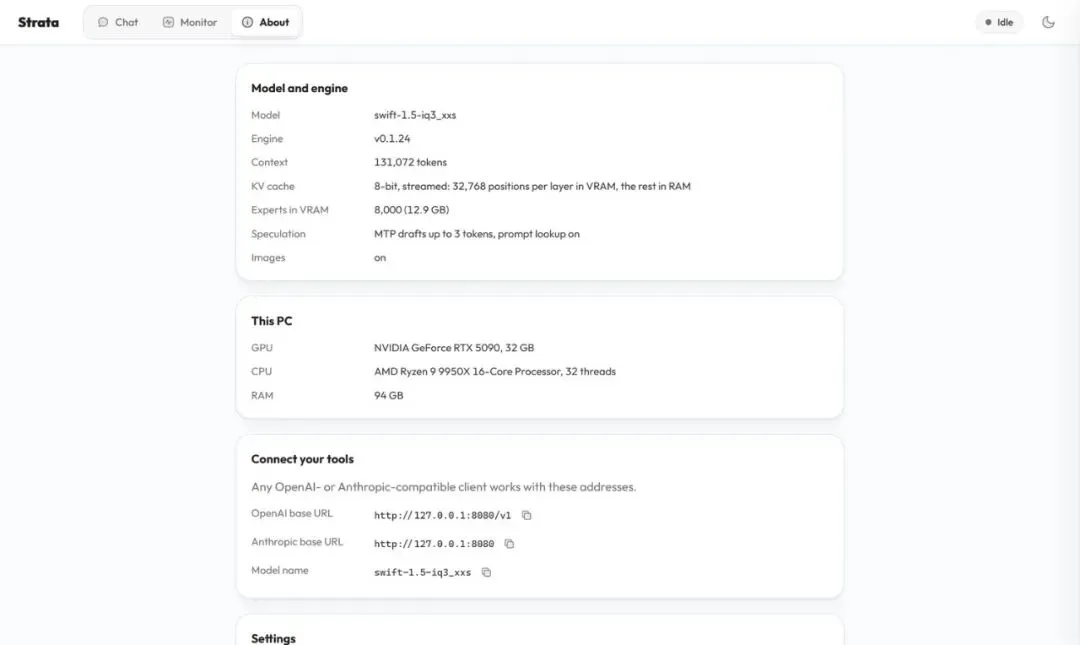
About 页把整机配置列清楚了
两个数字单独说。
第一,显存真的比算力重要。 启动时程序划出 12.93 GiB、8,000 个专家槽位给显卡常驻。对照官方那张表,同样是 IQ3_XXS 档位,12GB 的 RTX 5070 是 62 token/s,这边是 92.9;缩到 2K 以内的短对话,中位值是 89.3。档位完全一样,快 50%,差的就是那块能装下更多专家的显存。
第二,读材料和写答案是两件事。 读提示词中位能到 838 token/s,快的时候四五千。但长材料第一次发过去还是要等,日志里一次 51,047 token 的提示词读了 12.8 秒才进入生成。而后续追问只要命中了前缀缓存,读取立刻掉到几十毫秒,同一次会话里 51,257 token 的提示词只读了 534 毫秒。长文档刚丢进去时先别急着判断是不是卡了,看一眼监控页有没有在显示正在读取。
09常见问题与命令速查
常见问题
| 现象 | 原因和处理 |
|---|---|
--source modelscope,或设 HF_ENDPOINT=https://hf-mirror.com | |
--draft-vocab on | |
命令速查
| 想干什么 | 命令 |
|---|---|
START-HERE.bat --check | |
START-HERE.bat | |
START-HERE.bat --model IQ2_XS --context 32768 --vision no --yes | |
SETUP.bat | |
START-HERE.bat --calibrate | |
UPDATE.bat | |
--source modelscope | |
--setup --host 0.0.0.0 --api-key <密钥> |
结语写在最后
别看完整篇才动手。第 3 章对完表确认能装,就从第 4 章一路做到第 7 章的浏览器聊天页。 那一步走通,你就已经有一个不联网也能用的大模型了,剩下的校准和调优都可以慢慢来。
先上路,再谈车技。
数据来源
Strata 官方仓库 README、docs/INSTALL.md、docs/MODELS.md、docs/OLDER_GPUS.md、docs/MULTI_GPU.md 与 GitHub releases API(2026-10-08 抓取);本机实录来自作者自己那台 RTX 5090 的运行日志与安装输出;社区案例描述来自公开实测记录。标注官方实测的速度数据来自项目公开文档,不同提示词长度下会有浮动。