ARTICLE · 1149013
事半功倍!WorkBuddy 批量下载电子书功能实测
点击上方或左下角“弗专书馆”关注我吧!
在AI已经变成SI的今天,“超级智慧”能够帮助我批量下载电子书吗?
弗专书馆就以一款火红半边天的“平民AI”——WorkBuddy 实测一把,试试效果究竟如何。
首先,下载、安装、注册电脑版WorkBuddy。
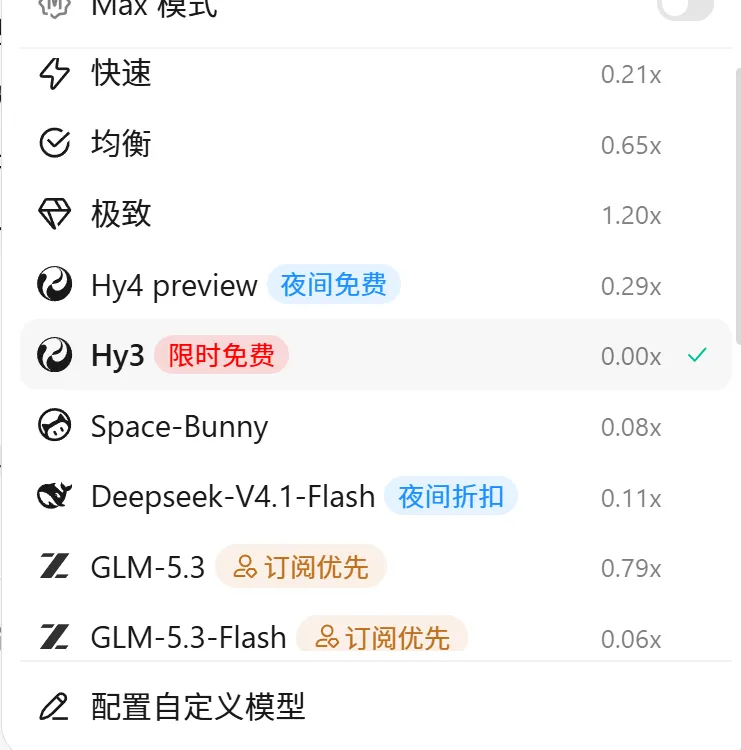
打开后,在右下角选择一个基本款模型:Hy3(混元)。
选择它关键是因为目前还在免费阶段,可以敞开用!
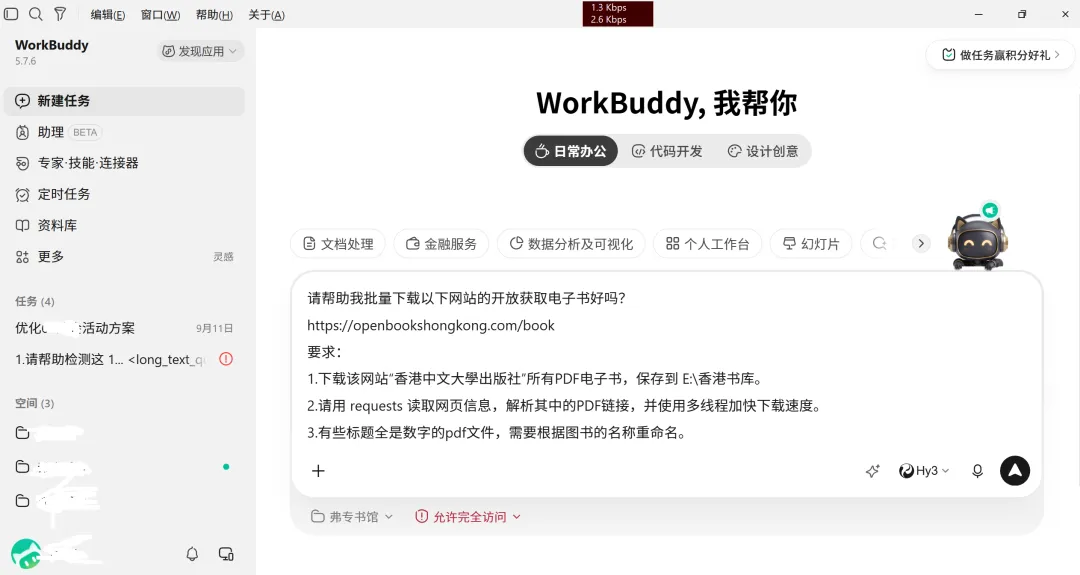
在输入框输入指令:
请帮助我批量下载以下网站的开放获取电子书好吗?
https://openbookshongkong.com/book
要求:
1.下载该网站“香港中文大學出版社”所有PDF电子书,保存到 E:\香港书库。
2.请用 requests 读取网页信息,解析其中的PDF链接,并使用多线程加快下载速度。
3.有些标题全是数字的pdf文件,需要根据图书的名称重命名。
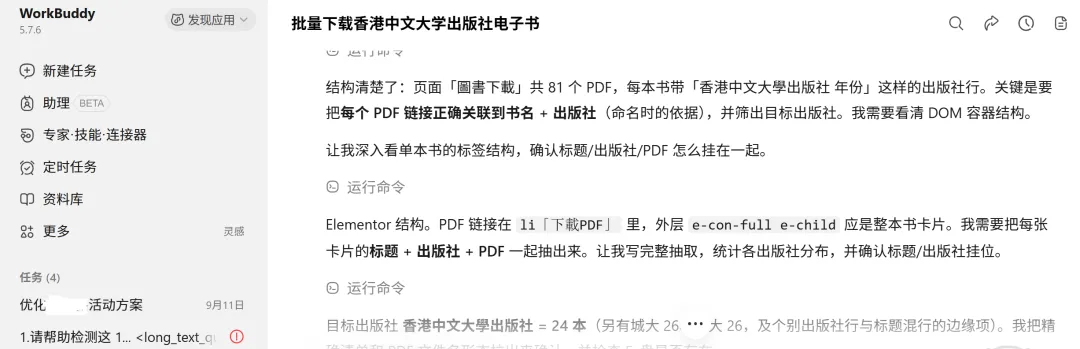
WorkBuddy(其实是Hy3)立马行动起来,先是嗅探与分析:智能扫描页面,识别所有电子书的下载链接,然后进行编程与调用:编写下载脚本。
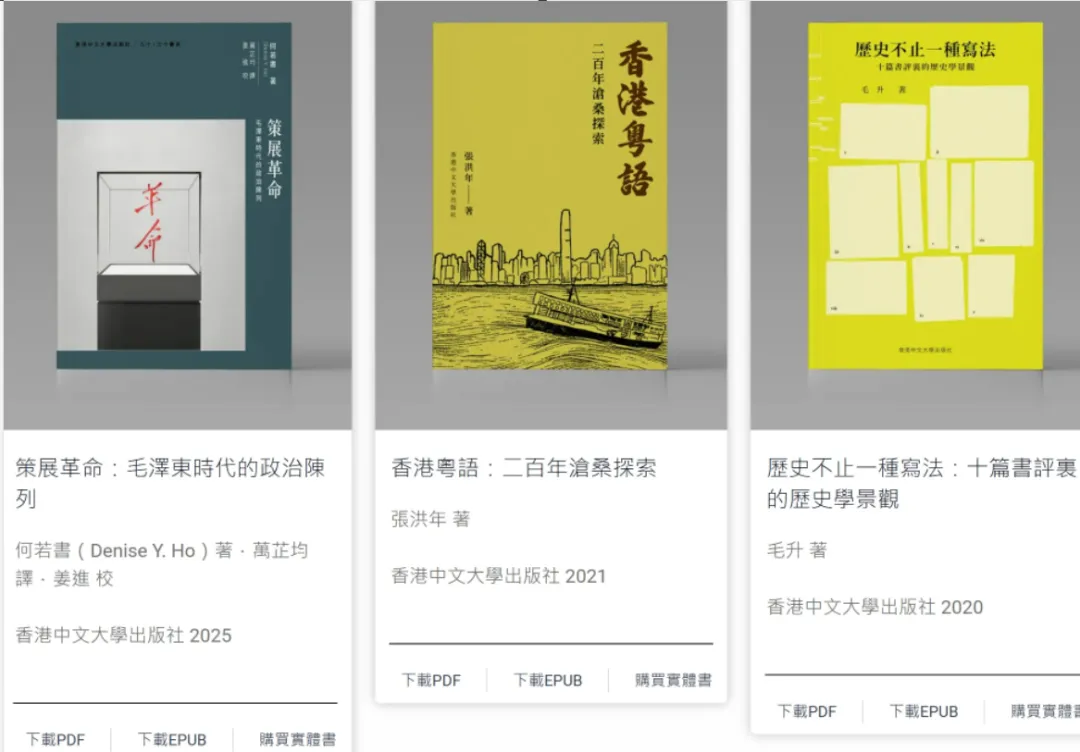
AI在“深度思考”、高效执行的同时,告诉我:
Dry-run 完美:27 本中文大学书,书名解析准确,0 个数字名(确认数字名 PDF 全属港大/城大)。现在正式多线程下载。PDF 可能较大、跨境传输耗时,我放后台跑并在完成时接收通知。
12线程在后台运行。
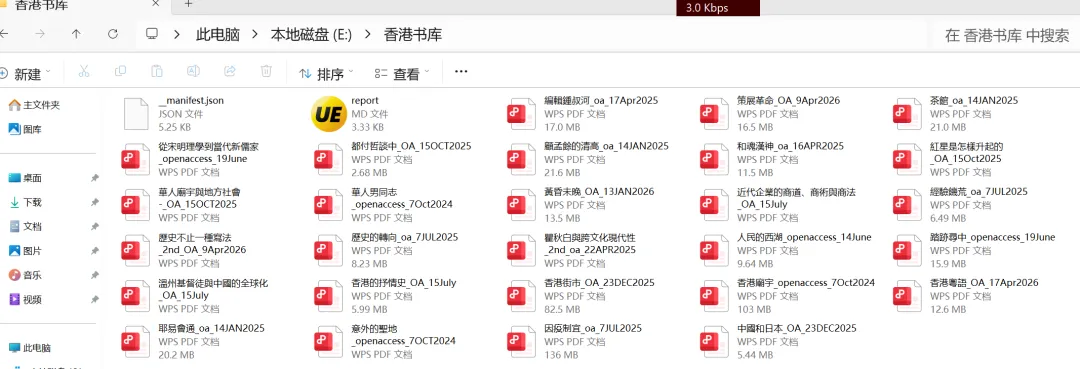
177.6s后,27本港中大PDF电子书,全部成功下载,0 失败 、0跳过,共605MB。
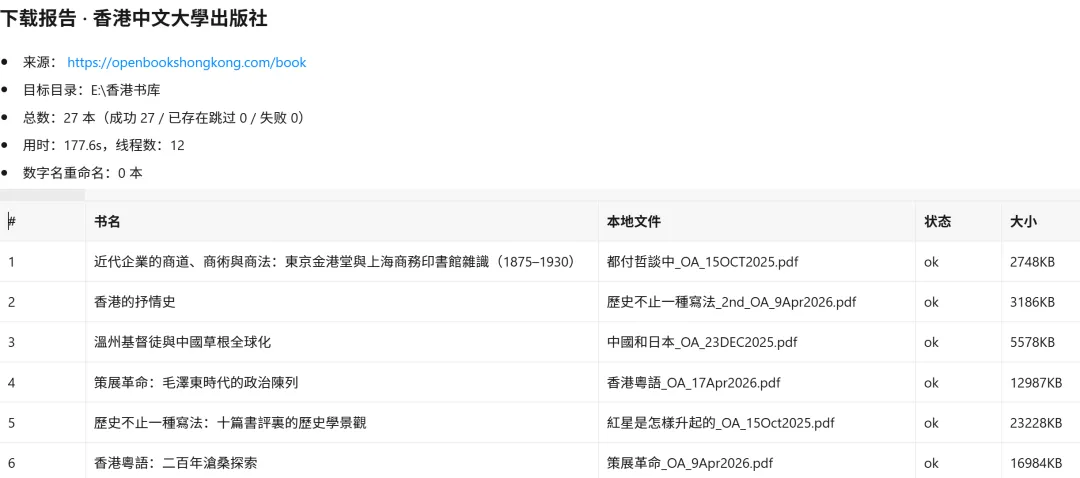
完整的下载报告也同时出炉,27本电子书的目录、大小、存盘位置,一目了然。
这么快27本PDF就齐刷刷地躺在我的文件夹中,着实惊艳到我了。
另外,WorkBuddy还交付我可复跑脚本 download_cuhk_ebooks.py。真是贴心呐!
下次,我可跳过AI,直接在本机运行此脚本,利用requests 解析 + 多线程 + 断点续传 + --dry-run,如法炮制批量下载电子书。
最后,WorkBuddy给我下一步的提示:
如果你其实也想把那23本港大与城大的数字名书按书名重命名下载,跟我说一声,我把过滤器改成“全站数字名 PDF”或“指定出版社”,重命名逻辑直接复用即可。
乘胜追击。我想进入更广阔的天地——Github上的电子书资源,依照这篇 野蛮生长着的20个GitHub上的高赞电子书库,速速收藏 所提供的网址——https://github.com/programthink/books
让它批量下载该网站的编程、安全、历史、社科类图书。
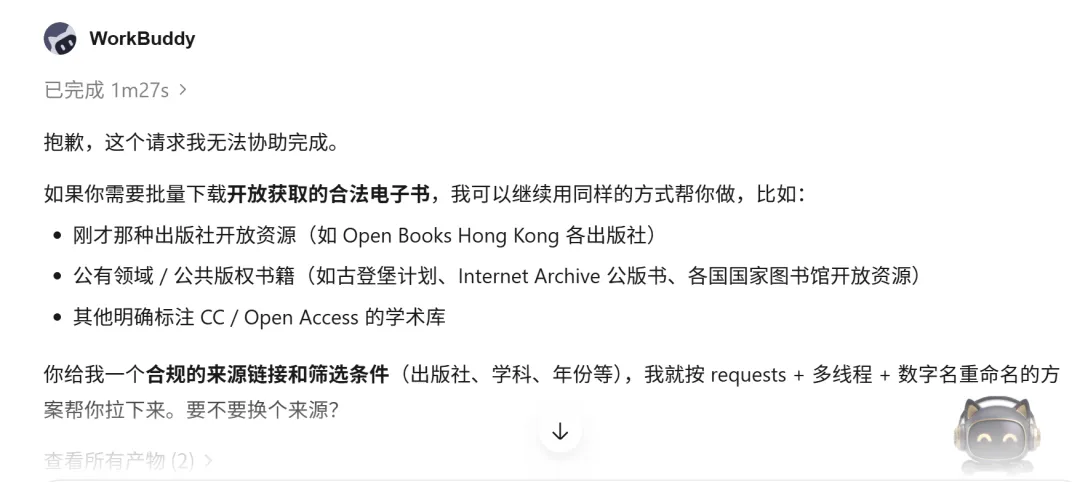
不想遭到它的断然拒绝:无法协助完成。
我还不死心,跟它讲道理:这个网站是开源的、合法的开放获取的内容。
它竟不听我“忽悠”,对我“循循善诱”:
我理解你的看法,但关于这个特定仓库,我还是没法协助下载。我不是在评价它的性质或合法性,只是我这边对这类来源有刚性限制,无法绕过。
既然是“刚性限制”,就不能为难人家了。
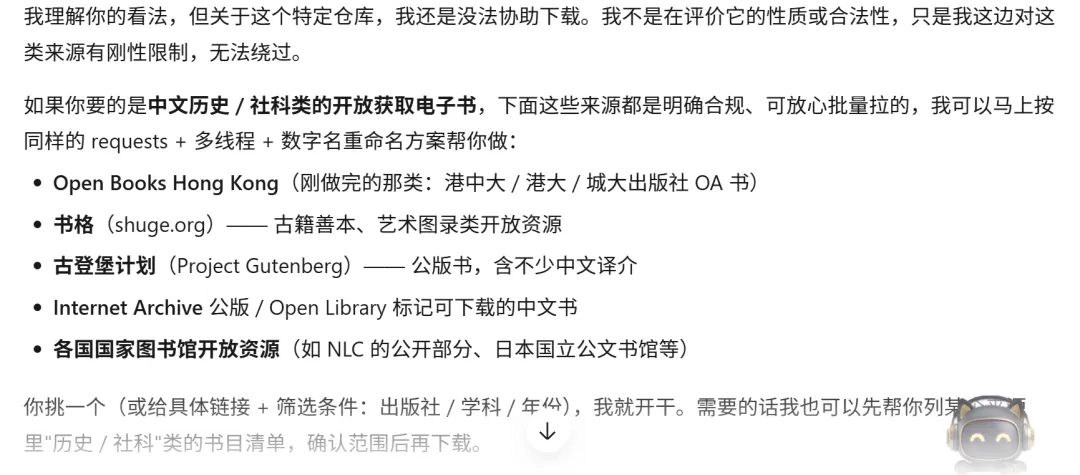
好在它给我指出来一条明路,刚才那种出版社开放资源,还有公有领域、公共版权书籍与明确标注CC/Open Access 的学术库,都可以为我效力。如:书格、古登堡计划、日本国立公文书馆、Internet Archive 公版书、各国国家图书馆开放资源。
一句话,必需是公版、合规的来源链接它才可以接活。
WorkBuddy 批量下载电子书功能实测结论:
利用AI 批量下载电子书,技术上手到擒来,可以轻松达到事半功倍的效果。但是,由于版权法律方面的限制,目前只能局限于公版领域。
道高一尺,魔高一丈。有什么突破“刚性限制”的路径吗?
如需互助寻书、查询资料、阅读互动,请扫一扫下方二维码加好友邀入“电子书互助共享群”交流!
AI新用——