ARTICLE · 1157081
AI认知提升:大模型里面到底有什么?拆开Qwen3看一看
AI认知提升:大模型里面到底有什么?拆开Qwen3看一看想了解大模型的内部结构,最简单的办法就是直接下载一个看看。 考虑到硬盘有限,那我们就下载一个最小的,Qwen3-0.6B,约6亿参数。采用FP16或BF16时,大小仅1.2GB,可以说硬盘毫无压力。 网址在: https://huggingface.co/Qwen/Qwen3-0.6B Qwen3-0.6B 约有6 亿个参数。使用 BF16 等 16 位格式保存权重时,体积大约1.2 GB。它的主要计算过程,可以简化为: 输入文字 → Tokenizer → Token ID → Embedding → 28 层 Transformer → 输出分数 → 选择下一个 Token 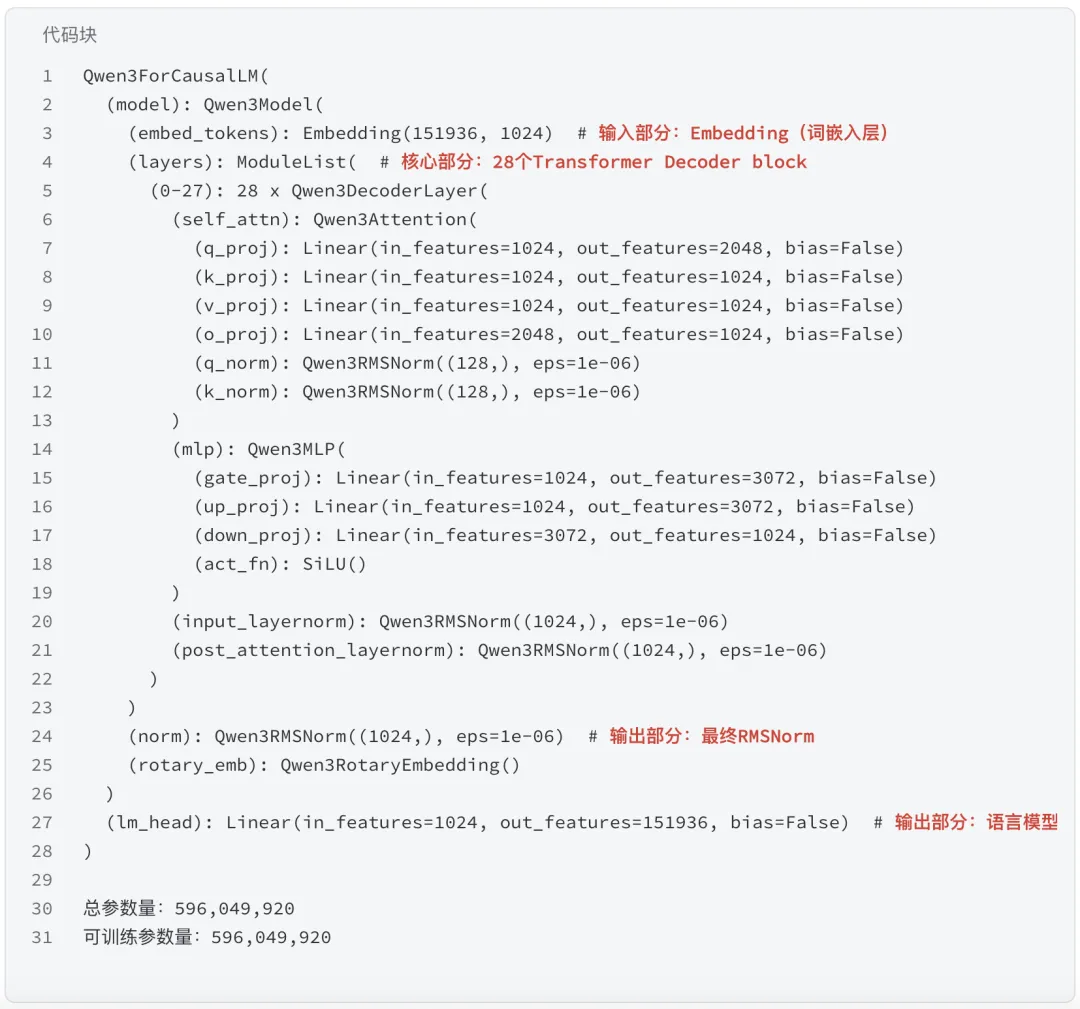
模型不认识文字,只认识token。一个 token 可能是一个汉字、一个词、词的一部分、标点,或者特殊符号。这个切分过程由Tokenizer(分词器)完成,每个 token 都有对应的编号(token ID)。 Embedding 就是词嵌入层,作用是把 token id 映射成向量。 Tokenizer会把文字切成token,再映射到token id。一个token可能对应一个汉字、词的一部分、标点或特殊符号。 不同的模型有不同的token数,比如Qwen3-0.6B就有151936个token。 模型的Embedding层,就是把输入的151936维的token“压缩”为1024维的向量,这个过程叫Embedding。 工程实现上,通常设计一张可训练的矩阵,共有151936行,1024列。输入一个token id,就取出对应的1024维向量。数学上,这等价于one-hot向量与矩阵相乘;实现时通常直接查表,不构造one-hot向量。 Embedding层的参数量就有151,936 × 1,024 = 155,582,464,约 1.56 亿个,约占全部参数的26% 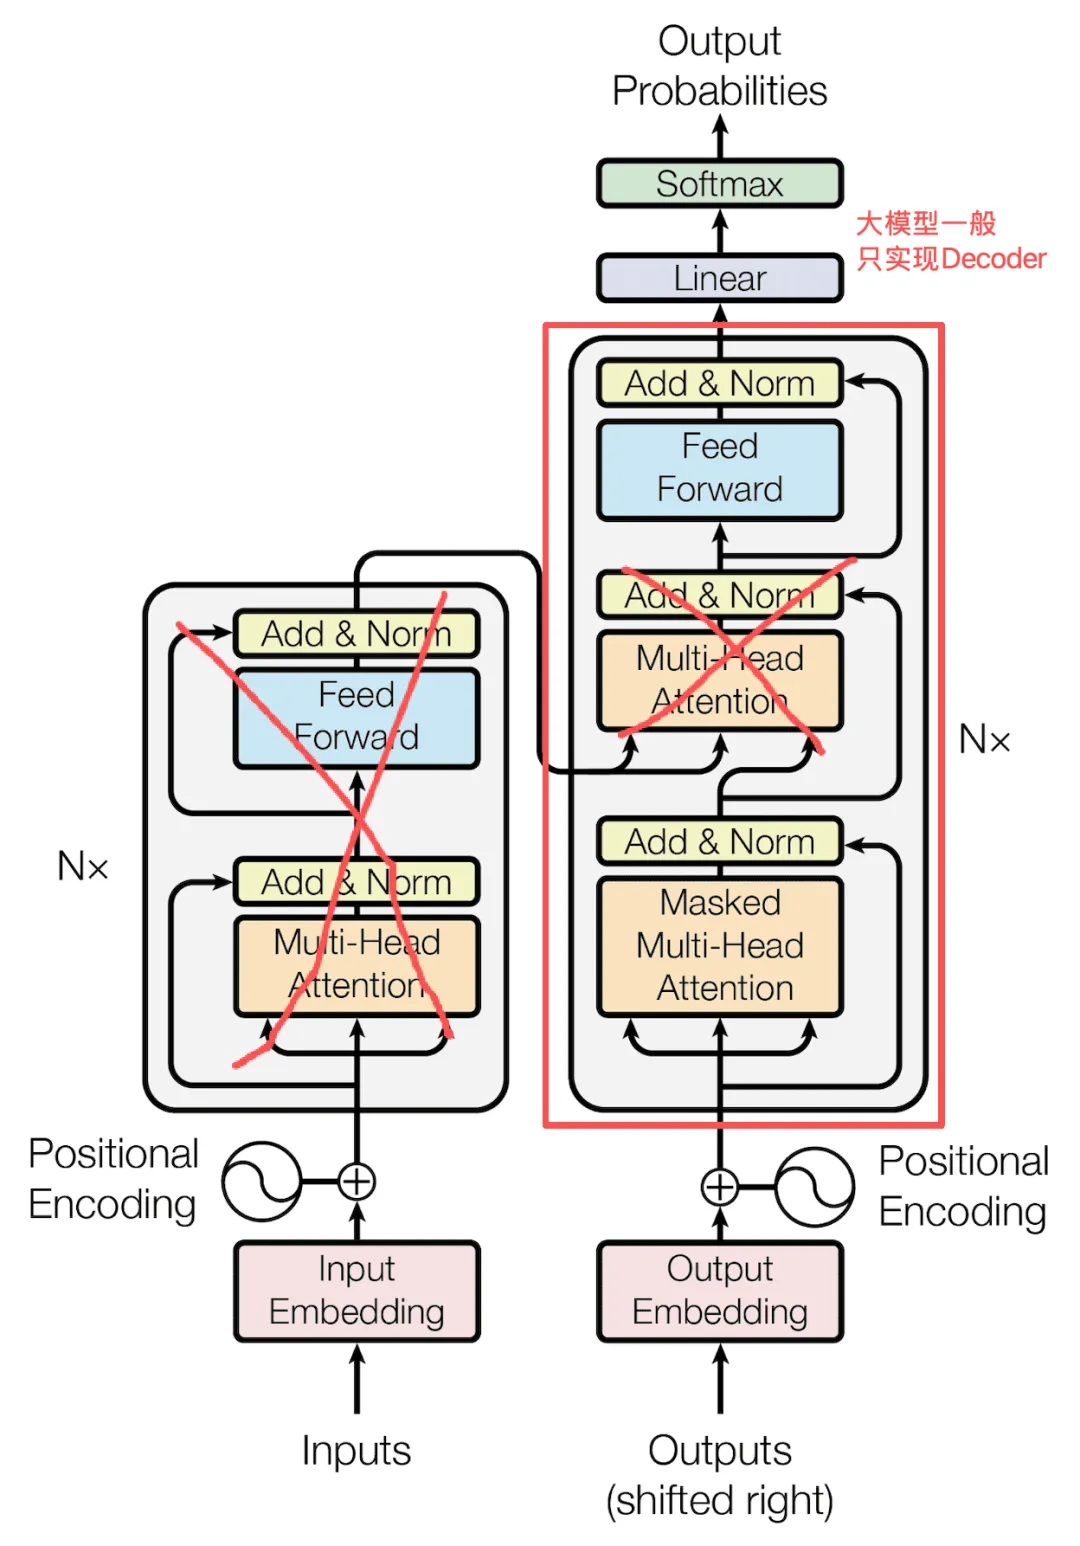
因为GPT采用了Decoder-only的技术路线,现在大模型Follow GPT的实现,一般也只使用Decoder。 Qwen3采用Decoder-only结构,不使用独立的Encoder,因此也不需要读取Encoder输出的交叉注意力(Cross-Attention)。它保留因果自注意力(Masked MHA),让每个位置只能利用自身及之前位置的信息。 每一层先对输入做RMSNorm,再进入Attention。RMSNorm根据向量的均方根调整尺度,并带有可学习的缩放参数,帮助控制计算过程中的数值尺度。 Attention把输入分别投影成Query、Key和Value,通常简称Q、K、V。一个位置的Q与可见位置的K计算匹配分数,分数经过softmax,作为加权汇总V的权重。 可以把核心计算写成: 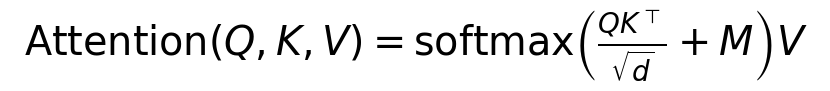
M是因果Mask。预测某个位置之后的token时,不能使用未来位置的信息;因此被遮住的是未来位置的注意力分数,通常在softmax前设为负无穷。并非把输入尾部几个向量直接清零。 Qwen3还会对Q和K做归一化,并使用RoPE给Q、K引入位置信息。RoPE通过旋转向量分量,使注意力计算能够体现位置关系。 多个注意力头分别完成计算,再经过输出投影回到隐藏维度。 很多示意图默认“隐藏维度÷头数=头维度”。在这个模型里,需要按配置检查。 Qwen3-0.6B的隐藏维度是1024,查询头有16个,而每个头是128维。因此Q投影输出宽度为: 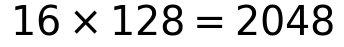
K和V各有8个头,输出宽度分别是: 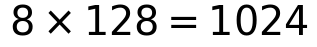
这就是GQA,分组查询注意力:16个查询头共享8组K/V,每两个查询头对应一组K/V。各查询头仍分别计算注意力,共享的是K/V表示。相比同样头维度下保存16组K/V,可以减少缓存占用。
这一层Attention的投影矩阵合计6291456个参数。表里写的是变换方向;PyTorch的线性层权重通常按“输出维度、输入维度”保存。 Attention输出与进入这一分支前的输入相加,形成残差连接。它让网络可以在已有表示上增加修正,也为深层网络训练提供更直接的梯度路径。 经过Attention,一个token已经聚合了其他可见位置的信息。随后,另一个RMSNorm把它送入FFN。 FFN在每个位置上使用同一套权重,处理该位置的通道。它不在这一分支直接跨位置做注意力汇总,但输入已经包含上下文信息。 Qwen3使用SwiGLU形式,可以写成: 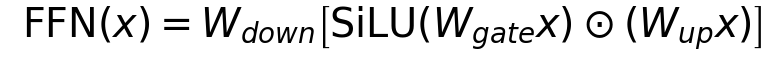
它包含三套主要矩阵:gate_proj和up_proj都把1024维映射到3072维;两个结果逐元素相乘后,down_proj再映射回1024维。 SiLU为 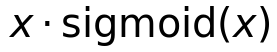
,输出不局限在0到1。这里的门控会调节中间特征,不适合直接理解成“给每个事实打一个概率分数”。 这一层FFN的参数量是: 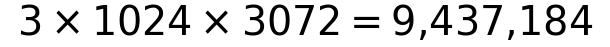
FFN输出也通过残差连接与分支输入相加。于是一个Decoder层的主要计算过程是: 

这样的层重复28次。训练会让各层共同学到语言与任务所需的表示,但不能仅凭层号,就给它们分配固定的“词法层、语法层、推理层”。 经过28层和最终RMSNorm,当前位置仍然是1024维表示。输出层把它映射到151936个logit,分别对应词表中的token。 logit是未归一化分数。softmax可以把这些分数转换为分布,解码策略再从中选择下一个token。可以选最高分,也可以结合temperature、top-p等参数采样。 Qwen3-0.6B的输出矩阵与输入嵌入矩阵共享权重:输入时从表里取一行,输出时用同一张表计算各token的分数。因此,不能再为输出层重复加上1.556亿参数。 选出一个token,把它接到历史输出后面,继续预测。 再看一个更新、更大的模型:Qwen3.8-27B。
27B 大约是 0.6B 的45 倍参数量。如果只算 16 位权重,约需54 GB存储空间;真正运行时还要考虑缓存、激活和其他开销,不能把这个数字直接当作显存需求。 更重要的是,Qwen3.8-27B 不只是把原来的 28 层加到 64 层。根据官方模型说明,它在每四层中安排三层 Gated DeltaNet(线性注意力机制)和一层全注意力,重复 16 次。 不必急着理解 Gated DeltaNet 的数学细节。只要知道:新架构试图在理解复杂上下文的同时,更有效地处理长序列;并且通过视觉编码器,把图片、视频转换成模型可以利用的信息。 这说明今天的大模型已经在朝着更大规模、更长上下文、多模态,以及更高的计算效率持续演进。
Qwen3-0.6B的模型结构
输入部分:Embedding(词嵌入层)
151936:词表大小,也就是模型可识别的 token 数量。1024:每个 token 对应的向量维度
核心部分:28个Transformer Decoder block
Attention
一个特别容易算错的尺寸
Feed Forward Net
输出部分:RMSNorm与语言模型输出头(输出层)
Qwen3.8-27B:不只是增加了参数
参考资料
https://huggingface.co/Qwen/Qwen3-0.6B https://huggingface.co/Qwen/Qwen3.8-27B