ARTICLE · 1182804
OpenAI首款自研芯片亮相!TPU之父秘密操盘9个月,撕开英伟达万亿帝国裂缝
两年前的春天,山姆·奥特曼(Sam Altman)带着刚入职的硬件副总裁理查德·何(Richard Ho),步履匆匆地穿梭在亚洲半导体巨头的会议室里。
面对台积电、三星和SK海力士的高管,奥特曼的话没有半句客套:“再过几年,我们对硅芯片的胃口会大到不可思议。请你们现在就开始,多建晶圆厂”
晶圆厂确实在动工,但速度根本赶不上大模型的进化。
更残酷的现实摆在眼前:全球每产生十条大模型的推理请求,九条都要给黄仁勋“交税”。算力不仅贵得惊人,而且随时可能断供。
奥特曼不再等待他转过头,对理查德·何下达了一道生死令:从零开始,造一颗属于OpenAI自己的芯片。
大约两年后,成果破土而出2026年下半年,OpenAI正式公开其首颗自研推理ASIC芯片,Jalapeño(墨西哥辣椒)。
从最初的架构草图到送厂流片,这支平均不到100人的精锐小分队,仅仅用了整整9个月。
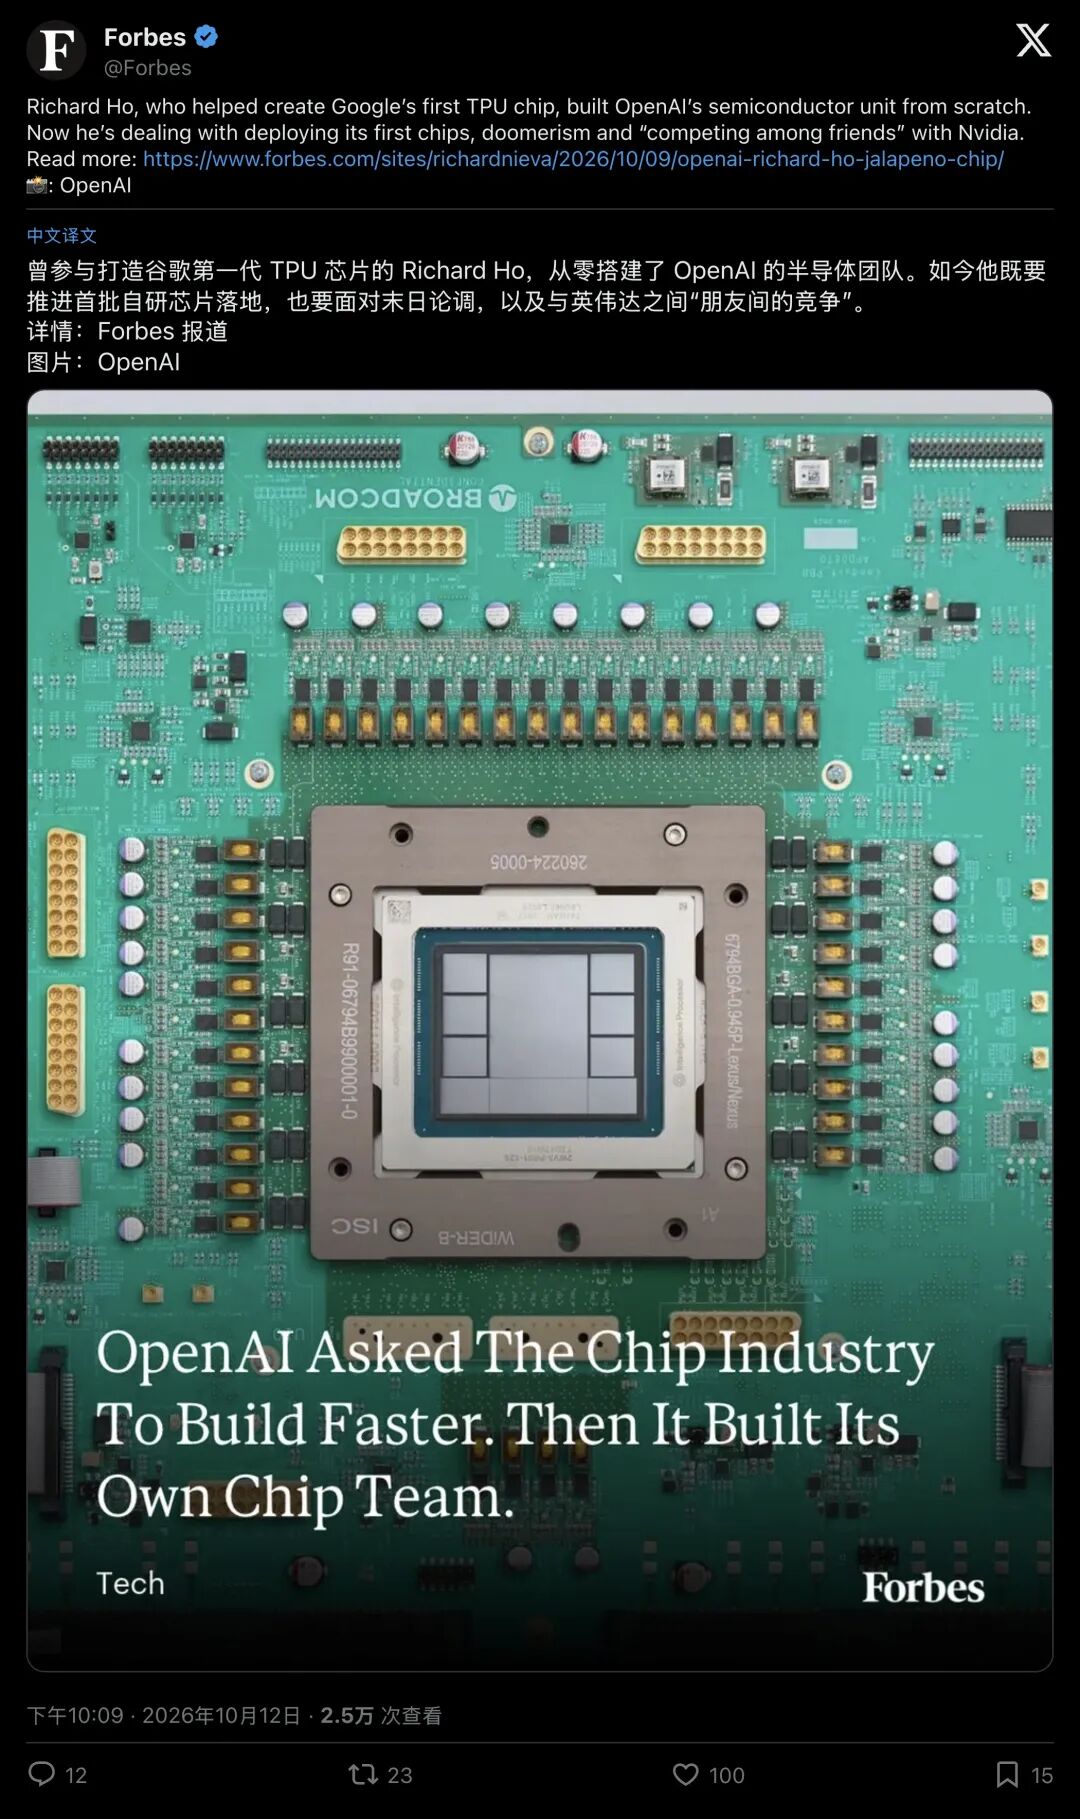
▲ Forbes 披露 OpenAI 首款芯片 Jalapeño 细节,由前谷歌 TPU 核心缔造者操刀
在AI硬件的牌桌上,从来没有外行能轻易赢下赌局。但这一次,整个硅谷都感受到了震动
有投资人在社交媒体上惊呼:“那个亲手造出谷歌第一代TPU的男人,现在替OpenAI把芯片端上桌了,这是整个市场此前完全没有定价的黑天鹅!”
▲ 业内人士指出,打造谷歌首代 TPU 的功勋工程师转战 OpenAI 自研芯片,市场严重低估了这一变量
01组建《十一罗汉》:旧金山食堂里诞生的“辣椒芯片”
理查德·何绝非普通工程师
早年,他在神秘的D. E. Shaw研究所参与打造Anton药物超算,那台机器的定制网络与专用计算架构,被业内公认为现代大算力加速器的精神祖父。
后来,谷歌找上门HR在保密协议上只写了一句极具诱惑力的话:“我们现在不能告诉你做什么,但你绝对不会后悔。”
入职后,何见到了计算机大师杰夫·迪恩(Jeff Dean)。当时,谷歌数据中心快被翻译模型的庞大计算量压垮了。
为了自救,谷歌决定绕开传统显卡,自己动手做张量处理单元,这就是后来统治AI行业多年的TPU。理查德·何在谷歌一干就是七八代TPU,摸透了专用芯片加速的所有底层密码。
当奥特曼抛出橄榄枝时,两人一拍即合。
何形容自己接下来的动作就像好莱坞电影《十一罗汉》:“我给那些分散在谷歌、Meta、亚马逊和老东家的顶尖老战友发信息,要不要聚在一起,再玩一票大的?”
一支不足百人的“造芯刺客团”就此集结。
至于芯片的名字,来自一个非常接地气的团队梗。在OpenAI旧金山米申区的旧办公室食堂里,有一排摆满辣酱的木架子,何的硬件小分队天天端着餐盘围着辣酱讨论架构,索性戏称自己是“热辣椒(Hot Peppers)”。
第一代自研芯片因此顺理成章地被命名为,Jalapeño(墨西哥辣椒)。
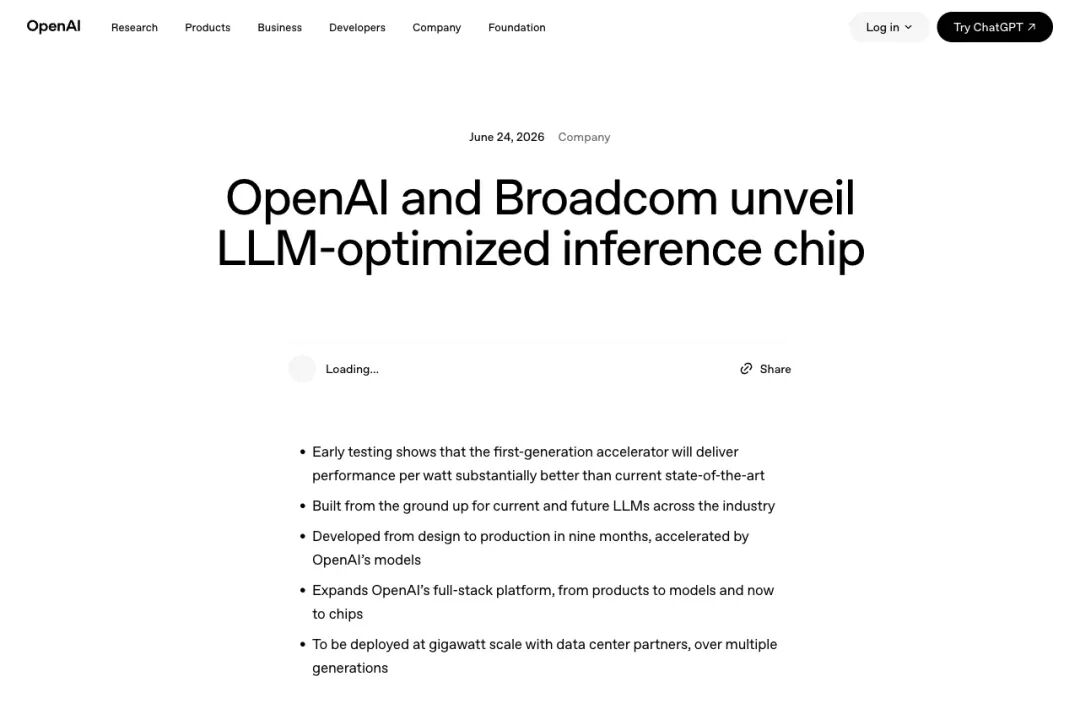
▲ OpenAI 官方公告:为前沿大模型全栈定制的推理加速器 Jalapeño 正式亮相
02刀刃向内:为什么偏偏是“推理芯片”?
很多人第一反应会问:OpenAI要做,难道不应该做挑战英伟达B200/GB300的训练大杀器吗?
大错特错
在AI的物理世界里,“训练”和“推理”完全是两码事:
- 训练(Training)
:好比让天才在象牙塔里苦读十年,吞下万亿网页数据,最终“开窍”。它需要数万张GPU不分昼夜地暴力死磕; - 推理(Inference)
:好比这位天才走入职场,面对全球数亿用户的每一次提问、每一行代码补全、每一个语音交互,进行闪电作答。
训练只是一次性的固定资本开销,而推理,则是每天推门营业都要燃烧的巨额电费账单。
当ChatGPT每天响应几十亿次请求时,算力成本的绝大部分都砸在了推理上。
传统GPU为了兼容图形渲染和各种科学计算,内部塞满了复杂的通用模块,宛如一把功能繁多的瑞士军刀。
但在大模型的推理现场,只需要两件事:
- Prefill(吞下提示词)
:狂啃算力,比拼矩阵乘法的极限速度; - Decode(逐字吐答案)
:极度依赖内存带宽,每一次往外蹦字,都要把庞大的模型权重在内存和核心之间快速搬运一次。
瑞士军刀在这样的特定战斗里太重了。OpenAI需要的是一柄专门用来切削Token的极细手术刀。
Jalapeño从第一天起,就是为大语言模型量身定制的专用集成电路(ASIC)。
它抛弃了一切冗余晶体管,将计算核心、高带宽内存(HBM4)与网络互联彻底打通,在硬件底层把KV缓存等高频状态牢牢锁在本地,最大程度减少芯片内外的数据倒腾。
标称功耗约700瓦,而实际持续运行功耗直接压低到550瓦以内。
用极度紧凑的能耗,榨取每一度电能够产出的“有用智能”。
039个月光速交卷:用AI设计AI芯片的恐怖闭环
在半导体行业,一颗复杂先进制程芯片从画图纸到送去台积电流片(Tape-out),通常要熬上两到三年。
但何的团队从初始代码到交付生产,只用了惊人的9个月。
他们是怎么在物理世界的铁律面前弯道超车并打破常规的?
答案听起来极具科幻色彩:OpenAI让自己的大模型,给自己生芯片。
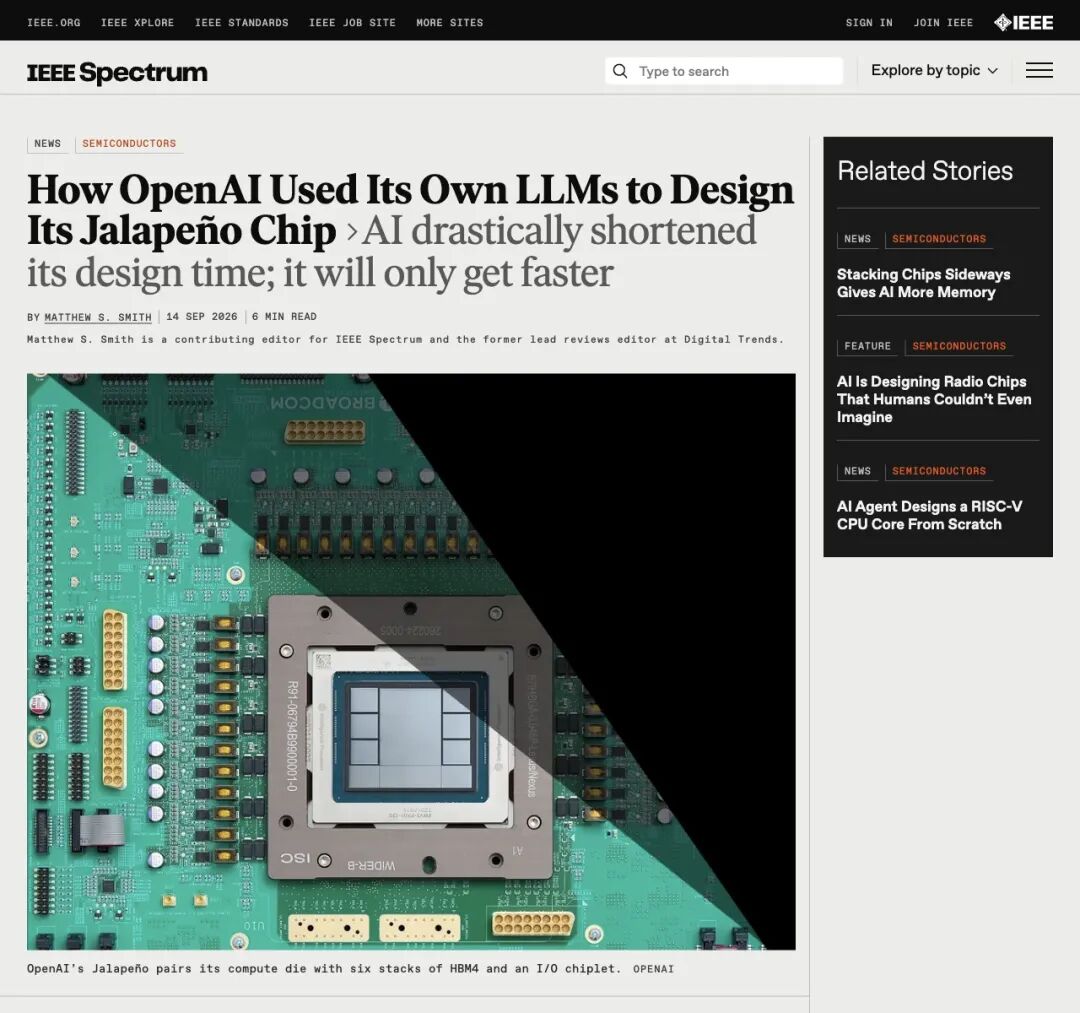
▲ IEEE Spectrum 揭秘:LLM 如何重塑芯片设计流程,使小团队完成巨头数百人的工程量
在芯片设计的极度微观世界里,数亿个逻辑门电路挤在指甲盖大小的硅片上。如何摆放线路、怎样缩短延迟,以往需要资深工程师调参数周。
这一次,团队直接调用自研的大模型GPT-Astra与Codex,充当工程师的“智能外挂”。
在探索电路极限布局时,大模型在数小时内就给出了一套人类未曾想到的结构优化,单芯片面积直接省下了超过13%。
在编写关键算子内核时,面对极其复杂的注意力机制模块,人类专家手工调优需要耗时数月;而内部模型在约40个小时内,就将硬件利用率从不足1%直推到近90%的物理天花板。
针对部分开源模型,AI生成的代码甚至比业界顶级人类专家手工写出的内核还要快上1.5到1.8倍。
但理查德·何保持着老派工程师罕见的清醒:“AI给了工程师超能力,但我依然不完全信任它们。”
他并没有盲目放权给AI跑完全程涉及数亿美元代价的物理签核(Sign-off),团队依然死死钉在成熟EDA工具与人类工程师的双重审查红线之内。
用AI突破极限脑力瓶颈,用人类把控物理确定性。这种“硅基大脑加速硅基肉身”的飞轮,成了OpenAI最可怕的秘密武器。
04亮出跑分底牌:延迟暴降70%,专治高交互卡顿
2026年8月底,OpenAI拿出了Jalapeño的第一份全公开实测报告。
数据来自第三方行业基准平台InferenceX,基于GPT-OSS 120B、DeepSeek R1以及Kimi K2.5等主流顶尖开源模型实测得出:
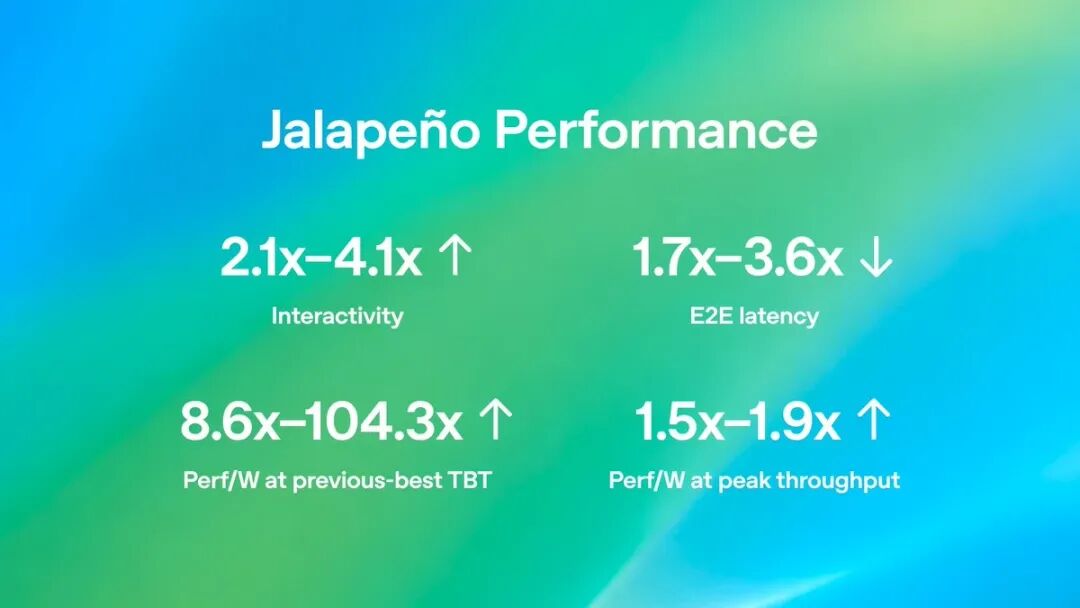
▲ OpenAI 官方公布的 Jalapeño 首批实测数据:交互响应提升最高达4.1倍,端到端延迟降低最高达3.6倍
- 每瓦AI算力产出提升1.5至1.9倍
:在同等数据中心供电限制下,能支撑将近两倍的服务调用; - 端到端延迟降低1.7至3.6倍
:以往敲下回车后的尴尬停顿被大幅抹平; - 高交互任务表现飙升2.1至4.1倍
:面对实时语音、复杂代码多轮调用等要求毫秒级反馈的智能体场景,性能呈现碾压态势。
过去,大家评价芯片往往看单卡峰值算力(PFLOPS)有多吓人。
但OpenAI的账本很现实:数据中心的电网配电是有上限的,谁能在有限的功率里输出最多的有效Token,谁才能在接下来的淘汰赛里活下去。
05致命权衡:为什么抛弃英伟达,反手拥抱AMD与博通?
如果说Jalapeño芯片本身是尖刀,那么支撑这把尖刀落地的整机机柜设计,则体现了极为老辣的商业与工程权衡。
仔细拆解这套机柜架构,处处都能看到极为务实的系统工程逻辑。
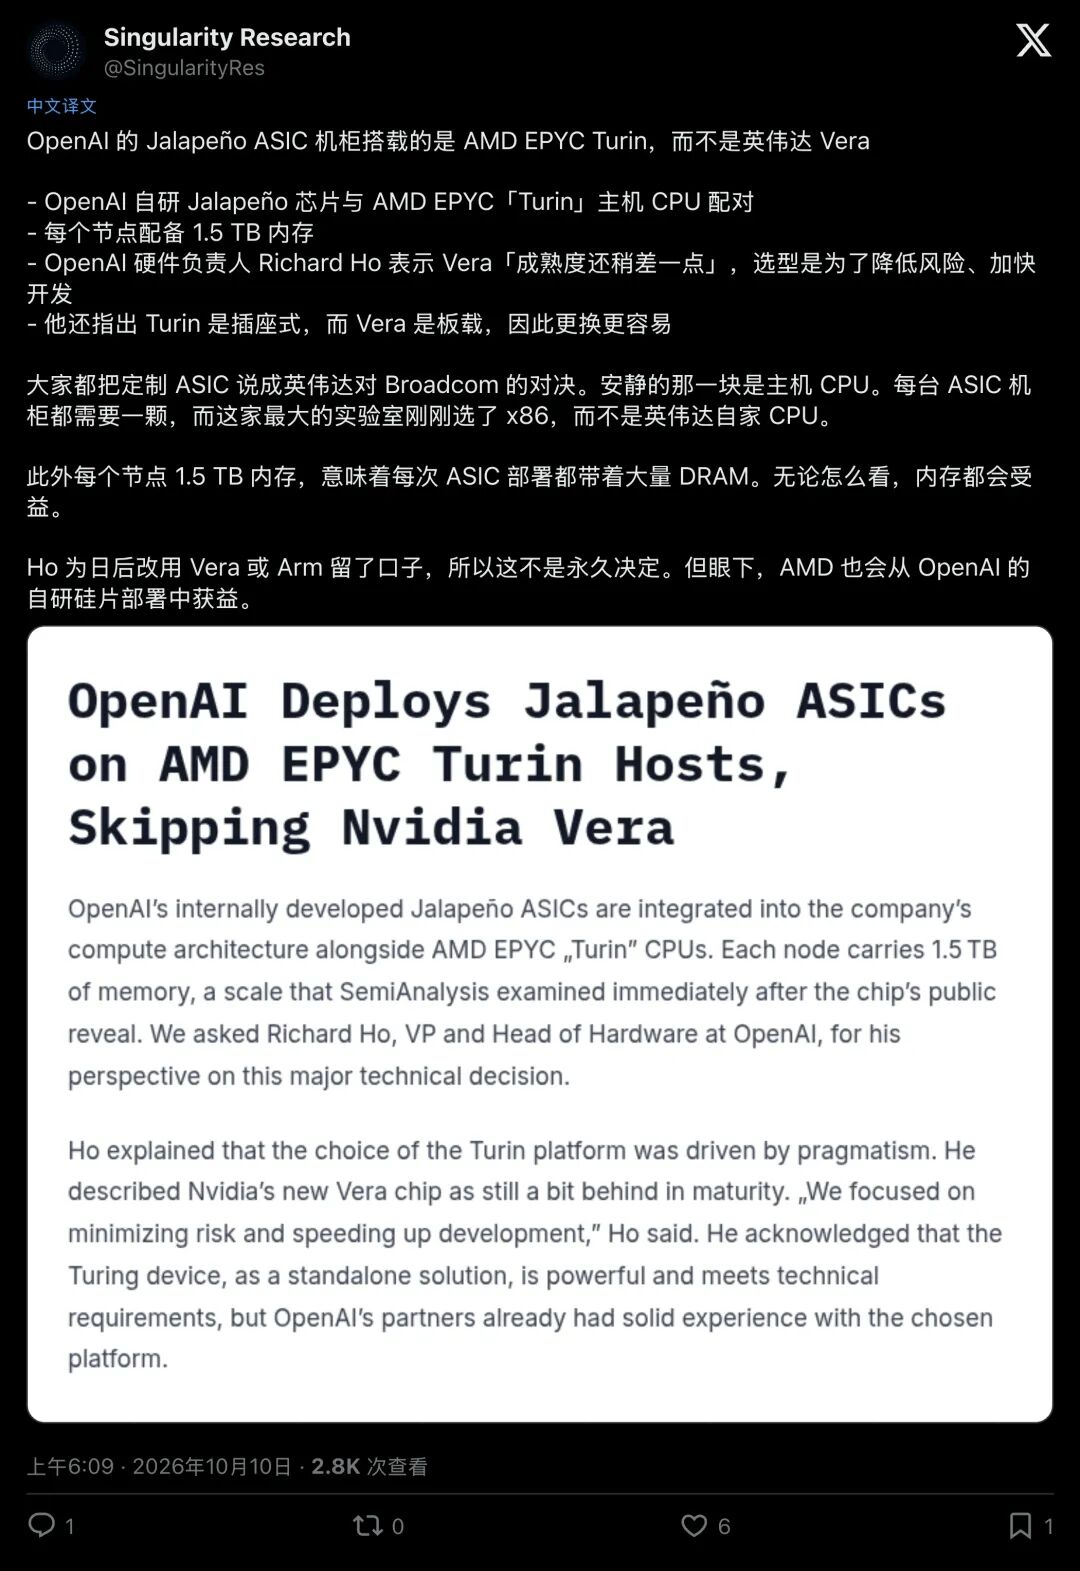
▲ 技术细节披露:OpenAI 自研机柜选用 AMD EPYC Turin 作为主机 CPU
1. 主机CPU为什么选AMD Turin?
在机柜里,除了跑AI的加速器,还需要掌管操作系统的主机处理器(Host CPU)。
英伟达正在极力推行自家的Vera CPU,希望通过私有协议把客户死死绑在自己的生态里。但OpenAI的选择却出人意料:他们直接选用了AMD最新的EPYC“Turin”处理器。
理查德·何在专访中坦陈:英伟达Vera在独立运行的通用外设成熟度上,客观上还稍稍落后一点。
原因在于两个极其务实的工程考量:
- 可维护性防爆雷
:许多高度定制方案喜欢把CPU直接焊死在主板上。但AMD Turin采用的是工业标准的插槽式(Socket)设计。在万卡集群中,某颗芯片一旦发生内部电气故障,机房运维人员几分钟内拔下来换一颗新的就行,根本不用把整块几万美元的高密度主板连带报废; - 内存防卡脖子
:大模型需要维护天文数字般的用户上下文。AMD Turin原生支持12通道海量DDR5内存,让每个计算托盘能够轻松配备高达1.5 TB的物理内存池,瞬间化解了上下文缓存的吞吐瓶颈。
2. 为什么紧紧抱住博通(Broadcom)?
自研芯片的陷阱极多OpenAI空有顶级的AI算法,但在物理制造领域依然是个新手。
去台积电要产能,黄仁勋和库克一挥手就是几十万片先进制程订单,甚至能包圆台积电最宝贵的CoWoS先进封装生产线。初出茅庐的OpenAI,凭什么让台积电给你最高优先级的产能配额?
答案就是:找博通当保镖
博通是全球数一数二的ASIC和网络芯片霸主,手里握着最顶级的SerDes互联IP,在台积电那里的排单权更是元老级别。
OpenAI负责定义模型内核与微架构,博通则扛下物理实现、先进制程流片以及先进封装的供应链重任,再交由Celestica进行整机集成。
不逞一时之勇,凡事做两手准备这是工程老将给年轻的AI霸主上的一堂残酷现实课。
06终局:朋友间的残酷竞争
面对自研芯片对英伟达构成的实质性威胁,理查德·何在面对媒体时,展现出了极其微妙的外交辞令。
他将两家公司的关系定义为:“在朋友之间互相竞争(Competing among friends)。”
事实确实如此OpenAI在发布Jalapeño亮眼数据的同时明确表示:自研芯片旨在分担核心工作负载,未来公司仍将继续采购并大规模部署英伟达的最新GPU。
这既是给盟友的面子,也是当下算力黑洞之下的必然选择。
AI的需求扩张得太快了,哪怕把台积电的产能榨干,依然不够全世界挥霍。但对黄仁勋而言,卧榻之侧的酣睡声已经被彻底惊醒。
计算机先驱艾伦·凯(Alan Kay)几十年前曾留下名言:“认真对待软件的人,应当自己做硬件。”
从山姆·奥特曼踏上亚洲化缘的那一天起,OpenAI就早已不满足于做一家寄生在别家硅片上的纯算法公司。
Jalapeño只是这套漫长算力征途的第一枚落子。第二代芯片已在实验室深处狂飙,第三代的架构蓝图也已跃然纸上。
在这个用代码重塑世界的时代,最底层的权力,终究只属于那些能够亲手锻造算力基石的人。