ARTICLE · 1222678
【第56期】 CSIG文档图像分析与识别专业委员会学术微沙龙
CSIG文档图像分析与识别专业委员会学术微沙龙(简称:文档图像微沙龙)在线学术报告会第56期于2026年9月1日成功举行。
本沙龙由中国图象图形学学会主办,文档图像分析与识别专委会发起承办,中国图象图形学报协办。
本场活动邀请华中科技大学博士生李长分享最新成果:MonkeyOCRv2:面向文档智能的视觉基础模型;邀请上海人工智能实验室工程师杨浩特和上海交通大学博士生宋家和共同分享最新成果:MinerU.Chem:一个高精度化学结构与反应识别系统。
微沙龙活动在B站、蔻享学术、中国图像图形学报视频号进行了同步直播。三个平台共计约3940人次的相关领域的老师同学观看学习。
1
第一场报告活动由百度黄明鑫研究员担任主持人。
报告人为华中科技大学博士生李长。
报告围绕“MonkeyOCRv2:面向文档智能的视觉基座模型”展开,深入探讨了文档专用视觉模型的设计与应用。报告首先介绍了 OCR 视觉基座模型的研究意义及其在办公自动化、大模型训练语料构建、古籍数字化等场景中的应用价值,指出现有通用视觉模型难以充分感知文档中的密集文本与细粒度字符信息,而单纯依赖文本生成目标进行训练,又容易使模型利用语言上下文猜测内容,忽略真实的视觉细节。针对这些问题,研究团队构建了覆盖17种语言、包含1.13亿个样本的 MonkeyDoc v2 数据集,并提出联合图像到文本生成与像素级图像重建的预训练方法,使模型在学习文字语义的同时保留字符笔画与版面细节。实验表明,MonkeyOCR v2 在文本识别、公式识别、文本检测、文档篡改检测及重叠文本分割五类任务上均带来了稳定提升。基于该视觉基座构建的文档解析模型仅有0.7B参数,在多语言文档解析基准 MDPBench 上取得83.3分,较此前最优的开源模型提升2.8个百分点;在相同训练设置下,基于该视觉模型构建的文档理解模型的性能也优于采用其他通用视觉编码器的模型。
参考论文
[1]. Liu, Y., Li, Z., Zhang, Z., Zhang, S., Liu, Q., Song, J., Guo, Z., Wang, X., Zheng, H., Liu, Y., Luo, D., Ma, Z., Zhang, J., & Bai, X. (2026). MonkeyOCRv2: A Visual-Text Foundation Model for Document AI. arXiv preprint arXiv:2607.11562.
2
第二场报告活动由上海人工智能实验室的杨浩特老师担任主持人。
报告人为上海人工智能实验室工程师杨浩特和上海交通大学&上海人工智能实验室联培博士生宋家和。
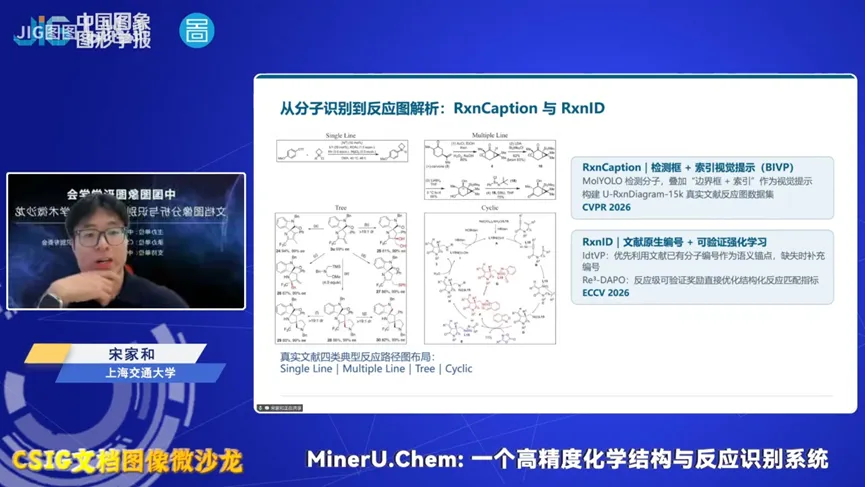
报告题为“从化学图像到结构化知识:MinerU.Chem 的分子识别、反应解析与 AI for Chemistry 实践”,深入探讨了大模型时代面向有机化学文献的智能解析技术。报告首先指出了MinerU在化学文献解析中化学语义解析功能的补足,明确了MinerU.Chem作为补足这一短板关键一环的重要意义。报告进而详细的介绍了MinerU.Chem的整个管线的工作原理。并重点介绍了分子识别和反应图解析两个关键模块。其中分子识别模型GTR-VL创新性的提出了以图遍历的方式预测分子结构和CARBON这种表达能力更强的分子表示方法。得益于其精准的分子识别能力和良好的反应图解析能力,MinerU.Chem自上线以来,获得了学术界和工业界的良好风评。当然,报告最后也指出,在如底物范围图,反应机理图等复杂场景,MinerU.Chem仍然面临挑战,需要进一步的研究探索。
参考论文
[1]. Haote Yang, Jiang Wu, Jingchao Wang, Xingjian Wei, Lixin Ma, Linye Li, Chen Zhu, Xiaolong Wu, Yuheng Lu, Ziran Zhu, et al. MinerU.Chem: A High-Precision System for Optical Chemical Structure and Reaction Recognition. arXiv preprint arXiv:2608.03525, 2026.
[2]. Haote Yang, Hui Wang, Chen Zhu, Jingchao Wang, Linye Li, Hongbin Lai, Huijie Ao, Yongxuan Lyu, Jiang Wu, Jiaxing Sun, et al. Molrecbench-wild: A real-world benchmark for optical chemical structure recognition. arXiv preprint arXiv:2605.05832, 2026.
[3]. Jingchao Wang, Yifan He, Haote Yang, Jiang Wu, Lingli Ge, Xingjian Wei, Yinfan Wang, Linye Li, Huijie Ao, Chengjin Liu, et al. Gtr-cot: Graph traversal as visual chain of thought for molecular structure recognition. arXiv preprint arXiv:2506.07553, 2025.
[4]. Jiahe Song, Chuang Wang, Bowen Jiang, Yinfan Wang, Hao Zheng, Xingjian Wei, Chengjin Liu, Rui Nie, Junyuan Gao, Jiaxing Sun, et al. Rxncaption: Reformulating reaction diagram parsing as visual prompt guided captioning. arXiv preprint arXiv:2511.02384, 2025.
[5]. Jiahe Song, Chuang Wang, Yinfan Wang, Hao Zheng, Rui Nie, Bowen Jiang, Xingjian Wei, Junyuan Gao, Yubin Wang, Bin Wang, et al. Molecular identifier visual prompt and verifiable reinforcement learning for chemical reaction diagram parsing. arXiv preprint arXiv:2603.15011, 2026.
报告回放
B站视频链接:https://www.bilibili.com/video/BV1fonE6BEUT/
或扫描二维码观看:
END
加入学会:
关注我们: