ARTICLE · 1226146
【python实战案例】8层嵌套的Excel套娃公式,我拆成了30行Python 【代码在文末】
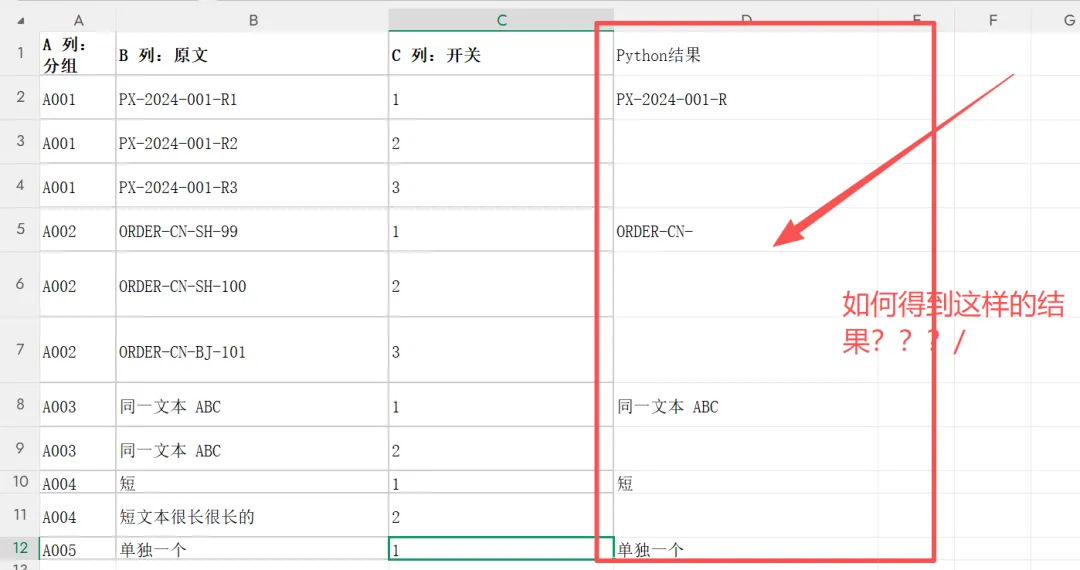
上周用excel公式处理excel中上面的数据,今天花了点时间把它拆成了Python代码,顺便把踩的坑一并整理出来。
LET、FILTER、SEQUENCE、BYCOL、LAMBDA……单个函数都眼熟,叠在一起就看得人头大。
但拆解开就会发现,核心逻辑非常朴素:按A列分组,提取每组B列文本的最长公共前缀,仅在每组第1行(C列=1)输出结果。
今天就以这条公式为例,讲清楚复杂Excel公式转Python的完整思路。
一、先把Excel公式拆开
原始公式如下:
=IF(C2=1,
    LET(t, FILTER(B$2:B$1000, A$2:A$1000=A2),
        L, MAX(LEN(t)),
        k, SEQUENCE(,L),
        ch, MID(t,k,1),
        same, BYCOL(ch, LAMBDA(c, AND(c=INDEX(c,1)))),
        p, MATCH(FALSE,same,0)-1,
        IFERROR(LEFT(B2,p), B2)),
    "")
先不急着转代码,我用一组数据看懂它的真实逻辑。
假设A列分组均为A001,B列数据如下:
三条文本前缀完全一致,仅末尾R1/R2/R3有区别,最长公共前缀就是:
PX-2024-001-R
注意是最长公共前缀,不是公共子串。公式的目标,就是自动定位到这个差异起始点。
把LET里的变量逐个拆解
t | |
L | |
k | |
ch | |
same | |
p | |
result |
对应到字符级就是:
P X - 2 0 2 4 - 0 0 1 - R 1
P X - 2 0 2 4 - 0 0 1 - R 2
P X - 2 0 2 4 - 0 0 1 - R 3
前13个字符完全一致,第14位首次出现差异,因此公共前缀长度为13。
公式的核心逻辑就是这么简单。真正的坑,藏在性能损耗和几个极易忽略的边界场景里。
二、这条公式有3个值得注意的坑
1. 每行重复筛选,计算量指数级上升
FILTER(B$2:B$1000, A$2:A$1000=A2)
公式里的FILTER会逐行筛选当前分组的所有文本。
1000行数据下,分组比对的次数粗略估算可达百万级;数据涨到几万行时,重复计算的开销会直线上升。
实际耗时受分组分布、数组计算模式和Excel版本影响,未必一定会卡顿,但有一点非常明确:同一分组的公共前缀,完全没必要逐行重复计算。这也是迁移Python时最核心的优化点。
2. 依赖错误处理实现正常逻辑
MATCH(FALSE, same, 0)-1
这段代码的作用是定位第一个字符不同的位置。
如果组内文本完全一致,same数组就全是TRUE,MATCH找不到FALSE会直接报错,靠外层的IFERROR捕获错误后返回原文。
功能上没问题,但正常逻辑靠异常兜底,可读性很差,也不符合常规编码习惯。Python里可以直接做判断,不需要靠触发异常来走分支。
3. 文本长度不一致时的越界行为
假设同一组里有两条文本:
短
短文本很长很长的
Excel的MID函数在字符位置越界时,会返回空字符串""。逐位比对时:
第 1 位:短 == 短   TRUE
第 2 位:"" != 文   FALSE
最终得到公共前缀"短",结果是正确的。
但这个细节很容易忽略:空字符串会参与比对,不会因为文本结束就跳过。
转Python时如果直接用text[idx]下标访问,越界会抛出IndexError,和Excel行为不一致。后面我会用切片来模拟Excel的取值规则。
三、先写一个可核对的Python版本
把Excel公式直译成Python,最容易踩的坑就是只追最终结果,忽略中间每一步的计算逻辑。
我的习惯是先写一个1:1对齐的调试版本,完整保留所有中间变量,等逻辑完全核对无误,再做性能优化。
from dataclasses import dataclass
from typing import List, Optional


@dataclass
classLetTrace:
    t: List[str]
    L: int
    ch: List[List[str]]
    same: List[bool]
    p: Optional[int]
    result: str


defformula_literal(texts, current):
    t = list(texts)
    L = max((len(x) for x in t), default=0)

# 模拟 Excel 的 MID:越界时返回空字符串
    ch = [
        [x[i] if i < len(x) else""for i in range(L)]
for x in t
    ]

# 逐列判断字符是否全部相同
    same = []
for i in range(L):
        col = [row[i] for row in ch]
        same.append(all(v == col[0] for v in col))

# 找到第一个 FALSE
    p = None
for i, ok in enumerate(same):
ifnot ok:
            p = i
break

# 对应 IFERROR(LEFT(B2, p), B2)
    result = current if p isNoneelse current[:p]

return LetTrace(t, L, ch, same, p, result)
运行测试:
trace = formula_literal(
    ["PX-2024-001-R1", "PX-2024-001-R2"],
"PX-2024-001-R1"
)
print(trace)
运行后可以看到完整的中间结果:
L = 14

same = [
    True, True, True, True, True, True, True,
    True, True, True, True, True, True, False
]

p = 13

result = 'PX-2024-001-R'
每一步计算过程都透明可查。如果和Excel结果不一致,直接定位对应位置排查即可。
这个版本不求快,求的是把黑盒的Excel公式,变成可调试、可验证的Python代码。逻辑跑通了,优化只是顺水推舟的事。
四、生产环境我会这么写
调试版有个明显的问题:会把所有文本拆解成二维字符矩阵,数据量大了内存开销很高。
生产环境不需要保留中间过程,逐位比对、遇到第一个不同字符就终止,效率会高很多。
先写公共前缀函数:
defcommon_prefix(texts):
"""返回一组文本的最长公共前缀。"""
ifnot texts:
return""
if len(texts) == 1:
return texts[0]

    longest = max(len(t) for t in texts)
    prefix_len = 0

for idx in range(longest):
        first = texts[0][idx:idx + 1]
for text in texts[1:]:
if text[idx:idx + 1] != first:
return texts[0][:prefix_len]
if first == "":
break
        prefix_len += 1

return texts[0][:prefix_len]
这里有个关键细节:用text[idx:idx+1]切片,而不是text[idx]下标访问。
原因很简单:切片越界会返回空字符串,下标越界会抛出IndexError。这一字之差,决定了能不能完美复现Excel的MID行为。
接下来处理分组逻辑:
defprefix_by_key(
    rows,
    key_col=0,
    text_col=1,
    flag_col=2,
    flag_value=1
):
    rows = list(rows)

defnorm(value):
return""if value isNoneelse str(value)

# 第一步:一次性建立分组索引
    groups = {}
for row in rows:
        key = norm(row[key_col])
        text = norm(row[text_col])
        groups.setdefault(key, []).append(text)

# 第二步:每个分组只计算一次公共前缀
    cache = {}
    results = []

for row in rows:
if flag_col isnotNoneand row[flag_col] != flag_value:
            results.append("")
continue

        key = norm(row[key_col])
if key notin cache:
            cache[key] = common_prefix(groups[key])
        results.append(cache[key])

return results
核心做了两处优化:
第一,预分组替代逐行筛选。 原公式每行都执行一次FILTER,Python里先遍历一次数据,用字典建好分组索引,后续直接取数,避免重复筛选。
第二,分组结果缓存。 同一分组的公共前缀只计算一次。1000行数据如果只有20个分组,公共前缀最多算20次,而不是1000次。
补充说明:建索引依然需要遍历全量数据,缓存优化的是公共前缀的重复计算开销,不是说全程只遍历20次。
代码里的flag_col对应原公式的C列。这里C列实际是组内序号,只有C=1(每组第一行)才输出结果,其余行返回空值——相当于把公共前缀"贴"在每组的首行上。
五、用真实数据跑一遍
我手上实际的数据长这样,C列是组内流水号(1、2、3……),不是简单的0/1开关:
跑完之后,D列的结果是:
几个关键场景都覆盖到了:
A001:三条文本仅末尾序号不同,公共前缀正确提取到 PX-2024-001-R;只有C=1的首行输出,C=2、C=3的行留空。A002:第三条文本 ORDER-CN-BJ-101在第10位和前两条分叉(SH vs BJ),公共前缀截断到ORDER-CN-,符合预期。A003:两条文本完全一致,不存在分叉点, MATCH找不到FALSE的场景被正确处理,返回原文。A004:一条短一条长,短文本读完后按空串参与比较,公共前缀停在"短"字,没有越界报错。 A005:分组里只有一条文本,直接返回原文。
再单独测几个边界用例:
print(common_prefix(["A", "AB"]))      # A
print(common_prefix(["B", "A"]))       # 空字符串
print(common_prefix(["", "A"]))        # 空字符串
print(common_prefix(["X"]))            # X
print(common_prefix([]))               # 空字符串
边界测试非常必要。尤其要区分两种情况:
第一位就不同:公共前缀长度为0,返回空串; 组内只有一条文本:压根没有"不同位置",走的是 IFERROR兜底,返回原文。
"前缀长度为0"和"没找到差异点",是两回事——这也是把Excel公式翻成代码时最容易写反的地方。
六、对接Excel文件,下面代码,直接复制,直接生成结果
逻辑验证无误后,就可以用openpyxl对接真实Excel文件,直接批量输出结果。
下面是开箱即用的完整版本,默认读取Sheet1,从第2行开始处理,A/B/C列分别对应分组、原文、序号,结果写入D列。
# -*- coding: utf-8 -*-
"""
按 A 列分组,提取每组 B 列文本的最长公共前缀,
仅在 C 列标记为 1 的行输出结果,结果写入 D 列。
"""

# 从 openpyxl 库导入 load_workbook:用来打开 .xlsx 文件
# 如果报 ModuleNotFoundError,先执行: python -m pip install openpyxl
from openpyxl import load_workbook


defcommon_prefix(texts):
"""
    输入一组字符串,返回它们的最长公共前缀。
    例如 ["PX-001-R1", "PX-001-R2"] -> "PX-001-R"
    """

# 边界情况 1:空列表,没有文本,直接返回空串
ifnot texts:
return""

# 边界情况 2:只有一条文本,公共前缀就是它本身
# (对应原 Excel 公式 IFERROR 兜底返回原文的逻辑)
if len(texts) == 1:
return texts[0]

# 找出组内最长文本的长度,作为逐位比较的最大轮次
# 例:["abc", "ab"] -> longest = 3
    longest = max(len(t) for t in texts)

# prefix_len 记录当前已经确认“所有文本都相同”的字符个数
    prefix_len = 0

# 从第 0 位开始,一位一位往后比
for idx in range(longest):

# 取第一条文本在 idx 位置的字符,作为这一位的“标准答案”
# 注意:用切片 [idx:idx+1],而不是下标 [idx]
# 原因:切片越界时返回空字符串 "",和 Excel 的 MID 行为一致;
#       下标越界会直接抛 IndexError,程序崩溃。
        first = texts[0][idx:idx + 1]

# 拿这一位的“标准答案”,去和组内其他所有文本的同一位比较
for text in texts[1:]:

# 只要有任何一条文本在这一位对不上,就说明公共前缀到此为止
# 直接返回已经确认相同的前 prefix_len 个字符
if text[idx:idx + 1] != first:
return texts[0][:prefix_len]

# 能走到这里,说明这一位所有文本都一致。
# 但如果标准答案本身是空串(说明第一条文本已经读完了),就停止。
# 不加这个判断,下一轮 first 还是空串,会无限“比较成功”。
if first == "":
break

# 这一位全部相同,公共前缀长度 +1
        prefix_len += 1

# 循环正常结束(所有位都比完了,且没出现不一致)
# 说明较长的文本完全包含较短的文本,返回前 prefix_len 个字符
return texts[0][:prefix_len]


defprefix_by_key(
    rows,
    key_col=0,      # 分组列下标(从 0 开始)
    text_col=1,     # 原文本列下标
    flag_col=2,     # 开关列下标
    flag_value=1,   # 开关列取何值时才输出结果
):
"""
    输入多行 (分组, 文本, 开关),返回每行对应的公共前缀结果。
    同一个分组只计算一次公共前缀,用缓存避免重复计算。
    """

# 兼容传入的是生成器的情况,转成 list 方便多次遍历
    rows = list(rows)

# 内部小工具:把 None 统一转成空串,其他值统一转成字符串
# 防止 Excel 里单元格是空(None)或数字时,拼字符串报错
defnorm(value):
return""if value isNoneelse str(value)

# ========== 第一步:先遍历一遍数据,按分组号建立索引 ==========
# groups 是一个字典:{分组号: [文本1, 文本2, ...]}
# 这样后面取某个分组的所有文本,直接 groups[key] 就行,不用再筛一遍
    groups = {}
for row in rows:
        key = norm(row[key_col])     # 取出分组号(如 "A001")
        text = norm(row[text_col])   # 取出原文本(如 "PX-2024-001-R1")
# 如果 key 不在字典里,就先塞一个空列表;然后把文本 append 进去
        groups.setdefault(key, []).append(text)

# ========== 第二步:再遍历一遍数据,每行产出结果 ==========
    cache = {}       # 缓存:{分组号: 该组的公共前缀},同一个分组只算一次
    results = []     # 最终输出的结果列表,和输入 rows 一一对应

for row in rows:

# 如果开关列不等于 flag_value(默认不等于 1),这一行输出空串
# 对应原 Excel 公式最外层 IF(C2=1, ..., "")
if flag_col isnotNoneand row[flag_col] != flag_value:
            results.append("")
continue# 跳过本行,不参与计算

# 取出当前行的分组号
        key = norm(row[key_col])

# 如果这个分组的公共前缀还没算过,就算一次并存进缓存
# 这是性能优化的核心:原 Excel 公式每一行都重新 FILTER 一遍,
# 这里整个分组只算一次,算完后面同组的行直接取缓存。
if key notin cache:
            cache[key] = common_prefix(groups[key])

# 把缓存里的结果追加到输出列表
        results.append(cache[key])

# 返回所有行的结果,顺序和输入 rows 完全一致
return results


defrun_excel(
    src="input.xlsx",        # 输入文件路径
    dst="output.xlsx",       # 输出文件路径
    sheet="Sheet1",          # 工作表名
    start_row=2,             # 数据从第几行开始(第1行当表头)
    key_col=1,               # 分组列(openpyxl 列号从 1 开始,A=1)
    text_col=2,              # 原文本列(B=2)
    flag_col=3,              # 开关列(C=3)
    out_col=4,               # 结果写回到哪一列(D=4)
    flag_value=1,            # 开关列取何值时输出结果
):
"""完整流程:读 Excel -> 算公共前缀 -> 写回新列。"""

# 打开 Excel 文件(read_only=False 才能写回)
    wb = load_workbook(src)

# 如果指定的 sheet 存在就用它,不存在就用当前活动的表
    ws = wb[sheet] if sheet in wb.sheetnames else wb.active

# 第一步:把数据读出来,同时记录每一行的原始 Excel 行号
# 为什么要记行号?因为后面写结果时要写回原来那一行,不能错位
    data_rows = []   # 形如 [(2, ("A001", "PX-001-R1", 1)), (3, (...)), ...]

# iter_rows 是 openpyxl 高效按行读取的方法
# min_row 从 start_row 开始;max_col 一次最多读用到的列数
for row_num, row in enumerate(
        ws.iter_rows(
            min_row=start_row,
            max_col=max(key_col, text_col, flag_col, out_col),
            values_only=True,   # True 直接返回单元格的值,而不是 Cell 对象
        ),
        start=start_row,        # 行号从 start_row 开始计数
    ):
# 如果这一行所有列都是 None(完全空行),跳过不处理
# 对应原文章里说的“跳过空白行,但保留行号位置”
if all(v isNonefor v in row):
continue

# 从 row 元组里取出三列的值(注意 row 是 0 索引,所以列号要 -1)
        key = row[key_col - 1]
        text = row[text_col - 1]
        flag = row[flag_col - 1] if flag_col isnotNoneelseNone

# 把 (行号, (分组, 文本, 开关)) 存起来
        data_rows.append((row_num, (key, text, flag)))

# 把读出来的行整理成 prefix_by_key 需要的格式
# (prefix_by_key 里列下标是从 0 开始的,所以直接 (k, t, f) 就行)
    norm_rows = [(k, t, f) for _, (k, t, f) in data_rows]

# 调用核心计算函数,得到和 data_rows 一一对应的结果列表
    results = prefix_by_key(
        norm_rows,
        key_col=0,
        text_col=1,
        flag_col=2,
        flag_value=flag_value,
    )

# 写表头:在 out_col 列的第 1 行写“Python结果”
    ws.cell(row=1, column=out_col, value="Python结果")

# 按原始行号,把结果逐行写回 Excel
# zip 把 (行号, 原始行数据) 和 计算结果 一一配对
for (row_num, _), value in zip(data_rows, results):
        ws.cell(row=row_num, column=out_col, value=value)

# 另存为新文件(不会覆盖原文件,更安全)
    wb.save(dst)

# 打印完成提示,方便确认脚本跑通了
    print(f"处理完成,共 {len(results)} 行,文件已保存:{dst}")


# 脚本入口:只有直接运行本文件时才执行下面的代码
# (被别的 import 时不会自动跑)
if __name__ == "__main__":
    run_excel(
        src="input.xlsx",    # 输入文件名
        dst="output.xlsx",   # 输出文件名
    )
运行前先安装依赖:
pip install openpyxl
将待处理文件命名为input.xlsx,和脚本放在同一目录下运行即可,结果会输出到output.xlsx的D列。
两点注意事项:
代码会跳过完全空白的行,但保留原始行号;如果表格包含公式、特殊格式或带宏的 .xlsm文件,需要根据实际结构调整读写逻辑。正式迁移前不要直接覆盖原文件,建议先备份,再将Python结果与Excel公式结果逐行比对,确认完全一致后再替换。