ARTICLE · 1234380
Phoenix-MWA 源码精读:双教师蒸馏加联合去噪,33.8 亿帧怎么教会机器人干活
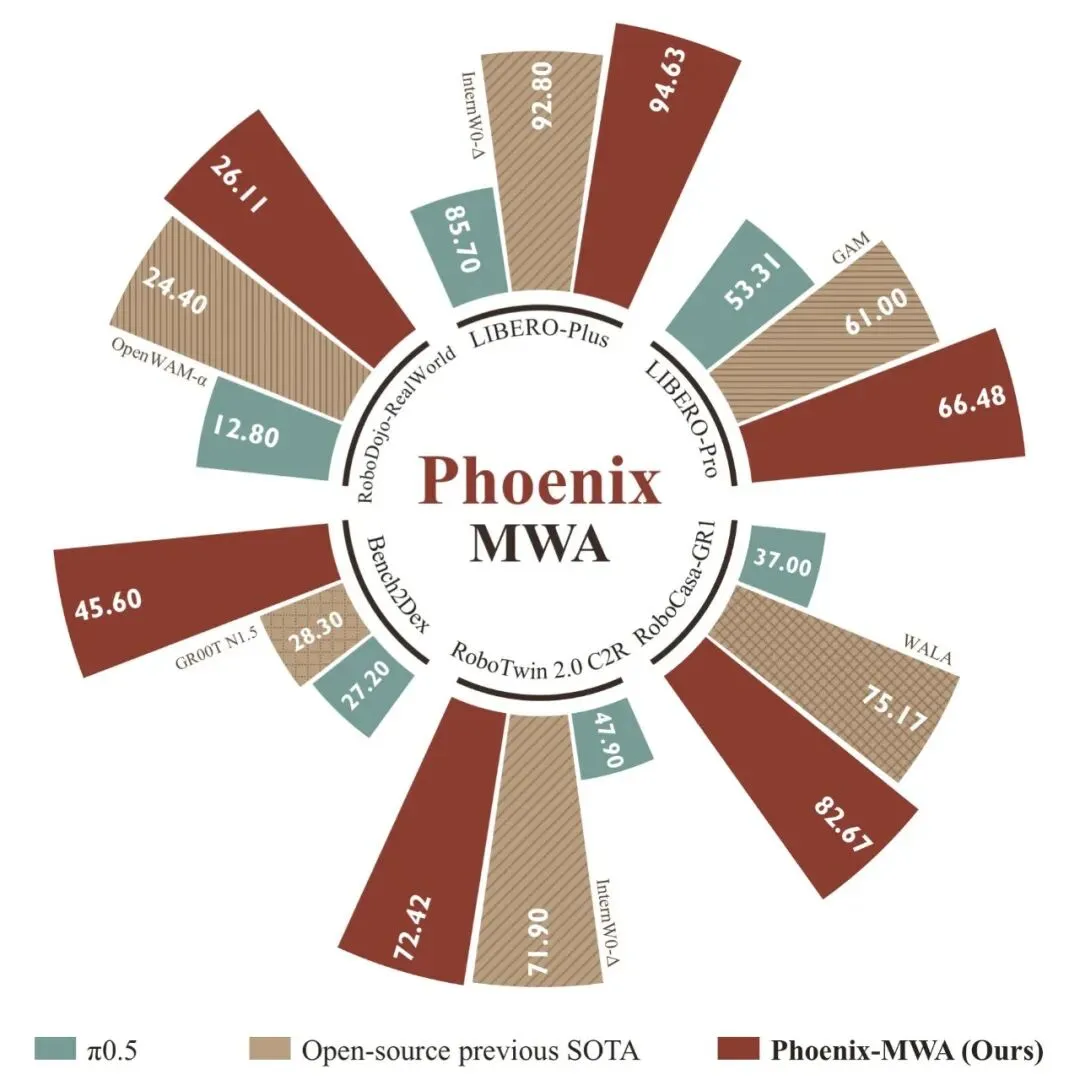
昨天上午,机器之心放出无界动力的开源消息:MWA-Phoenix 隐空间世界模型基座连同预训练代码、权重、后训练评测分支一起放了出来。六项操作评测一次登顶——LIBERO-Plus 94.63%、LIBERO-Pro 66.48%、RoboCasa-GR1 82.67%、Bench2Dex 45.6%、RoboTwin 2.0 C2R 72.42%,外加 RoboDojo 真机榜。仓库 10 月 20 日建,代码树完整,我把技术报告和源码读了一遍。
01 先看结论
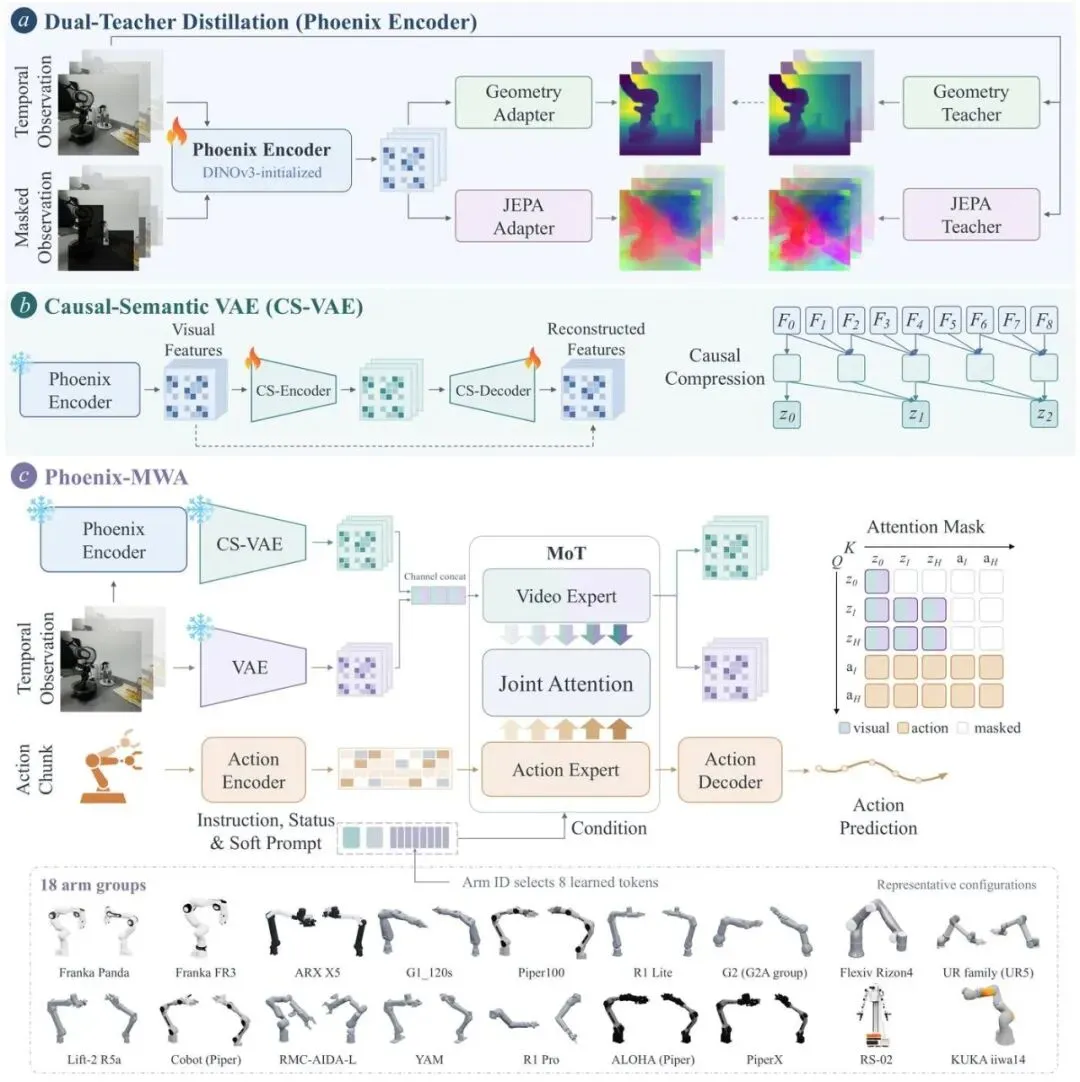
MWA-Phoenix 解决的是具身基模的感知短板:操作任务要看清三维空间怎么随动作变化,现成的视觉骨干要么懂语义不懂几何,要么懂几何不懂时间。团队的办法是给 DINOv3 请两个老师——VGGT 管几何、V-JEPA 管时序,蒸馏完再压进一个因果 VAE,然后让视频专家和动作专家在一个混合 Transformer 里联合去噪。
预训练数据池约 54400 原始小时、39300 有效小时、33.8 亿帧,覆盖真机操作、第一视角人手数据和 UMI 录制。可训练参数约 6B,其中视频专家 5B、动作专家 1B,三套编解码器全部冻结。
停在哪:六榜成绩都带各自的后训练设置,不能直接互比;Bench2Dex 45.6% 的绝对值说明跨本体迁移还难;RoboDojo 真机榜 26.11%,真机和仿真之间的沟还在。只看一个文件的话,看 src/wam/training/losses.py 的 _joint96_training_loss,联合去噪的全部逻辑都在这一个函数里。
02 问题背景
机械臂操作有个绕不开的事实:抓取发生在三维空间里,错误在三毫米的位姿偏差上兑现。纯语义表征分辨得出「杯子」和「碗」,但说不清杯子离爪子多远、歪了多少度;VGGT 这类几何模型能给深度和相机位姿,却不懂一段连续观测里什么变了。团队在技术报告里说得很直白:绝大多数表征方式对几何与时序的联合理解是缺失的。
第二个坎在训练目标上。模仿学习只学动作序列,不看世界会怎么变;视频世界模型只预测画面,不接执行。两件事捏在一起训,又容易互相稀释——视频分支追着像素走,动作分支追着关节走,谁也帮不上谁。上周写过的 LoopWAM 和这里是同一族思路,都拿 Wan2.2 当视频底座、动作专家逐层联合注意力,区别在 LoopWAM 回收部署数据,MWA-Phoenix 把功夫全花在预训练表征上。
第三件事是数据。17 种本体的关节构型各不相同,单臂双臂、灵巧手、移动底盘都往一个模型里塞,得先约定统一的表示接口。
03 方法拆解
主线一句话:把外观、几何、时序压进同一套潜空间,让「世界会怎么变」和「机器人该怎么做」共享一个骨干。
第一个设计是双教师蒸馏。学生骨干是 DINOv3 ViT-L/16 加一个时空适配器,两个老师都冻结:VGGT-Ω 出几何监督,用的是多层特征、深度预测和相邻帧关系,不需要真值深度;V-JEPA 出时序监督,老师看完整视频,学生在被一致遮蔽的区域里预测老师的特征。两门课交替上,学生权重做指数滑动平均,CS-VAE 和策略侧用的都是这份 EMA 骨干。
第二个设计是 CS-VAE 因果压缩。DINOv3 特征语义几何都有,但维度高、分布不像高斯,直接拿去做生成代价大。CS-VAE 用一个空间 Transformer 和两级因果时间阶段,把九帧压到三个时间位置、空间网格不动;因果连接保证编码时不许偷看未来帧,重建约束留住语义与空间结构。
第三个设计是联合去噪。一条训练样本配 32 个动作和同区间的九帧:WanVAE 提外观特征,当前观测保持干净,未来八帧和 32 个动作各自加噪,两个专家在 MoT 的掩码联合注意力里一层层互通信息;语言(T5 嵌入)、机器人状态投影、本体软提示从交叉注意力侧喂给动作分支。
公式只写损失:视频损失等于 0.5 乘 WanVAE 潜空间的掩码均方误差加 0.5 乘 CS-VAE 潜空间的同型误差,动作损失是动作的掩码均方误差,总损失等于两者相加。三个量:WanVAE 分支管「画面长什么样」,CS-VAE 分支管「几何语义怎么摆」,动作分支管「关节怎么走」,各自按去噪时间步加权,互不加系数。
04 源码对照
先说调用链。scripts/pretrain.sh 起 28 节点训练,scripts/pretrain.py 进 src/wam/trainer.py 的加速器封装,损失在 src/wam/training/losses.py 的 frame_training_loss,正式目标叫 _joint96_training_loss;模型组装在 src/wam/model/world_action_model.py,WAM 类持有 video_expert、action_expert、mot 三件套;掩码联合注意力的实现躺在 src/wam/model/modules/mot/mixture_of_transformers.py。
要先分清一件事:函数开头一连串 raise ValueError 把路堵死——损失系数必须全为 1,不支持非单位动作权重,不许训练时开 RTC 前缀,不许视频专家用真值动作做条件。这些断言划出了正式 recipe 的边界,别处那些分支是实验代码。
第一处对读,技术报告 III.1 说「当前观测保持干净,未来视觉潜态与动作加噪」,对应 losses.py 里的四行:
timestep_video = model.train_video_scheduler.sample_training_t(...)noisy_video = model.train_video_scheduler.add_noise(input_latents, noise_video, timestep_video)noisy_video[:, :, :1] = input_latents[:, :, :1]target_video = model.train_video_scheduler.training_target(input_latents, noise_video, timestep_video)
第三行把加噪后的第一帧直接换回干净潜态,下一行把第一帧的训练目标整个置零——观测不加噪、不算损失,逐字对上技术报告。采样器是 WanContinuousFlowMatchScheduler,训练推理各配一对,默认 1000 步、shift 5.0。动作支路同样三步:加噪、取目标、送进 action_expert 的 pre_dit。掩码处理贯穿始终:相机填充、时间填充、动作维填充各自生成有效位,输入潜态先按有效位归零再采样噪声,加噪后的视频张量还再清洗一次,对上 80 维接口「缺失维度置零并从损失里剔掉」的约定。
第二处对读,技术报告图 2 说「MoT 每层掩码联合注意力,注意力掩码规定信息访问方向」,对应 mixture_of_transformers.py 的 _mixed_attention:
if self.attention_backend == "sdpa" or ...:effective_mask = self._apply_key_mask(attn_mask, flex_key_mask, ...)effective_mask = self._apply_query_mask(effective_mask, query_mask)...block_mask = self._build_flex_block_mask(attention_mask=..., query_len=..., key_len=...)out = self._flex_attention(q_heads, k_heads, v_heads, block_mask, ...)
键掩码和查询掩码分开施加,访问方向写进 block_mask,flex_attention 走块掩码编译加速,sdpa 是兜底后端。类初始化时还有一句硬校验:mixtures 必须同时含 video 和 action 两个专家,缺一个直接抛错。
05 实验配置
预训练的架子是 28 节点乘 8 卡共 224 张 GPU,全局 batch 4480,跑满 256013 步;学习率 1e-4 余弦退火到 1e-6,前一万步 warmup;BF16 精度、DeepSpeed ZeRO-1,权重衰减 0.01,梯度裁剪 1.0,每 5000 步存一次。
冻结名单:WanVAE 约 705M、Phoenix Encoder 约 621M、CS-VAE 约 72M;可训练的是两个专家、状态投影和本体软提示,合计约 6B。机器之心的稿子按整体规模口径称端侧 7B。
数据侧,configs/pretrain/ 下 22 份数据源清单、17 份本体配置(agibot、galaxea、human、intern、rdt1b、rh20t、robomind、roboset、umi 等)。窗口 33 帧、动作块 32、动作与视频频率 4 比 1,分辨率 256 边长、三相机拼接;主视角增强含运动模糊、高斯模糊、变焦模糊、雾、玻璃模糊五种噪声,语言增强概率 0.7。
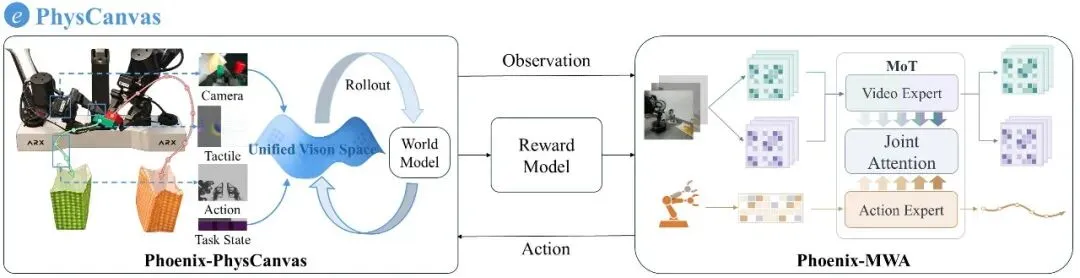
后训练各走各的设置:LIBERO 上 20000 步用于视频预测对比;接触任务用 ILA,强化学习走 PhysCanvas 先监督微调再 GRPO。真机演示的推理在一张 RTX 4090 上原速运行,RTC 实时分块加异步执行。
06 结果怎么看
六个榜分开写,各自带自己的后训练与评测设置。LIBERO-Plus 七类扰动下总体成功率 94.63%;LIBERO-Pro 任务条件变化 66.48%;RoboCasa-GR1 桌面长时序 82.67%,比前代 MWA-WALA 的 75.17% 高 7.5 个百分点;Bench2Dex 跨本体平均 45.6%,比最强对照 π0.5 高 17.3 个百分点;RoboTwin 2.0 C2R 双臂随机场景 72.42%;RoboDojo 真机榜 26.11%。
RoboDojo 这个榜的含金量值得单独说一句:机器之心的稿子里提到,GPT-6 Astra 在同一评测的早期评估里仿真成绩领先,真机诊断测试却因为出现不合理或不安全动作而中止,没能进入正式真机评测。仿真高分不等于可靠执行,26.11% 这一行数字是在这个背景下拿出来的。
两个后训练的收益都给了真机对照。加入 ILA 后,黄瓜削皮成功率 20% 到 40%,盘子擦拭 75% 到 90%,同任务下 FastWAM 是 10% 和 50%;PhysCanvas 里 GRPO 之后,试管任务 58.33% 到 75.00%,积木 80.00% 到 86.67%。
视频预测对比设置在 LIBERO-Plus 相同的 200 个完整窗口上,评估未来八帧,主视角、腕视角和窗口等权平均,五项指标上 MWA-Phoenix 都高于 FastWAM 和一个无策略预训练的对照配置。
真机演示一共放了八段原速视频:笔袋收纳、三明治制作、削皮、擦盘、试管、积木、拧瓶盖、魔方复位,从多步骤衔接到持续工具接触都有覆盖;机器之心的稿子另外提到咖啡场景里跨布景、光照与人流完成递送、清理、回收、归位的长时程任务。
我没有跑,这些数字全部照技术报告口径照抄。
07 论文与代码
已对上的部分:主分支只放预训练;后训练与六榜评测在另一个组织名下的 post-train 分支(OpenPhoenix-Team/Phoenix-MWA)。没放全的部分照实说:encoder、data、rtc 三个分支在 README 里标着 coming soon,双教师蒸馏的蒸馏代码和 RTC 异步执行的实现暂时读不到,复现编码器一侧现在做不到。
实现补充:resources/ 不随 git 走——Wan2.2-TI2V-5B 三个 DiT 分片、Wan2.2-VAE、Phoenix Encoder 的 DINO110k EMA 检查点、CS-VAE 第 150000 步检查点、数据清单和 UMT5 文本缓存都得另备;训练不联网补文件,启动器还强制校验 224 卡拓扑。
只是配置选择、不是缺陷的一类:损失函数断言所有权重为 1(样本等权),WAM 构造函数给视频和动作各配一对 train/infer 调度器并默认 shift 5.0——这一整套默认值就是正式 recipe 本身。
08 复现路线
环境用 Python 3.10 配 PyTorch 2.7.1 加 cu128 和 torchvision 0.22.1,仓库根目录 pip install -e '.[train,logging]',train 扩展开 DeepSpeed。之后把 resources/ 包备齐再启动,不然训练脚本第一步就停。
启动命令是 scripts/pretrain.sh,每个节点设 NNODES=28、NPROC_PER_NODE=8、NODE_RANK 0 到 27,MASTER_ADDR 指向零号节点,RUN_ID 起个新名字。W&B 默认关闭,成功与否看 runs/ 目录下的检查点和每 5000 步的评估输出。
一个容易看错的地方:不要在 main 分支里找评测和后训练——六榜成绩的复现路径在 post-train 分支,主分支只有预训练。另外把仓库 clone 下来就开跑是不行的,缺的权重和文本缓存不会自动下载。
09 判断
有证据的价值:这是国产具身基模里少见的系统级开源——预训练代码、6B 级权重、评测分支三样齐活;六榜覆盖鲁棒性、泛化、长时序、跨本体、双臂、真机六个侧面,比单榜成绩有说服力;几何时序联合表征踩在操作任务的真实短板上,从 Bench2Dex 领先 π0.5 的幅度看也确实吃到了收益。
限制同样清楚:45.6% 的跨本体绝对值、26.11% 的真机榜,说明通用操作基模离「随便换机器人就能干」还有距离;六榜各带各的后训练,直接横比容易误读;蒸馏与 RTC 代码没放全,第三方现在只能复训不能复核。
我的推测,标明是推测:接下来最值得盯 rtc 分支——4090 上原速跑的演示目前只有视频证据,端侧实时分块执行是这套基座能不能真上产线的那道门,代码放出来的那天这个问题才算有答案。