ARTICLE · 1284424
AI统计方法创新与统计业务实践
AI统计方法创新与统计业务实践
程瑶 (南京审计大学)
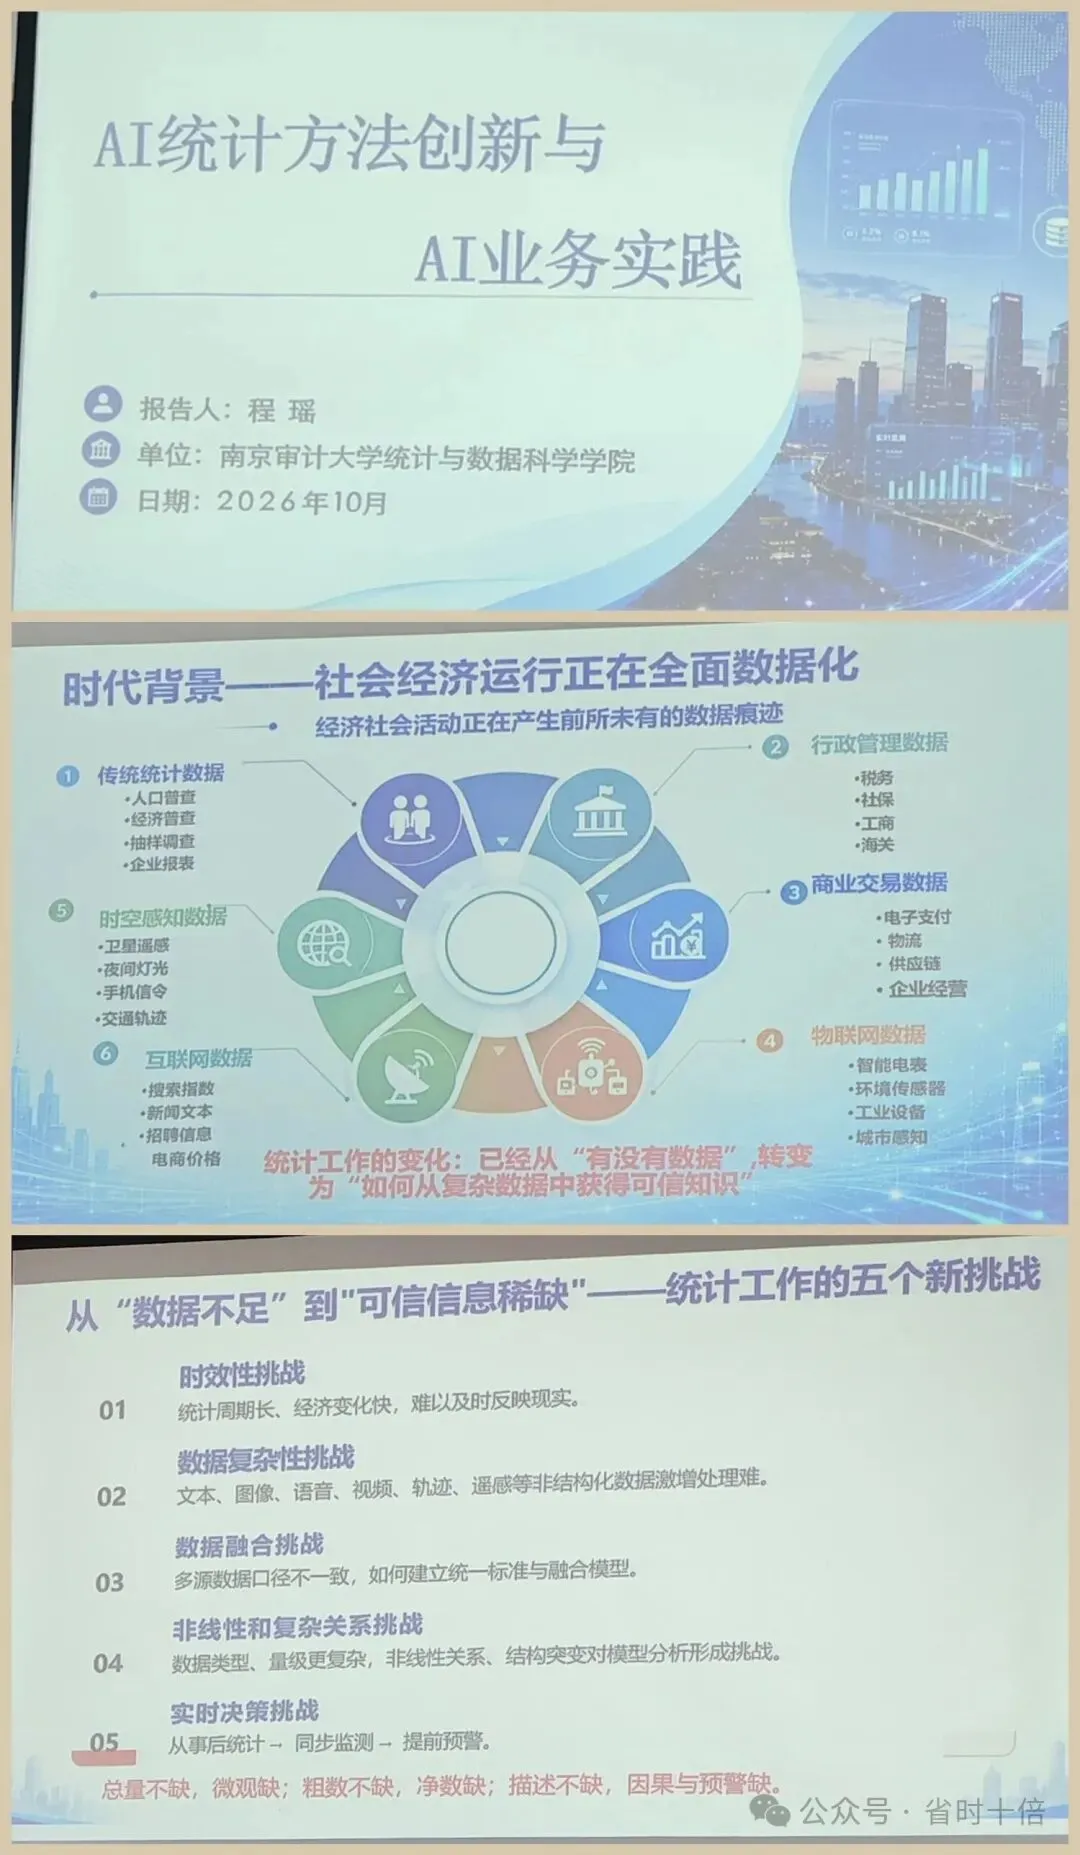
一、时代背景与统计工作新挑战
(一)社会经济全面数据化
人类社会进入全面数据化时代,数据来源从传统统计报表扩展为六大类:
·传统统计数据:普查、抽样调查、报表等官方统计产品。
·行政管理数据:税务、工商、社保、海关等行政记录。
·商业交易数据:电商支付、物流、平台交易等商业记录。
·物联网数据:传感器、设备、监测终端自动采集。
·时空感知数据:GPS定位、遥感影像、地理信息。
·互联网数据:网页、社交、搜索、评论等网络痕迹。
统计工作的重心已经从“有没有数据”转向“如何从复杂数据中得到可信知识”。
(二)统计工作五大新挑战
挑战维度核心问题
时效性挑战传统统计周期长,跟不上经济快速变化,需要近实时监测。
数据复杂性挑战文本、图像、轨迹、音视频等非结构化数据大量增加。
数据融合挑战多源数据标准不一、口径差异大,融合难度高。
非线性复杂关系挑战变量间关系复杂、存在突变,传统线性模型难刻画。
实时决策挑战从事后统计转向同步监测、提前预警,支撑即时决策。
痛点:总量不缺,微观缺;粗数不缺,净数缺;描述不缺,因果与预警缺。
(三)政策定位
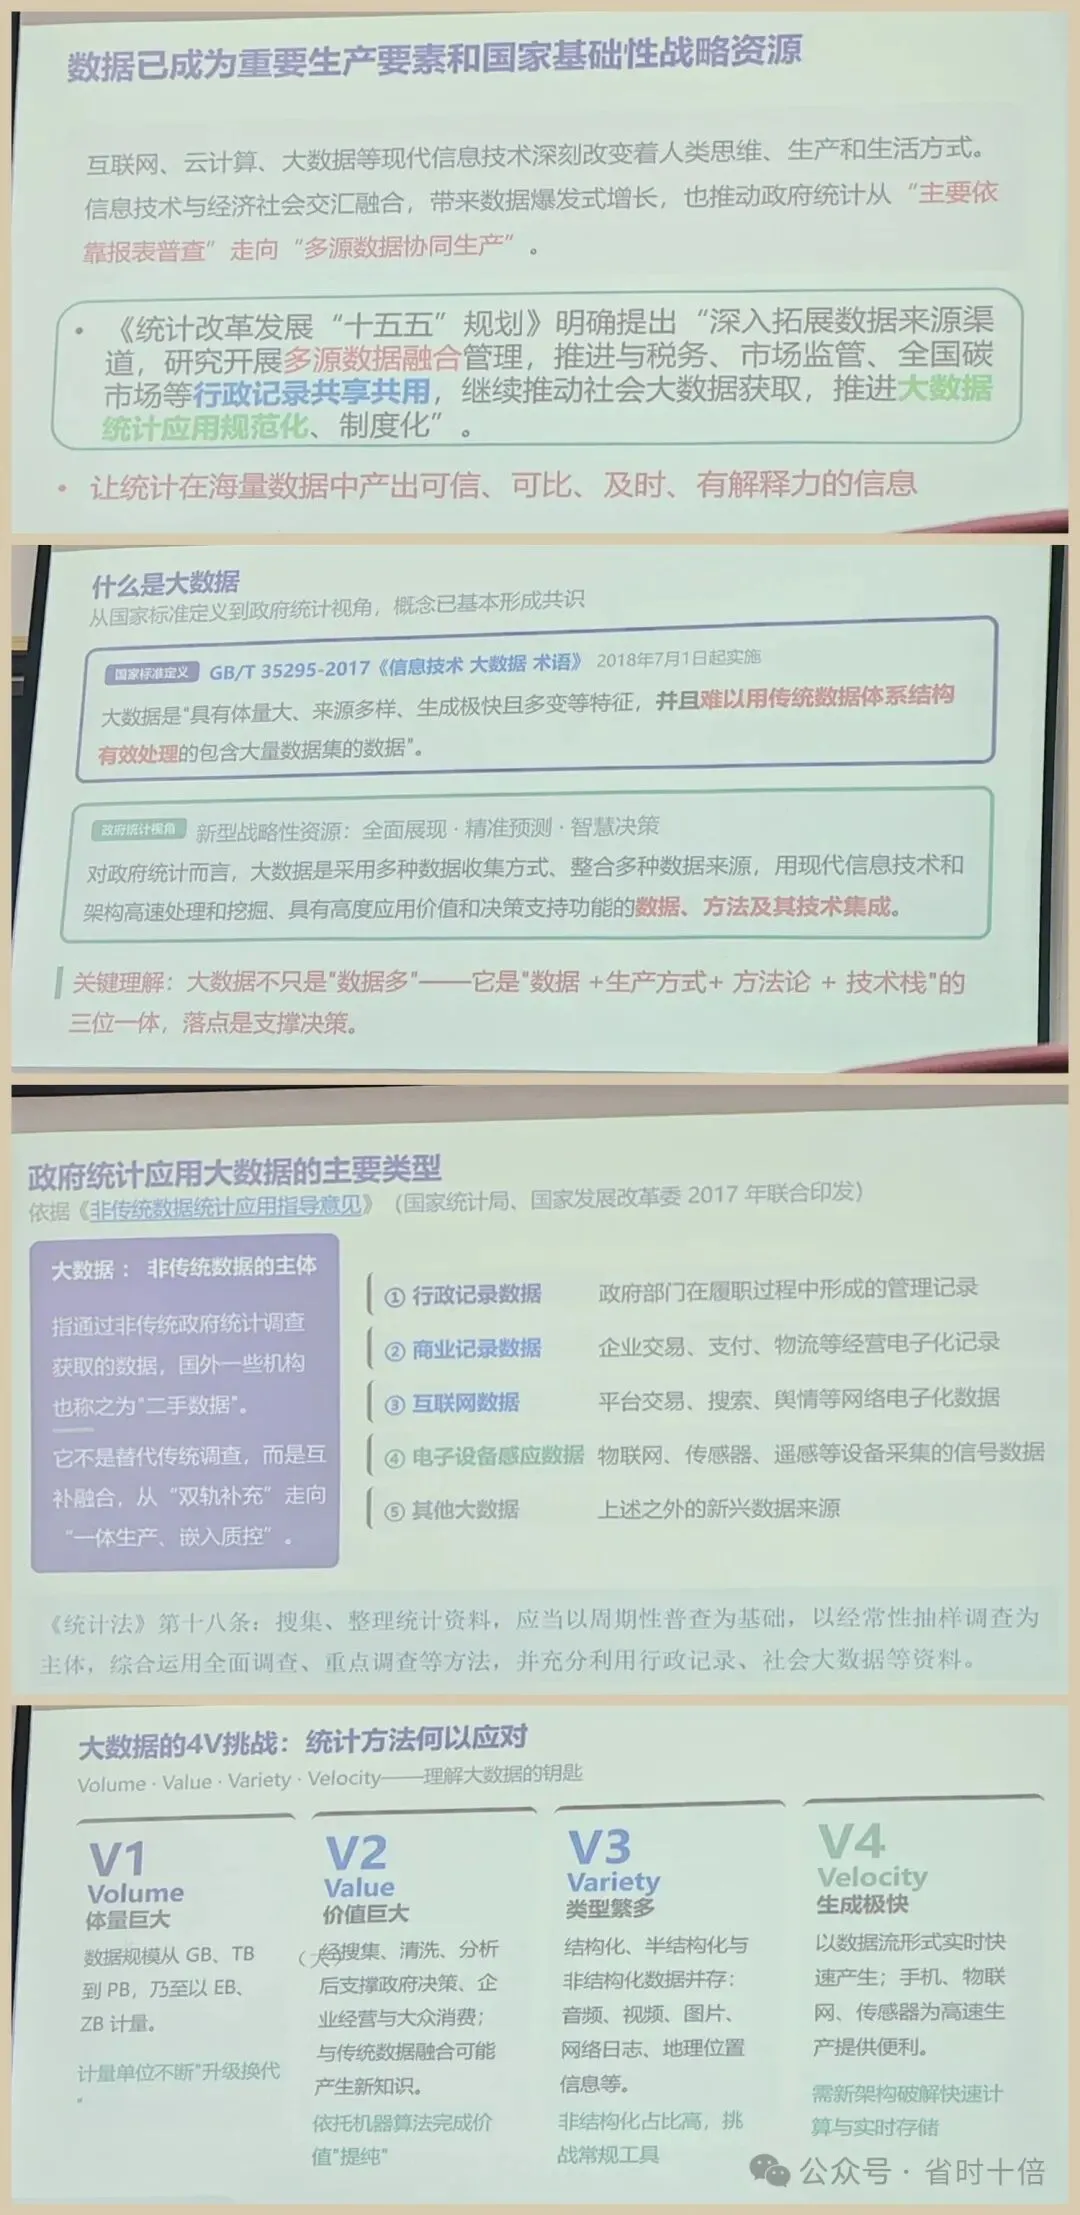
·数据是生产要素,是国家基础性战略资源。
·国家《统计改革发展“十五五”规划》提出发展多源数据融合、大数据统计。
·《非传统数据统计应用指导意见》推动政府统计从“靠报表普查”转向“多源数据协同生产”。
·《国家统计质量保证框架(2021)》鼓励使用聚类、决策树等数据挖掘方法,并新增大数据、行政记录的质控要求。
二、大数据基础认知
(一)大数据定义与分类
国家标准 GB/T 35295-2017 定义:大数据是指体量巨大、来源多样、生成极快且多变,难以用传统数据体系进行有效处理的数据集。
政府统计语境中的大数据(又称非传统二手数据)包括:行政记录、商业记录、互联网数据、设备感应数据及其他新兴大数据。它与传统统计数据是互补融合关系,不是替代关系。
(二)大数据 4V 特征
特征含义
Volume体量巨大,数据规模达到 TB、PB 甚至 EB 级别。
Value价值巨大但密度低,需要挖掘才能提炼有用信息。
Variety类型繁多,结构化、半结构化、非结构化并存。
Velocity生成极快,要求实时或近实时处理与分析。
核心观点:大数据不只是“数据多”,而是“数据 + 生产方式 + 方法论 + 技术栈”的结合,最终服务于决策。
三、两大常见认识误区辨析
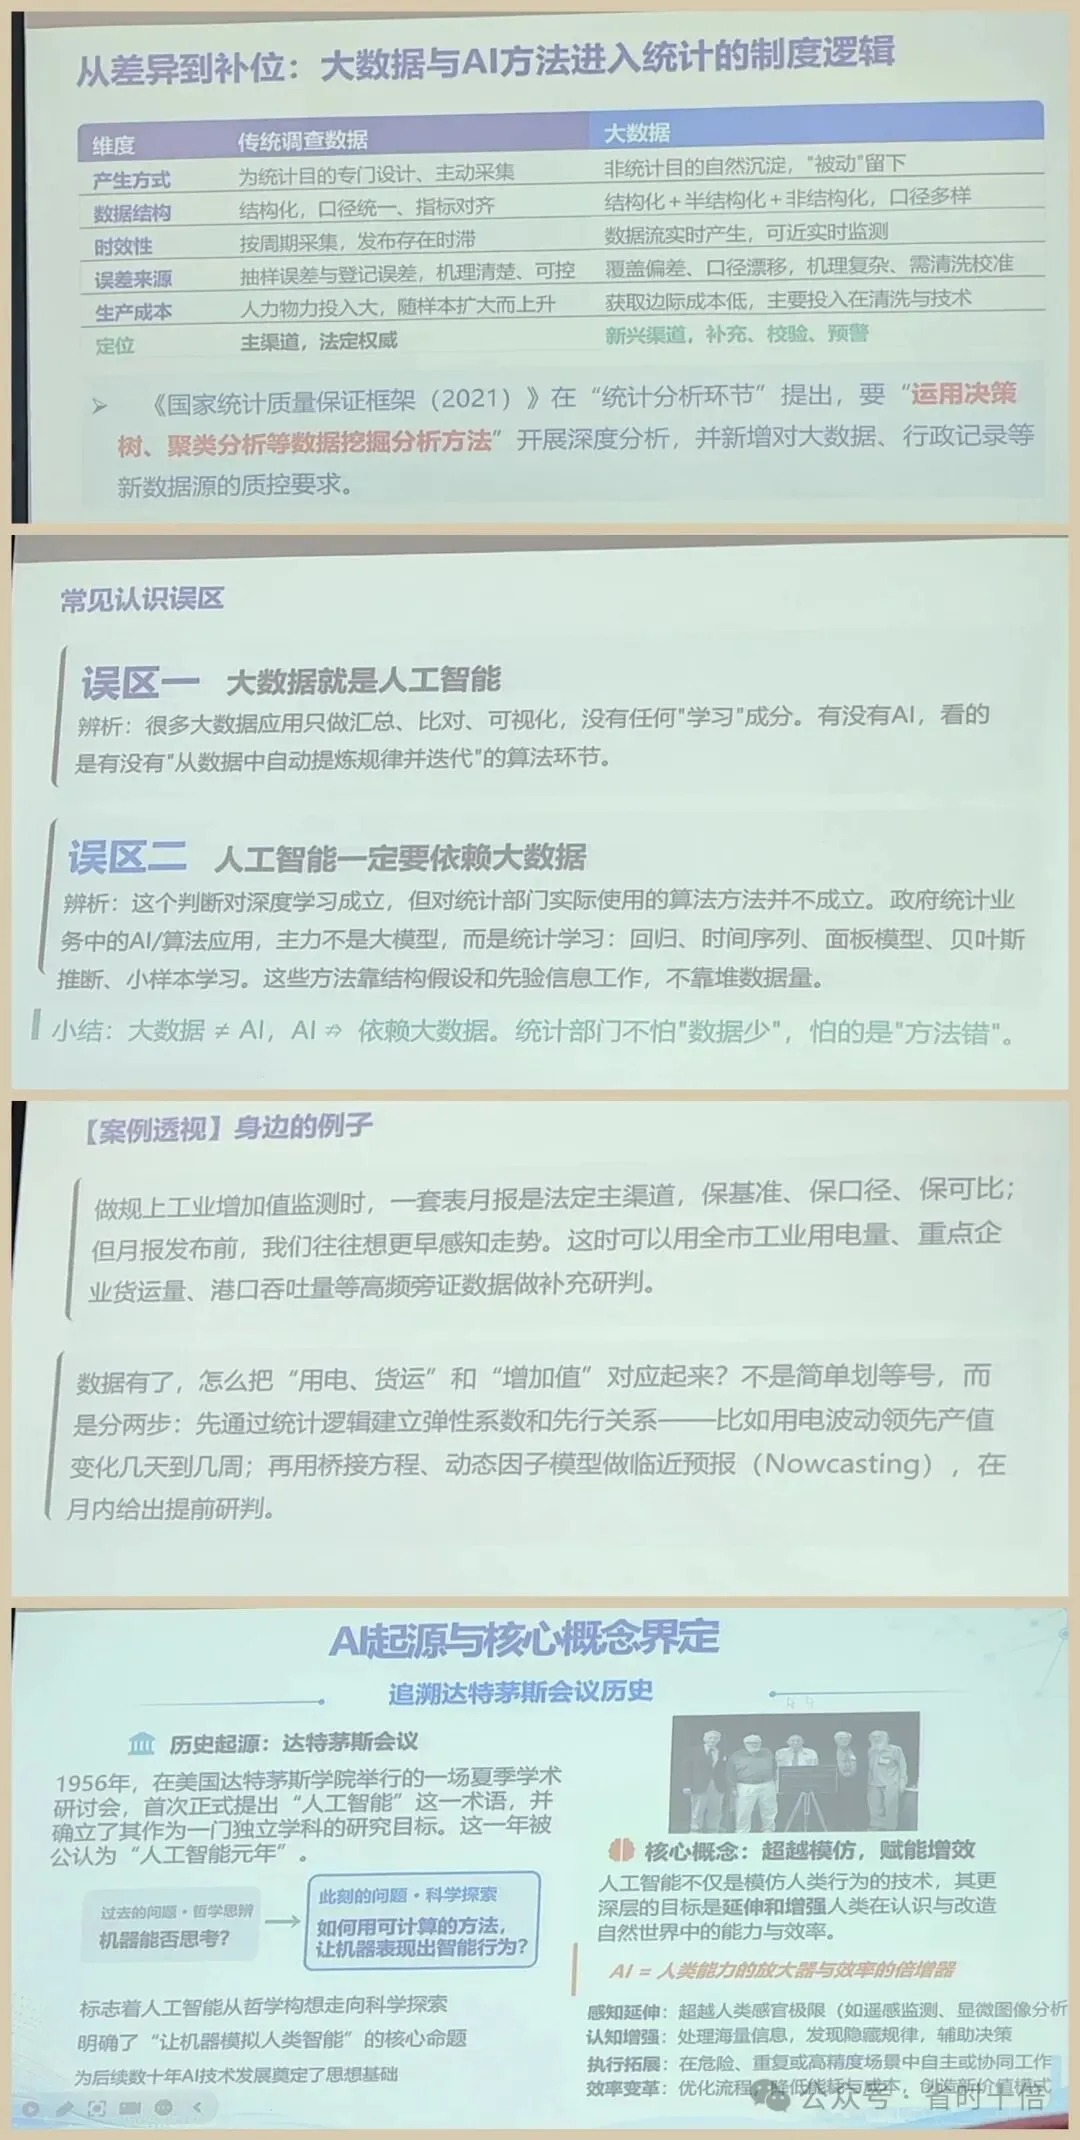
(一)误区一:大数据就是人工智能
辨析:很多所谓“大数据应用”只做了汇总、比对、可视化,并不存在“从数据中自动提炼规律并迭代学习”的算法环节。没有学习环节,就不是人工智能。
(二)误区二:人工智能一定要依赖大数据
辨析:深度学习确实高度依赖大数据;但统计部门常用的是统计学习方法(回归、时间序列、贝叶斯、小样本学习等),依靠模型假设和先验信息,并不需要海量数据。
小结:大数据 ≠ AI,AI 也不一定依赖大数据;统计不怕数据少,怕方法错。
(三)案例:规上工业增加值监测
·法定主渠道:企业表月报,保证基准、口径、可比。
·高频佐证数据:工业用电量、货运量、港口吞吐量。
·建模思路:先确定弹性系数、先行关系,再用桥接方程、动态因子模型做临近预报(Nowcasting),在月报正式发布前提前研判经济走势。
四、AI 起源与统计学的关系
(一)AI 起源时间线
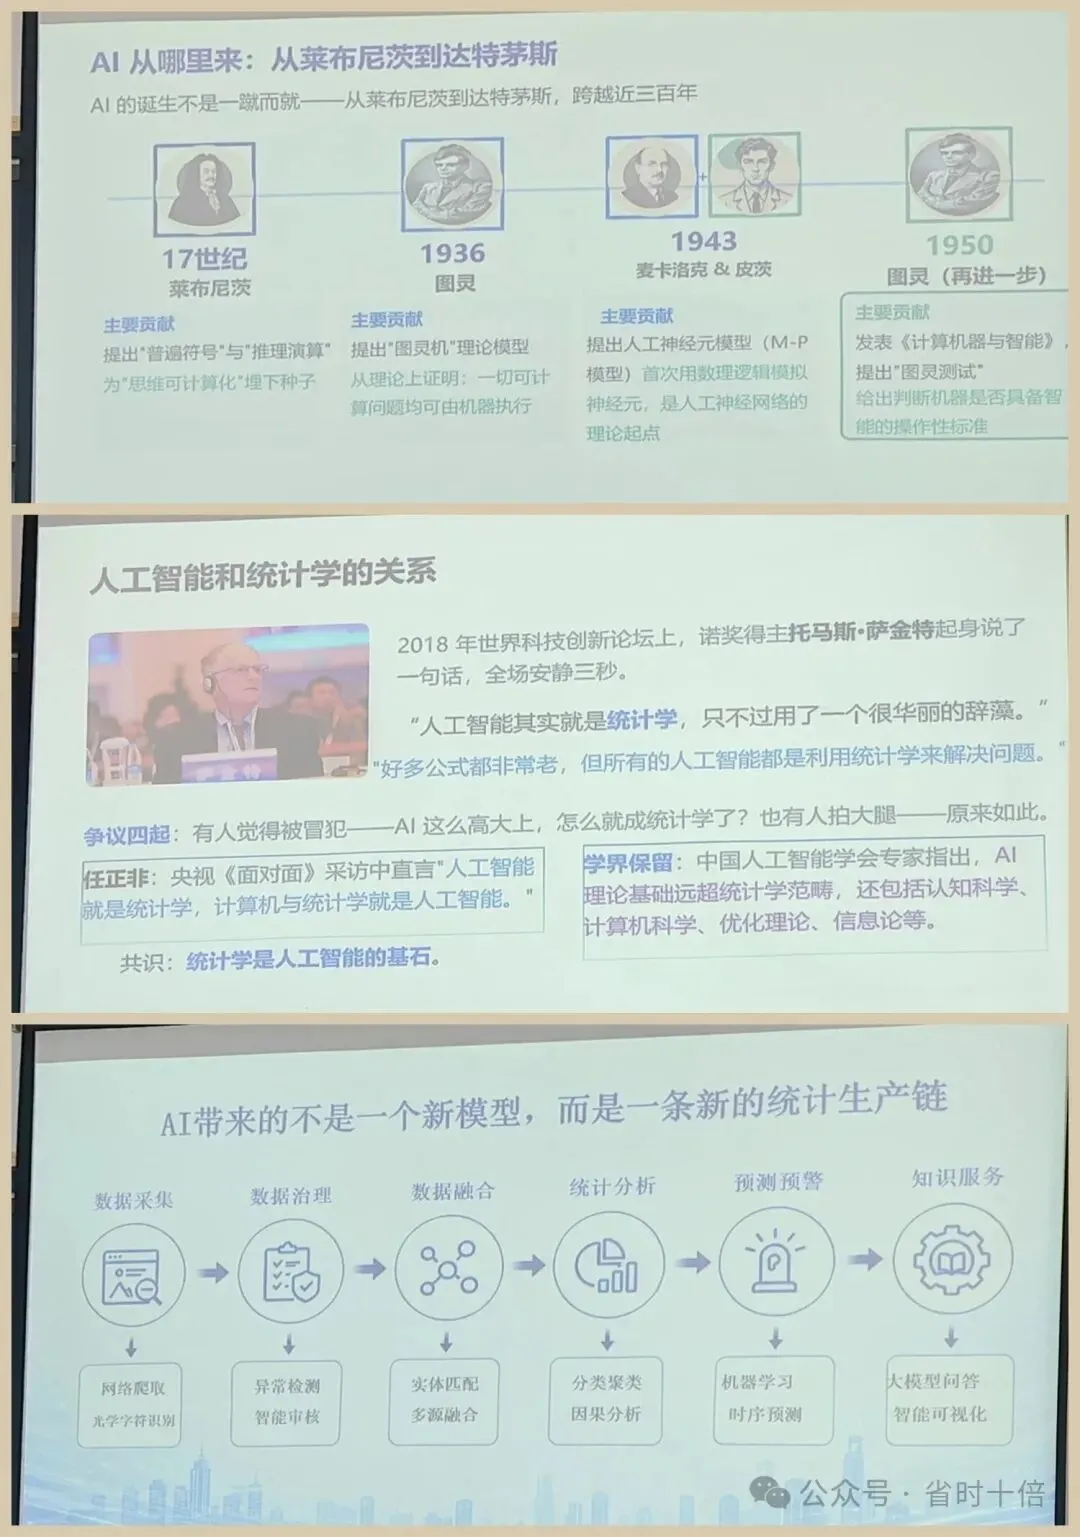
1956年达特茅斯会议正式提出“人工智能”,被称为人工智能元年。
AI 的目标不只是模仿人,而是延伸、增强人的认知能力;AI 是人类能力的放大器。
(二)AI 与统计学的关系
·托马斯·萨金特名言:人工智能其实就是统计学,只不过用了一个很华丽的辞藻。
·学界共识:统计学是人工智能的基石;同时 AI 理论范围更广,还包含计算机科学、认知科学、优化理论等。
(三)AI 重塑统计生产链条
AI 带来的不是单一模型,而是一套全新的统计生产链路:
数据采集(爬虫、OCR)→ 数据治理(异常检测、智能审核)→ 数据融合(实体匹配、多源融合)→ 统计分析(聚类、因果分析)→ 预测预警(机器学习、时序预测)→ 知识服务(大模型问答、可视化)。
五、AI 核心概念框架
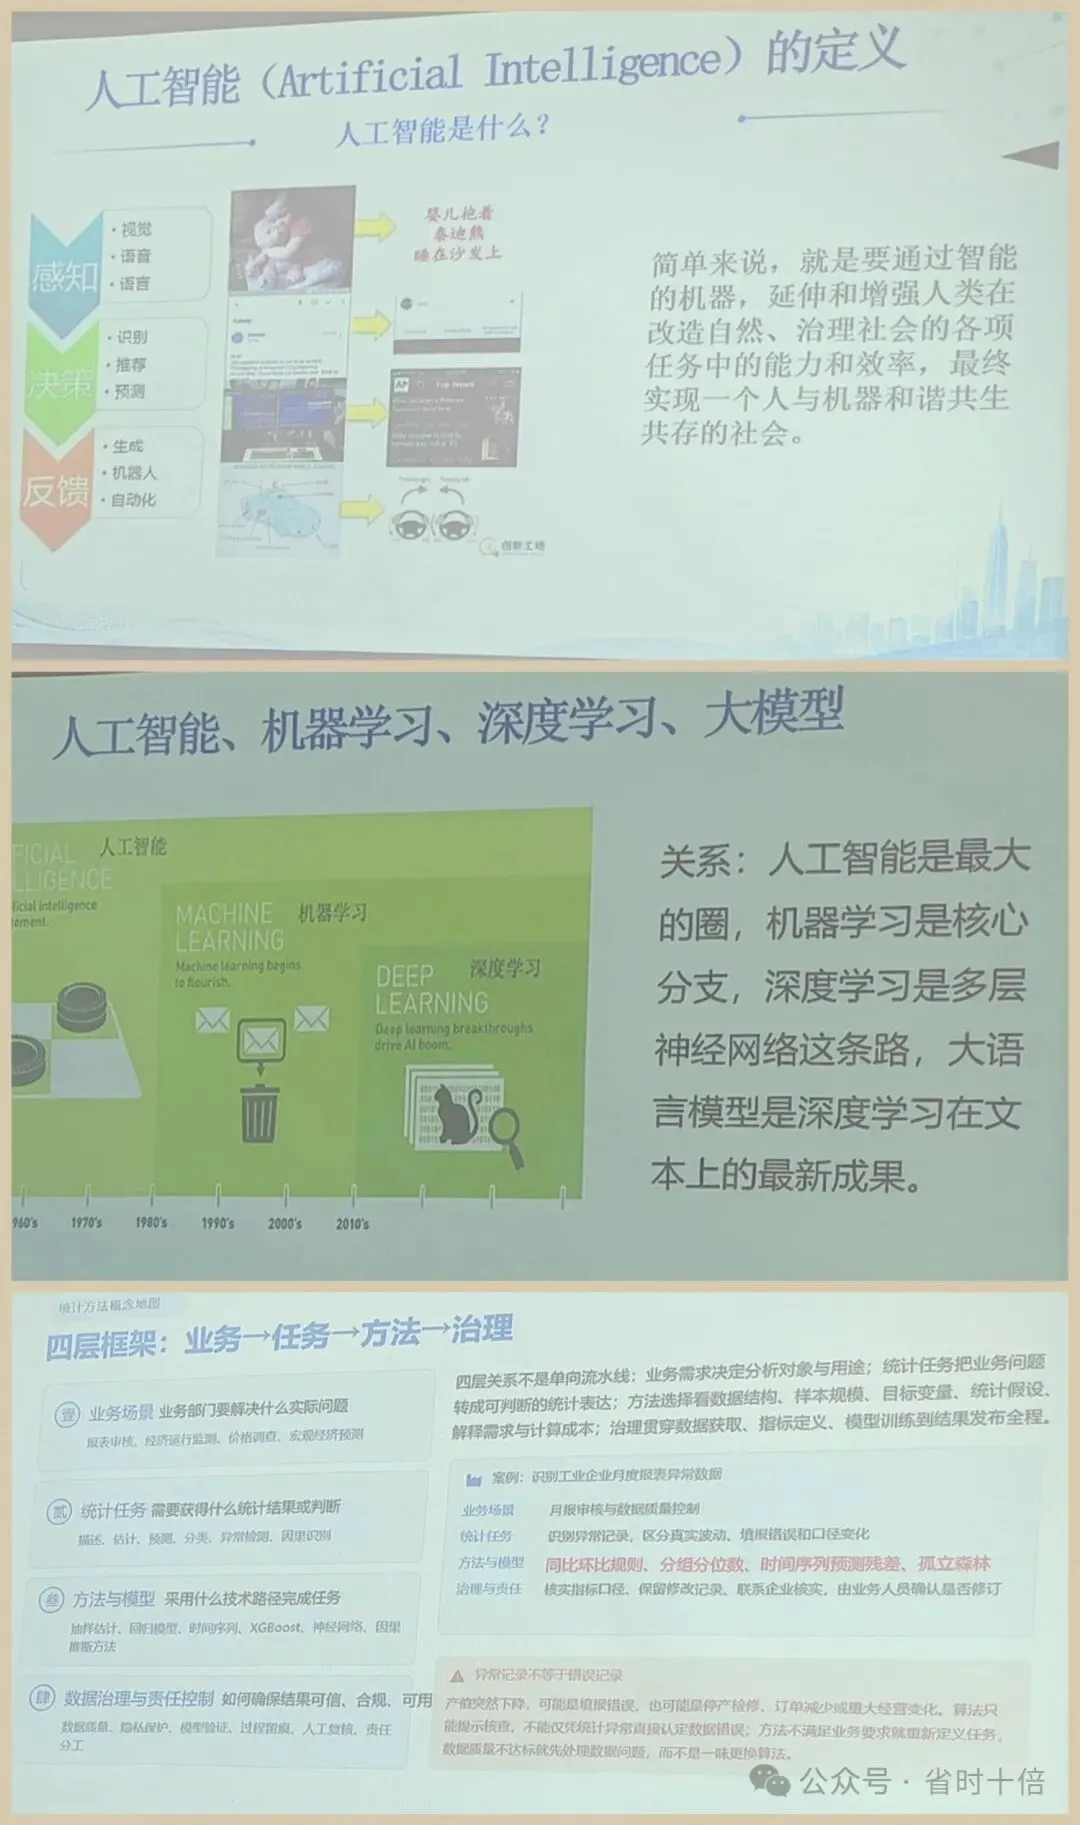
(一)AI 的三层能力
能力层内容
感知计算机视觉、语音识别、自然语言处理。
决策识别、分类、推荐、预测、优化。
反馈内容生成、机器人控制、自动化执行。
AI 的本质:依靠智能机器延伸、增强人类改造和治理世界的能力与效率,最终实现人机和谐共生。
(二)AI / 机器学习 / 深度学习 / 大模型的包含关系
人工智能 ⊃ 机器学习 ⊃ 深度学习 ⊃ 大语言模型。
·AI 是最大范畴。
·机器学习是 AI 的核心分支。
·深度学习是依托多层神经网络的一条技术路线。
·大语言模型(如 BERT、GPT)是深度学习在文本方向上的代表性成果。
(三)四层落地框架:业务 → 任务 → 方法 → 治理
用来规范统计 AI 项目落地,不是单向流水线,而是相互反馈的闭环:
层级回答的问题举例(工业企业月报异常识别)
业务场景统计部门要解决什么真实问题?月报审核、数据质量管控。
统计任务转化成什么统计目标?识别异常记录,区分真实波动、填报错误、口径变动。
方法与模型选择什么技术路径?同比环比规则、分组分位数、时序残差、孤立森林。
数据治理与责任如何质控、保护隐私、明确权责?算法只做提示标记,不能直接判定错误;最终由业务人员确认。
重要边界:异常不等于错误,可能是真实波动;算法输出只是线索,人对最终结果承担专业判断责任。
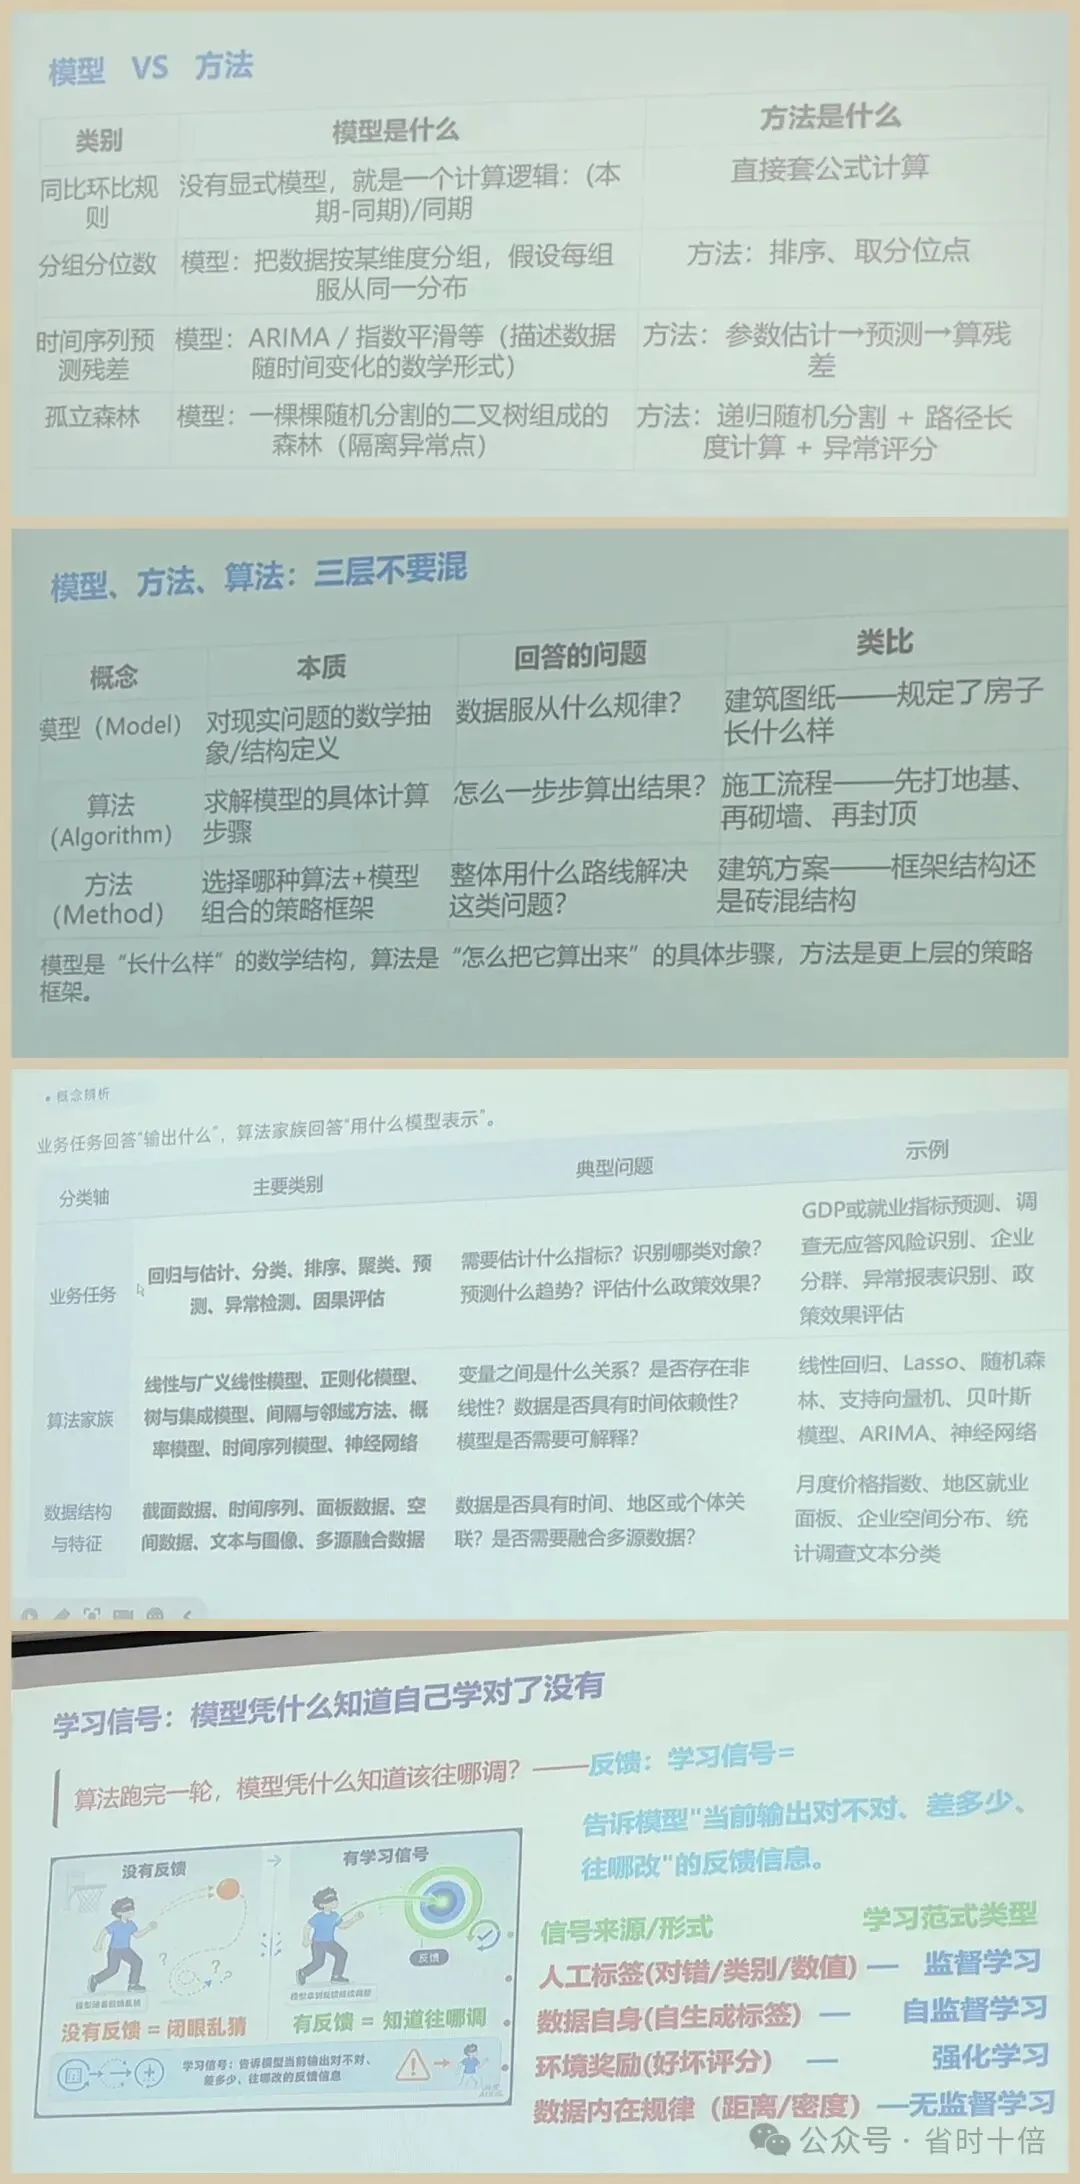
(四)模型、方法、算法三者辨析
术语回答的问题通俗类比
模型 Model数据服从什么规律?(对现实的数学抽象)建筑图纸
算法 Algorithm怎么算出结果?(求解模型的计算步骤)施工流程
方法 Method用什么方案解决问题?(模型+算法的整套策略)建筑方案
举例对照:同比环比规则没有显式模型,直接套公式;分组分位数假设组内分布一致;时间序列残差基于 ARIMA 等数学形式;孤立森林由随机二叉树构成森林模型。
六、机器学习四大范式
(一)四种学习类型对比
学习范式信号来源典型问题例子
监督学习人工打好标签(对错、类别)预测、判别企业行业归类、指标预测
无监督学习无标签,挖掘内在距离与密度聚类、降维、异常探查企业分群、异常线索筛查
自监督学习从数据本身自动构造标签表征学习大模型预训练
强化学习来自环境的奖励/打分信号动态调度与优化资源仿真调度
关键提醒:信号质量决定结果质量。标签错误、奖励机制跑偏、数据有偏,都会让模型出错。通俗比喻——没有反馈等于闭眼投篮瞎猜;有反馈才能知道偏了多少、调整方向。
(二)范式、模型、方法的选择逻辑(三步)
·第一步:看有没有标签 → 确定学习范式(怎么学)。
·第二步:挑选适配模型工具——样本少、需可解释:线性模型、树模型;样本量大、不强制可解释:神经网络;分群用 K-means;降维用 PCA。
·第三步:确定训练策略——数据少:预训练+微调;数据充足:从头训练。
一句话区分:范式是学习的框架规则,模型是计算工具,二者是两个维度,可以自由组合。
(三)易混术语辨析
术语所属类别
异常检测统计任务(要解决的问题),可用规则、孤立森林等多种方法实现。
DML 双重机器学习因果推断估计框架,用来估计因果效应。
BERT预训练语言模型,是工具,不是固定任务。
差分隐私隐私保护框架,管控信息泄露风险,不直接做预测识别。
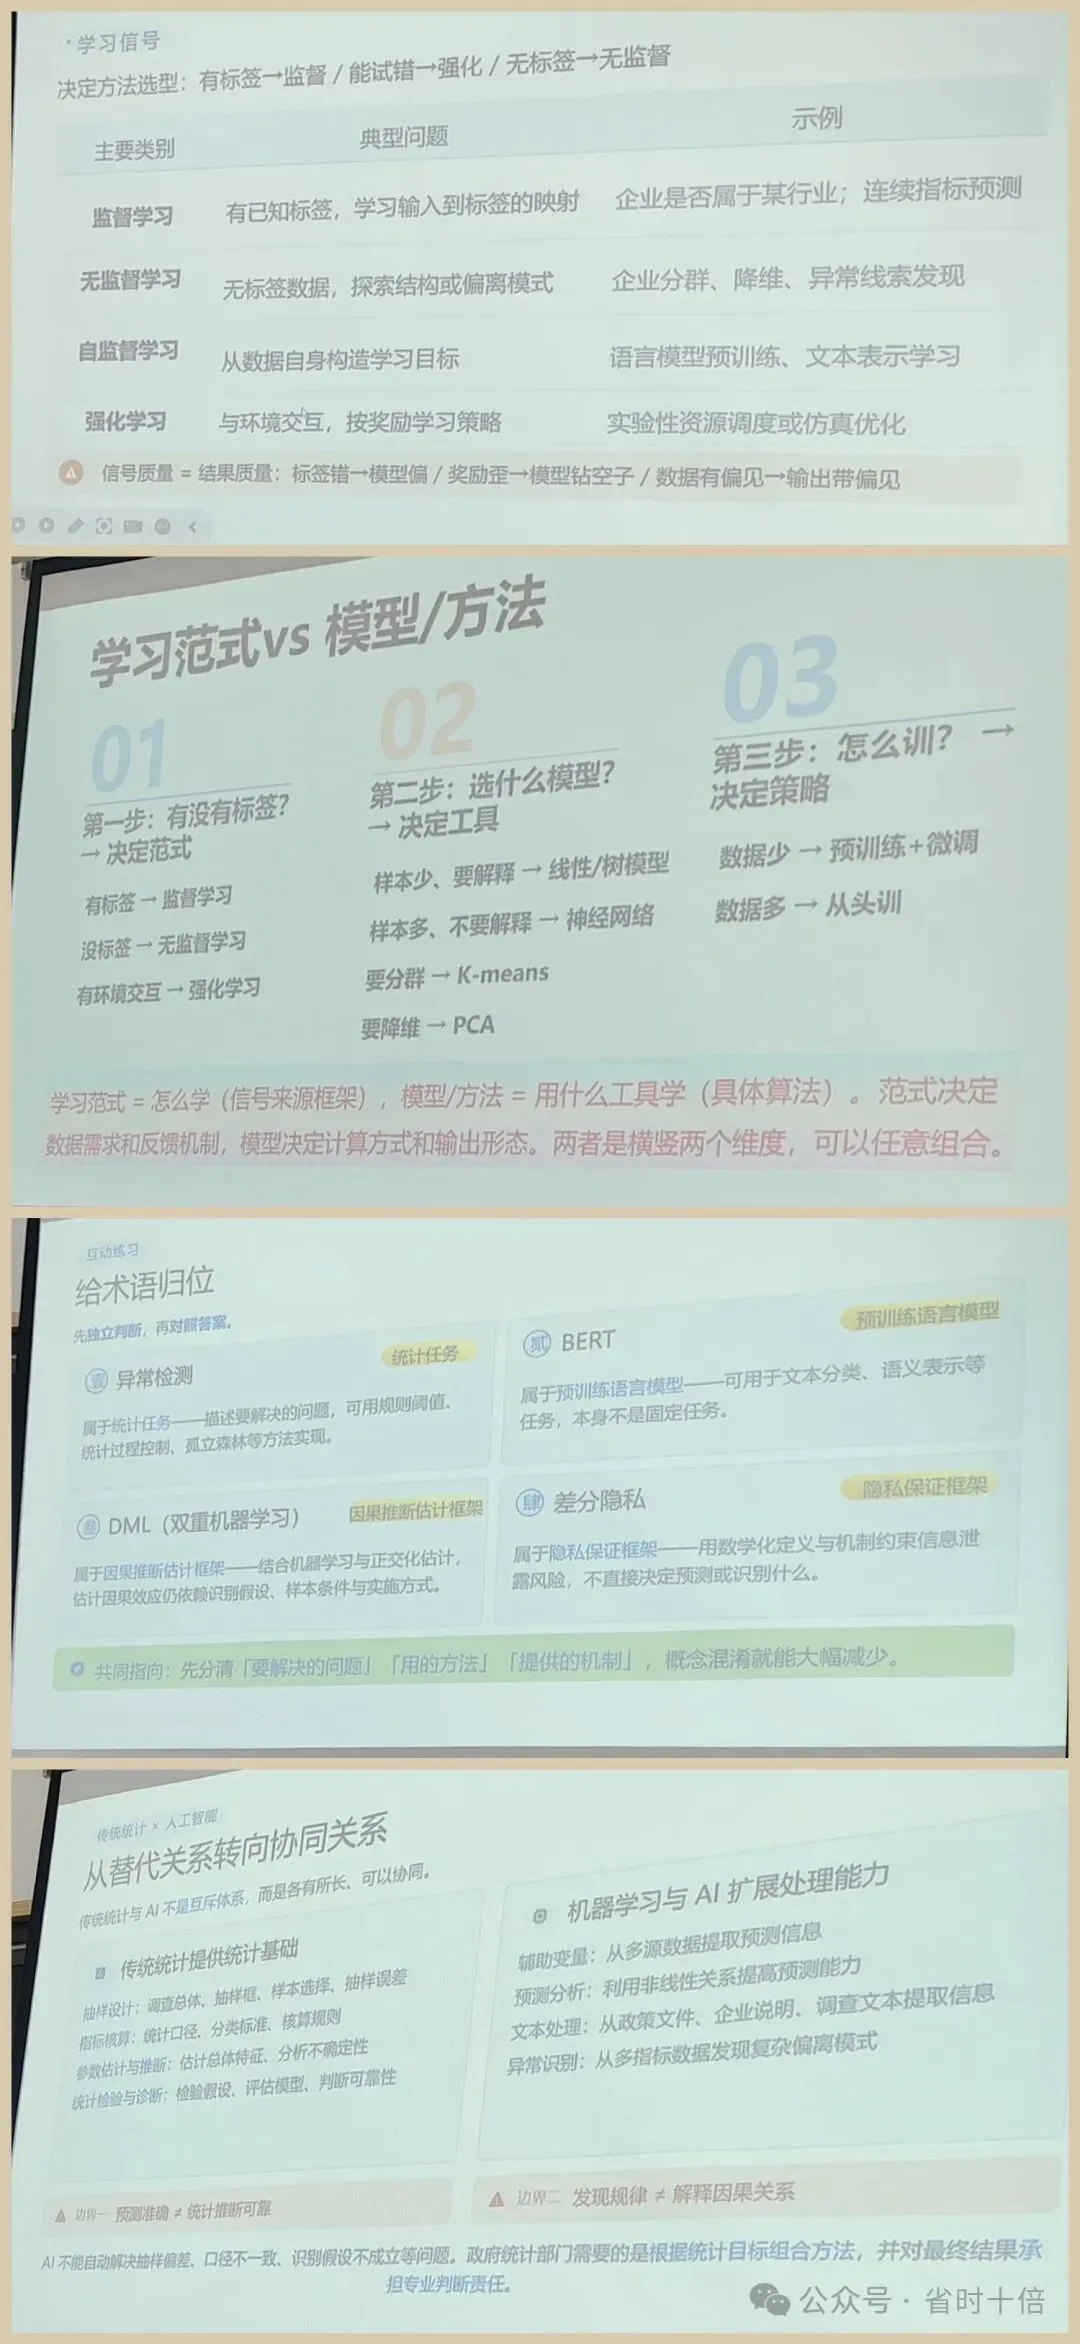
七、传统统计与 AI:协同互补而非替代
(一)各自价值
·传统统计的价值底座:抽样设计、指标核算、参数推断、假设检验、不确定性分析,保证规范性和可解释性。
·机器学习/AI 的扩展能力:挖掘多源辅助信息、捕捉非线性关系、文本信息提取、复杂模式的异常识别。
(二)两个重要边界
·预测准确 ≠ 统计推断可靠。AI 解决不了抽样偏差、口径不一致这类统计基础问题。
·发现相关性规律 ≠ 找到因果关系。相关不等于因果,因果需要额外的假设和识别策略。
政府统计思路:按需组合方法,人对最终结果承担专业判断责任。
八、监督学习基础
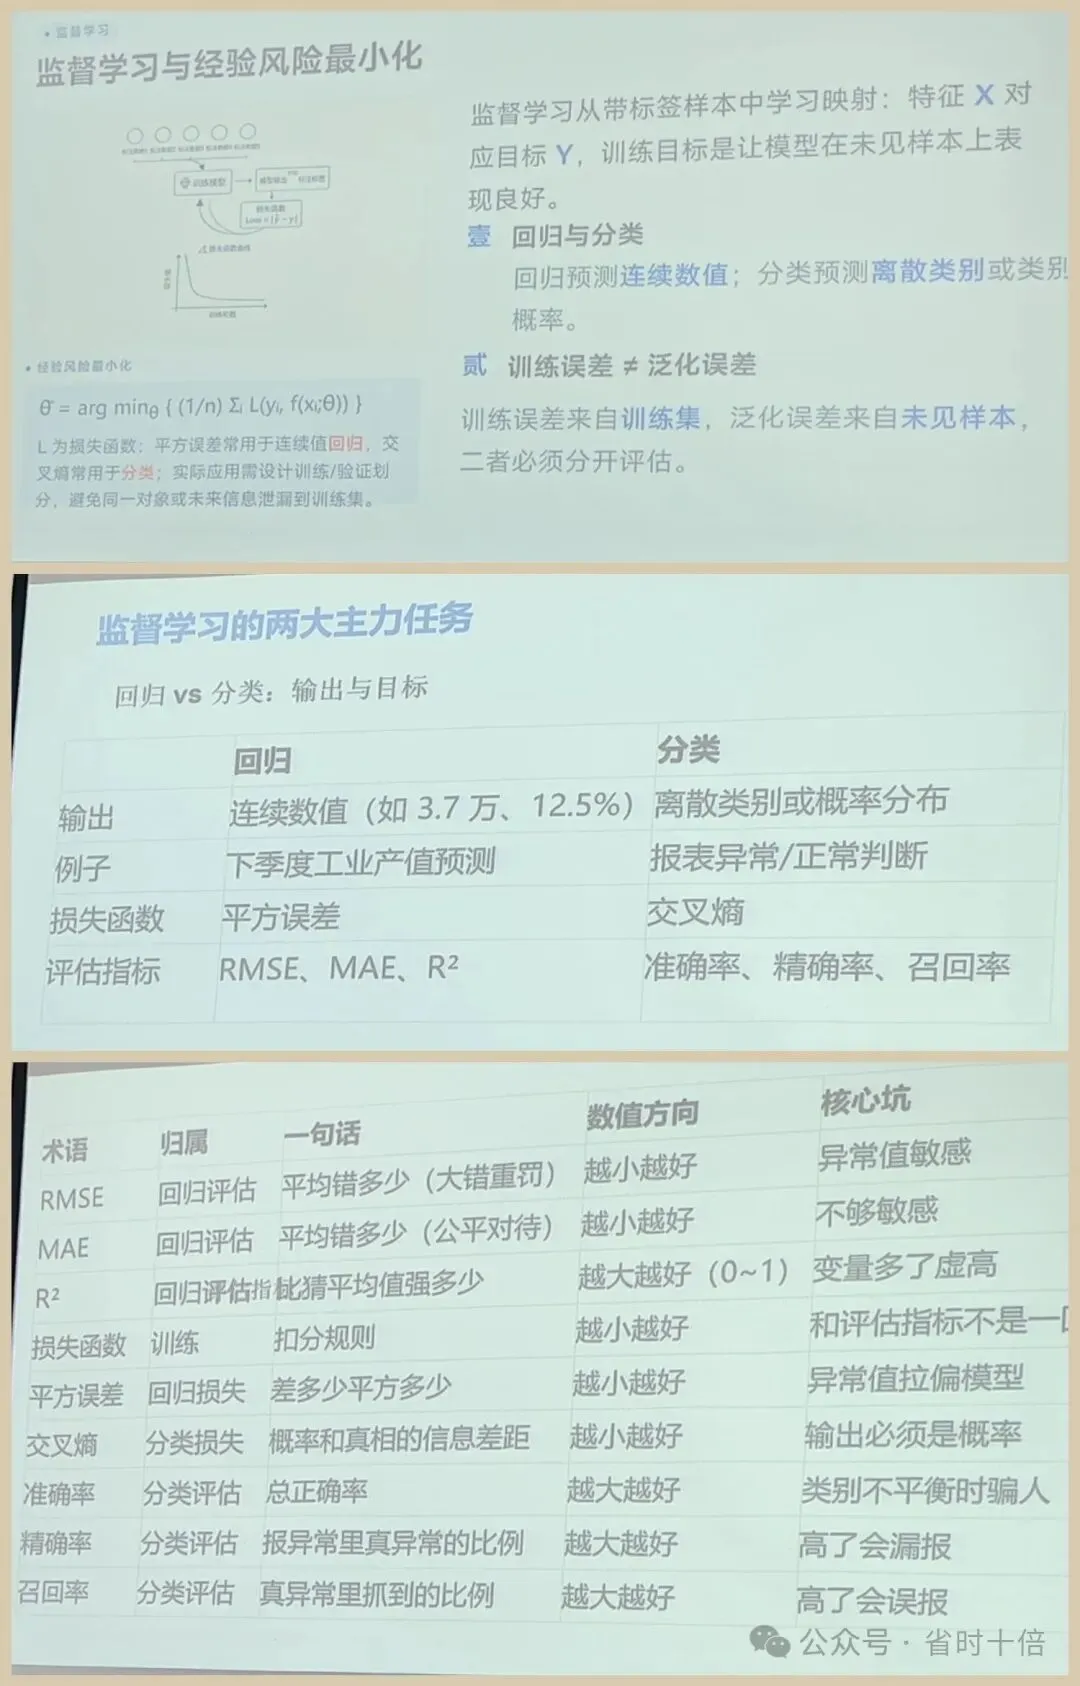
(一)经验风险最小化
监督学习的目标:从带标签数据中学到特征 X 到目标 Y 的映射 f,追求在没见过的新样本(泛化)上表现良好。
关键区分:训练误差 ≠ 泛化误差。训练误差是模型在训练集上的误差;泛化误差是模型在新样本上的误差。必须划分训练集、验证集,防止信息泄露和过拟合。
(二)回归 vs 分类
维度回归分类
输出类型连续数值离散类别 / 概率
典型示例工业产值预测报表是否异常判断
损失函数平方误差交叉熵
评估指标RMSE、MAE、R²准确率、精确率、召回率
(三)评估指标通俗解读与常见坑
·RMSE:平均误差,放大大偏差,对异常值敏感。
·MAE:平均绝对误差,平等对待所有偏差,对异常值不敏感。
·R²:对比均值基准的解释能力;变量越多越容易虚高。
·准确率:整体正确率;类别不平衡时具有欺骗性。
·精确率:判定为异常的样本中真实异常所占比例;太高容易漏检。
·召回率:真实异常中被成功抓到的比例;太高容易误报。
九、常用模型方法速览
(一)线性回归与正则化
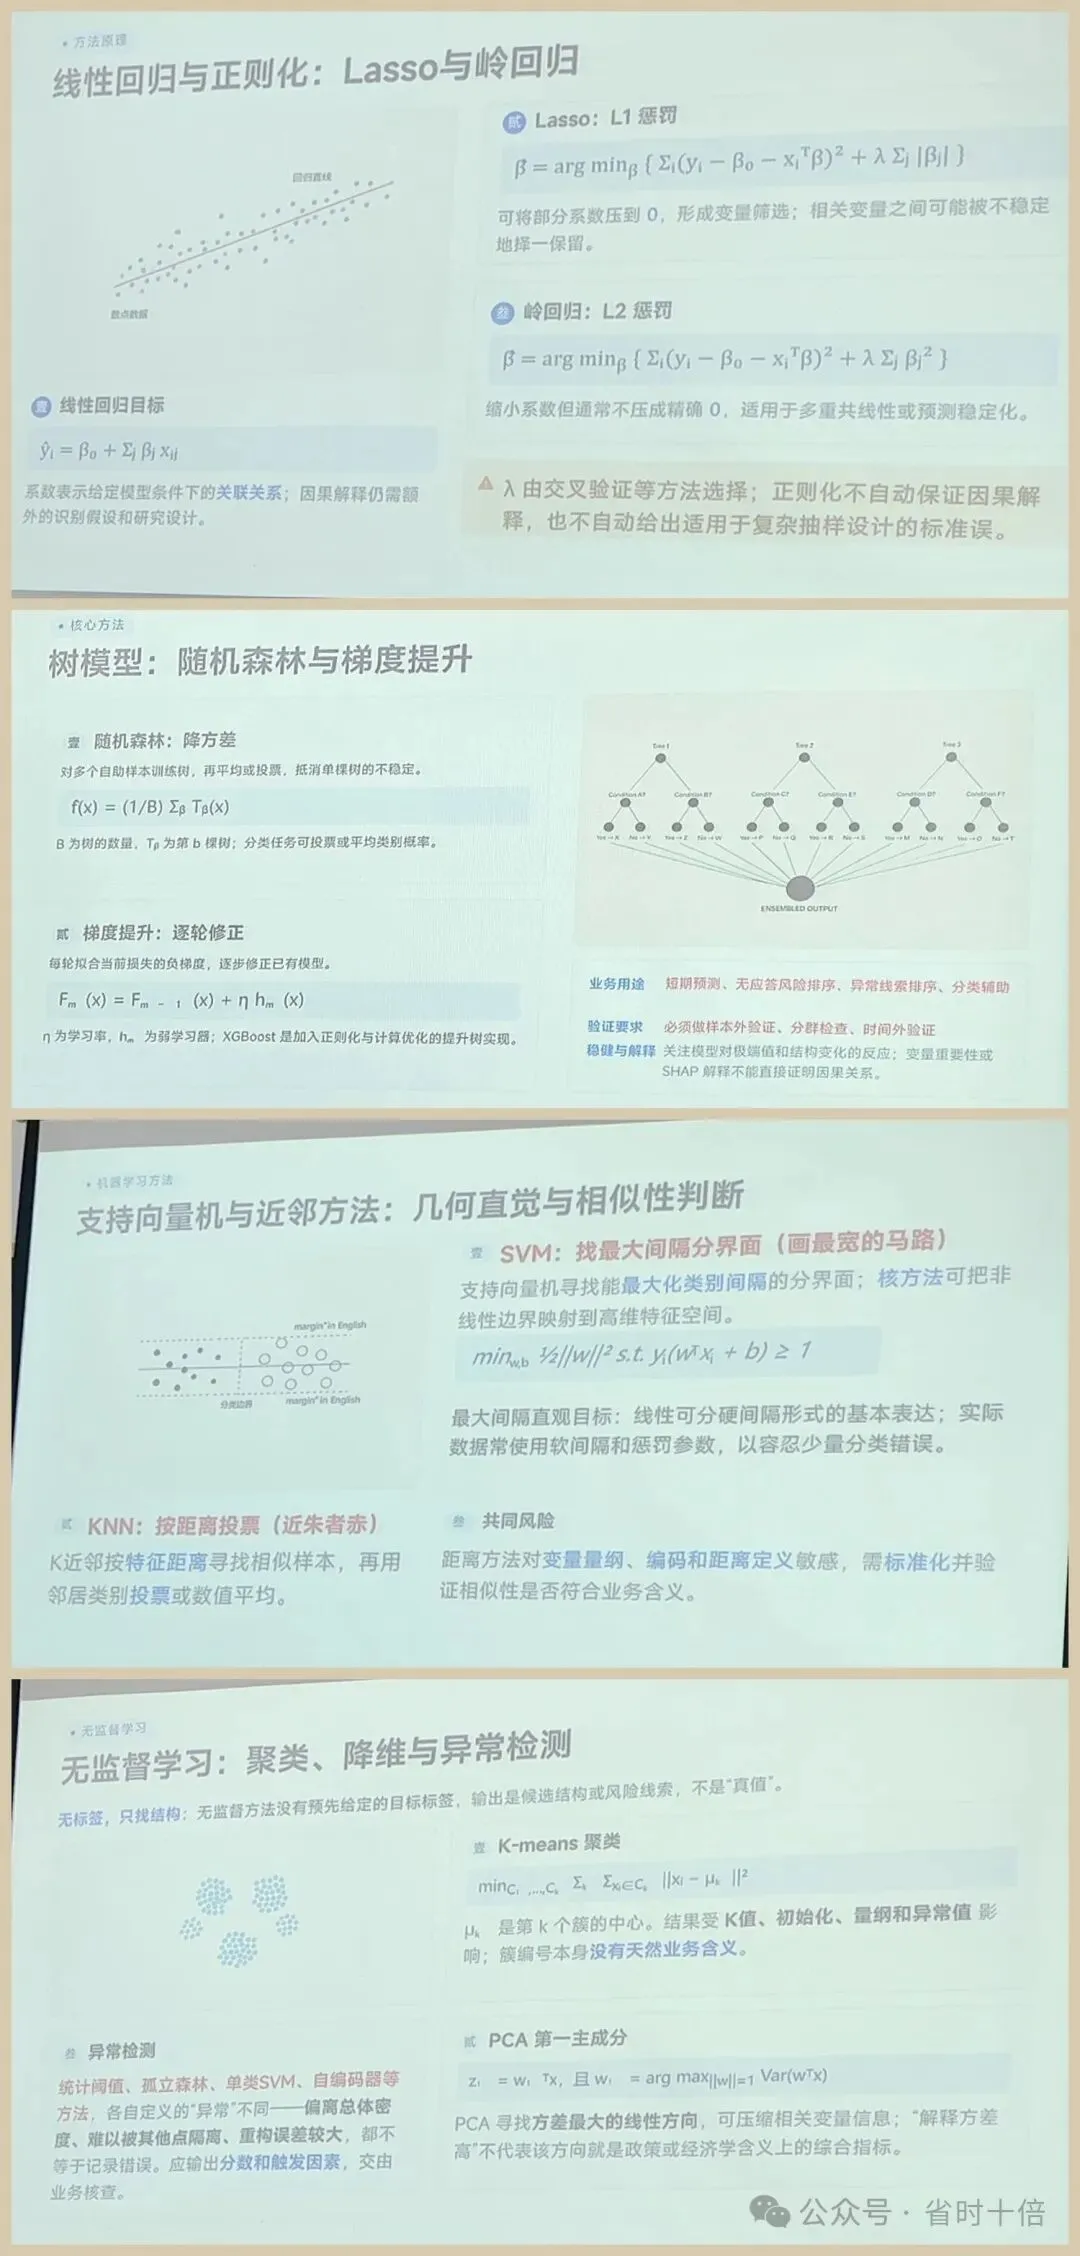
基础线性回归:ŷ_i = β_0 + Σ β_j x_ij。它只刻画条件关联关系,不能直接当作因果解释,因果需要额外假设。
1. Lasso(L1 惩罚)
目标:最小化 Σ(y_i - β_0 - x_iᵀβ)² + λ Σ|β_j|。特点:可将部分系数压缩到 0,自动筛选变量;但相关变量之间不稳定,只保留其中一个。
2. 岭回归(L2 惩罚)
目标:最小化 Σ(y_i - β_0 - x_iᵀβ)² + λ Σ β_j²。特点:只缩小系数,一般不会压成 0;适合解决多重共线性,稳定预测。
注意:正则化参数 λ 通过交叉验证选择;正则化本身不保证因果解释,也不会自动适配复杂抽样标准误。
(二)树集成模型
1. 随机森林(降方差)
对多个自助样本分别训练单棵树,再投票或平均预测,抵消单棵树的不稳定性:f(x) = (1/B) Σ T_b(x)。
2. 梯度提升(逐轮修正)
不断拟合当前模型残差的负梯度,迭代更新:F_m(x) = F_{m-1}(x) + η h_m(x),其中 η 是学习率,h_m 是弱学习器。XGBoost 就是加入正则化与优化的梯度提升实现。
统计业务用途:短期预测、风险排序、异常线索筛查、分类辅助。验证要求:样本外验证、分群验证、时间外验证;SHAP 只能解释模型,不能证明因果。
(三)SVM 与 KNN
·支持向量机(SVM):寻找最大间隔分类超平面(通俗说就是画出最宽的分隔马路),核方法可将非线性问题映射到高维空间。
·K 近邻(KNN):近朱者赤,按特征距离找邻近样本,用邻居投票或平均做预测。
共同风险:对量纲和距离定义非常敏感,必须做标准化,并且要确认距离定义符合业务含义。
(四)无监督学习
无标签,只找结构;输出只是线索和结构,不是真实标准答案。
·K-means 聚类:最小化簇内距离平方和;结果受 K 值、初始点、异常值影响大,簇编号本身没有业务含义。
·PCA 主成分分析:寻找方差最大的线性方向压缩变量信息;方差最大 ≠ 经济意义最重要。
·异常检测:孤立森林、单类 SVM、自编码器等;异常 ≠ 错误,可能是真实波动,只输出风险线索,必须交业务核查。
(五)深度学习与强化学习
1. 深度学习
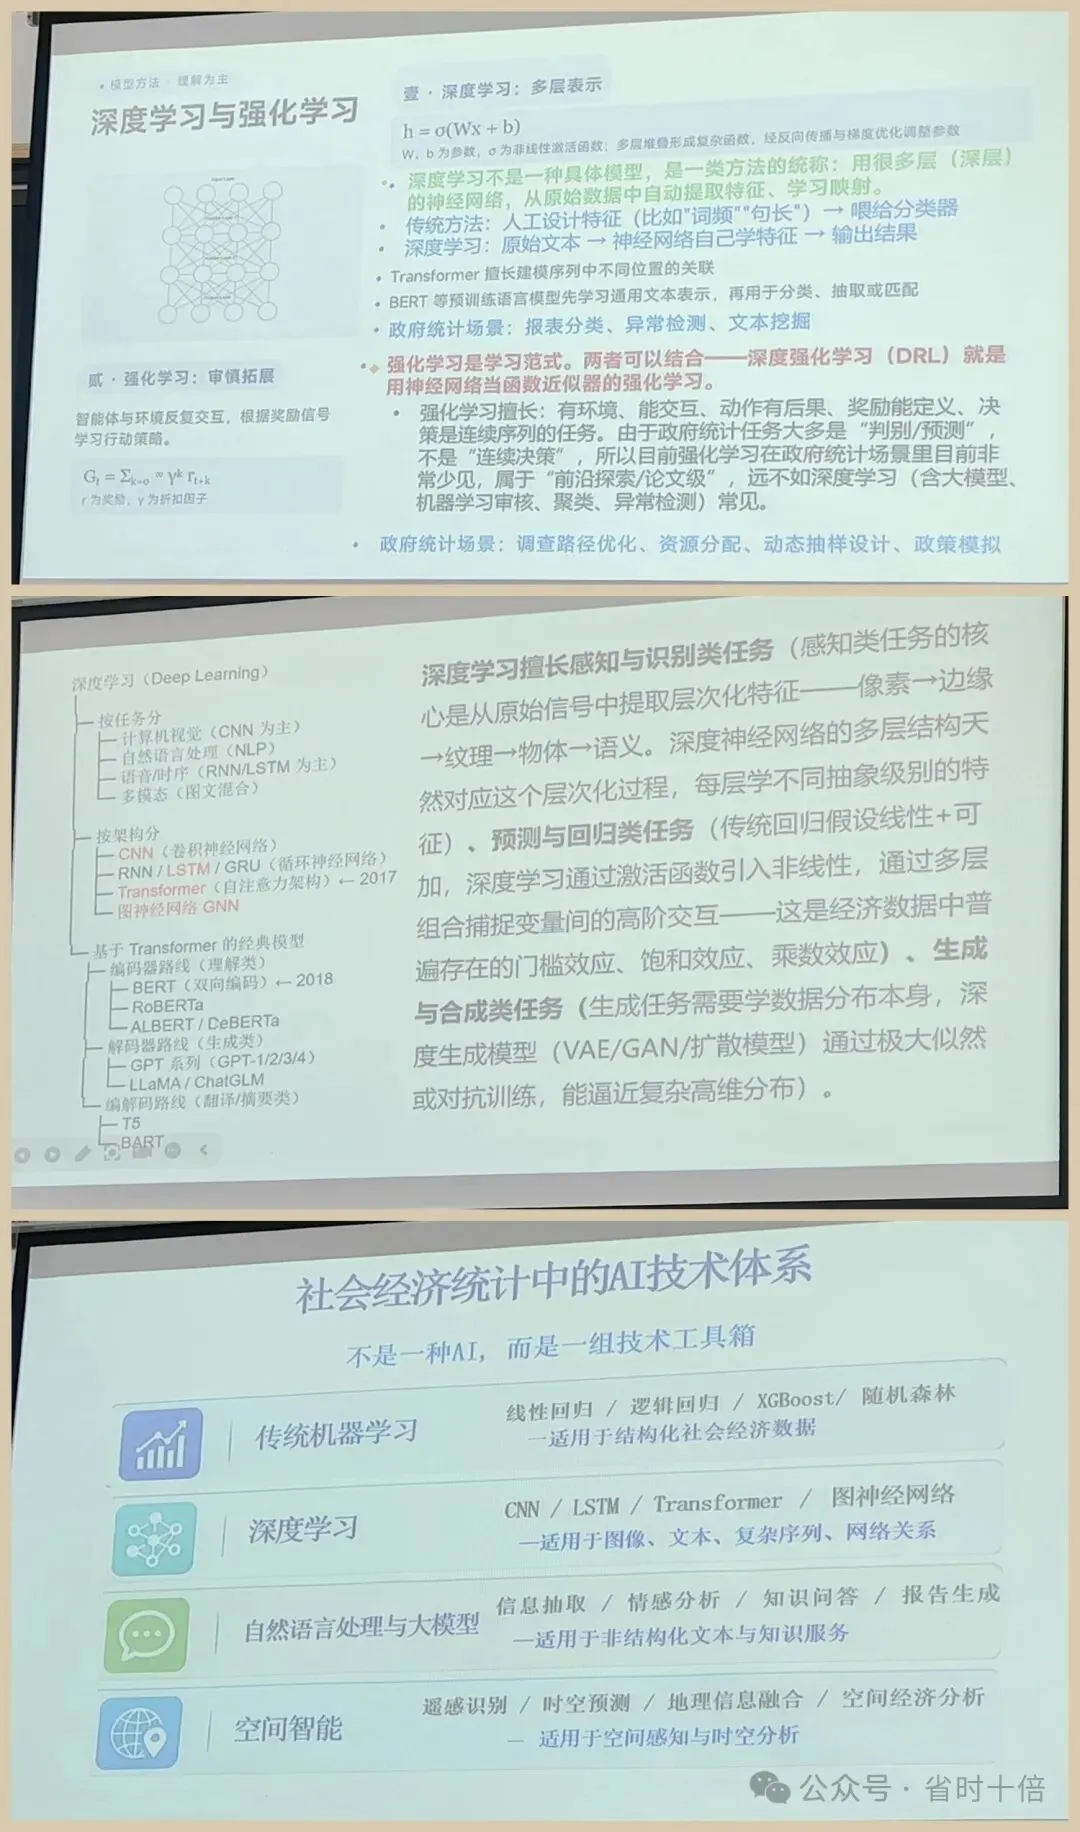
本质是多层神经网络,自动提取分层特征;激活函数引入非线性。主流架构:CNN(图像)、RNN/LSTM(时序)、Transformer(自然语言,BERT、GPT 均基于此)、GNN(图网络)。在统计中适合报表文本分类、文本挖掘、复杂非线性预测。
2. 强化学习
智能体与环境交互,依靠奖励信号学习策略:G_t = Σ ω^k r_{t+k},其中 r 为奖励,ω 为折扣因子。政府统计场景:调查路径优化、资源分配、动态抽样、政策模拟。局限:统计大多是判别、预测任务,连续决策场景不多,应用不如大模型和树模型普及。
深度强化学习(DRL):将深度学习当作函数近似器的强化学习。
3. 深度学习任务分类
·感知识别:CNN 处理图像、语音时序。
·预测回归:多层网络捕捉高阶交互、门槛效应、乘数效应。
·生成任务:VAE、GAN、扩散模型,学习数据分布、合成数据。
十、社会经济统计 AI 技术工具箱
技术类别代表方法适用数据
传统机器学习线性回归、XGBoost、随机森林结构化统计表格数据
深度学习CNN、LSTM、Transformer、GNN图像、长文本、时序、网络关系
NLP + 大模型信息抽取、报告生成、问答政策文件、问卷文本等非结构化文字
空间智能遥感、时空预测、地理融合区域经济、空间统计分析
结语:核心要点回顾
·大数据和 AI 不会取代传统统计调查,而是互补补位、协同生产。
·统计学习是 AI 在政府统计落地的核心工具,重塑整个统计业务流程。
·预测准确不等于推断可靠,发现相关不等于找到因果。
·AI 输出只是线索和辅助,人对最终统计结果承担专业判断责任。
·范式(怎么学)、模型(用什么学)、方法(怎么组合)是三个独立维度,按需选择。