ARTICLE · 1284755
知识库的文档究竟该怎样切,固定长度、递归切分还是按结构切分?
假设一份设备手册写着:“正常工作温度为 0 至 40 摄氏度。环境温度超过 35 摄氏度时,设备必须降低负载。”用户问设备在 38 摄氏度时能否满负载运行,知识库如果只找回第一句话,模型就可能给出错误建议。
原文没有缺失,限制条件却没有进入回答。这类问题常发生在文档切分之后,系统虽然找到了相关片段,却没有同时拿到判断所需的条件。
文档切分的核心,是让系统既能定位相关内容,又能取回足以支持回答的完整证据。固定长度、递归切分和按结构切分,分别用长度、分隔符层级和文档组织来决定边界,三种方法也可以结合使用。
我们不必先寻找一个适合所有文档的切块长度,而更有用的是先检查:用户常问什么问题,答案依赖哪些内容,这些内容在切分后还能不能一起被找到?
01、知识库为什么要切块,边界又为什么重要
在常见的检索增强生成流程中,程序先把文档解析成可处理的内容,再将内容分成片段并建立索引。用户提问后,检索系统寻找相关片段,程序把选中的内容交给模型,模型据此组织回答。
切分不仅是为了避开模型输入长度的限制。一份文档可能同时讨论安装、使用和维护,程序如果只给整篇文档建立一个向量表示,不同主题可能混在一起,具体问题也就不容易对应到清晰的检索单元,Azure AI Search 的文档也解释了这一原因。
片段过大时,检索系统可能把许多无关内容一起找回,模型需要从中继续筛选。片段过小时,系统又可能把条件、对象或解释留在别处,设备手册中的温度范围与降载要求就属于需要关联阅读的内容。
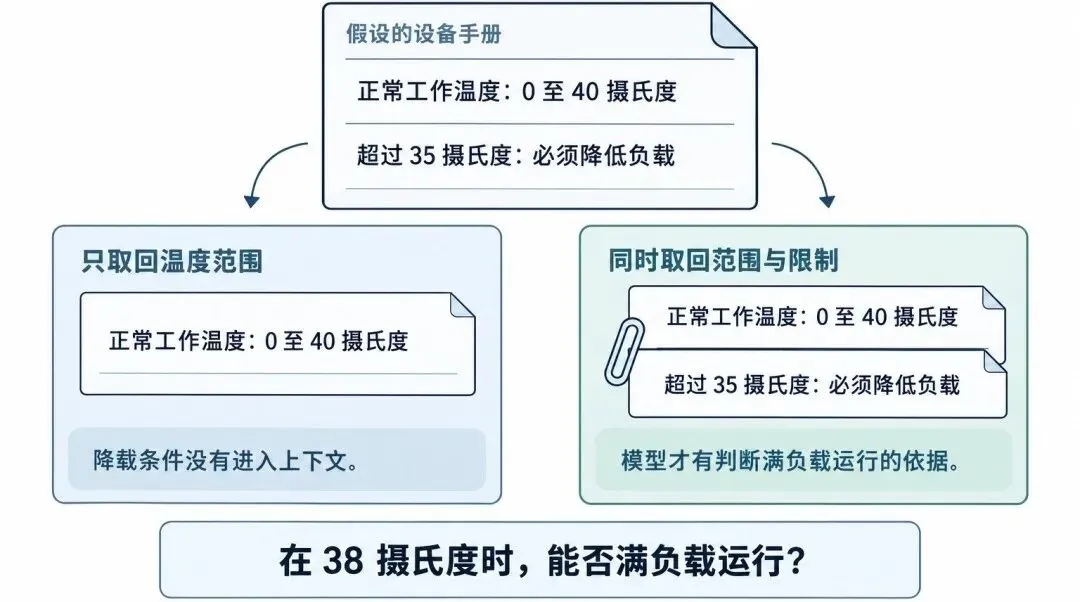
设备手册假设例子中的范围与限制。
切分前还有一项更基础的检查:解析结果是否正确。如果程序把双栏文字读串,把页眉插入正文,或者把表头与数据分离,后续算法面对的已经是错误内容,开发者单独调整切块长度无法恢复原来的阅读关系。
02、固定长度:边界容易控制,意思却未必完整
最直接的方法,是让程序沿着文本按预设长度依次取出片段,必要时让相邻片段保留一部分重复内容。程序只需要知道从哪里开始、取多长,就能完成基础切分,这种严格按长度截取的方式便于实现和检查。
长度单位必须先说清楚。字符数与 Token 数不是一回事,开发者如果希望控制嵌入模型的输入,就应该使用相应的分词方式计数,并把附加标题等内容一起算入预算,不能把“500 字符”和“500 Token”当成相同设置。
固定位置不会自动理解句子关系。设备手册中的工作温度与降载条件如果落在两个片段中,检索系统可能只返回其中一个,模型即使认真依据收到的文字作答,也可能漏掉限制。
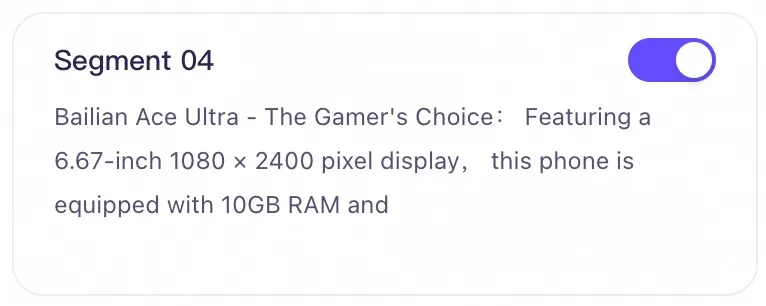
官方文档展示的语义截断片段
对于已经整理得比较均匀、相邻内容依赖较少的文本,固定长度可以作为容易复现的起点。团队需要记下具体单位、边界规则和重叠设置,后面比较其他方法时,团队才知道结果变化来自哪里。
03、递归切分:先尊重自然边界,过长内容再细分
固定长度暴露的问题,是预设位置可能落在一句话或一个段落中间。递归切分会先按较大的自然边界处理文本,例如段落分隔,再对仍然过长的部分使用更细的分隔符,直到内容满足长度要求或进入最后的兜底切分。
递归切分通常不需要模型判断语义。以 LangChain 的递归字符切分器为例,程序按配置的分隔符顺序拆分文本,再组合较小片段,开发者还可以指定长度计算方式。
中文配置需要单独检查。中文正文通常不用空格分词,开发者应根据材料加入中文句号、问号、换行等边界,否则,算法即使名字里有“递归”,程序仍可能退到逐字符处理。
自然边界可以减少随意截断,但标点没有告诉程序所有业务关系。如果工作温度和降载要求位于相邻两段,程序按段落切开以后,条件依赖仍然存在,团队还要结合重叠或检索后的上下文扩展来处理。
我更愿意把递归切分作为普通长文本的基线。程序比严格定长多利用了一层文本组织,维护成本也相对可控,但开发者需要检查实际产物,不能只根据方法名称判断语义是否完整。
04、按结构切分:让标题、条款和内容保持关系
递归切分主要识别文字中的分隔符,按结构切分则进一步利用文档已有的组织。程序可以先识别标题、章节、列表、表格和代码块,再围绕这些单元形成片段,并保留相应的标题路径。
假设降载要求位于“运行条件—温度限制”这一节,程序可以把同节内容组织在一起,或把标题路径附到较小片段上。检索系统因此多了一些判断主题的信息,模型也更容易看清一段话属于哪种设备、哪一类条件。
结构提供了依据,但章节大小未必适合直接检索。一个章节可能只有几行,也可能长达数十页,程序仍需要对过长单元继续拆分,并考虑合并主题一致的小单元,这也是结构与长度规则经常结合的原因。
Docling 的 HybridChunker就体现了这种组合思路:系统先利用文档结构生成片段,再根据 Token 预算拆分过大的内容,并在符合条件时合并较小内容。Docling 还提供把标题等元数据加入片段文本的方式,供嵌入或生成模型使用。
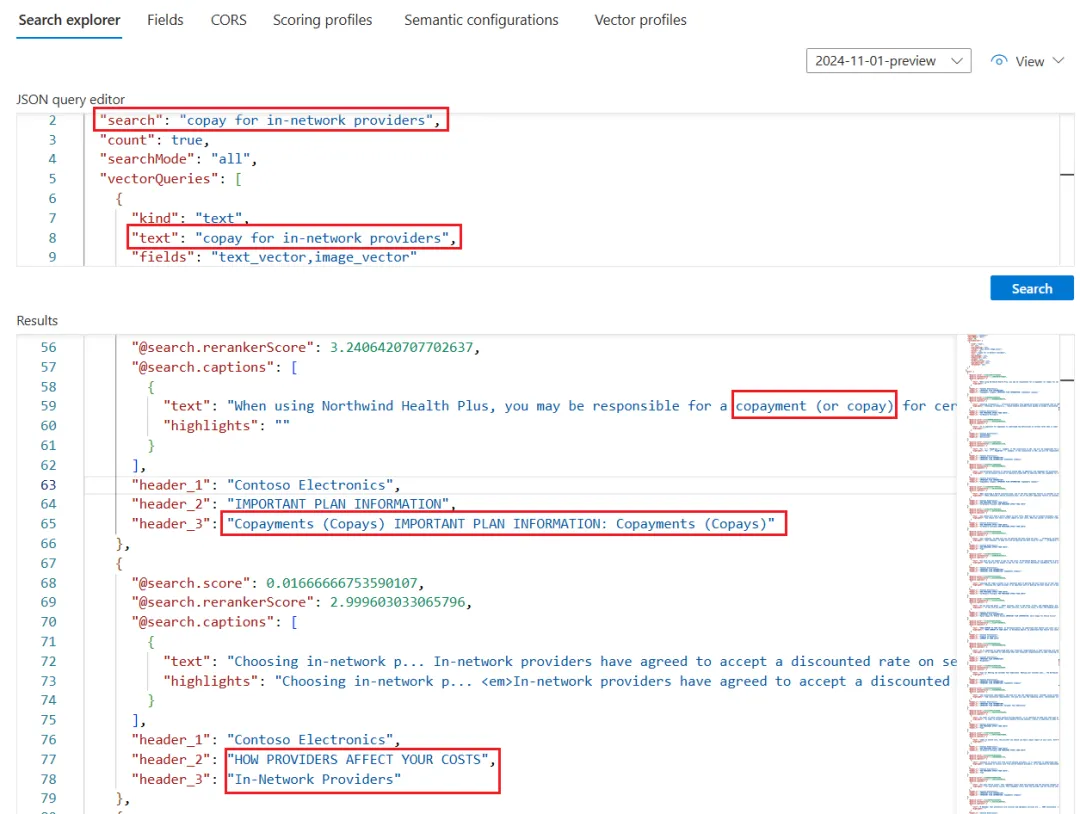
官方示例中保留标题层级的检索结果
结构化材料需要保住各自的解释关系。程序拆分长表格时要考虑列名、单位和相关说明,程序处理代码时要尽量保留函数与必要注释,程序整理条款时则要检查适用对象与例外条件,页码本身通常不能替代这些关系。
这种方法更适合标题可靠、内容层次明确的手册、规范和报告。如果文档解析器把标题认错,后续切分也会继承错误,所以团队需要把结构识别质量和切分效果一起检查。
05、重叠与父子片段,分别补上哪一部分上下文
三种方法都可能遇到跨边界的依赖,开发者可以先判断相关条件离得有多远。如果必要内容紧挨着边界,程序让相邻片段共享一部分文字,有机会让检索结果同时带回两边信息,这就是重叠。
重叠有明确成本。相同文字会进入多个片段,索引和向量化开销可能增加,检索结果也可能被相近片段占满,程序还需要去重或合并,避免模型反复读取同一段话。
重叠也不能保证补齐所有条件。如果一条规定的定义在前一章、例外在附录,开发者继续增加重叠可能带入大量无关内容,却仍然没有稳定覆盖依赖,系统需要更明确的关联或扩展策略。
父子片段提供了另一种选择:程序用较小的子片段建立检索入口,命中以后再取回包含该片段的较大父片段。Dify 在介绍这一机制时,明确区分了用于匹配的子片段和用于补充上下文的父片段。
检索的单位与模型阅读的单位因此可以不同。子片段可以帮助定位“温度限制”,父片段则补上所属章节的条件,但程序仍要限制返回内容的总量,父片段过大时,无关文字和输入开销也会重新出现。
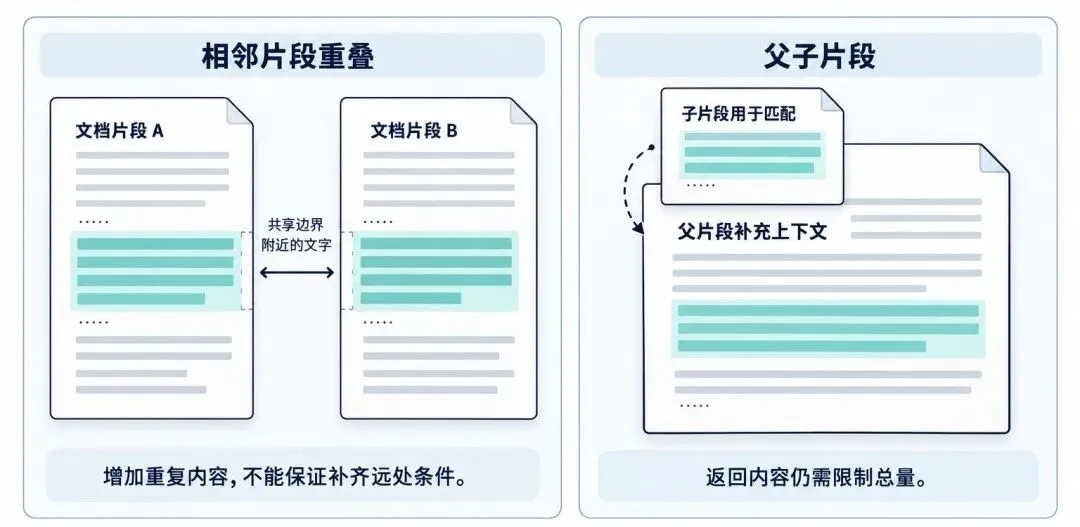
重叠与父子片段的作用区别。
06、三种方法怎样选,为什么没有统一长度答案
三种方法的差别,首先是程序凭什么确定边界。严格定长最依赖长度规则,递归切分会利用分隔符的层级,按结构切分则需要先获得可靠的文档组织,后两者通常仍然需要长度限制。
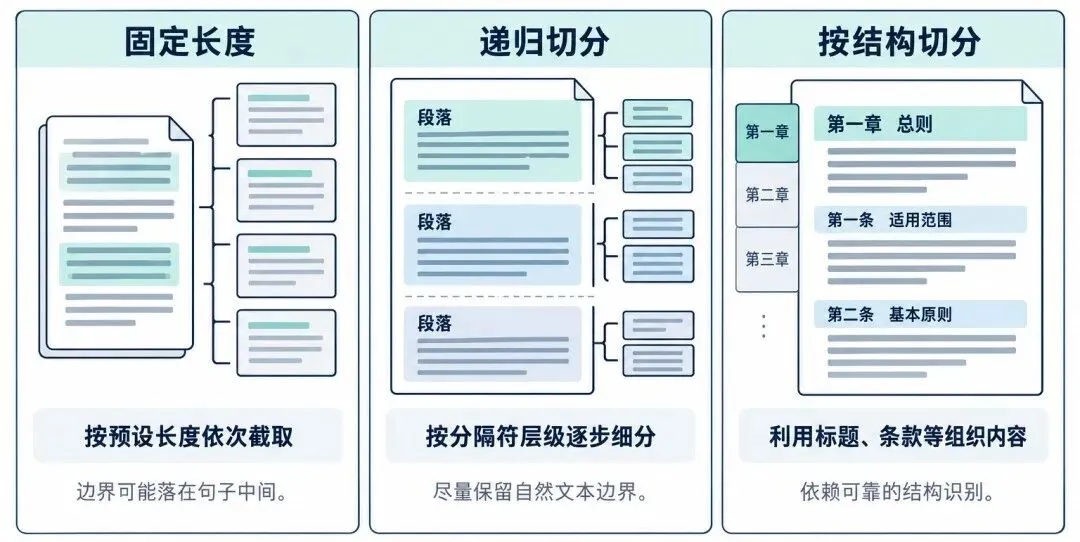
三种方法确定边界的依据。
普通长文本可以先用递归切分建立基线,标题可靠的技术文档可以优先尝试结构切分与长度限制的组合。对于单条内容已经很短、含义独立的问答或术语条目,程序可以直接保留完整条目,开发者没有必要为了“切块”再把条目拆碎。
用户的问题也会改变合适的粒度。查一个参数通常需要范围较小的证据,比较两套方案则可能需要多个章节,团队应围绕常见问题测试片段,而不能只看切出来的段落是否整齐。
检索设置必须一起考虑。同样返回五个结果,大块与小块带给模型的总文字量可能相差很大,开发者比较方法时应控制或明确记录上下文预算,避免把“拿到了更多文字”误判成切分算法本身更好。
按结构切分也不等于语义切分。前者主要依据标题和版面等组织信息,后者可以利用句子表示的相似程度等信号选择边界,LlamaIndex 的语义切分示例就采用了这一思路。相似度不直接表示业务上的条件依赖,团队仍要验证实际结果。
07、验证切分效果,先检查证据是否被完整取回
团队可以从真实材料中选出几类问题,并标出每个答案依赖的原文位置。测试既要包括单段即可回答的问题,也要包括条件跨段、表头跨页和多个片段共同支撑结论的问题,设备手册的温度例子可以作为这类测试的一个假设样本。
程序首先检查检索结果是否覆盖必要证据,然后再检查模型有没有正确使用这些证据。如果系统没有找回降载条件,团队应优先检查切分与检索,如果模型已经收到完整条件却仍然答错,团队就要继续检查推理与回答要求。
切分算法不能承担全部检索责任。嵌入表示、关键词匹配、过滤和排序也会影响结果,团队比较不同切分方案时,应尽量固定这些设置,并记录重复片段比例、输入量、耗时和答案质量,本文没有对这些方法进行实际跑分。
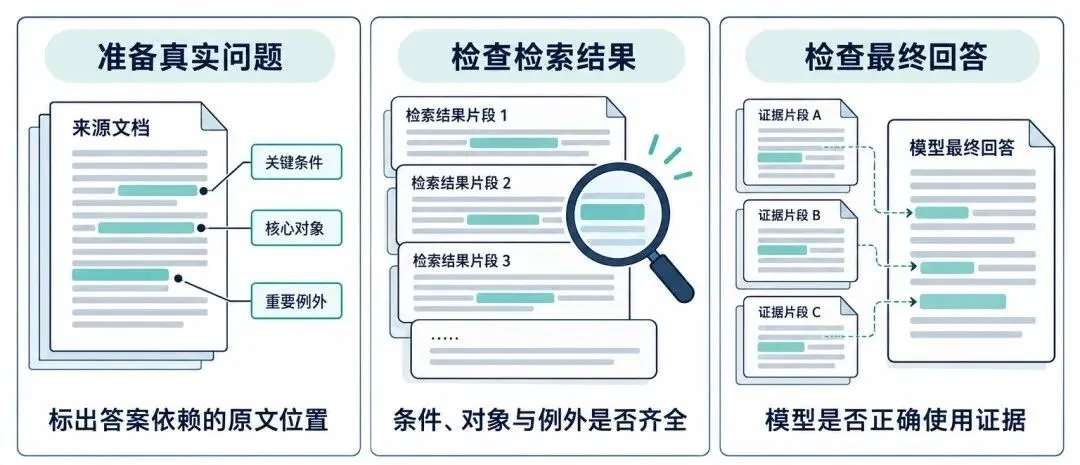
验证切分应从证据覆盖到回答使用。
片段还应保留文档标识、版本和原文位置。用户发现回答有问题时,程序可以据此回查原文,文档更新后,系统也需要处理对应旧片段和索引,避免检索结果继续混入过时内容。
最后一句:对多数知识库,值得先做的是让片段保留清楚的对象与条件,再通过测试决定边界和大小。如果能说明某次调整让哪些必要证据更容易一起取回,并确认额外开销可以接受,这次切分优化才有了可核对的价值。