ARTICLE · 1294228
面向离线 RAG 语料预处理的三层文档识别架构
面向离线 RAG 语料预处理的三层文档识别架构
——证据量门控、判别式优先路由与生成式兜底的实证研究
摘要
面向行业协会政策法规知识库的离线私有化检索增强生成(RAG)建设,原始凭证与公文的批量数字化须满足「无幻觉入库」这一硬约束:进入向量库的文本必须可回溯至原文墨迹,且形态可疑的错值不得静默通过。本文报告一套面向该场景的离线批量文档预处理方案,其贡献可归为三个位于不同层面的创新点,它们分别作用于这类系统的使用门槛、算力成本与结果可信度。
其一,交付形态上,以 AI Agent 的 Skill 而非应用软件作为交付单元。 Skill 是一份开放、声明式的标准清单——能力描述、调用指令与随附脚本及资源——任何具备工具调用能力的 agent 均可加载,不绑定特定厂商、特定界面或特定入口。由此带来三项改变:使用门槛降至「把文件交给 agent 并说明要什么」,无需安装、无需图形界面、无需记忆命令行参数;同一套编排能力可同时被对话代理与批处理脚本复用,也可被上层 agent 编排为更大流程中的一步;全部计算在本机完成,链路中不存在服务端与网络出口,需要审计的数据流动因此可被完整枚举。对本文这类「文件本身即敏感」的场景,无服务端不是附加优点,而是准入条件。据我们所知,将离线文档预处理流水线以此种形态交付、而非以独立应用发布的公开报告尚不多见。
其二,输入入口上,以页内可切出的合格长行组数 ngrp 作前置证据量门控,按证据充分性分层供给算力。 该量由版面切分阶段顺带产出,不增加任何计算,却把「本页统计量是否可信」变成可在推理期直接回答的问题:证据充分则该页在本机以 CPU 走判别式,证据不足则弃权并转交生成式。算力因此按需而非按页平均分配,页级预筛同时削减了无效计算,并使「证据不足」成为显式的一等状态,而非被静默判错。
其三,输出契约上,以国家标准编制的 schema 约束抽取、校验与渲染。 schema 同时充当抽取目标、校验契约与渲染规格,从而把「这个值属于哪个标签」的链接问题降级为按已知标签逐项查找的确定性匹配;字段级验证从主观判断变为可计算的编码校验、形态校验与跨字段一致性校验;缺失则由「看不见」变为可计数、可归因的事件。与自由抽取相比,该路线给出的结构化结果更规范、更可核验。
上述三者承载于同一个三层识别核心之上:第一层 OpenCV 承担版式定位与噪声抑制(密码区与防伪底纹掩膜、投影与连通域分析、长行组切分),第二层 RapidOCR 作为判别式主力承担常规识别并提供坐标与校验见证,第三层 DeepSeek-OCR 作为生成式兜底仅在判别式失效或版面复杂时介入;全部增强位于编排与交付层,上游 OCR 应用源代码零改动。
以增值税发票为例,该 schema 给出五层字段组织(标识、主体、明细、汇总、签署)、区分专用/普通发票及其密码区是否掩膜的票种变体标记,以及编码校验、形态校验与跨字段一致性三类确定性校验。其实施效果不体现在识别更准,而体现在三处:缺失可观测、错值在入库前回落为「(未识别)」、Markdown/HTML/JSON 三份产物由同一 schema 驱动因而同源不漂移。
在此架构上本文围绕五个研究问题开展实证。其一,页级手写/印刷判别:本文提出以「本页可切出的合格长行组数 ngrp」作为手工特征的前置证据量门控——该量在版面切分阶段本来就要计算,不增加任何成本,且判据只读行组数、不读类别标签。在 200 页样本上引入 ngrp ≥ 5 后,字符块高变异系数与上下沿线夹角两个独立手工特征的 AUC 分别由 0.897 / 0.843 升至 0.949 / 0.946,融合判据 R3 达 0.972。两个特征各有直系文献源头,本文的增量不在特征设计,而在于把「证据量是否充分」这一经验提醒显式化为可计算的弃权变量,并给出其量化影响。代价须一并指出:该门控使 35.5% 的页面弃权,且弃权率在两类间并不对称(手写 53%、印刷 18%);在可判子集上漏报 6.4%、误报 9.8%;按路由口径(弃权页一律送生成式)则拦截 97% 手写页、误触发 26% 印刷页,千页耗时由 42 min 增至 75 min。该成本使页级自动路由仍不敌按批次人工指定,故功能默认关闭。其二,区域级生成式升级的可行域:单行切片、半页切片与整页双识别仲裁三种朴素方案均被实测否决,唯一稳定区间为「一个完整字段栏」(约 1000 × 200 像素)。其三,栏位级事后抢救:救回率仅 10%(1.5/15),但由此发现 61%(上界)的「未识别」实为抽取归位失败而非识别失败。其四,量化档位对比:Q8_0 与 Q4_K_M 在中文增值税发票上的数字级污染率中位数完全相同(均为 11.1%),剔除输出发散页后 Q4_K_M 反而略优(9.7%),两档均未编造出能通过 GB 32100 校验位的信用代码;实质差异在失败形态——Q8_0 塌陷时「弃答」,Q4_K_M 塌陷时「发散」,且塌陷具有完全确定性(同页三次复跑 SHA-256 逐字一致)。其五,据此提出六条零成本输出后置护栏(过短、发散、语种漂移、数字污染、复读、耗时异常),在 22 次调用(6 个异常页、16 个正常页)上实现异常页 100% 命中、正常页零误报。
本文的结论是:对于协会这类组织,在借助大模型与 AI 智能体技术建设私有知识库时,具备对历史文件「离网、批量、个性化预处理」的能力是必要的。本文为此提出一套以流程解耦为核心的三层架构技术方案——把版式处理、判别式识别与生成式合成置于可独立替换的三层,把编排与交付从上游应用中剥离,并把证据量门控与 schema 契约分别前置于两端——并在三个创新方向上开展了研究,取得五组实证发现。
关键词:文档图像分析;光学字符识别;视觉语言模型;检索增强生成;Agent Skill 与本地化部署;结构化抽取与 schema;证据量门控;手写体判别;量化误差;数据可审计性
Abstract
Batch digitization of source documents for an offline, privately deployed retrieval-augmented generation (RAG) knowledge base of industry-association policy and regulatory materials must satisfy a hard constraint of hallucination-free ingestion: every character entering the vector store must be traceable to ink on the original page, and suspicious values must never pass silently. This paper reports an offline batch document-preprocessing pipeline for this setting, whose contributions fall into three innovations at three distinct layers—each acting on the barrier to use, the compute cost, and the trustworthiness of the result.
First, in delivery form, the unit of delivery is an AI-agent Skill rather than an application program. A Skill is an open, declarative manifest—capability description, invocation instructions, and bundled scripts and resources—that any tool-calling agent can load, binding it to no particular vendor, interface or entry point. Three consequences follow: the barrier to use collapses to "hand over the files and state the goal", with no installation, no graphical interface and no command-line flags to memorize; one and the same orchestration logic serves a conversational agent and a batch script alike, and can be composed by a higher-level agent into a larger pipeline; and all computation stays on the local machine, with no server and no network egress anywhere in the chain, so the data flows requiring audit are fully enumerable. For documents that are themselves sensitive—the case here—serverlessness is not an added convenience but an admission requirement. To our knowledge, publishing an offline document-preprocessing pipeline in this form, rather than as a standalone application, remains uncommon.
Second, at the input gate, the number of admissible long line groups ngrp that a page yields serves as a front-end evidence-amount gate, rationing compute by evidential sufficiency. The quantity falls out of the layout stage for free, yet turns "is this page's statistic trustworthy" into a question answerable at inference time: sufficient evidence sends the page to the discriminative layer on the local CPU, insufficient evidence triggers abstention and hand-over to the generative layer. Compute is thereby allocated on demand rather than uniformly per page, page-level pre-screening removes wasted computation, and evidential insufficiency becomes an explicit first-class state instead of a silent misjudgement.
Third, at the output contract, a schema compiled from national standards constrains extraction, validation and rendering. The schema serves simultaneously as extraction target, validation contract and rendering specification, which reduces the linking problem—which value belongs to which label—to a deterministic lookup over a known label set; field-level validation shifts from subjective judgement to computable encoding, morphology and cross-field consistency checks; and missing fields become countable, attributable events rather than invisible gaps. Relative to free-form extraction, the resulting structured output is more regular and more verifiable.
These three innovations sit on a single three-layer recognition core: Layer 1 (OpenCV) performs layout localization and noise suppression, including masking of the tax-invoice cryptographic area and anti-counterfeiting guilloche, projection and connected-component analysis, and long-line-group segmentation. Layer 2 (RapidOCR) serves as the discriminative workhorse, producing text, coordinates and verification witnesses. Layer 3 (DeepSeek-OCR) is invoked as a generative fallback only when the discriminative layer fails its quality gate or the layout is complex. All enhancements reside in the orchestration and delivery layer; the upstream OCR application is left byte-for-byte unmodified.
Using the Chinese VAT invoice as an instance, the schema specifies a five-layer field organization (identity, parties, line items, totals, signatures), a variant flag that distinguishes special from ordinary invoices and hence whether the cryptographic area is masked, and three families of deterministic checks: encoding, morphology and cross-field consistency. The benefit is not higher recognition accuracy but three properties: missing fields become observable, suspicious values are demoted to "(unrecognized)" before ingestion, and the Markdown, HTML and JSON outputs, driven by one and the same schema, cannot drift apart.
Five research questions are examined empirically. (i) Page-level handwritten/printed discrimination. We propose to gate handcrafted features by the number of admissible long-line groups ngrp that a page yields—a quantity already produced by the layout stage, hence free, and whose rule reads only the group count, never the class label. On 200 pages, imposing ngrp ≥ 5 raises the AUC of two independent handcrafted features—the coefficient of variation of character-block height and the intersection angle of upper/lower baselines—from 0.897/0.843 to 0.949/0.946, with the fused criterion R3 reaching 0.972. Both features have direct antecedents in the literature; the contribution here lies not in feature design but in making the sufficiency of evidence an explicit, computable abstention variable and quantifying its effect. The cost must be stated alongside: the gate abstains on 35.5% of pages, and the abstention rate is asymmetric (53% for handwritten, 18% for printed); on the decidable subset the miss and false-alarm rates are 6.4% and 9.8%; under a routing protocol that sends every abstention to the generative layer, R3 intercepts 97% of handwritten pages while false-triggering on 26% of printed pages, raising the cost from 42 to 75 minutes per thousand pages. That cost still leaves page-level routing inferior to per-batch manual assignment, so the feature is disabled by default. (ii) Feasible granularity of region-level generative escalation. Single-line crops, half-page crops and whole-page dual-recognition arbitration are all rejected empirically; the only stable regime is one complete field column (approximately 1000 × 200 pixels). (iii) Field-level post-hoc rescue. The rescue rate is only 10% (1.5/15), yet the experiment reveals that 61% (upper bound) of missing fields are extraction-and-assignment failures rather than recognition failures. (iv) Quantization-tier comparison. Q8_0 and Q4_K_M exhibit identical median digit-level contamination rates (11.1%); excluding the divergent page, Q4_K_M is marginally better (9.7%); neither tier fabricates a credit code that passes the GB 32100 check digit. The substantive difference lies in failure morphology—Q8_0 abstains while Q4_K_M diverges—and degeneration is fully deterministic (identical SHA-256 across three repeated runs on the same page). (v) Zero-cost output guardrails. Six model-free post-hoc criteria (too short, divergent, language drift, digit contamination, repetition, latency anomaly) achieve 100% detection on 6 abnormal pages with zero false positives on 16 normal pages across 22 calls.
The conclusion is that for organizations such as industry associations, building a private knowledge base with large language models and AI agents makes it necessary to possess the capability of offline, batch and individualized preprocessing of historical documents. This paper offers a technical solution for that need: a three-layer architecture organized around process decoupling—layout processing, discriminative recognition and generative synthesis placed in three independently replaceable layers, orchestration and delivery separated from the upstream application, and an evidence gate and a schema contract placed at the two ends respectively. The solution is studied along three innovation directions and supported by five groups of empirical findings.
Keywords: document image analysis; optical character recognition; vision-language model; retrieval-augmented generation; agent-skill delivery and local deployment; schema-guided structured extraction; evidence-amount gating; handwritten text discrimination; quantization error; data auditability
1 引言
1.1 研究背景与工程约束
行业协会的政策法规知识库需将大量纸质与扫描材料(政策文件、执法文书、案例卷宗、发票与收据等凭证)转化为可检索的向量库。此类系统对错误的容忍度分布极不均匀:检索排序偏差仅影响使用体验,而正文中混入一个编造的金额或多出一位的纳税人识别号,会静默污染整个知识库,且事后极难定位与回滚。为此,该知识库确立了「无幻觉入库」五条准则:正文永远来自原文、AI 仅辅助抽取元数据、切片绑定溯源、入库前强校验、回答强制引用且无依据时拒答。
上述准则对预处理环节施加三个不可回避的约束。其一,必须离线:数据不得出网,故无法借助在线大模型或云端 OCR 服务。其二,必须可追溯:进入向量库的每一个字符都应能回溯至某一页的某一区域与某一台引擎。其三,必须容忍「读不出来」:宁可输出占位符「(未识别)」,也不得输出一个形态合理而实际错误的取值。
此外还存在一项现实约束:所使用的 OCR 应用程序(下称上游应用)为第三方打包产物,团队无权修改其内部实现。所有增强必须在编排层完成,此边界被视为不可逾越。
最后一项约束关乎交付形态。此类系统的使用者通常是机构内部的业务与档案人员,而非工程师:他们没有条件部署服务、配置环境或记忆命令行参数;与此同时,机构对文件外流的容忍度为零。这两点共同排除了两种常见形态——把文件送至某个在线服务,或开发一套需要专门安装、长期维护的应用软件。本文因此选择第三种形态,即以 AI Agent 的 Skill 作为交付单元,并在第 4.1 节把这一选择作为一项贡献单独论证。
1.2 问题定义与研究问题
本文关注的核心矛盾是:判别式 OCR 与生成式视觉语言模型(VLM)的失效模式不同,但均无法单独满足「无幻觉入库」。判别式 OCR 输出确定、不生成图像中不存在的字符,但对防伪底纹、低对比手写与复杂表格的鲁棒性有限;生成式 VLM 具备版面理解与结构化输出能力,却存在三类已知失败:对清晰文本标注「部分被遮挡」而整体丢弃字段、将相邻栏位内容串位、以及在缺乏把握时退化为「描述这张图」或「讲解发票要素」的自由生成。
若两种失效模式近似正交,则合理的设计是分层路由:以判别式承担确定性工作,仅在判别式失效时启用生成式。但这一设计立即引出若干缺乏现成答案的工程问题,本文将其形式化为五个研究问题:
RQ1(页级路由可行性):在无标注训练数据的条件下,页级手写/印刷判别能否达到可用于批处理路由的可靠性?其判别力的真正瓶颈是什么? RQ2(升级粒度边界):当判别式在局部失读时,将局部区域送生成式升级的可行粒度边界位于何处? RQ3(事后抢救收益):对已判为「未识别」的字段做事后切片抢救,其收益上限如何?失败源自定位错误还是模型不可信? RQ4(量化档位):生成式引擎的量化档位选择是否影响幻觉水平?若不影响,差异体现在何处,何种形态更危险? RQ5(后置护栏):在不依赖模型能力增强的前提下,能否用零成本判据可靠识别生成式的异常输出?
1.3 主要贡献
本文的贡献可归为三个重大创新点,它们分别位于交付形态、输入入口与输出契约三处;三者之外另有若干支撑性结论。
创新点一(交付形态):以 AI Agent 的 Skill 而非应用软件作为交付单元。 本文不开发带界面的应用程序,也不部署服务,而把整条流水线封装为一份符合开放标准的 Skill——由元数据、调用指令与随附脚本及资源构成的声明式清单。其要点有三:其一,不绑定特定 agent,任何具备工具调用能力的宿主均可加载,本文的两个入口共用同一套编排逻辑(第 3.2 节);其二,使用门槛显著降低,使用者只需把文件交给 agent 并说明意图,无需安装、无需界面、无需记忆参数;其三,无服务端因而无外泄路径,全部计算在本机完成,编排层与上游应用仅通过文件与进程边界交互(第 3.6 节),数据流动可被完整枚举与审计。对「文件本身即敏感」的场景,这三点不是便利性修饰,而是准入条件。据我们所知,将离线文档预处理流水线以 agent 可加载的 Skill 形式交付、而非以独立应用发布的公开报告尚不多见;本文因此把该点定位为形态层面的贡献,其评价依据是零安装、跨 agent 复用与无服务端三项可核查性质,而非与既有方法的指标比较(第 4.1 节)。
创新点二(输入入口):以 ngrp 作证据量门控的页级预筛,使算力按证据充分性分层供给。 该量的三点性质构成本文的实质性增量:其一,它由版面切分阶段顺带产出,不引入任何额外计算;其二,其判据只读行组数而不读类别标签,故不是「按文本量筛样本」的事后分析,而是可在推理期执行的运行时决策;其三,它同时充当弃权变量,使「证据不足」成为一个显式可报告的状态而非被静默判错。在 200 页样本上,引入 ngrp ≥ 5 使两个独立手工特征的 AUC 由 0.897 / 0.843 升至 0.949 / 0.946,融合判据 R3 达 0.972;代价是 35.5% 的页面弃权,且在两类间显著不对称(手写 53%、印刷 18%)。由此形成的分层供给是:证据充分的页面由本机 CPU 以判别式处理,只有证据不足的页面才占用生成式算力,算力因而按需而非按页平均分配(第 4.3、6.1 节)。
创新点三(输出契约):以国家标准编制的 schema 约束抽取、校验与渲染。 schema 同时充当抽取目标、校验契约与渲染规格三重角色。据此把「这个值属于哪个标签」的链接问题降级为「按已知标签逐项查找」的确定性匹配,并使「票面本就空白」与「该字段未抽出」成为可区分、可计数的事件——后者是本文得以诊断归位失败的前提。以增值税发票为例给出五层字段组织、票种变体标记(专用/普通发票的密码区差异)与三类确定性校验,并明确该路线的适用边界、版本维护成本与「字段命名须取自规范原文」的纪律(第 4.8 节)。
在此之外,本文还有三项支撑性结论。
架构与可审计性:给出一个零侵入、可离线批量运行的三层文档识别编排架构,以及将「引擎选择」实现为可审计状态机的方法;并提炼出一条跨层原则——「兜底是否真的发生须由被调用方作证,不能由调用方的意图推断」(第 3.7 节)。 实证边界:界定区域级生成式升级的可行域(唯一稳定粒度为单个完整字段栏);量化栏位级事后抢救的收益上限(10%)并给出其结构性不可行的原因;系统对比 DeepSeek-OCR 两种量化档位的幻觉水平与失败形态,并证明塌陷具有完全确定性(第 6.2–6.4 节)。 工程护栏:提出六条零成本输出后置护栏,在本文全部异常样本上实现 100% 命中且零误报;并汇总四类以提升识别率为目标的尝试为何未奏效、四类确定性约束措施为何有效(第 6.5、7.1 节)。
三个创新点与三项支撑性结论同五组实证之间的对应关系见图 1。
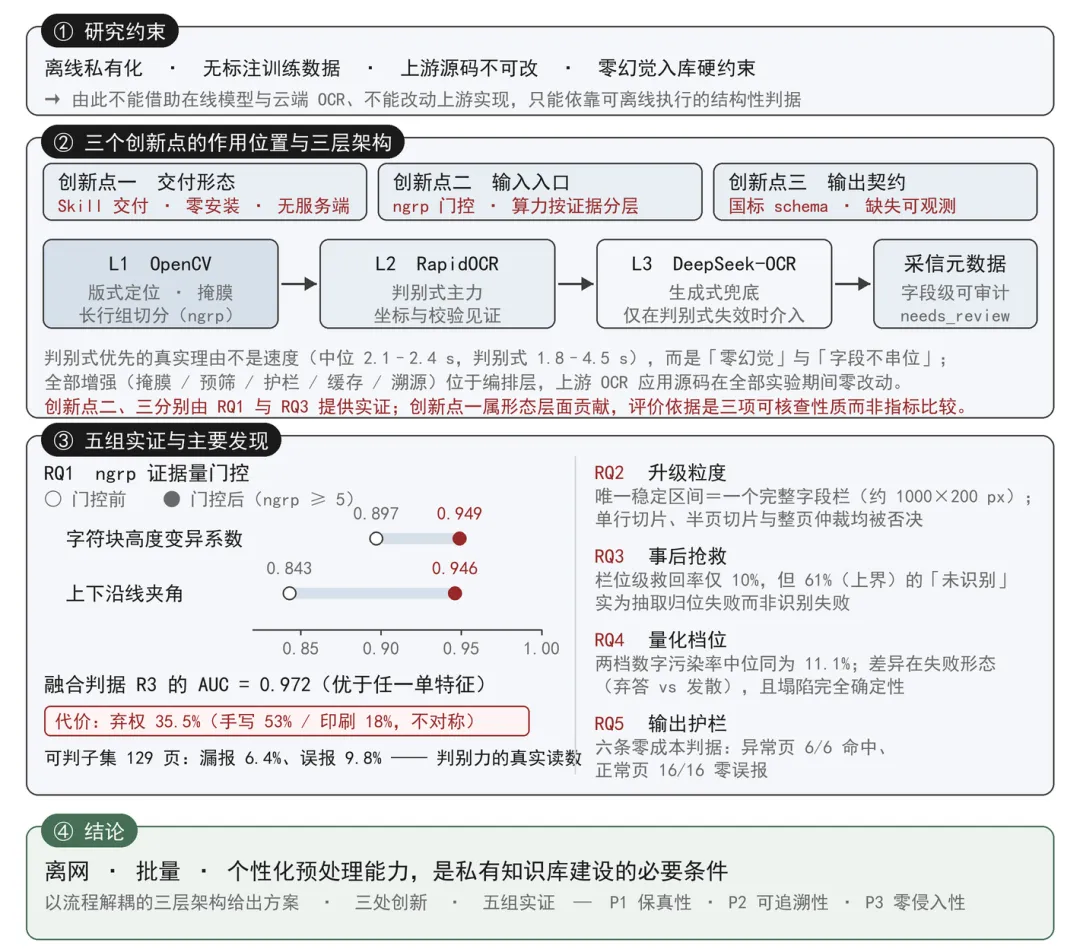
图 1 研究总览:约束、三个创新点与三层架构、五组实证与结论
1.4 论文组织
第 2 节综述相关工作并界定本文定位;第 3 节给出问题形式化与系统架构;第 4 节阐述方法设计,含交付形态的选择与论证、路由判据、证据量门控、切片粒度、输出护栏与 schema 优先的结构化抽取;第 5 节说明实验设置,含研究问题与实验设计的映射;第 6 节按研究问题报告结果;第 7 节汇总实证结果并讨论结论稳定性与有效性威胁;第 8 节总结并给出后续工作。
2 相关工作
2.1 判别式 OCR 与端到端文档理解
文档理解长期存在两条技术路线。判别式路线以文本检测加文本识别为主,工程成熟、可解释、结果确定;RapidOCR 与 PaddleOCR 是其在 CPU 侧的代表实现[1]。端到端路线以序列生成取代检测识别流水线:Donut[2] 以无 OCR 方式直接从图像生成结构化序列,DiT[3] 提供了文档图像的自监督预训练骨干。DeepSeek-OCR[4] 属于后者,其要点在于以视觉词元压缩长上下文,在压缩比小于 10 倍时报告 97% 的解码精度,并在 OmniDocBench 上以更少视觉词元超越同期端到端模型。
生成式路线在实验室指标上占优,但在生产环境中引入了判别式路线不存在的风险:其输出不是「对像素的确定性映射」,而是「对图像的一种解释」,因而可能生成图像中并不存在的内容。这正是本文坚持判别式优先的根本理由——并非出于速度(第 6.1 节的实测否证了该直觉),而是出于零幻觉与字段不串位两项性质。
2.2 手写与印刷体判别
2.2.1 字符、词与行粒度
手写/印刷判别有一条独立于通用 OCR 的文献脉络,其共同前提是:两类文本在「局部排布是否规整」与「上下轮廓是否平滑」上存在可测量的形态差异。本文使用的两个特征分别属于下面两条支线,均非本文首创,须先厘清其来源。
支线一:字符块排布规整度。 Fan 等[5] 提出字符块排布方差(character block layout variance, CBLV):先以 X–Y 投影谷宽判定文本块方向,再用约简 X–Y 切分得到字符块,最后以 CBLV = ΣC(i)/N 分类,其中 C(i) 在相邻块中心底点间距超过中位块高十分之一时取 1、否则取 0,N 为文本块内字符块个数。该方法同时适用于英文与中文。Pal 与 Chaudhuri[6] 面向孟加拉与天城文提出同族特征 CLPSD(字符最低点标准差),把统计对象从包围盒底边换成连通域最低点相对基线与下线的标准差,报告行级准确率约 98.3%。本文的「字符块高度变异系数」正是这一族的连续化变体:以块高的变异系数取代「规整/不规整」的硬阈值计数,从而避免再引入一个人工阈值。须注意,Fan 等把 N 用作归一化分母,其作用是让指标不随文本块长度漂移;本文把同类量用作门控,二者用途不同。
支线二:上下沿线轮廓。 Kavallieratou 与 Stamatatos[7] 是这一支线的直系源头:先定位文本区域并切分为文本行,再对每一行计算上轮廓与下轮廓的水平投影剖面,由此导出三个结构特征——上伸部与主体区之比、下伸部与主体区之比、剖面面积与剖面峰值之比——以马氏距离的线性判别分析分类,在 IAM-DB 与 GRUHD 上十折交叉验证取得 98.2% 的行级准确率。本文的「上下沿线夹角」与之一脉相承,同以行的上下轮廓为观测量,但估计量不同:该文用剖面比值刻画轮廓形态,本文用分别拟合块顶与块底所得两条直线的夹角刻画轮廓的趋势,对整体倾斜与基线抖动更敏感。值得指出的是,该文已经注意到「部分文本行可能只含一个词或几个词」,但并未据此设置任何弃权机制。
支线三:有监督与像素级方法。 Zagoris 等[8] 以视觉词袋结合多 SVM 决策在块粒度上区分手写、印刷与噪声,并公开了三个数据集;该类方法在各自数据集上普遍报告 90% 以上的字/词级准确率,但全部依赖有监督训练集,换语种或换版式后需重新训练。近年工作转向像素级分割:Gholamian 与 Vahdat[9] 针对手写与印刷重叠像素的归属问题提出 SignaTR6K 数据集与新架构,在 ICCV 2023 报告 IoU 相对提升 17.9% 与 7.3%;Lu 等[10] 则以句级连通域切分结合手工设计的区域感知手写描述子,在自建 MAD-HPTS 与公开基准 PHD-AS 上仅比最强深度基线低 1.4% 准确率而快 8 倍以上。
综合三条支线可见,本文两个特征的判别力来源在文献中已有充分交代,本文不以特征新颖性立论。
2.2.2 页级分类与处理链路由
与本文最接近的是页级判别,其目的不是识别内容,而是路由下游处理链(content-specific page routing)。Torrisi 等[11] 将法律卷宗页分为「仅印刷/仅手写/混合」三类,使用 50 份真实案卷(3000 页训练、1800 页测试,两名领域专家标注),发现文本特征与图像特征互补,二者集成后准确率超过 95%。Lutsai 与 Straňák[12] 在近 5 万页捷克考古档案上将页面分为 11 个内容类,微调 DiT、ViT、EfficientNet、RegNetY 与 CLIP 等骨干,以分类器作为前置闸门决定该页走 OCR、手写文本识别(HTR)还是人工复核,并公开了权重与代码。此外,RVL-CDIP 数据集[13] 的 16 个类别中直接包含 handwritten 一类,其上最优模型 DocXClassifier-XL[14] 报告 94.17% 的 16 类整体准确率,Afzal 等[15] 则系统研究了极深卷积网络与训练策略对该任务的增益。
需强调三点差异:其一,上述工作的准确率全部来自有标注训练集;其二,RVL-CDIP 的 94.17% 是 16 类整体准确率而非handwritten 类的单类召回;其三,其 handwritten 标签是「整页全为手写」的强标签,与本文关心的「本页是否含手写」并非同一问题。
还需指出一处关键区别:上述工作的门控是针对内容类别的(判断「这页是什么」),而本文的门控是针对证据量的(判断「这页的测量是否可信」)。前者需要标注数据训练分类器,后者只需数一数行组。二者的失效后果也不同:内容分类判错会把页面送到错误的处理链,证据量不足则表现为统计量失真——后者在没有标注数据的场景下才是可处理的。本文场景不存在标注训练集,故只能走手工特征路线;这既是本文的局限,也界定了第 6.1 节结论的适用范围。
2.2.3 文本量与手工特征可靠性
「页内文本量决定手工特征的可靠性」这一判断本身已有明确的定量研究,本文的出发点正建立在其上。Brink 等[16] 在 Firemaker 与 IAM 上用「逐步擦除页面文本」的方式系统操纵证据量,测量书写人验证与辨识性能随文本量的变化曲线,得到两条对本文直接有用的结论:其一,性能随文本量单调上升,对最佳特征而言可靠分类所需的最小文本量约为 100 个字符;其二,单行文本的验证性能仅 63%~65%,而半页可达 95%。该文由此把「最小文本量」表述为数据集设计的经验法则。
本文与该文的关系需要精确界定,这决定了本文贡献的性质。共同点是两者都把「证据量不足会使手工特征失效」当作核心机制。差别有三:其一,Brink 等为控制变量而主动擦除文本,测量的是「若只有这么多文本,性能会怎样」;本文不改变任何页面,测量的是「在自然分布的页面上,把证据不足的页面判为弃权,剩余页面的判别力会怎样」。其二,该文给出的是离线数据集设计准则;本文把它做成推理期的运行时门控,即同一份代码在批处理时自主决定是否对该页下结论。其三,也是最关键的一点:若按「保证每页都有足够文本」的方式筛选评测集,会系统性排除短页与稀疏页,从而高估真实场景的性能;本文因此不筛选,而是把弃权率(第 6.1 节表 6)作为与 AUC 并列的一级指标报告,并同时给出弃权率在两类之间的不对称程度。
据此,本文对该文献脉络的增量可归纳为一句话:把「证据量」从实验设计中的控制变量,转为推理链路中一个零成本、可计算、可弃权的门控状态,并给出它在真实不均衡页面分布下的收益与代价。
2.3 RAG 语料预处理与数据质量
RAG 系统的质量上限由检索语料决定,而语料质量的上游是文档解析。既有工程实践多关注切分策略与嵌入模型,对「解析出的文本是否忠实」关注不足。Lutsai 等[12] 提供了一个可借鉴的做法:以语言识别模型加因果语言模型的困惑度过滤「OCR 出来但不可信」的文本,将噪声挡在下游命名实体识别之前。本文第 4.6 节提出的输出后置护栏与该思路同源,但判据更偏结构性(长度、语种比例、数字可验证性),不依赖额外模型。
2.4 结构化抽取与表单理解
票据、表单类文档的抽取长期是独立于通用 OCR 的课题。Jaume 等[17] 发布的 FUNSD 是该方向的基准数据集:199 张真实扫描表单,标注 question/answer/header 三类语义实体及其链接关系,把「表单理解」定义为语义实体标注加关系抽取;此后基于该数据集的工作多以「学习 key–value 链接」为核心,其共同前提是需要标注数据。
这条路线与本文的关系须精确区分。共同点是都承认表单的语义结构——即哪个值属于哪个标签——比字符识别本身更关键。差别在于先验的来源:学习式路线从标注样本中归纳结构,本文则对存在国家标准或行业规范的凭证,直接从规范文本导出结构,字段清单、值域形态、字段间的编码与算术关系均由规范给定,不需要任何标注样本。这不是同一问题的两种实现,而是问题定义的差别:前者要回答「这个值属于哪个标签」,后者在抽取之前就已知「一共有哪些标签、各自应长什么样」,于是把链接问题降级为按标签的确定性匹配,并把「找不到」转成一个可报告的状态而非静默的空白。
适用边界同样重要:这条路线只对格式受统一规范约束的凭证成立;对自由排版的公文、手写信函,规范并不约束字段,仍须回到通用抽取或直接做版式还原。本文因此在实现上保留了两条路径,按是否命中 schema 分流(第 4.8 节)。
2.5 本文定位
本文不提出新的识别模型,也不训练分类器。它是一项系统与实证研究,回答的是工程问题:在「离线 + 无标注数据 + 不可改上游 + 零幻觉」四重约束下,批量预处理管线应如何组织,哪些优化真正有效,哪些看似合理但实测不成立,以及如何在模型之外建立可审计的防线。
需要单独说明的是本文对交付形态的处理。本章不设「工具化与 Agent 系统」子节,也不与既有系统作形态对比:在本文检索范围内,文档识别领域的方法论文献普遍以算法指标为报告对象,交付形态通常不被列为贡献,因此缺少可直接对标的文献。本文据此把交付形态定位为形态层面的贡献(第 4.1 节),其评价依据是零安装、跨 agent 复用与无服务端三项可核查性质,而非与既有方法的指标比较;该判断来自对公开文献与产品形态的观察,不构成系统性调研结论。
3 问题建模与系统架构
3.1 问题形式化
设输入为文档页面图像 I,识别引擎集合为 {D, G},其中 D 为判别式引擎,G 为生成式引擎。一次识别即一个映射 f: I → T,T 为输出文本序列。本文要求 f 满足三条性质:
P1 保真性(Fidelity):T 中的每个字符须能对应到 I 中某一区域的墨迹,或至少来自某一确定性引擎的输出。形式化地,不存在 t ∈ T 使 t 在 I 中无对应笔画支撑。 P2 可追溯性(Traceability):每个结构化字段须携带来源引擎、校验结果与复核标记三元组,使任一入库字符可回溯至「哪一页、哪个区域、哪台引擎」。 P3 零侵入性(Non-invasiveness):全部增强位于编排层,上游应用的行为与源码保持不变。
在此框架下,判别式优先的路由可写作一个带质量门控的选择函数:
r(I) = D(I) 若 q(D(I)) ≥ τr(I) = G(I) 若 q(D(I)) < τ其中 q(·) 为质量函数,τ 为阈值。本文的两个门控分别是页级的 ngrp(第 4.3 节,决定整页是否路由至 G)与块级的上游质量闸门(要求本页有不少于 5 个汉字或字母)。
进一步,本文把生成式输出的退化(degeneration)分为两类,二者对 P1 的危害等级不同:
空输出型:|T_g| < 60(去空白字符数),模型弃答或仅输出空表格骨架。 发散型:|T_g| > 1500,或语种漂移(ASCII 字母占比 > 40%),或数字污染率 ρ > 0.5。
数字污染率 ρ 的定义为:设 N(T) 为文本 T 中长度不少于 4 的数字串集合,digits(T) 为 T 的字符流中按顺序保留全部数字字符所得的串,T_d 与 T_g 分别为判别式与生成式在同一页上的输出,则
ρ = |{ t ∈ N(T_g) : t ∉ digits(T_d) }| / |N(T_g)|即以同页判别式输出作为见证源,统计生成式吐出的长数字串中在本页判别式数字流中找不到对应者的比例。该口径是保守的:不同位置的数字拼接后碰巧命中的概率不为零,故 ρ 只会低估污染程度,不会夸大。
3.2 三层结构与调度
系统由三层识别能力与一层编排逻辑构成。编排层以 Skill 形式实现,运行于命令行与对话代理两种入口之上,对上暴露「将一批文件转换为 Markdown/HTML/JSON」的单一接口,对下仅通过文件与进程边界调用上游应用,不做任何代码级侵入。这一交付形态的选择与论证见第 4.1 节,图 2 给出总体结构与调度流程。
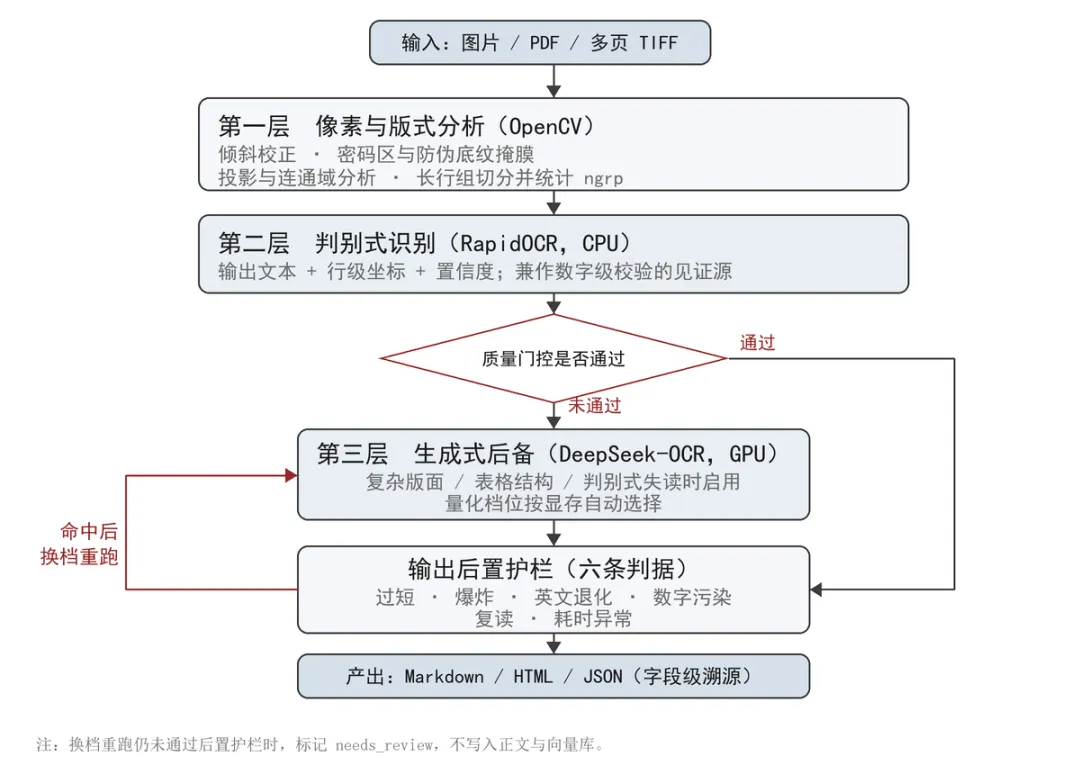
图 2 三层识别架构与调度流程
表 1 给出三层的职责、典型输入与主要失效模式。需说明的是,三层并非常规意义上的「逐级精度递进」,而是按失效模式互补组织的。
表 1 三层结构的职责与失效模式
3.3 第一层:像素与版式处理
第一层承担两项关键工作。
防伪底纹与密码区掩膜。 增值税发票右侧的密码区由机器可读密文与防伪底纹构成,属「打印文本」,会被 OCR 一视同仁地读入正文。早期实测中,一段形如 /+4+<6683645605991>-1*<178*.../ 的噪声块被完整注入输出,若直接入库即构成污染。解决方式是在送入识别前将该矩形区域涂白:默认矩形取归一化坐标 (0.50, 0.20, 0.95, 0.44),覆盖票面上中右带而避开左侧购方区与下方表格及销方区,对增值税专用发票与普通发票通用,无需按票种调参。掩膜后上述噪声块整段消失,经逐字段核对无任何真实字段落入该矩形范围,残留仅为 RapidOCR 的常规字级误差。
值得注意的是,掩膜位置的自动化定位存在一项真实困难:部分普通发票的密码字符为低对比灰字,基于「近黑密度」或「彩色密度」的自动定位均探测不到,最终仍以加宽固定矩形解决。这说明第一层的价值更多来自「已知版式的先验」,而非「通用的自适应算法」。
长行组切分与证据量统计。 第一层还负责将文本行按宽度归并为「组」,并统计本页可切出的合格长行组数 ngrp。合格组的判据是组宽不少于 8 倍字高:对汉字文本约相当于 8 个连排汉字,对拉丁文本约相当于 16 个字符。之所以用「字高」而非「字符数」作标尺,是因为原图分辨率差异可达数倍,绝对像素阈值不可移植,而字高是版面内禀尺度;同时过窄的组(如单个栏目标签)不足以承载基线趋势,必须排除。该量在第 4.3 节中作为证据量门控扮演关键角色。
3.4 第二层:判别式主力
RapidOCR 以纯 CPU 运行,输出每个文本行的文本、四角坐标与置信度。将其置于主路径的理由有三:输出确定可复现、不会生成图像中不存在的内容、以及坐标信息——坐标是栏位几何定位与「字段不串位」的前提。
第二层的输出同时充当数字级校验的见证源:判别式在数字这类高对比、有限字符集的印刷内容上召回率显著高于中文长文本,因此「生成式输出了一个长数字串而本页判别式数字流中不存在」是一个高精度的幻觉信号(第 4.6 节)。
3.5 第三层:生成式兜底
第三层通过 llama.cpp 的 llama-server 以 OpenAI 兼容接口调用,模型由 DeepEncoder 与 DeepSeek3B-MoE-A570M 解码器构成[4]。量化档位按显存自动选择:显存 ≥ 6.5 GB 用 Q8_0(3.1 GB 权重),3–6.5 GB 用 Q4_K_M(1.95 GB),无独立显卡则退至 CPU 推理。本文实验中该层运行于 NVIDIA RTX 4060 Laptop(8 GB)。
第三层只在两种情况下介入:判别式质量门控未通过,或页面被判定为手写/复杂版面。
3.6 零侵入约束下的编排
编排层与上游应用之间仅有三种交互:传入文件路径与环境变量、启动与回收推理服务进程、读取输出文件。因此所有增强(掩膜、预筛、重复护栏、缓存、溯源)均实现于编排层,上游应用的源码在全部实验期间 git status 保持零改动(仅有其打包时遗留的未跟踪文件)。
该约束的代价是明显的:无法升级判别式模型、无法透传置信度、无法收窄上游的表格跳过错判。但它带来两项收益:上游升级时可平滑跟进;整条链路的可信性可通过审计编排层单独确认,即 P3 使 P1、P2 的验证范围可控。
3.7 引擎溯源与虚假溯源缺陷
编排层为每个输出文件写入 `` 标记,标明该页实际由哪一层产出。这条看似琐碎的设计在实践中暴露了一个严重缺陷:早期实现依据「是否设置了强制跳过判别式的标志」来标注引擎,导致在强制跳过但生成式实际未被调用时仍被标为 vlm,构成虚假溯源,直接违反 P2。
根因定位到一次真实的门控失效:编排层在某一分支将 skip_discriminative 硬编码为 False,于是即使请求强制跳过,流水线仍先运行判别式;复杂底纹发票上判别式返回非空噪声,上游质量闸门(仅要求本页有不少于 5 个汉字或字母)随即通过,生成式兜底被静默跳过。表象是日志打印「引擎就绪」,实质是目标模型从未被调用。
修复分两步:该分支改为透传调用方的 skip_discriminative;引擎标注改以「生成式后端是否真的被调用」为唯一判据(以探针包装后端并记录调用集合),而非标志位。这条教训具有普遍性:在多层兜底系统中,「兜底是否真的发生」必须由被调用方作证,不能由调用方的意图推断。
4 方法设计
4.1 交付形态:以 Agent Skill 而非应用软件
问题的提出。 本文的能力可以有多种交付形态:带图形界面的独立应用、常驻本机的 Web 服务、被脚本调用的命令行工具,或可被 agent 加载的 Skill。形态选择不是包装问题,它同时决定三件事——谁能用得起来、用起来有多重、数据流向哪里。本文选择最后一种,并把这一选择本身作为一个贡献来陈述,因为在一个数据不能出网、使用者不是工程师的场景里,形态往往比算法更决定这套东西会不会被真正使用。
四种形态的差异。 图形应用把能力固化为可点击的流程,使用者被锁定在开发者预设的路径上,任何参数变化都需要新增界面控件或配置文件;常驻 Web 服务解决了多用户访问,却引入常驻进程、端口、鉴权与运维负担,对「处理完一批就走」的批处理任务是明显的过度设计;命令行工具最轻,但它把「哪个参数控制掩膜、哪个开关跳过判别式」的负担转嫁给使用者,而这些恰恰是本方案最容易配错的部分,第 3.7 节的虚假溯源缺陷正源于一个被硬编码的跳过标志。Skill 与前三种的根本差别在于它是声明式而非构造式的:一份 Skill 由元数据、自然语言指令、随附脚本与资源构成,它描述「何时该用、怎么用、需要注意什么」,而不规定界面、语言与调用序列;宿主 agent 读入这份清单后自行组织调用。换言之,前三种形态交付的是已经装配好的程序,Skill 交付的是一份可被装配的说明书加零件。
三项可核查的性质。 该形态的价值不靠体感表述,而落在三条可核查的性质上。
其一,零安装与跨 agent 复用。Skill 不产生安装包,也不注册系统服务;对宿主而言它只是一个目录。因此同一份能力可以不经修改地被对话式 agent 与命令行式 agent 加载,本文的两个入口共用同一套编排逻辑(第 3.2 节),上游应用与全部增强代码在两种入口下完全一致。使用者侧的动作被压缩为「把文件交给 agent 并说明要什么」——不需要理解参数、不需要配置环境、不需要常开一个界面。本文的批量转换实验即以对话入口驱动完成(第 6.6 节)。对机构内部的业务与档案人员,这一差别直接决定工具能否被用起来。
其二,无服务端因而无外泄路径。这是本文场景的准入条件而非附加优点。全部计算在本机完成,链路中不存在向外部发送文件的步骤,也不存在可供远程调用的端口。编排层与上游应用之间只有三类交互:传入文件路径与环境变量、启动与回收推理进程、读取输出文件(第 3.6 节)。需要审计的数据流动因此可被完整枚举——它们是本机文件系统内的一组已知读写,而非一个需要被信任的黑箱。这与「无幻觉入库」是同一套合规要求的两面:后者防污染,前者防泄露。
其三,可组合与可编排。Skill 是更大流程中的一步,而不是一个需要人守着跑的终点程序。上层 agent 可以把「批量转换」「字段抽取」「入库校验」等若干 Skill 串联,也可以据上一步的产物自动决定下一步;这种组合能力在应用软件形态下需要额外的集成开发才能获得。
代价与边界。 该形态的局限必须一并说明,否则会高估其成熟度。
其一,正确性依赖宿主的指令遵循。Skill 本身不能强制被正确调用:宿主可能误解意图、跳过某个步骤,或在长流程中丢失前文约束。本文的应对是把会改变结果的约束下沉为脚本内的硬校验——输出护栏、schema 校验、引擎标记、缓存哈希全部写在代码里而不是写在指令文本里。指令可能被忽略,代码不会。这一取向与第 3.7 节的教训同源:可信性应由执行侧作证,不应由意图侧声明。
其二,可复现性弱于固定程序。不同宿主、不同轮次的调用顺序可能不同。本文因此把所有影响输出的决策固化为脚本参数与配置默认值,agent 只负责触发、不负责设定算法细节,使同一批文件的产物在重复运行中保持一致。
其三,可观测性较差。没有界面意味着状态只能从日志与产物反推。本文为此强制每页写入引擎标记与耗时,并在产物头部记录本次运行的参数快照,使「这一页是怎么来的」在事后仍可回答。
其四,「业界尚不多见」这一判断的性质须澄清。本文检索范围内,文档识别的方法论文献普遍以算法指标为报告对象,交付形态通常不作为贡献陈述,因此缺少可直接对标的文献。本文据此把它定位为形态层面的贡献,评价依据是上述三条可核查性质,而非与既有方法的指标比较;这一判断来自对公开文献与产品形态的观察,不构成系统性调研结论(另见第 7.3 节)。
4.2 判别式优先的判据
最初的架构动机被表述为「判别式更快,故优先」。该表述在实测后被否证:在 11 张发票上,生成式兜底的单页耗时中位数为 2.11–2.39 s,与判别式的 1.77–4.48 s 处于同一量级,首次加载约 20–30 s 且只需一次。千页成本差异主要来自异常页而非正常页。
因此判别式优先的正确理由只有两条:零幻觉与字段不串位。前者指判别式不会生成图像中不存在的字符,即满足 P1 的强形式;后者指判别式输出带坐标,可做几何约束的字段归属,而生成式只能凭顺序猜测。实测中生成式曾将某张专用发票的销售方名称「上海易火广告传媒」填入购买方栏位,并将「易火」读作「易大」——字形接近、位置错位,且该错误在纯文本层面完全不可见。
4.3 页面证据量门控
机制。 两个特征都是页级统计量:h_cv 是页内若干块高变异系数的中位数,θ 是页内若干行组夹角的中位数。中位数的可靠性取决于参与平均的独立观测数。若一页只能切出一两个合格长行组,页级统计量实际退化为单行测量,其抽样波动与类间差异同量级;此时无论阈值如何设定,判别力都会塌陷。这一机制与 Brink 等[16] 在书写人辨识中观测到的「性能随文本量单调上升」属同一现象(第 2.2.3 节);区别在于该文通过擦除文本操纵证据量以给出数据集设计准则,本文则在推理期直接识别「证据量不足」这一状态。
规则。 定义 ngrp 为本页可切出的合格长行组数(判据见第 3.3 节:组宽不少于 8 倍字高)。门控规则极为简单:ngrp ≥ 5 则用该页统计量下结论,否则弃权(abstain),交由生成式兜底。该规则有三点设计性质值得单独说明。其一,零成本:ngrp 是版面切分阶段的副产品,不需额外计算,也不需再次读图。其二,判据与标签无关:规则只读行组数、不读「手写/印刷」标签,故不构成按类别筛选样本;但它对两类样本的实际影响并不对称(见下文代价)。其三,弃权是一等状态:证据不足时系统显式声明「本页无法判定」,而非强行给出一个低置信度结论——这与第 3.1 节 P1 的取向一致。
效果。 在 200 页样本上,该门控使两个独立特征的判别力同时跃升(第 6.1 节表 5):字符块高度变异系数的 AUC 由不设限时的 0.897 升至 ngrp ≥ 5 时的 0.949,上下沿线夹角由 0.843 升至 0.946。后者尤为关键:该夹角特征在先前一轮评估中 AUC 曾跌至 0.705、在英文页上方向反转,因而被判定为过拟合。复查发现真凶是 ngrp = 1~8 的英文书籍照片——单组页的页内夹角标准差中位数为 2.59°,已大于类间差异。在 ngrp 门控后,该特征在旧集上由 0.705 回升至 0.884、在全新盲测集上达 0.970,原「过拟合」判定应予撤回。
这也修正了对该特征的参数直觉:并非「每页选 2~3 组算平均」即可,需要 5 组以上才稳定。进一步加严到 ngrp ≥ 8 时,角度特征略升至 0.954 而块高特征略降至 0.947,二者互为消长,说明 5 组已接近本样本量下的有效上限;继续加严只增加弃权而不提升判别力,故本文取 5。
代价。 门控的代价必须与收益并列陈述,否则会高估其价值。在 200 页上它使 35.5% 的页面弃权,且弃权率在两类之间显著不对称:手写页 53%、印刷页 18%(第 6.1 节表 6)。该不对称有两个来源:手写样本多为短札与便条,可切出的长行组天然更少;印刷页多为整版公文,几乎总能满足门控。其后果是「拦截率」这一指标会被弃权抬高——被弃权的手写页因直接送生成式,也会被计入「拦下」,但这不是判别力的体现。因此本文在报告路由层指标之外,同时报告可判子集上的漏报率与误报率(第 6.1 节表 7);只有后者才是判别力的真实读数,也只有它可与文献报告的准确率横向比较。
4.4 融合判据 R3 与生产口径
将两个特征以稳健标准化后等权求和:
R3 = 0.5 · z(h_cv) + 0.5 · z(θ)z(x) = (x − median_p) / IQR_p其中 h_cv 为字符块高度变异系数,θ 为上下沿线夹角,z(·) 为稳健标准化,median_p 与 IQR_p 为参照中位数与四分位距,由一组仅含印刷页的样本烘定,因而不含类别信息;用 IQR 而非标准差作尺度,是为避免个别离群页把尺度撑开。ngrp < 5 的页不参与打分,直接弃权并交由生成式兜底。
R3 的 AUC 为 0.972,优于任一单特征(块高 0.949、夹角 0.946)。权重取等权而非最小二乘拟合,是为避免在百量级样本上过拟合:两个特征在设计上测量的是不同的几何性质(块高离散 vs 轮廓趋势),没有先验理由认为其中一个更重要,等权是唯一无偏的默认。在可判集上两类分数的分离相当干净:手写页 R3 中位 2.83(P25 2.15、P75 3.81),印刷页中位 −0.11(P25 −0.44、P75 0.37),阈值 1.0 落在两者之间几乎无争议的空白区。
生产口径评估。 若在待评估样本上现算参照中位数与 IQR,等于偷看测试集。为此采用外烘常数:以旧集内 43 张满足门控的印刷页定出 h_cv 中位 0.2840、IQR 0.0760,θ 中位 0.8959°、IQR 0.9268°,再对全部 200 页统一打分。这样做的关键收益是口径干净:新补充的 81 页从未参与任何参数设定,构成纯盲测集,其读数不受常数烘定过程污染。结果见表 7。
4.5 区域级升级的可行域
一个自然的设想是:既然整页送生成式有风险,何不只在判别式失读的局部送?本文测试三种粒度:单行切片(约 963 × 69 像素)、半页切片、以及整页双识别仲裁(判别式与生成式各跑一遍,逐行比对取一致者)。结果与判定见第 6.2 节表 9。唯一稳定的区间是一个完整的字段栏,约 1000 × 200 像素,即包含「标签 + 值」的最小语义单元。该结论与 DeepSeek-OCR 依赖版式上下文的设计取向一致[4]:切片过小则丧失版式线索,过大则超出模型的有效压缩比。
4.6 输出后置护栏
既然无法保证模型不出错,就必须保证出错能被发现。本文提出六条不依赖任何模型的判据,全部作用于生成式兜底的输出文本,见表 2。
表 2 输出后置护栏的六条判据
设计过程中出现过两个会制造反向结论的错误,记录以备后鉴。其一,最初以纯数字流判断含字母的统一社会信用代码是否出现于页面,而代码含 X 等字母,纯数字流永远不含字母,导致真实税号被全部判为「编造」(实例:某张普通发票的 1211000040068750X7 在流水线输出中即为真值);修正为使用字母数字流并统一大写。其二,最初在全字符流上滑窗寻找 18 位代码,结果将「开票日期 20160602 + 金额 94339.62 + 税额 5660.38」拼接而成的 201606029433962566 判为一个「通过校验位的编造税号」;修正为按 token 边界切分(以非字母数字字符为分隔)后整串匹配。两处错误的共同性质是:指标本身的构造缺陷会伪造出它所要检测的现象。
4.7 重复循环护栏
生成式兜底在长页面上的典型退化是周期性重复。实测某张长页面发票的输出中「普通/专用」四行一周期地循环了 239 次,原始输出逾万字符而有效内容不足 2%。
护栏采用两层策略。第一层为行级尾部词表收敛:自末尾向前扫描,若去重后的行内容种类不超过 4 且非空行数不少于 16,则判为循环,遇第一种新内容即为循环起点。该层既可抗行级抖动(「普通×4 + 专用」与「普通×3 + 专用」混排),也可抗半行截断(模型在生成长度上限处被切断)。第二层为字符级尾部周期兜底,处理无换行或行内自循环的情形。
该护栏在实现过程中出现过两次静默失效,值得单独指出:第一次因切片下标写错,text[n-p*1:n-p] 恒为空串,判等永不成立,函数永远返回「无重复」,护栏整体失效且无任何报错,直接违反 P1 却不可观测;第二次是修复后仍不适配真实样本的行级抖动与半行截断。最终以「行级为主 + 字符级兜底」解决,并补充两点:缓存命中分支亦须过护栏(否则脏缓存会将已截断的循环「复活」),以及保留回归自测用例(含真实长页面样本,5308 → 153 字符,reps = 237)。
4.8 schema 优先的结构化抽取
动机:标准文本不应按自由文本处理。 通用文档抽取把页面视为自由文本,抽取哪些字段、抽到多深,由模型能力或提示词决定,结果随输入浮动。但对票面格式受国家或行业规范约束的凭证(增值税发票、财政票据、营业执照、银行回单等),存在一个不花任何训练成本即可获得的强先验:规范本身规定了应当出现哪些字段、每个字段的形态、以及字段之间的编码与算术关系。《发票管理办法》[18] 即以规章形式列举发票的基本内容构成(发票名称、代码与号码、客户名称、开户银行及账号、商品名称或经营项目、数量、单价、大小写金额、开票日期、开票人等),GB 32100-2015[19] 与 GB/T 2260[20] 则分别给出统一社会信用代码与行政区划代码的可计算编码规则。这一先验的来源是规范文本而非样本统计,因此不随语料漂移。放弃它,等于把一个「答案形状已知」的问题当成「答案未知」来求解,把可判定的错误留给概率模型去碰。
本文与学习式表单理解路线的分工已在第 2.4 节界定:FUNSD[17] 一类工作从标注样本学习 key–value 链接,本文则从规范文本直接导出字段集合,把链接问题降级为按标签的确定性匹配。以下给出该设计的具体形态。
设计:schema 的三重角色。 本文的 schema 不是字段名字典,而是同时承担三种职责的单一契约。
抽取目标。schema 枚举出本票种应当存在的全部字段,抽取因此从「自由生成」变为「按枚举逐项填充」。字段数在抽取前即为已知量,故「覆盖了多少」与「缺了哪些」都可直接计算。 校验契约。规范为每个字段给出了可计算的值域与校验函数(编码校验位、位数、跨字段算术关系),字段级验证由此成为确定性计算,而不再引入第二个概率判断。 渲染规格。schema 同时是 HTML 输出的版式规格:命中 schema 时严格按票面结构渲染,缺字段显式渲染为「(未识别)」;未命中 schema 时不强行套版,转为尽量还原图片。同一份 schema 驱动三份产物(Markdown 供人读、HTML 供版式核对、JSON 供 RAG 与资料库消费),三者不会相互漂移。
三者必须合一。若抽取用一套字段名、校验用另一套、渲染再用第三套,就会出现「抽到了但没校验」「校验了但没渲染」的缝隙,而缝隙正是错值静默通过的入口。这一「单一契约」的设计取向,与第 3.7 节「兜底是否真的发生须由被调用方作证」是同一条原则在不同层面的体现。
实例:增值税发票。 本文以增值税发票为首个落地票种,字段按五层组织:标识层(发票代码、发票号码、开票日期、校验码);主体层(购买方与销售方的名称、纳税人识别号、地址电话、开户行及账号,共八项);明细层(货物或应税劳务服务名称、规格型号、单位、数量、单价、金额、税率、税额,按行重复);汇总层(合计金额、合计税额、价税合计的大写与小写);签署层(收款人、复核、开票人)。
schema 以变体标记区分票种:专用发票含密码区、须施掩膜,普通发票无密码区、不施掩膜。掩膜策略由 schema 逐票种驱动而非全局开关——这是「普通发票没有密码区」这一事实在实现层的落点,也是仅凭「发票」一个类别名无法表达的信息。schema 片段如下(省略明细层的重复规则):
{ "doctype": "vat_invoice", "variant": "special", // special | ordinary:决定密码区是否掩膜 "fields": { "invoice_code": {"label":["发票代码"], "check":"len:10|12"}, "invoice_no": {"label":["发票号码"], "check":"len:8|20"}, "buyer_id": {"label":["纳税人识别号"], "check":"gb32100"}, "buyer_addr": {"label":["地址、电话"]}, "total_cn": {"label":["价税合计","大写"], "check":"rmb_upper"} }, "cross_checks": [ "invoice_code[:4] in gbt2260", "total == amount + tax", "rmb_upper(total_cn) == total" ] }三类校验按确定性由高到低排列。其一,编码校验:统一社会信用代码的 GB 32100-2015 校验位(31 字符集加权模 31),这是唯一能对单个字段给出「不可能存在」判定的校验。其二,形态校验:发票代码 10 或 12 位、发票号码 8 或 20 位,该项同时是防止「18 位税号被误认为发票代码」的护栏。其三,跨字段一致性:行政区划前缀与票面省份是否匹配(依据 GB/T 2260)、价税合计是否等于金额加税额、大写金额与小写金额是否互证。校验不通过的字段回落为「(未识别)」,而非保留一个形态可疑的值——这是「宁可空着,也不能填错」原则在字段粒度的落地,也是 P1 在这一层面的表达。需要强调,字段命名与层级应逐条取自规范原文而非凭样本观感拟定,理由见下文「命名纪律」一项。
效果。 schema 的收益不体现在「识别得更准」,而体现在三处结构性改变,其中第一处是本项目最重要的方法学收获。
其一,使「缺失」成为可观测事件。自由抽取无法区分「票面本来就没有这个字段」与「该字段存在但未抽出」,因为两者在输出里都表现为「没有」。schema 枚举了应然字段,缺失于是变成可计数、可归因的事件:15 张发票上共 57 个未识别字段,另有 3 个确为票面空白(第 6.3 节)。没有这一区分,后文的归位失败诊断在方法上无法进行——RQ3 之所以能得出「六成以上的『未识别』是归位失败而非识别失败」,前提正是 schema 给出了期望字段清单,使「抽到了却没挂上正确栏位」与「确实没读到」得以被分开检验。换言之,schema 不只是抽取工具,还是可测量性的前置条件。
其二,把错值挡在入库之前。校验位与算术关系不依赖模型,也不会被模型流畅的措辞说服。
其三,三份产物同源。Markdown、HTML、JSON 由同一 schema 驱动,其字段集合与缺省标记必然一致,不会出现「网页上看着有、JSON 里却没有」的情形。
代价与边界。 其一是人工成本:每个票种需一份 schema,须逐字段对照规范编写,无法由样本自动生成。其二是版本维护:票种变体(专用/普通)、版式年份更迭都会产生新 schema,须以版本号管理,否则旧票会被新版 schema 误判。其三是适用范围:仅对受统一规范约束的凭证成立,自由文本仍走通用路径并降级为版式还原。其四是命名纪律:schema 的字段名与层级必须取自规范原文,不能凭样本观感自由定义——若按样本定义字段,样本的偶发性(例如某张票恰好把「地址、电话」印成两行)就会被固化成结构约束,schema 也随之丧失异常检测能力,退化为一张「看起来像票面」的模板。这一点是本文在多个票种上复用时最容易出错、也最需要制度约束的地方。
5 实验设置
5.1 研究问题与实验设计映射
表 3 给出五个研究问题、对应实验、所用数据与结果所在小节。这一映射关系是本文组织结果章节的依据。
表 3 研究问题与实验设计映射
5.2 实验环境
实验在一台 Windows 笔记本上完成:NVIDIA RTX 4060 Laptop(8 GB 显存),llama.cpp llama-server 承载 DeepSeek-OCR,量化档位 Q8_0 与 Q4_K_M,mmproj 分别为 q8_0 与 bf16;判别式为 RapidOCR,纯 CPU 运行。
5.3 数据集
本文使用三组数据,构成见表 4。
表 4 实验数据集构成
.jpg 用于档位对照(两档在同页上逐一跑过) | |||
手写/印刷页集的构成方式直接影响结论解读,须说明三点。其一,两批样本并非同分布:旧集 119 页多为短札与便条,新集 81 页多为整版文稿,故旧集有 62 页(52.1%)在 ngrp ≥ 5 下弃权,而新集仅 9 页(11.1%)弃权。这意味着两批的覆盖率相差近五倍,跨批比较 AUC 时必须同时看覆盖率,否则会把「样本变好了」误读为「方法变好了」。其二,本文的参照常数只烘自旧集印刷页,新集完全未参与,因而新集读数可视为纯样本外。其三,早期版本曾做过一次人工清理(剔除明显误标样本),但被剔除者恰含最多难判页,会使指标虚高;本轮改用「扩样 + 盲测」替代「清理 + 复测」,避免了按结果筛样本的选择偏差。
5.4 评价指标
判别力:以 AUC 衡量单特征与融合判据对「手写/印刷」二分类的区分能力,且只在通过门控的可判子集上计算。AUC 是对判别力的度量,弃权页不参与,故必须与下两项指标同看。
弃权率:未通过门控(ngrp < 5,含特征提取完全失败的页)的页数占该类别总页数的比例,按类别分别报告。该指标是本文新增的一级指标:若只报 AUC 而不报弃权率,一个「只在容易页面上工作」的分类器会显得异常优秀。
路由代价:区分两个口径。路由层口径把弃权页一律计为「送生成式」,用于计算实际资源消耗——误触发率(印刷页被送至生成式的比例)与拦截率(手写页被送至生成式的比例);判别层口径只在可判子集上计算误报率与漏报率,用于衡量真实判别力。两个口径给出不同结论,混用会系统性高估方法价值,故本文全部并列报告。千页耗时由实测单页耗时外推。
幻觉水平:以数字污染率 ρ(式见 3.1)为主指标,同时报告页均、中位与剔除发散页后三种口径——三种口径给出不同结论,这一事实本身即为本文的一项发现(第 6.4 节)。
输出形态:去空白字符数、ASCII 字母占比、尾部重复单元数、单页耗时。
确定性:同页重复调用输出的 SHA-256 是否逐字一致。
为避免指标缺陷消耗推理成本,本文采用两阶段流程:第一阶段仅运行模型并将原始输出落盘,第二阶段在纯 CPU 上离线计算指标。该流程的动机来自一次失败——早期把指标计算与模型调用写在同一脚本,因指标设计缺陷得出假阴性结论,而 GPU 时间已消耗完毕(详见附录 A)。
5.5 复现方法
全部实验可用三个脚本复现,均在离线环境运行,职责与资源需求见附录 A 表 A1。
6 实验结果与分析
6.1 RQ1:页级路由的可行性与瓶颈
判别力。 表 5 给出两个手工特征在门控前后的 AUC,分全部样本、旧集与盲测集三个层次。
表 5 ngrp 门控前后两个手工特征的 AUC
注:括号内为该门控下的可判页数(手写 + 印刷)。n 较小时 AUC 的置信区间很宽,不宜作强解读。
两个特征的判别力在门控后同步跃升,其中夹角特征的提升幅度最大:全部样本 0.843 → 0.946,旧集 0.705 → 0.884。这与 4.3 节的机制判断一致——它是一类被低证据量样本掩盖的高判别力特征。盲测集上两个特征在门控前已达 0.945 / 0.973,门控带来的增益相应较小(→ 0.970 / 0.970),原因是盲测集本身覆盖率就达 88.9%(第 5.3 节),「不设限」与「门控后」两个子集高度重合,门控几乎无事可做。这一点必须强调:门控的增益大小取决于样本的证据量分布,而非方法本身;在文本充裕的语料上,门控近乎冗余。
语言分项首次具备报告条件(英文手写 25 页、印刷 25 页,较上一轮的 7 / 3 页大幅扩充)。在 ngrp ≥ 5 下,中文页的块高与夹角 AUC 分别为 0.944 / 0.956(可判 108 页),英文页为 0.955 / 0.882(可判 21 页);加严到 ngrp ≥ 8 时英文夹角升至 0.971 而块高降至 0.929。英文可判页仅 21(ngrp ≥ 8 时 17),该组数字应视为趋势而非估计。
覆盖与弃权。 门控的代价集中体现在弃权率上,见表 6。
表 6 ngrp ≥ 5 下的覆盖与弃权
该表是理解本文全部 RQ1 结论的前提。弃权并非均匀分布:手写页的弃权率是印刷页的 2.9 倍。这有两个后果。其一,门控的「类别无关」只体现在规则上,不体现在效果上——它在两类上的作用强度相差悬殊。其二,任何以「被送交生成式的比例」定义的拦截率都会被弃权污染:被弃权的手写页也会被计入「拦下」,但那是系统放弃判断,不是系统认出手写。因此下文一律并列给出可判子集口径的读数作为对照。
双口径混淆。 表 7 在可判子集上给出 R3 > 1.0 的混淆统计,并与路由层口径并列。
表 7 R3 > 1.0 的双口径混淆统计(参照常数烘自旧集 43 张印刷页)
先看判别层:在真正被下过结论的 129 页上,R3 的漏报率 6.4%、误报率 9.8%,均在十个百分点以内;且盲测集略优于旧集(6.1% / 7.7% 对 7.1% / 11.6%)。同一套常数、同一份代码,在从未见过的样本上表现不降反升,说明参照常数没有过拟合到旧集。再看路由层:拦截率 97%、误触发率 26%。两个口径的巨大差距(97% 对 6.4% 漏报)几乎全部来自弃权——53 个弃权手写页贡献了 53 个百分点的「拦截」,而真正被判对的手写页只有 44 个。
旧集与盲测集的差异来源。 旧集误触发率 37%、盲测集仅 10%,这一差距值得单独说明,因为它不是方法差异而是样本组成差异。按来源拆分后,印刷侧误报在中文页为 7/72(10%)、英文页为 1/10(10%),两者相仿;差异主要来自可判页占该批的比例:旧集印刷页 17/60 弃权(弃权页按路由口径计为误触发),盲测集仅 1/40 弃权。换言之,旧集误触发率高,是因为它含更多稀疏页面被弃权,而非因为判别更差。这是「路由层指标必须与弃权率同看」的又一个实例。
成本。 表 8 对比四种调度策略。
表 8 四种调度策略的千页成本对比
R3 是「只升不降」的:它只把手写页捞到生成式,不会把印刷页降级,故相对「仅判别式」严格无害,代价纯粹是时间。把阈值从 1.0 放宽到 1.5 可再省 5 min/千页,代价是拦截率由 97% 降至 94%——这条曲线相当平坦,说明本场景不存在「甜点阈值」;选 1.0 是因为它落在两类分数分布的空白区(第 4.4 节),而非因为它在成本上最优。
RQ1 结论。 预筛从「完全不可用(误报 65%、漏报 32%)」进步到「可判子集上漏报 6.4%、误报 9.8%」,这一进步是真实的;瓶颈确实在页内证据量而非特征表达能力。但按批次人工指定仍压倒性更优——全印刷批次 42 min 零风险,含手写批次直接全量生成式 167 min 零风险,而 R3 的 75 min 两头不占优,还要额外承担 26% 的误触发。故该功能默认关闭,仅在「手写与印刷混在同一批且量小到不值得人工分类」时启用。
RQ1 的答案因此是三重的:其一,判别力的瓶颈在于页内证据量,ngrp 门控解除了这一瓶颈,使两个手工特征在可判子集上达到与文献中需标注训练集的方法可比的区分度;其二,解除瓶颈的代价是高弃权率(35.5%)且弃权在两类间高度不对称,故拦截率不能作为方法有效性的证据;其三,即便瓶颈被解除,页级自动路由在成本维度上仍不敌人工先验,本场景下自动化的价值有限。真正可迁移的结论属于方法学层面:报告手工特征的判别力时,必须同时报告证据量门控的弃权率与它在类别间的不对称度,否则指标不可比、也不可复现。
6.2 RQ2:区域级升级的可行域
表 9 给出四种粒度的实测结果。
表 9 三种区域级切片粒度的实测结果
三种朴素方案的失败各有其机制:单行切片丧失了「这是文档而非自然图像」的上下文,模型转向场景描述;半页切片仍含足够文本使模型判定为「翻译任务」,且输出长度超出有效压缩比导致耗时激增;整页双识别仲裁的失败最为根本——两版文本的字符级相似度均值仅 0.344,意味着两版输出差异过大,逐行比对无法产生稳定的仲裁基准。
6.3 RQ3:栏位级事后抢救的收益与副产品
对 15 张发票逐字段清点(须经渲染层而非 schema 字典统计,因「(未识别)」是渲染期替换的产物),共 57 个未识别字段,另有 3 个确为票面空白。缺失最集中者为「地址、电话」(12)、「开户行及账号」(11)、「纳税人识别号」(10)。
对 15 个可几何定位的缺失栏位做切片后送生成式抢救,救回 1.5 个,救回率约 10%(严格按「可直接入库」计为 7%)。失败模式分布为:幻觉或提示词污染 4 例(输出「正确答案」「答案解析锐锐网」「答案 stmnt 4」)、转去讲解图片 1 例、仅回声标签或空输出 5 例、把邻近密码区的「码区」竖排字当作取值 3 例、部分正确 1 例(税号读对但地址编造成另一张票的内容)。
已用切片图像目视核对,排除「裁错框」的可能:某地址栏位的值区确实空白(右侧仅有密码区竖排「码区」),某税号切片内容正确且模型亦读对。因此低救回率源于模型不可信,而非定位错误。
由此发现一个结构性矛盾:需要抢救的字段恰恰是「值区接近空白」的字段,而近空白切片正是该模型最容易退化为问答模板的输入——该路径自我矛盾,其低收益不是调参问题而是设计问题。
但本次实验给出一个更有价值的副产品:对每个未识别字段检查原始判别式文本中是否存在形态合规的候选,51 个可判字段中有 31 个存在(61%,上界)。典型如「上海浦东发展银行」「招商银行」「91430100MA4L79LN8P」——判别式明明读到了,只是未挂到正确的购销方栏位上。即六成以上的「未识别」是抽取归位失败,而非识别失败。
需说明 61% 为上界,存在三类虚高:跨行粘连产生的假候选(如「发票号码 + 税号」粘成一串)、无法区分购销方归属(这恰是抽取失败的真正原因)、以及「地址、电话」正则过松(「…号」会命中密码区噪声)。
6.4 RQ4:量化档位与失败形态
表 10 给出两档在 11 张发票上的同页、同提示词对照,图 3 给出逐页输出长度分布。为免暴露样本来源,本文以 P1–P11 匿名指代这 11 张发票页,匿名映射仅存于作者处;下文 P 编号与图 3 纵轴、表 11 一致。
表 10 Q8_0 与 Q4_K_M 在 11 张发票上的对照(同页、同提示词)
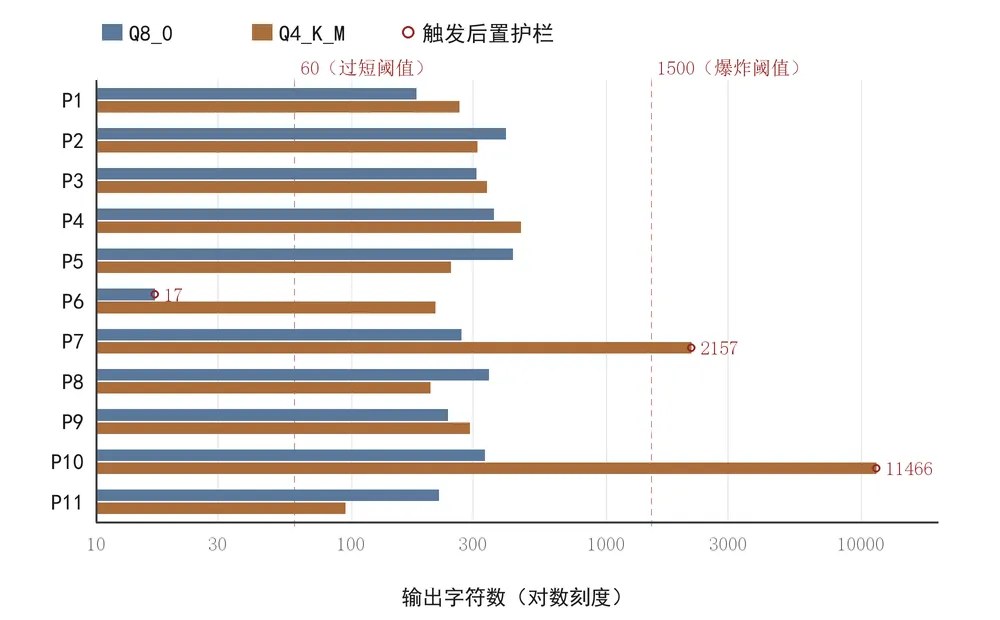
图 3 两档量化在 11 张发票上的逐页输出长度分布(对数横轴)
结论一:两档的幻觉水平没有可测差异。 数字污染率中位数完全相同;剔除发散页后 Q4_K_M 反而略优;两档均未编造出能通过 GB 32100 校验位的信用代码。故以「量化更细则幻觉更少」为由选择 Q8_0 缺乏依据。
结论二:真正的差异在失败形态,而失败形态决定危害等级。 Q8_0 塌陷时弃答:P6 整页输出仅为 <table></table> 加两个竖线,去空白后 17 字符(表 10 中的「输出过短」即指此页),且其在本批 11 页中的输出长度上限只有 430 字符,永不发散。Q4_K_M 塌陷时发散:P10 去空白后 11466 字符(原始 13546 字符),开头的「发票代码」栏被填入纳税人识别号 91340105MA4L7GA41H(真值为 91430105MA4L7GA41H,第 4 位被改,且该变体不通过校验位),「发票号码」栏被填入金额 748971.43,随后从 ¥1300000.00 起以每行 +10000 的等差数列一路生成至 150 万,全页 1032 个数字串中 1021 个在原始票面上不存在(污染率 99%);P7 则整页退化为英文科普文,输出「A tax invoice is a document used to record the details of a transaction between…」并逐条讲解发票要素,去空白后 2157 字符(原始 2638 字符)。
对「无幻觉入库」而言,发散比弃答危险一个数量级。弃答的空页会被任何基于长度的闸门拦下;而一篇 2157 字符、结构规整、英文流利的「发票要素科普」在长度、熵与编码有效性三个维度上都非常健康,基于此类判据的闸门会全部放行,直接入库即构成污染。这也解释了为何表 2 中「语种漂移」判据并非冗余——它是唯一能拦住该样本的廉价判据。
结论三:塌陷是完全确定性的。 同页连跑三次,输出 SHA-256 逐字一致、耗时一致:
P5 (Q8_0) 36.71 / 37.56 / 37.23 s 440 字符 sha=c153a253189a 三次一致P8 (Q8_0) 38.27 / 36.77 s 458 字符 sha=f1d21af1f8ec 三次一致P6 (Q8_0) 5.32 / 4.57 s 17 字符 sha=edb899988cc3 三次一致P10 (Q4_K_M) 34.39 / 34.13 s 11466 字符 sha=0c48798f543f 三次一致三点推论:其一,同档重试无效,塌陷即塌陷;其二,换档重试有效,两档的塌陷页集合互不重叠(Q8_0 塌于 P5、P8、P6,Q4_K_M 塌于 P10、P11、P7),交叉可救回绝大多数;其三,塌陷可被预检,因其为页型相关的确定性行为。
6.5 RQ5:输出后置护栏的有效性
在 22 次调用(6 个异常、16 个正常)上评估表 2 的六条判据,结果见表 11。
表 11 六条护栏的命中与误报
异常页 100% 命中,正常页零误报。
其中「耗时 > 10 s」是本次最经济的发现:16 个正常页的最大耗时为 2.96 s,4 个慢页全部 ≥ 30.2 s,而 10–30 s 区间内一个样本都没有。该判据无需任何额外计算——计时器本就存在。需指出的是,P11 虽被列为异常页,其输出为 95 字符,并不满足「输出过短」阈值,实际是由「耗时异常」捕获的;这说明多判据并行的必要性,单条长度判据会漏掉该样本。
处置策略为:命中则换另一档重跑一次(利用两档塌陷页不重叠的性质,见 6.4 节推论二),仍命中则标记 needs_review,不写入正文、不投喂向量库。不建议同档重试(确定性,必然无效),也不建议通过调节 repeat-penalty 压制复读(本批的失败形态不是复读,而是退化文章,惩罚项压不住)。
6.6 端到端效果
将上述设计合入后,一批 15 张发票的批量转换可全自动完成,每页产出 Markdown(人可读)、HTML(版式还原,命中 schema 时严格按票面结构渲染、缺字段标注「(未识别)」)与 JSON(供 RAG 与资料库消费)三份产物;原始判别式全文只写入 logs/ 供追溯并默认保留 10 天。
此处须指出 schema 在端到端链路中的作用位置:它并不改善第二层的字符识别,而是决定了识别之后「什么算完成」。由于三份产物由同一份 schema 驱动(第 4.8 节),它们的字段集合与缺省标记必然一致,因而「网页上看着有、JSON 里却没有」这类漂移在结构上不可能发生;也正是这一点,使端到端效果可以被逐字段核对,而不只是逐页目视。
早期版本的三类典型缺陷均被消除:防伪底纹噪声注入(第一层掩膜,3.3 节)、循环复读(4.7 节护栏)、以及引擎溯源虚假(3.7 节探针判据)。后续三轮抽取层修复把单票「未识别」字段数由初版的十余项降至个位数,但 6.3 节表明剩余部分中有六成以上属归位问题而非识别问题。
7 讨论
7.1 实证结果的汇总与工程含义
把本文的全部结果并列,可以得到两个清单。表 12 汇总四类以「提升识别率」为目标的尝试,它们在本文的工作面上均未奏效。
表 12 四类「提升识别率」的尝试及其结果
另一组清单是四条「不依赖模型更准、只依赖确定性约束」的措施,它们在本文中全部有效,见表 13。
表 13 四类「提升可验证性」的措施及其效果
两个清单一并看,得到的不是「识别率不重要」,而是本文工作面的一条边界:对自由排版的公文与手写信函,识别率仍是主要矛盾,校验位与正则帮不上忙;而对受统一规范约束的凭证,识别率之外的确定性约束已足以支撑「无幻觉入库」(边界见第 4.8 节)。在这一边界内,本文建议把「识别」与「采信」解耦,让每个字段携带来源、校验结果与复核标记,而不是只有一个字符串。具体的字段级表示如下:
{ "value": "91430105MA4L7GA41H", "source": "rapidocr", "verified_by": ["gb32100"], "confidence": 0.93, "needs_review": false }这与文献[12] 用语言识别加困惑度过滤不可信 OCR 文本的做法同源,但判据更偏结构性。其价值在于:RAG 侧可按 needs_review 过滤;出问题时能定位到具体环节;且为护栏结果提供了自然落点——护栏的命中不应只是一个日志告警,而应是一个可被下游消费的字段属性。这一设计正是 P2 可追溯性在实现层面的落地形态。
由此可以把本文的工作面概括为一句话:这项工作要解决的不是「识别得更准」,而是让一批形态各异的历史文件能够在无人值守的离线环境中完成批量转换、按规范结构抽取、并在入库之前把不确定的部分显式标出。这三件事分别落在交付形态(第 4.1 节)、输出护栏(第 4.6 节)与输出契约(第 4.8 节)上;其整体必要性构成第 8 节的结论。
7.2 结论稳定性:样本量的教训
本研究过程中出现七次结论翻案,每次均源于样本组合或评估口径改变,见表 14。
表 14 七次结论修订及其真实原因
共同病根有两个:一是在样本量临界线以下下结论——早期的 57 + 57、11、12 这些规模都太薄,本文最终的 200 页在类别判别意义上也只是刚过临界线;二是评估口径本身混入了被评估对象——清理样本与弃权都在「提高指标」的同时削弱了被测能力。该教训比任何单项结论都重要,也直接界定了本文结论的适用范围。值得注意的是,七次翻案中有四次的方向是「过早地相信一个有利结论」,这提示在小样本实证中,审慎的方向应当是系统性地质疑正面结果,而非质疑负面结果。
7.3 有效性威胁
内部效度。 「数字污染率 11%」这一数值中,有多少来自生成式编造、多少来自判别式见证源自身漏读造成的假阳性,尚未分离——分离需人工逐字核对原始票面,本文未做。另外,「真实税号被误判为编造」曾因见证源构造错误而在首版分析中出现,虽已修正,但同类风险在 ρ 指标的边界情形上依然存在。此外,护栏的阈值是在同一批 22 次调用上选定并评估的,存在乐观偏置,其真实误报率可能高于本文报告值。
外部效度。 主要结论建立在 11–15 张中文增值税发票与 200 页手写/印刷页上,属单一页型族、单一硬件。文献[11][12][14] 报告的 > 95% 与 94.17% 均来自千页量级的有标注数据,本文不具备可比条件,亦不应被解读为对该任务的一般性结论。「两档塌陷页互不重叠」在 4 个塌陷样本上成立,属观察而非统计结论。语言维度上,样本虽已含中文 150 页与英文 50 页,但英文可判页仅 21,其 AUC 应视为趋势。还需单独声明一项:本文关于「以 Skill 形态交付在业界尚不多见」的判断未做系统性调研,其证据等级低于第 6 章的量化结果,不应被等同看待;该判断的作用是为形态层面的贡献提供定位,而非构成一项实证发现。
构造效度。 此处有三项风险,前两项来自指标定义、第三项来自本文新增的门控。
其一,以「是否出现于判别式数字流中」定义幻觉,对数字密集的凭证类页面可靠,对纯文字页面则没有可用见证源——这是 ρ 指标的适用边界。
其二,六条护栏的阈值(60、1500、40%、50%、10 s)是在 22 次调用上选定并评估的,存在乐观偏置;「耗时 > 10 s」在本批数据上间隔极其干净,但换硬件、换模型或换提示词后须重新标定,更稳妥的部署方式是把阈值表述为「相对本批正常页中位耗时的倍数」而非绝对秒数。
其三,弃权率的统计口径本身会影响结论。本文把「特征提取完全失败」(已切不出任何合格行)与「有行但 ngrp < 5」合并计为弃权,合计 35.5%;若只计后者则为 17%,若把两者分开报告则能看出「图像层面失败」与「证据量不足」是两种不同性质的困难。本文选择合并,是因为二者对路由的后果相同(都送生成式),但这会掩盖困难的性质差异。此外,ngrp ≥ 5 这个阈值是在全部 200 页上选定的,同样带有选择偏置;本文以旧集定常数、盲测集验证的方式部分缓解,但未能消除。
结论效度。 R3 的参照常数烘自旧集 43 张印刷页,换分辨率、字体或语体会整体漂移;盲测集上判别层表现略优(漏报 6.1% / 误报 7.7% 对旧集 7.1% / 11.6%)说明常数未过拟合,但不能排除换域后失效。手写侧 3/47 的漏报率其置信区间仍相当宽,故不能宣称接近零漏报。更根本的限制是:本文全部 RQ1 指标的分母都依赖于「多少页能进入可判集」这一前置事实,而该事实由版面切分质量决定,换扫描分辨率或换语种后可能显著变化。
8 结论与展望
本文报告了一套离线批量文档预处理方案。其贡献集中在三个层面。交付形态上,全部能力以 AI Agent 的 Skill 而非应用软件交付:声明式的开放清单使其不绑定特定 agent,零安装使非工程使用者也能用起来,无服务端使内部文件不存在外泄路径——对「文件本身即敏感」的场景,这三点是准入条件而非便利性修饰。输入入口上,以页内可切出的合格长行组数 ngrp 作证据量门控,使算力按证据充分性分层供给:证据充分的页面由本机 CPU 走判别式,证据不足的页面才占用生成式算力,并使「证据不足」成为显式的一等状态。输出契约上,以国家或行业标准为 schema 建立结构化抽取方法,schema 同时充当抽取目标、校验契约与渲染规格,从而把字段链接降级为确定性匹配,并使「票面本就空白」与「该字段未抽出」成为可区分的事件。
承载上述三者的是一个三层识别核心:OpenCV 像素层、RapidOCR 判别式层与 DeepSeek-OCR 生成式层,并在「不许改上游」的约束下实现了掩膜预处理、页级预筛、循环护栏、内容哈希缓存与逐页引擎溯源。
五组实证给出的结论是:页面证据量门控 ngrp 是手工特征可用的前提,引入后两个独立特征的 AUC 分别由 0.897 / 0.843 升至 0.949 / 0.946、融合判据达 0.972,但代价是 35.5% 的弃权率与弃权在类别间的严重不对称(手写 53%、印刷 18%),故可判子集上的漏报 6.4%、误报 9.8% 才是其真实判别力(RQ1);区域级生成式升级只有「一个完整字段栏」这一个稳定区间(RQ2);栏位级事后抢救的收益上限极低(10%),但由此揭示六成以上的「未识别」实为抽取归位失败——而这一诊断成立的前提正是 schema 给出了应然字段清单(RQ3);两种量化档位的幻觉水平无差异,差异在失败形态(弃答 vs 发散)且塌陷完全确定(RQ4);据此提出的六条零成本输出护栏在本批数据上实现异常页 100% 命中、正常页零误报(RQ5)。
由此得到的结论是:对于协会这类组织,在利用大模型与 AI 智能体技术建设私有知识库时,具备对历史文件「离网、批量、个性化预处理」的能力很有必要——离网是数据合规的前提,批量是历史存量的现实规模,个性化则是「同一套流程要能吃下政策文件、执法文书、案例卷宗与各类凭证」这一异质性的要求。本文为此提出一个新的三层架构流程解耦技术方案:把版式处理、判别式识别与生成式合成拆为可独立替换的三层,把编排与交付从上游应用中剥离,并把证据量门控与 schema 契约分别前置于两端。围绕这一方案,本文在交付形态、输入入口与输出契约三个方向上开展了研究,并取得五组实证发现。
后续工作按证据强度排序:其一,实现输出后置护栏并接入换档重试,这是投入产出比最高的一步;其二,修复抽取归位逻辑并落地格式硬校验,这是当前唯一「免费变好」的机会;其三,引入字段级采信元数据,把识别与采信彻底解耦;其四,页级手写判定的自动化暂缓——若将来确有需求,应从 RVL-CDIP 预训练分类器微调或视觉语言模型零样本起步,而非继续调手工特征,并把类别设计从二分类改为「仅印刷/仅手写/混合」三分类[11],因为真实凭证本身大量属于「混合」;其五,扩展银行回单、收据、营业执照等凭证的 schema,每一类均先依国家或行业标准建立 schema,再按 schema 识别与还原。
声明
数据可用性:本文所用发票与手写/印刷页面样本涉及第三方信息,不便公开原始图像。生成式引擎的 22 次调用原始输出全文、离线指标计算脚本与确定性复跑记录可在合规审查后提供。
利益冲突:作者声明无利益冲突。
参考文献
[1] 百度飞桨. PaddleOCR: 飞桨 OCR 工具库[EB/OL]. https://github.com/PaddlePaddle/PaddleOCR.
[2] KIM G, HONG T, YIM M, et al. OCR-free document understanding transformer[C]//Proceedings of the European Conference on Computer Vision (ECCV). 2022.
[3] LI J, XU Y, LV T, et al. DiT: Self-supervised pre-training for document image transformer[C]//Proceedings of the 30th ACM International Conference on Multimedia. 2022.
[4] WEI H, SUN Y, LI Y. DeepSeek-OCR: Contexts optical compression[EB/OL]. arXiv preprint arXiv:2510.18234, 2025.
[5] FAN K C, WANG L S, TU Y T. Classification of machine-printed and handwritten texts using character block layout variance[J]. Pattern Recognition, 1998, 31(9): 1275-1284.
[6] PAL U, CHAUDHURI B B. Automatic separation of machine-printed and hand-written text lines[C]//Proceedings of the 5th International Conference on Document Analysis and Recognition (ICDAR). IEEE, 1999: 645-648.
[7] KAVALLIERATOU E, STAMATATOS S. Discrimination of machine-printed from handwritten text using simple structural characteristics[C]//Proceedings of the 17th International Conference on Pattern Recognition (ICPR). IEEE, 2004, 1: 437-440.
[8] ZAGORIS K, PRATIKAKIS I, ANTONACOPOULOS A, et al. Distinction between handwritten and machine-printed text based on the bag of visual words model[J]. Pattern Recognition, 2014, 47(3): 1051-1062.
[9] GHOLAMIAN S, VAHDAT A. Handwritten and printed text segmentation: A signature case study[C]//Proceedings of the IEEE/CVF International Conference on Computer Vision (ICCV). 2023. arXiv:2307.07887.
[10] LU Z, ZHANG J, ZHANG L, et al. Handwritten and printed text segmentation via region-aware human-writing descriptor engineering[EB/OL]. arXiv preprint arXiv:2607.15936, 2026.
[11] TORRISI A, BEVAN R, ATKINSON K, et al. Combining textual and visual information for typed and handwritten text separation in legal documents[C]//Legal Knowledge and Information Systems: JURIX 2019. IOS Press, 2019.
[12] LUTSAI K, STRAŇÁK P. Page image classification for content-specific data processing[EB/OL]. arXiv preprint arXiv:2507.21114, 2025.
[13] HARLEY A W, UFKES A, DERPANIS K G. Evaluation of deep convolutional nets for document image classification and retrieval[C]//Proceedings of the 13th International Conference on Document Analysis and Recognition (ICDAR). IEEE, 2015: 991-995.
[14] SAIFULLAH S, AGNE S, DENGEL A, et al. DocXClassifier: Towards a robust and interpretable deep neural network for document image classification[J]. International Journal on Document Analysis and Recognition (IJDAR), 2024.
[15] AFZAL M Z, KÖLSCH A, AHMED S, et al. Cutting the error by half: Investigation of very deep CNN and advanced training strategies for document image classification[C]//Proceedings of the 14th IAPR International Conference on Document Analysis and Recognition (ICDAR). IEEE, 2017.
[16] BRINK A, BULACU M, SCHOMAKER L. How much handwritten text is needed for text-independent writer verification and identification[C]//Proceedings of the 19th International Conference on Pattern Recognition (ICPR). IEEE, 2008: 2519-2522.
[17] JAUME G, EKENEL H K, THIRAN J P. FUNSD: A dataset for form understanding in noisy scanned documents[C]//2019 International Conference on Document Analysis and Recognition Workshops (ICDARW). IEEE, 2019, 2: 1-6.
[18] 国务院. 中华人民共和国发票管理办法[Z]. 2010 年修订.
[19] 全国组织机构代码管理中心. GB 32100-2015 法人和其他组织统一社会信用代码编码规则[S]. 北京: 中国标准出版社, 2015.
[20] 国家质量技术监督局. GB/T 2260 中华人民共和国行政区划代码[S]. 北京: 中国标准出版社.
附录 A 复现说明
本文全部实验可用三个脚本复现,均在离线环境运行,职责与资源需求见表 A1。
表 A1 复现脚本与用途
dump | ||
analyze | ||
determinism |
把采样与指标分析分离是本项目后期采用的方法,动机来自一次失败:早期将指标计算与模型调用写在同一脚本里,因指标设计缺陷(参照值本身有近三分之一页面为空、正则在多数名称上失配)得出「归属正确率 0/12」的假阴性结论,而 GPU 时间已经消耗完毕。分离后指标可离线反复修正,不再重复付出推理成本。这一流程上的教训可能比任何单项算法结论更具普适性:当指标本身可能出错时,不应让它与不可重复的昂贵操作耦合在同一执行单元内。
附录 B 主要工程缺陷与修复对照
表 B1 汇总本次实践中定位并修复的主要缺陷。其中前两项直接对应 P2 与 P1 的违反,且均属「静默失效」——系统行为错误但不产生任何报错。
表 B1 本次实践中定位并修复的主要缺陷
skip_discriminative 硬编码为 False;判别式在底纹上返回噪声,通过上游质量闸门 | |||
vlm 而实际未调用 | |||
text[n-p:n-p] 恒为空串 | |||
OSError(22) | |||
localhost:8080 被系统代理接管 | no_proxy 排除本地回环 | ||