ARTICLE · 1311947
AI 在代谢组学的三种研究范式藏在顶刊的12篇文献中
色谱质谱,物性表征测试(可合作),实验耗材,仪器设备,技术培训
从 15 亿张质谱图到「数字孪生」:AI 代谢组学的四层跃迁,藏在 12 篇文献里
文献盘点 · 人工智能 × 代谢组学 · 研究前景数据截至 2026 年 11 月 5 日|影响因子按 JCR 近年区间标注
封面|AI + 代谢组学:从十亿级质谱语料到可计算的代谢表型
30 TB 的质谱原始文件,27,643 次 LC-MS/MS 运行,1.54 亿张二级谱图——这是 2026 年 10 月一篇 Nature Methods 论文交出来的「语料库」。它没提出什么惊世骇俗的新算法,做的主要是一件事:把这些散落在公共库里的数据,整理成模型能直接吃进去的格式。
听上去不算新闻,对吧?但在代谢组学里,这一步的分量,差不多等于给这个领域修了一条高速路。过去十年,做代谢组的人最痛的不是「没有模型」,而是 同一个模型换一批样本就崩——因为数据来源、仪器、参数、格式全是散的。
我把 10 月底到 11 月初的文献翻了一遍,挑出 12 篇真正把 AI 当方法核心的论文,发现它们恰好排成了一条清晰的链路:数据 → 特征 → 机制 → 决策。四层,一层比一层接近临床和产业,也一层比一层难。
00|先说清楚:这 12 篇是按什么标准选的
你的第一反应可能是:最近一周顶刊里 AI + 代谢组学的文章,真有 12 篇吗?
没有。 我把 Europe PMC 全库按「2026-10-29 至 2026-11-05 + 代谢组学 + AI/机器学习/深度学习」检索了一遍,命中两百多条,但逐条看下来,同时满足「影响因子 10 分以上」和「AI 是方法核心」的原创论文,一周内几乎是零。近一周真正能用的只有 3 篇:一篇 9 分档的视角文章、一篇新刊的路线图综述、一篇 6.7 分的工具论文。
所以最终清单是这样的:9 篇近一个月的顶刊/子刊 + 3 篇近一周的新发,按主题契合度排,IF 如实标注,不硬凑。
选文有一条红线:只收 AI 是方法核心 的论文。那种在讨论区顺手跑了个随机森林、正文里只出现一次「machine learning」的文章,一律不收——这类文章占了检索结果的一大半。
01|先看一张地图:AI 在代谢组学里有三种范式
在进入单篇之前,得先有个坐标系。2026 年 11 月 2 日,密歇根大学 Chandrasekaran 组在 npj Metabolic Health and Disease 发了一篇路线图综述,把「用计算方法反推代谢调控」拆成了三条互不替代的路。这张图我建议每个做代谢组的人都存一下。
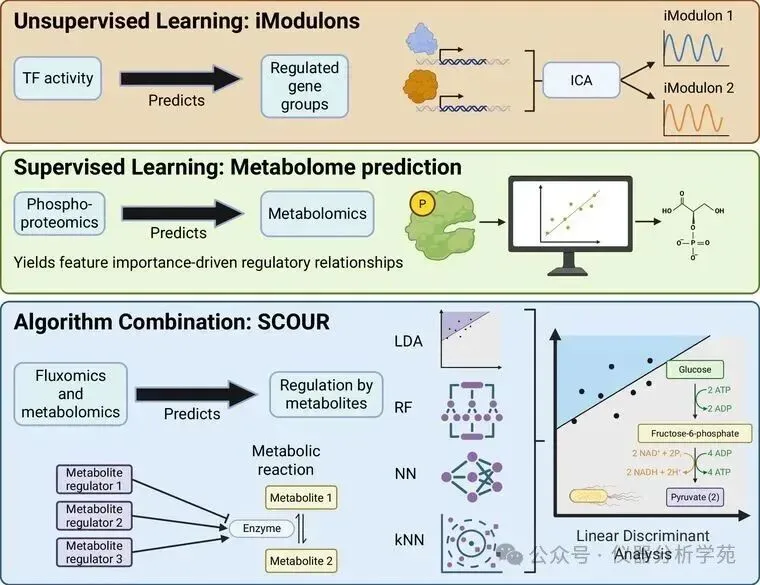
图 1|AI 反推代谢调控的三种范式:无监督(iModulons,用 ICA 从转录数据里拆出调控模块)、有监督(用磷酸化蛋白组预测代谢组,靠特征重要性读出调控关系)、算法组合(SCOUR:LDA / 随机森林 / 神经网络 / kNN 一起上,从通量组与代谢组反推「哪个代谢物在调控哪个酶」)。图源:Schildcrout, Rhoads & Chandrasekaran, npj Metab Health Dis, 2026
第一层,无监督。 不做预测,先把数据里「成组变化」的结构拆出来。iModulons 就是典型:用独立成分分析(ICA)把转录组拆成若干个协同变化的模块,每个模块背后通常站着一个转录因子。代谢组里对应的做法是聚类、共表达网络、分子网络。
第二层,有监督。 用一组好测的数据去预测一组难测的数据。图里举的例子是用磷酸化蛋白组预测代谢组——预测得准不准是一回事,真正有价值的是特征重要性:哪个磷酸化位点对哪个代谢物贡献最大,这就是一条可验证的调控假设。
第三层,算法组合。 到了 SCOUR 这一步,问题变成了「代谢物反过来怎么调控酶」。单个线性模型吃不下的非线性关系,就交给随机森林和神经网络;同时保留 LDA 这种可解释的线性判别,用来画决策边界。
这三层不是替代关系,而是「看得见 → 猜得到 → 说得清」的递进。大多数论文卡在第二层,能走到第三层并把机制做实验验证的,才有资格上顶刊。
02|12 篇速览:谁在做什么
先给一张总表,后面挑重点拆。IF 按近年 JCR 量级标注,不作为精确值引用。
03|第一层:数据底座,比模型重要得多
MassNet 这篇值得单独说。它做了三件在论文里显得「不够性感」、但对整个领域影响最大的事。
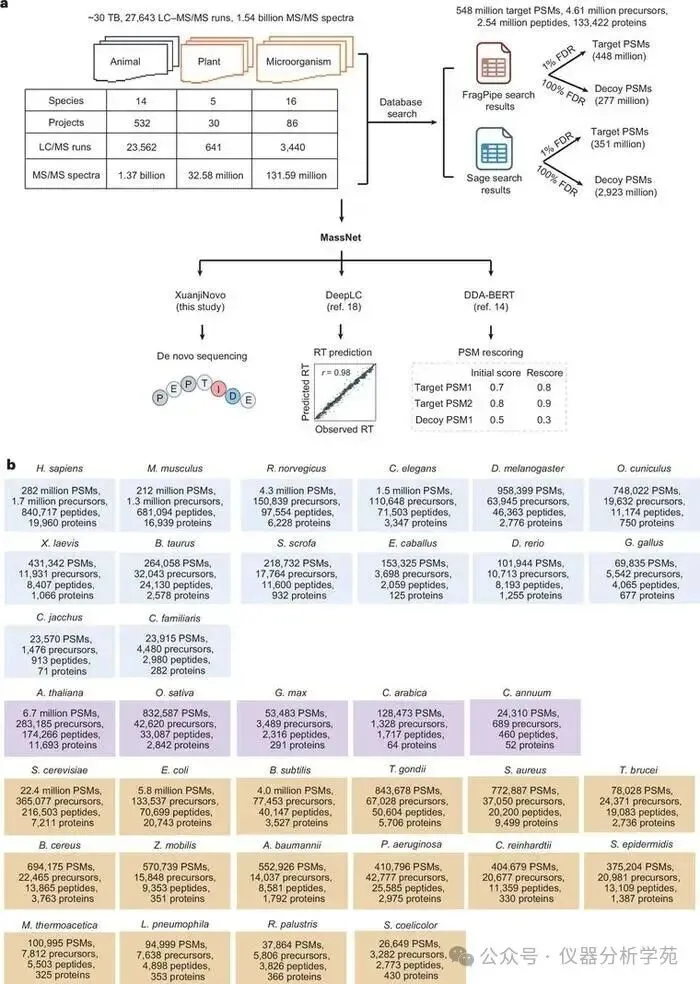
图 2|MassNet 的构成与下游任务。上:约 30 TB、27,643 次 LC-MS/MS 运行、1.54 亿张二级谱,经 FragPipe 与 Sage 两条流程搜库后形成 5.48 亿条 target PSM;下:35 个物种各自的谱图规模。图源:A J et al., Nature Methods, 2026
第一,把规模做到了「十亿级」。 1.5 billion 张串联质谱,覆盖 35 个物种,其中人类样本贡献约 170 万个肽前体。这个量级已经和视觉、语言领域的基础模型语料站在同一个数量级上了。
第二,定义了格式。 他们提出 MSDT(Mass Spectrometry DDA Tensor)——一种紧凑、标准化的张量存储格式,还能转成 Lightning Memory-Mapped Database 加速深度学习的数据读取。说实话,这一条比模型本身更值钱:没有统一格式,就没有可复现的基准,也没有真正的迁移学习。
第三,证明语料能换性能。 基于 MassNet 训练的 XuanjiNovo 是个非自回归 Transformer,配课程学习策略做 de novo 肽段测序,在人类 Astral 数据上比当时的最优方法提升 38.35%–143.57%。同一套语料还能直接支撑保留时间预测(DeepLC)和 PSM 重打分(DBA-BERT)。
另一块底座是 10 月 31 日上线的 MetabDB(Nucleic Acids Research)。它整合了 16 个公共研究,横跨核磁、质谱、脂质组,收录 2663 个代谢指标、3524 种疾病结局、3382 个 GWAS 性状、2025 个分子 QTL 靶点,并把变异、基因、蛋白、代谢物、疾病串起来,支持共定位、孟德尔随机化、精细定位。
这两篇放一起看,意思很清楚:AI 代谢组学真正的瓶颈,从来不是算法不够新,而是数据不够「规整」。 谁能把数据标准化,谁就掌握了下一轮模型竞赛的入场券。
04|第二层:从原始信号到特征表,深度学习开始「接管旋钮」
做 LC-MS 非靶向的人都懂那种痛:同一个样本,换个峰提取参数,出来的特征表能差 30%。峰检测、对齐、去噪、加合物归并,每一步都有一堆要手调的旋钮。
11 月 1 日 Analytical Chemistry 上的 Emzing 就是在拆这个痛点。它把峰检测重新定义成一个监督学习问题——在谱图域和色谱域同时建模,用数据驱动的噪声估计取代固定强度阈值,对低强度信号的灵敏度因此明显提升。样本间的特征对应用稳健的保留时间对齐加图分组,同位素、加合物、源内碎片用相关性打标签,注释到 MSI level 2。
更关键的是工程选择:预训练模型只做推理(inference mode),参数空间被大幅压缩。这意味着同一个流程在不同实验室跑出来的结果更接近——可复现性不是靠「写清楚参数」,而是靠「没有参数可写」。
这一层的价值被严重低估。大家盯着「能不能注释出新的代谢物」,但真实世界里 80% 的时间花在「这张特征表能不能用」上。AI 在这里不产生新知识,它产生的是可信度。
05|第三层:从「注释一个峰」到「反推一条通路」
10 月 1 日 Nature Communications 上,Shlomi 组做了一件很「反直觉」的事:他们不问「这个化合物作用于什么靶点」,而是反过来——用细胞被药物扰动后的代谢组变化,去反推它打中了哪条通路。
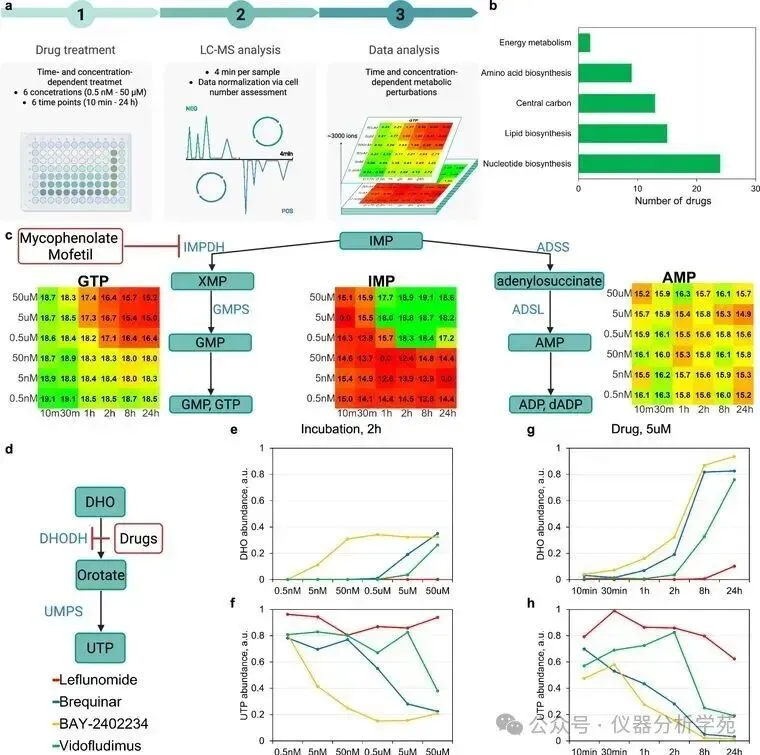
图 3|高通量代谢组筛选流程与命中验证。a:加药 → 4 分钟/样本的 LC-MS → 时间与浓度依赖的代谢扰动分析;b:命中化合物按通路归类;c–h:嘌呤/嘧啶合成通路的热图与关键代谢物(DHO、UTP)的剂量-时间响应。图源:Sarvin et al., Nature Communications, 2026
流程很硬:每个样本 4 分钟,1020 个类药化合物,多个浓度、多个时间点。真正的核心是一个图神经网络(GNN)——把 373 条代谢通路各自建模成图,输入扰动后的代谢谱,输出「这条通路被击中的概率」。
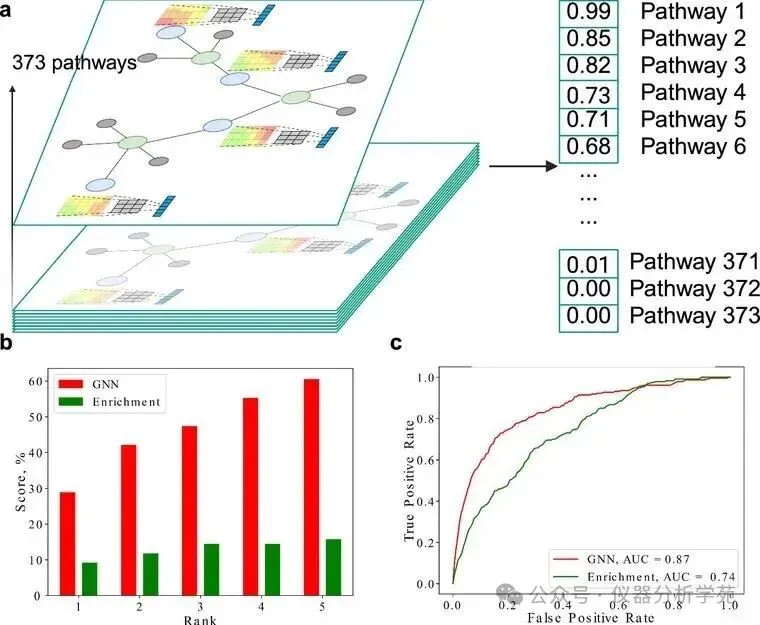
图 4|GNN 给 373 条通路打分。a:每条通路单独建图并输出 0–1 的得分,前 6 条通路得分 0.68–0.99;b:GNN 与富集分析(Enrichment)在 Top-5 命中中的对比;c:ROC 曲线,GNN 的 AUC 为 0.87,富集分析为 0.74。图源:同上
AUC 0.87 对 0.74,差距不算碾压,但足以改变实验策略:先用模型把 1020 个化合物压到 4 个,再去做湿实验。 这 4 个里包括嘌呤与嘧啶合成的抑制剂,以及一个谷胱甘肽代谢的诱导剂——后者在肌萎缩模型里逆转了萎缩标志物、恢复了蛋白含量。
同一个月,Cell 上那篇小细胞肺癌的论文展示了另一条路:不做预测,做整合。研究团队把转录组和代谢组叠在一起,发现无论神经内分泌(NE)还是非 NE 状态,所有细胞系都依赖外源半胱氨酸;但 ASCL1 高表达的细胞通过 GCH1 拉高 BH4/BH2 抗氧化水平,从而躲过铁死亡。联合「剥夺半胱氨酸 + 抑制 BH4/BH2 合成」在 PDX 模型里显著抑瘤。
这两篇的共同点值得记下来:AI 在机制层的真正贡献,不是给出答案,而是把「表型—通路—靶点」的搜索空间从无穷大压到几十个可验证的假设。
06|第四层:从机制到决策,顶刊要的是「能改变一个决定」
到了临床这一层,评价标准就变了。没人关心你的模型结构多花哨,只关心一件事:它能不能让医生做出一个不一样的决定。
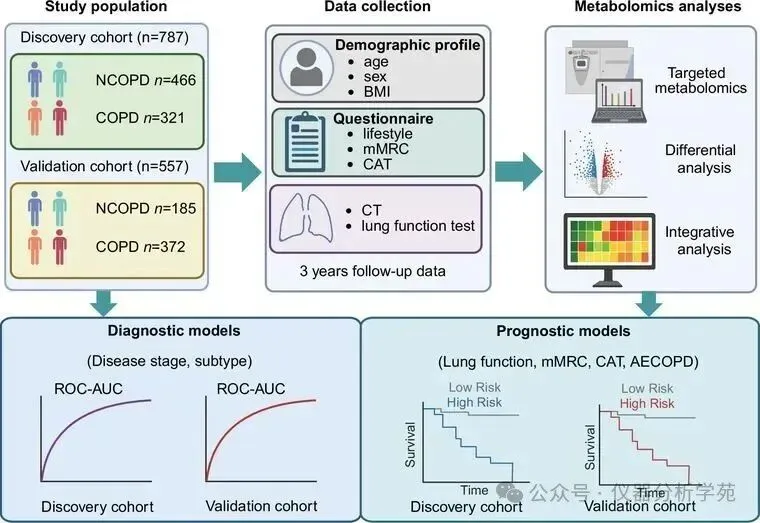
图 5|COPD 血浆代谢组研究的整体设计。发现队列 787 人(对照 466 / 患者 321)、验证队列 557 人(对照 185 / 患者 372),采集人口学、生活方式、CT 与肺功能,3 年随访,最终输出诊断模型(分期、亚型)与预后模型(肺功能下降、急性加重、生存)。图源:Li et al., Nature Communications, 2026
8 月 24 日这篇 Nature Communications(广州医科大学团队)是我这次读下来最「像临床研究」的一篇。1344 名受试者,覆盖 COPD 全病程,651 人有 3 年纵向随访。机器学习筛出来的代谢签名,在测试集和验证集里都能把患者和健康人分开,还能区分肺气肿主导型和小气道主导型两种亚型。
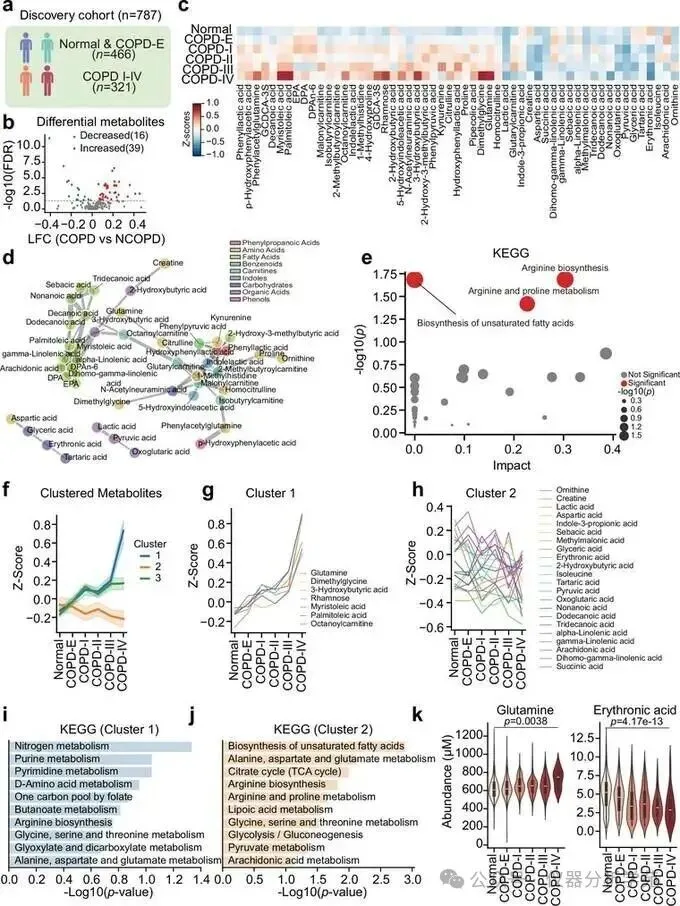
图 6|血浆代谢表型。差异代谢物火山图(下调 16、上调 39)、代谢物相关性网络、KEGG 通路富集,以及按疾病分级聚类的三类代谢轨迹。图源:同上
最实用的是那个 27 个代谢物的 panel:它在肺功能还没明显下降时就捕捉到了代谢漂移,等于把「早期诊断」的窗口往前挪了一段。此外,特定的代谢物子集还能独立预测 FEV1 下降速度、急性加重次数和呼吸困难程度。
另外三篇顶刊,走的是不同路线但同一个逻辑——用 AI 把一个原本做不起的实验变成做得起:
- Science(10-08)
:1543 份人乳样本、3 个队列(含 2 个随机对照试验),把代谢组、蛋白组、微量元素、宏量营养素、母乳寡糖全部测了。轨迹建模加多组学整合,找出一条连接「母亲营养—乳腺功能—婴儿生长」的共同轴;再用机器学习结合 Human Protein Atlas 的蛋白组信息,锁定 7 个标志物。戊酰基肉碱升高、泛酸降低,是两个最关键的代谢信号。 - Cell(10-15)
:小鼠跑轮 8 周,取 22 个组织和血浆,在活动相和静息相各采一次,做 bulk RNA-seq、代谢组、蛋白组、单核 RNA-seq 和单核甲基化测序。机器学习在跨物种数据里找到了保守的运动签名——这类「多组织 × 多组学 × 昼夜相」的设计,没有机器学习根本读不出结论。 - Science Advances(10-21)
:SIMCO,单细胞级数字孪生。用一份新生成的孕期免疫组质谱流式图谱训练,模拟 9 个候选药对分娩时间的影响,再在独立队列里验证。最后筛出四氢叶酸、以及阿司匹林 + 兰索拉唑的组合,机制落在先天免疫细胞的 mTOR 和初始 CD4⁺T 细胞的 JAK/STAT 上。
07|边界:AI 也有物理上限,而且不在算法里
如果只看上面这些,容易得出一个过于乐观的结论。所以我特意把 11 月 3 日 Nature Methods 那篇「泼冷水」的论文放在最后。
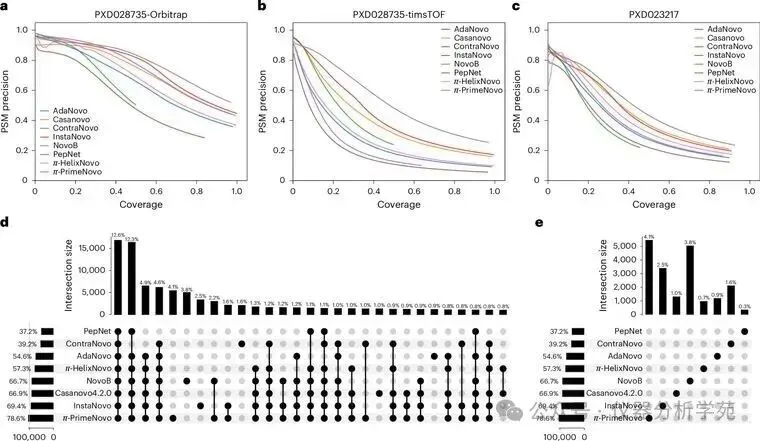
图 7|8 个主流 de novo 肽段测序模型的系统基准。a–c:三个数据集上 PSM 精度随谱图覆盖度的衰减曲线;d:模型间正确识别结果的重叠(UpSet 图);e:各模型独有与共有的错误数量。图源:van Puyenbroeck et al., Nature Methods, 2026
他们干了一件很基础但很少有人愿意做的事:在三个公开蛋白组数据集上,把 8 个当前最好的 de novo 模型放在一起比,还量化了模型之间的一致性。结论有点扎心——
- 模型之间差异很大,但正确识别的重叠度很高。
换句话说,换模型带来的边际收益,远小于换数据。 - 后处理几乎没用。
迭代精修、重打分、重排序,三种主流补救手段要么没提升,要么只提升一点点。 - 错误是「模型无关」的。
大多数测序错误来自碎片离子覆盖不足——这是谱图本身的物理限制,不是模型不够聪明。同样的现象在大搜索空间的数据库搜索里也出现。
这篇虽然做的是蛋白组,但结论对代谢组完全适用。它其实在说一句很重要的话:当输入信息量不够时,任何模型都只能在同一堵墙前面撞。
所以看到「我们的模型比 SOTA 提升 20%」这种表述,先问三个问题:数据集是不是同一个?覆盖度是不是可比?提升是来自模型,还是来自更多标注数据?
08|近一周的三个信号:数字孪生、可解释、工程化
把时间收窄到最近七天,能看到的不是「新突破」,而是三个方向性信号。
信号一:植物也要「数字孪生」。 11 月 3 日,Fernie 团队在 Journal of Integrative Plant Biology 发了一篇视角文章,题目很直白——「化学信号与认知模型:把代谢组学和 AI 结合起来做植物抗逆」。核心主张是:植物合成成千上万种化合物,这些化学指纹本身就在告诉你它怎么应对气候变化;把化学指纹、遗传信息和环境数据合起来,可以建一个植物的数字孪生,让育种家提前预测品种表现。
信号二:从「预测」转向「推断」。 11 月 2 日那篇 npj 路线图(就是图 1 那篇)反复强调一个词:同时。转录调控、翻译后修饰、变构调控,这三层机制过去是分开研究的,未来的方法必须能同时推断,否则你永远不知道一个代谢物变化到底是转录来的、磷酸化来的,还是被小分子别构激活的。
信号三:工具在「去参数化」。 Emzing 那篇的意义不在算法,在于它把「预训练模型 + 固定推理」做成了产品形态。这件事在蛋白组已经发生过一次(AlphaFold 之后,结构预测从「会调参的专家活」变成「点一下按钮」),代谢组正在重复这个过程。
09|我的判断:五个确定方向,四个必须绕开的坑
把 12 篇串起来看,未来三年比较确定的方向有五个:
- 质谱基础模型(MS foundation model)。
MassNet 已经把「语料 + 格式 + 下游任务」这套组合拳打出来了,代谢组的小分子版本大概率在两年内出现。谁先做出跨仪器、跨平台的预训练表征,谁就拿到标准制定权。 - AI-ready 数据标准会成为硬通货。
MSDT 这类格式一旦被主要期刊和数据库接受,「数据能不能直接喂模型」会变成投稿的隐性门槛。 - 多组学数字孪生。
SIMCO 证明了在伦理受限的场景(孕期用药、儿科、罕见病)里,数字孪生可以替代一部分临床试验。这是最有可能产生监管话题的方向。 - 代谢组的因果推断。
MetabDB 这类资源把代谢物、变异、疾病串起来之后,孟德尔随机化会成为代谢组论文的标配分析,而不是加分项。 - 临床 IVD 化。
COPD 那个 27 代谢物 panel 是模板:发现队列 + 独立验证 + 纵向随访 + 明确临床决策点。国内做代谢组临床转化的团队,应该照着这个骨架搭。
同时,有四个坑现在踩的人特别多:
- 小样本 + 高维特征 + 复杂模型。
几百个样本、上千个特征,直接上深度网络,AUC 一定好看,外部验证一定崩。这不是模型问题,是样本量问题。 - 忽略批次效应。
代谢组对仪器状态、柱效、溶剂批号极其敏感。跨批次建模前不做校正,模型学到的其实是「哪天做的样」。 - 只报 AUC,不做决策曲线。
临床上真正关心的是「在哪个阈值下净收益为正」,AUC 0.9 的模型可能在临床阈值区间一文不值。 - 把相关当因果。
代谢物和疾病同时变化,可能都是上游调控的结果。没有干预实验或遗传工具变量,就别写「驱动」。
10|写在最后
如果只记三句话,我希望是这三句:
- AI 在代谢组学的价值,正在从「预测得更准」转向「让原本做不了的实验变得可做」
——1020 个化合物的筛选、1543 份人乳样本的整合、22 个组织的跨组学比对,都是这个逻辑。 - 数据基建的优先级高于模型创新。
MassNet 和 MetabDB 这种「看起来不性感」的工作,决定了未来三年这个领域能跑多快。 - 边界比能力更值得关注。
那篇 8 模型基准告诉我们:当碎片离子覆盖不足时,换什么模型都一样。知道自己模型的物理上限,比刷高一个点的精度重要得多。
如果你正在选课题,我给一个很具体的建议:别再做「用某某模型预测某某代谢物」了,这个赛道已经挤满了。去看那些「数据已经攒了十年、但没人整理成 AI-ready 格式」的方向——临床队列的血浆样本库、植物逆境处理的代谢时序数据、微生物共培养的分泌组。这些地方的护城河,不在模型里。
下一个三年,代谢组学最稀缺的人,大概率不是会调 Transformer 的人,而是既懂质谱物理、又懂数据工程的人。
参考文献
A J, Zhang X, Zhang X, et al. MassNet: billion-scale AI-ready mass spectral corpus empowering scalable deep learning in proteomics. Nature Methods, 2026. DOI: 10.1038/s41592-026-03247-y van Puyenbroeck S, Beslic D, Suomi T, et al. Limitations of de novo peptide sequencing in resolving sequence ambiguity. Nature Methods, 2026. DOI: 10.1038/s41592-026-03301-9 Jauhal A, Cordazzo-Vargas B, Sunko D, et al. Shared patterns of human milk composition link mammary gland function to infant growth. Science, 2026. DOI: 10.1126/science.aee7240 Maier G, Hariharan M, Ramasamy RK, et al. Multi-omics atlas of chronic exercise. Cell, 2026. DOI: 10.1016/j.cell.2026.09.044 Kim JW, Bebber CM, Dai Y, et al. Cell-state-specific metabolic networks govern ferroptosis versus apoptosis in small cell lung cancer. Cell, 2026. DOI: 10.1016/j.cell.2026.09.045 Einhaus J, Neidlinger P, Fondeur O, et al. Single-cell-level digital twins for preterm birth prevention strategies. Science Advances, 2026;12:eaed2741. DOI: 10.1126/sciadv.aed2741 Sarvin N, Kantorovich R, Chakraborty S, et al. Untargeted screening of drug-like compounds using high-throughput metabolomics uncovers inhibitors of key biological pathways. Nature Communications, 2026;17:11274. DOI: 10.1038/s41467-026-78024-8 Li C, Yao J, Wu F, et al. Plasma metabolomic signatures enable the diagnosis and prognosis of chronic obstructive pulmonary disease. Nature Communications, 2026;17:10098. DOI: 10.1038/s41467-026-77040-y Girija A, Krishnan V, von Steimker J, Fernie AR. Chemical cues and cognitive models: Integrating metabolomics and AI for plant stress resilience. Journal of Integrative Plant Biology, 2026. DOI: 10.1111/jipb.70434 Schildcrout R, Rhoads N, Chandrasekaran S. Roadmap for inferring metabolic regulation using multiomics, machine learning, and genome-scale modeling. npj Metabolic Health and Disease, 2026;4:45. DOI: 10.1038/s44324-026-00138-w Singh et al. Emzing: A Deep Learning-Enabled Software Suite for End-to-End Analysis of High-Resolution LC-MS Metabolomics Data. Analytical Chemistry, 2026;98(43):29937-29946. DOI: 10.1021/acs.analchem.6c02696 Huang D, Shi X, Cui S, Xu Q. MetabDB: an integrated resource for human metabolic measures, disease associations, and genetic evidence. Nucleic Acids Research, 2026. DOI: 10.1093/nar/gkag1086
内容整理:质谱与组学观察
想要需要获取更完整更多相关学习内容和资料可以加入纷传资料库:仪器分析前沿资料信息库
仪器分析学苑是,致力于为广大科研工作者、技术人员和学生提供丰富的仪器分析知识、实验技巧和行业动态,可以获取您想要的技术文档,测试优惠,实验耗材,尤其对照品和塑料制品,目前开发了免费质谱工具和质谱解谱软件,一包烟可以加入小圈子获取持续更新仪器学习科研资料http://s.a0j.top/C8dcMnC/CBETB
···························································································································
AI人工智能问答资料库-内容含不限于仪器分析学苑知识库 仪器研发,代谢组学,分子网络,质谱分析,液相气相 访问链接:https://metaso.cn/s/d63ODAn
2. 如需要仪器分析学苑-质谱学堂 团队包年技术咨询,可以加入仪器分析学苑知识星球【含积累3年+的资料库,免费专家群包年咨询多对一解答问题】
https://t.zsxq.com/0fi0l3WGy
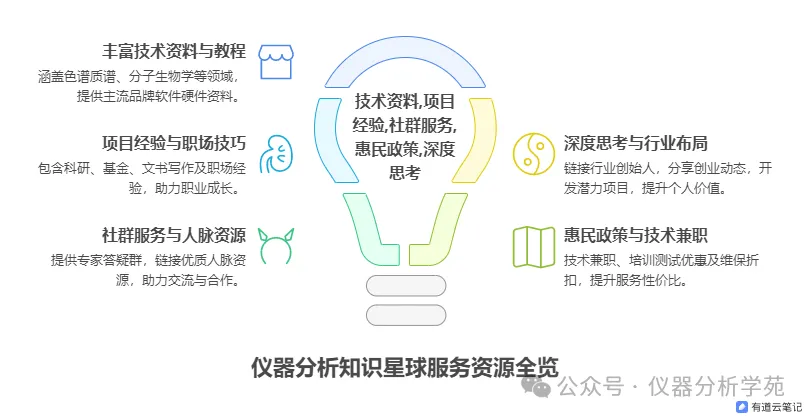
加入仪器分析知识星球享受的福利如图:
质谱辅助与解谱软件 ms assistant使用权限
!
3. 仪器分析学苑 可以提供SVIP贵宾服务:
苑主 SVIP个人咨询(单次一对一或单人包年):苑主玩耍质谱10年+,精通气相液相质谱化合物解析,方法开发,涉及empower软件,masslynx软件,unifi软件 qsight simplicity, waters,安捷伦,ab,pe质谱联用技术,分子网络GNPS等
相关的专业群聊:
盖独学难成, 唯友为益也,我们给大家建立了一个学习,交流,资源的专业分享平台,群里除了日常可以提问,大神会帮助解答以外,群中还有很多老师分享的文档、资料、书籍,绝对让你受益匪浅!为了防止机器人和无关人员加入:现有两种进群方式
行业动态,职业发展【科学家雄鹰计划】目前分为分析,制剂,生物三个板块【行业大佬背书】
加入一: 分析科学家雄鹰计划群聊a与b,已经超过200人,有大量资源,现转为收费群(19.9),
加入二:9.9元红包,直接入分析科学家雄鹰计划群C,生物科学家雄鹰计划A与制剂科学家雄鹰计划A,关注加星标公众号,在看点赞,转发公众号任意文章在朋友圈3h不删除,邀请入群
测试平台:
实验室生化环材耗材一站实服务,日常耗材,通用仪器
兰杰柯商城https://mall.labgic-ljk.com/,私聊下单,会员可有折扣或福利,优势代理,比克曼,白鲨等,代谢蛋白前处理耗材,其他材料
2. 对照品
20w种有证生化环标准物质bepure(特色同位素液标)https://www.bepurecrm.com/
有证杂质质控:https://www.cato-chem.com/
甄准https://www.zzsrm.cn/ 其他:中药 低聚糖 农残兽药脂质优势代理
3.化学中间体与材料供应
4 复杂中药定性定量测试分析,质谱解谱,代谢组【非靶广靶靶向空间代谢组】,蛋白组,分子网络培训,物性检测SEM ,冷冻SEM,XRD,DSC,TG,ITC,BET等
支持代购分子物质与生化试剂代理品牌:麦克林,阿拉丁,targetmol,sigma, 科进 洁特 耐思 碧云天 索莱宝 凯基 麦迪康 施睿康 源叶 三鹰 江莱 亚科因 陶术 Absea Apexbio,酶免,艾迪生欢迎咨询等
基于公众号的国内首个科研问答智能体上线了。
大家关注公众号这么久,有些知识搜不到,或者需要找色谱质谱科研资料,我们训练了几十本色谱质谱书籍及包括上千篇公众号文章,而且不断更新,现在关注公众号,后台发送需要提问问题,或者使用公众号中仪器分析学苑智能体小程序,就可以问答知识,快速找资料了 ,更多咨询问题和资料请关注仪器分析学苑知识星球
部分来源于互联网,B站,公众号等
END
声明:本公众号所有转载文章系出于传递更多信息之目的,且明确注明来源和作者,不希望被转载的媒体或个人可与我们联系,我们将立即进行删除处理。所有文章仅代表作者观点,不代表本站立场。