ARTICLE · 1318973
24k标星!一切文档皆可Markdown!14种格式全覆盖,速度只需毫秒级!
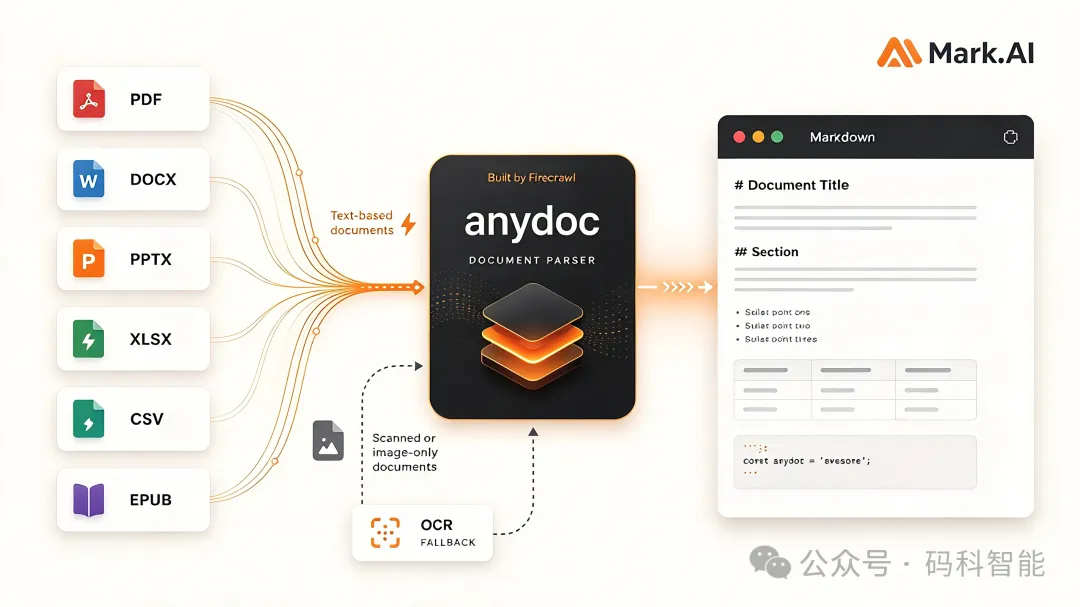
要将不同格式的文档转换为 Markdown,该用什么工具?
大家用的最多的应该是MarkItDown,这是微软官方开源了一款文件格式转换工具!
可以将常见的Word、PowerPoint、Excel、PDF、图像等转换为对大模型更友好的Markdown格式。
那么,这个工具有什么缺点?文档格式支持不够全!转换速度不够快!不是纯本地运行!
最近 Firecrawl 开源了anydoc,一个专门处理本地文档转换的库,解决的就是上面的问题。
14种文档格式全覆盖,转换耗时4.4毫秒,GitHub上已经24k标星。
https://github.com/firecrawl/anydoc一、支持什么?全文档结构
Anydoc 旨在以个位数毫秒的速度将任意文档转换为 LLM 友好的 Markdown,且无论输入哪种格式,输出都保持一致。首先是格式上,MarkItDown 支持6类,docling 支持4类,libreoffice 支持12类,而 anydoc 支持14类,所有格式统一输出。
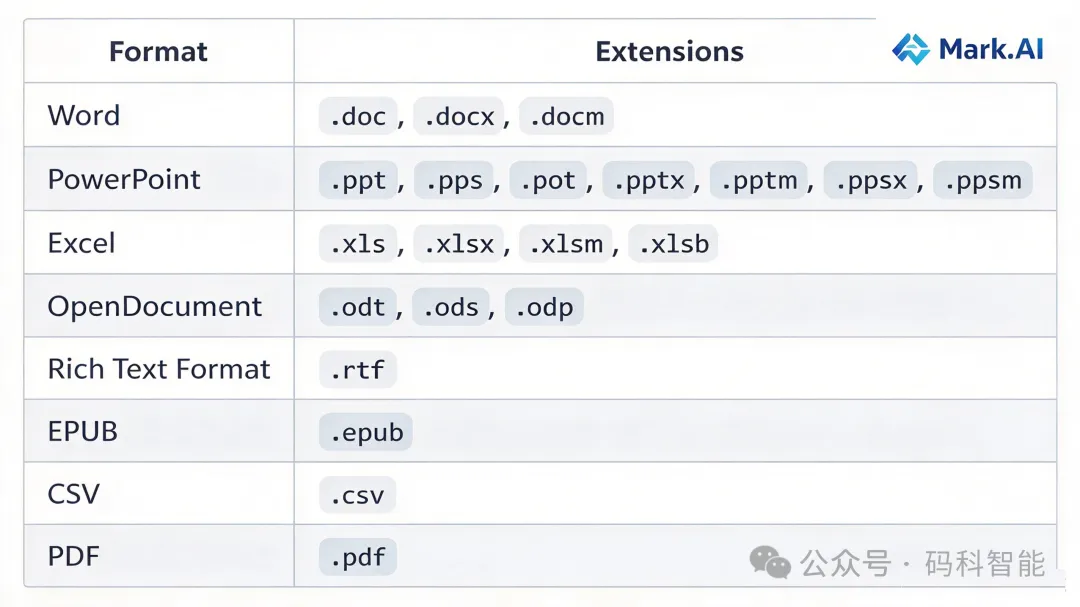
然后是质量上,Anydoc不是那种把文字抠出来就行的转换器,它保留完整的文档结构。
标题带锚点、粗体/斜体/删除线、行内代码和代码块、链接和内部交叉引用、多级列表带源文件编号、合并单元格的表格、块引用、脚注和尾注、演讲者备注。
嵌入资源保留。图片和嵌入对象在Markdown里渲染为替代文本,原始字节留在文档模型上。
二、速度怎么样?快一个数量级
快速是 Anydoc 的一大亮点,它使用纯Rust,没有ML模型,没有外部服务调用。
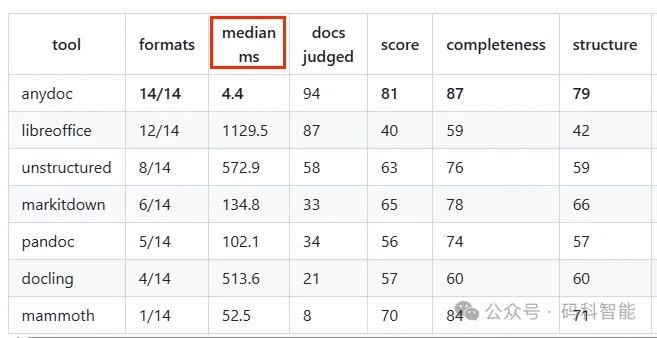
官方用 100 份真实文档、14 种格式做了盲测,anydoc 中位耗时 4.4 毫秒。对比一下,markitdown 是 134.8 毫秒,Pandoc 是 102.1 毫秒,慢了几十倍。
不需要OCR的文档永远不出本机。本地读取文本型PDF,不做OCR。那涉及到图像或者图表的解析怎么办?也可以选择性发送到Firecrawl Parse做OCR。
三、使用方便吗?
上手成本非常低,四种语言绑定,一条命令可接入Agent。
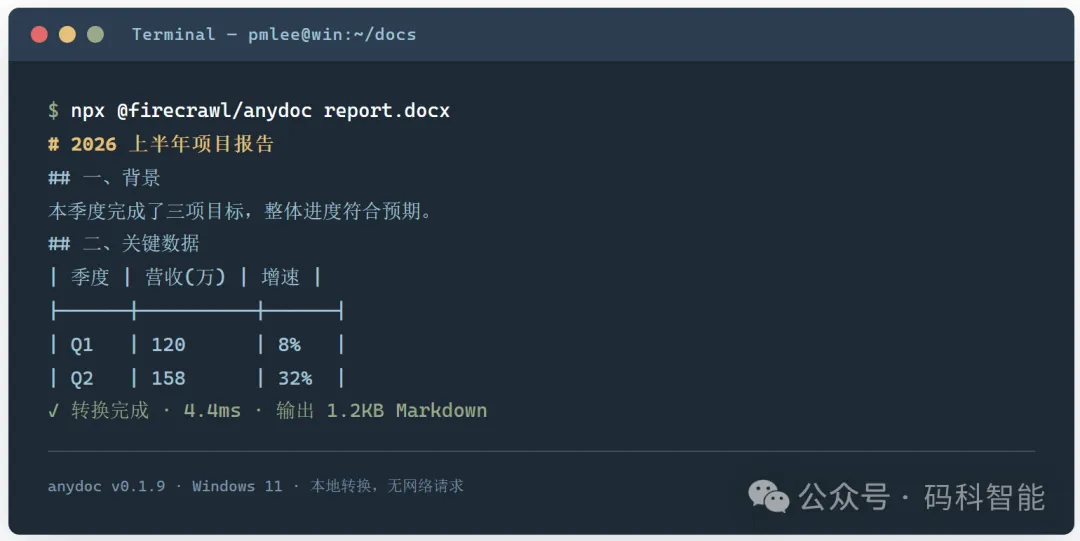
最快的方式是 npx,一行命令直接出结果,首次运行会自动下载对应平台的预编译二进制。
npx @firecrawl/anydoc report.docx
输出一份结构完整的 Markdown 出来,标题、表格、列表各归其位,不需要任何配置。
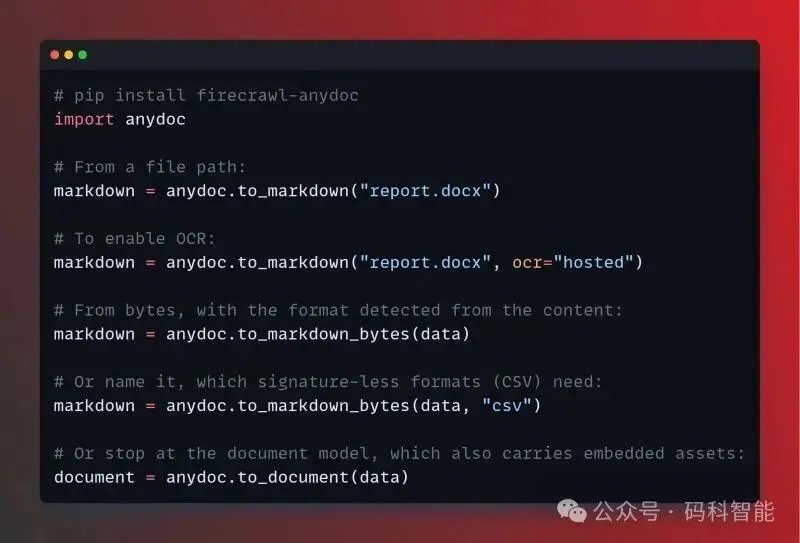
想在代码里集成也一样简单,Python 和 Node 都只要三行,全程本地跑、不用申请 API Key、不用起服务!
npm install @firecrawl/anydocpip install firecrawl-anydoc
然后就是我们目前离不开的 Agent 技能,anydoc 以 Agent Skill 形式提供。
适用于 Claude Code、Codex、Cursor、OpenCode 以及任何其他兼容的 Agent。
npx skills add firecrawl/anydoc
只要上面一条命令,Agent 就能读取任何 Office 文档。
唯一的问题就是OCR的处理,可能官方的还不够强,涉及需要文档解析的部分,可以看看文末之前推荐的各种开源模型呀!
首先是格式上,MarkItDown 支持6类,docling 支持4类,libreoffice 支持12类,而 anydoc 支持14类,所有格式统一输出。
然后是质量上,Anydoc不是那种把文字抠出来就行的转换器,它保留完整的文档结构。
标题带锚点、粗体/斜体/删除线、行内代码和代码块、链接和内部交叉引用、多级列表带源文件编号、合并单元格的表格、块引用、脚注和尾注、演讲者备注。
嵌入资源保留。图片和嵌入对象在Markdown里渲染为替代文本,原始字节留在文档模型上。
二、速度怎么样?快一个数量级
快速是 Anydoc 的一大亮点,它使用纯Rust,没有ML模型,没有外部服务调用。
官方用 100 份真实文档、14 种格式做了盲测,anydoc 中位耗时 4.4 毫秒。对比一下,markitdown 是 134.8 毫秒,Pandoc 是 102.1 毫秒,慢了几十倍。
不需要OCR的文档永远不出本机。本地读取文本型PDF,不做OCR。那涉及到图像或者图表的解析怎么办?也可以选择性发送到Firecrawl Parse做OCR。
不需要OCR的文档永远不出本机。本地读取文本型PDF,不做OCR。那涉及到图像或者图表的解析怎么办?也可以选择性发送到Firecrawl Parse做OCR。
不需要OCR的文档永远不出本机。本地读取文本型PDF,不做OCR。那涉及到图像或者图表的解析怎么办?也可以选择性发送到Firecrawl Parse做OCR。
三、使用方便吗?
上手成本非常低,四种语言绑定,一条命令可接入Agent。
最快的方式是 npx,一行命令直接出结果,首次运行会自动下载对应平台的预编译二进制。
npx @firecrawl/anydoc report.docx输出一份结构完整的 Markdown 出来,标题、表格、列表各归其位,不需要任何配置。
想在代码里集成也一样简单,Python 和 Node 都只要三行,全程本地跑、不用申请 API Key、不用起服务!
npm install @firecrawl/anydocpip install firecrawl-anydoc
然后就是我们目前离不开的 Agent 技能,anydoc 以 Agent Skill 形式提供。
适用于 Claude Code、Codex、Cursor、OpenCode 以及任何其他兼容的 Agent。
npx skills add firecrawl/anydoc只要上面一条命令,Agent 就能读取任何 Office 文档。
唯一的问题就是OCR的处理,可能官方的还不够强,涉及需要文档解析的部分,可以看看文末之前推荐的各种开源模型呀!
最后,小伙伴们可留言回复或者公众号后台回复‘加群’进入大模型交流群、视觉应用落地交流群!
记得点击下方卡片,关注并星标码科智能!