ARTICLE · 1377791
RAG 效果差,多半是文档切错了
答案好像对,但不敢用——问题可能根本不在检索环节。
很多团队在做企业知识库问答时都会遇到同一个现象:系统刚上线时效果还行,跑了两周之后回答开始飘,用户反馈“答案好像对,但不敢用”。第一反应通常是换 embedding 模型、加 rerank、调 top_k、上重排序、换向量库,折腾一圈,检索指标可能好了一点,但最终答案还是不准。问题可能根本不在检索环节。
这个判断有点反直觉。做 RAG 的人通常把 80% 的精力放在检索上,因为检索是显性的、可调参数多的环节。但业界的公开数据不这么看。Gartner 在 2018 年做过一个预测:到 2022 年,85% 的 AI 项目会因数据、算法或团队管理上的偏差产出错误结果——这个数字说的不是失败率,而是结果出错,其中数据偏差被列在第一位。IDC 给出的数字是,非结构化数据占企业数据总量的 80%–90%,Gartner 进一步预测非结构化数据的增速约为结构化数据的 3 倍。CrowdFlower 在 2016 年的一份调研里发现,数据科学家约 60% 的时间用于清洗和整理数据,19% 用于收集数据集,9% 用于挖掘模式,真正用在建模上的时间不足 10%。Gartner 的另一个估算是,仅 12% 的企业数据质量足以支撑 AI 应用。
把这些数字摆在一起,结论很清楚:知识库问答的上限不是检索策略决定的,而是喂进去的数据决定的。检索只是把已有的数据块捞出来,如果数据块本身是残缺、错乱、缺上下文的,检索再准也只能捞出残缺的内容。真正该下功夫的,是检索之前的「知识编译」工序。
企业知识库项目在数据准备阶段通常踩四个坑。每一个坑都会直接作用在最终答案质量上,而且容易被“检索调优”掩盖。
分块不合理
固定长度硬切是最常见的做法,比如按 512 字符一刀切,或者按 300 token 截断。问题在于,语义单元很少恰好落在字符窗口内。一个合同条款可能被切成两半,一个操作步骤可能和它的前置条件分开,一个表格可能被横着切断。检索时召回的块只包含半个语义,模型只能根据片段拼凑答案,回答自然不完整,甚至产生幻觉。
这个坑最普遍,也最影响质量。
解析质量差
企业文档里表格、公式、多栏排版、扫描件占了很大比例。如果解析阶段只做纯文本提取,表格可能变成一行行乱码,公式变成无法识别的符号串,扫描件直接返回空文本或整页乱码。这些解析噪声会被原封不动写进向量库,检索时可能召回这些无效块,模型基于噪声生成答案。
解析质量直接决定了知识库的可信度。
元数据缺失
很多知识库只存储了 chunk 文本,没有记录章节、来源、文档类型、时间、权限等元数据。结果就是 Top-K 过滤只能靠纯向量相似度,无法做条件过滤。比如用户问“去年第三季度华东区的销售政策”,如果元数据缺失,系统只能返回几个和“销售政策”最相似的块,而无法先限制“去年”“华东区”这些条件。
检索精度被元数据严重拖累,最后只能靠模型临时判断,但模型对时间、区域这类条件并不敏感,很容易答错。
流程碎片化
一个典型的企业知识库项目要处理 PDF、Word、网页、表格、图片等多种格式。很多团队用不同工具分别处理:某个库做 PDF 解析,另一个做 OCR,再靠脚本拼接。每个步骤都可能引入格式不一致、信息丢失、重复处理等问题。
调试和迭代成本非常高,而且问题定位很难。碎片化流程让人很难系统性地优化数据质量,最后变成哪里漏了补哪里。
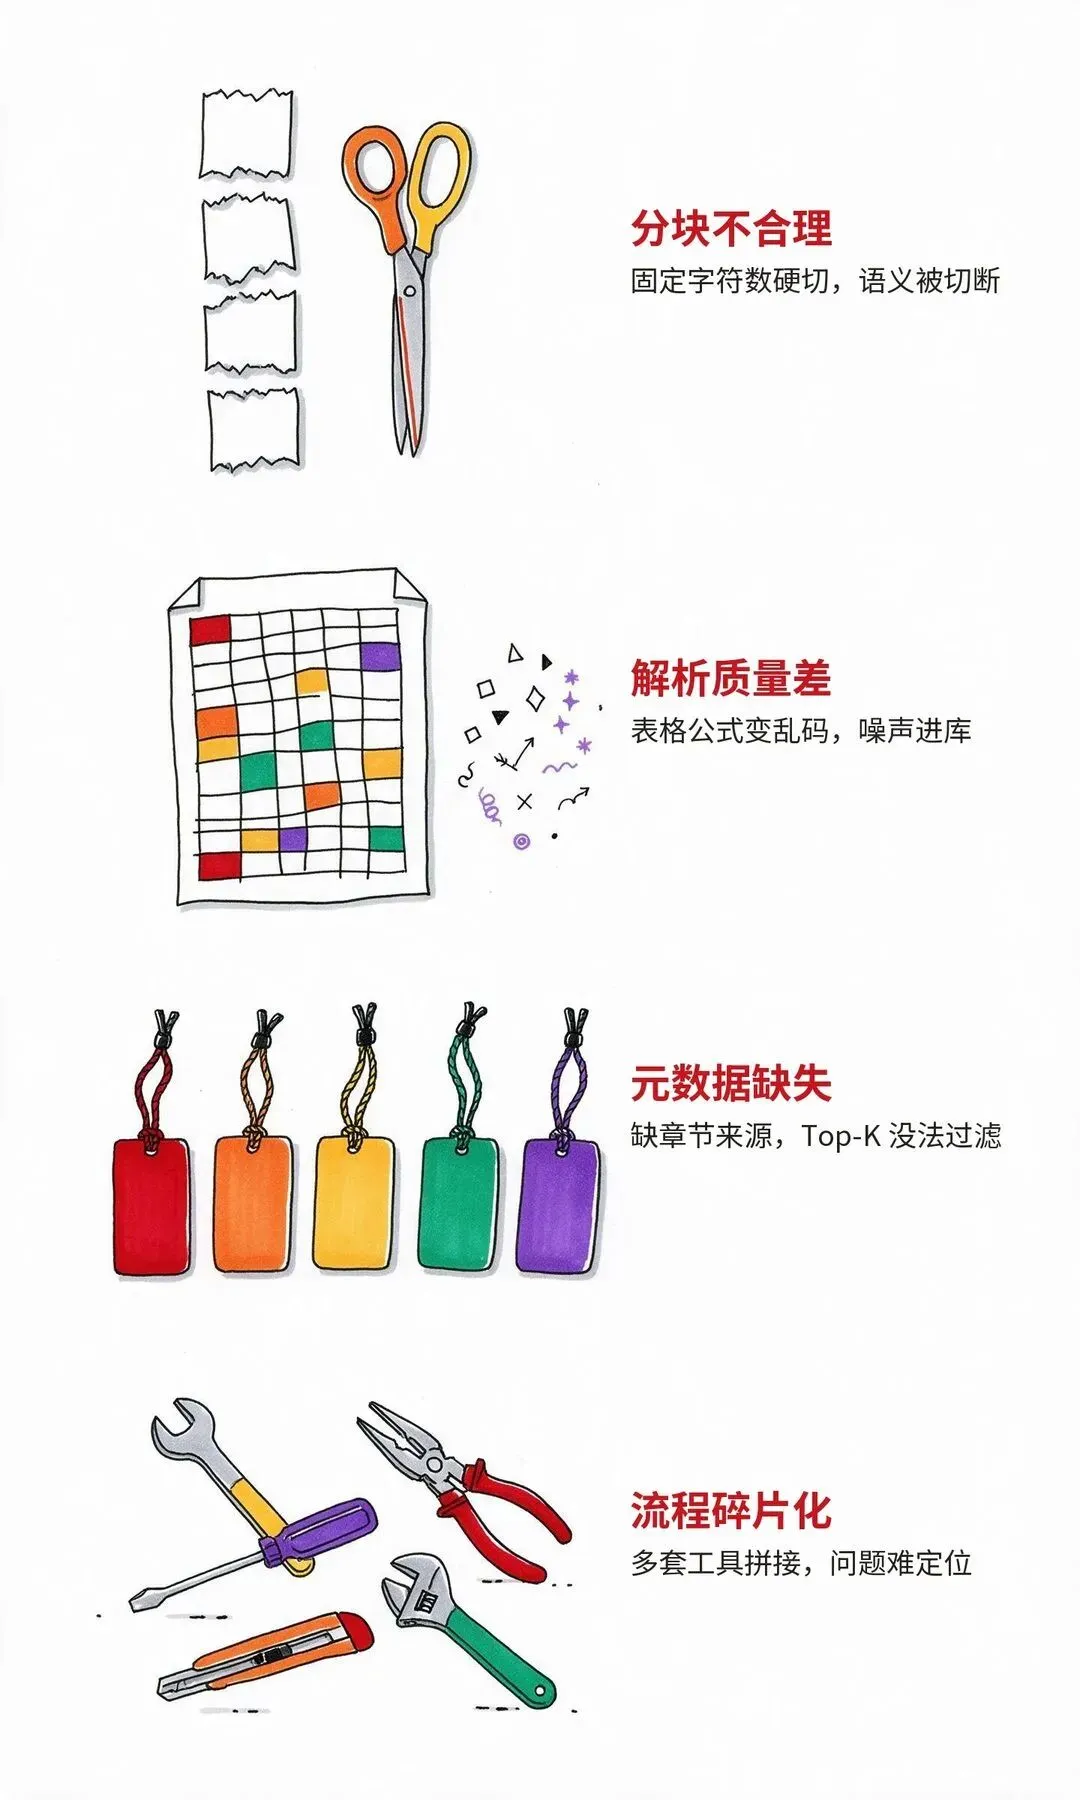
图1:数据准备阶段最常见的四个坑
四个坑里,分块不合理是最常见也最直接影响检索质量的一个。一个 chunk 既不能太大,否则关键信息被淹没;也不能太小,否则语义不完整。固定长度分块看似简单,实际上把语义边界交给字符数决定,等于放弃了数据中对检索最有价值的结构信息。
固定 512 字符硬切的问题,在长文档、结构化文档、技术手册里尤其明显。一个 API 文档可能一个参数说明就超过 512 字符,硬切会把参数名、类型、默认值、示例切成两个块。检索“这个参数默认值是多少”时,可能只召回参数名所在块,默认值在另一块,模型只能猜。这类问题靠调 embedding 和 top_k 解决不了。
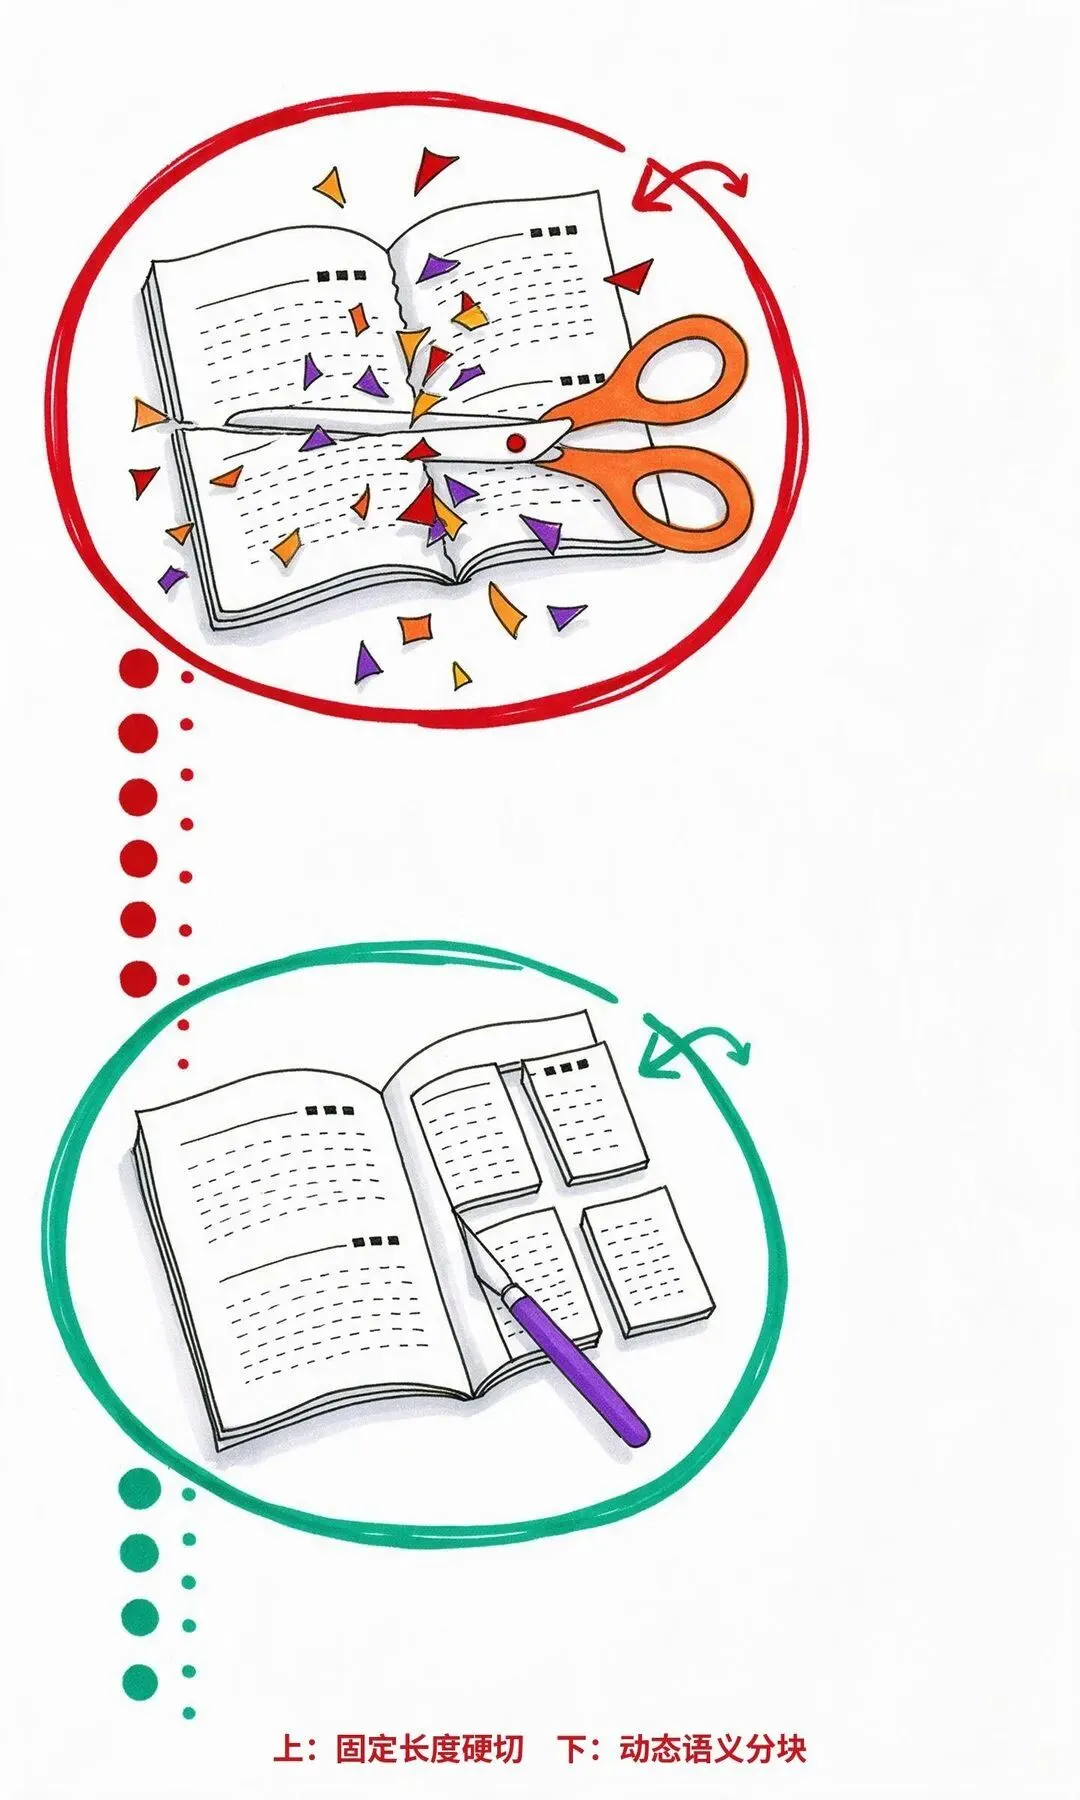
图2:同一本书,按字符数切与按语义切
动态语义分块要解决的是三个技术点。
语义边界定位
固定长度分块按照字符数切,语义边界定位则利用标题、段落、列表、表格、代码块等文档结构识别自然边界。比如一个二级标题下的所有段落可能形成一个完整语义单元,就不应该被拆开;一个步骤列表的各项之间有关联,也不应该从中间切断。实现方式可以是基于版面分析、DOM 结构或 NLP 模型判断句子间的语义断裂点。
这样切出来的块在召回时能提供完整的上下文,而不是一个句子的一半。
智能重叠
固定重叠字符数(比如每块重叠 50 字符)是常见做法,但重叠位置往往和语义无关,可能把一句话从中间截断。智能重叠只在语义关联处设置重叠,比如一个条款的延续、一个步骤的前置条件、或者一个公式的引用处。这样既保持了块之间的连贯性,又不引入无关内容。
重叠不是越多越好,固定重叠会带来大量重复向量,增加索引体积和噪声,智能重叠则只在真正需要的地方保留衔接。
父块上下文注入
每个子块除了自身内容,还携带所属父块的摘要或标题上下文。比如一个“3.2.1 参数配置”子块,在向量化时会附带“第三章:系统部署”的标题和目录信息,或者父块的前几行内容。这样检索时召回的块“有头有尾”,模型能看到它来自哪一章、在什么语境下被引用,回答时就能减少误解。
这个点很多团队没有做,但做与不做的效果差异很大。
根据社区案例的内部基准测试,固定长度分块作为基线(基线=100),动态语义分块在关键指标上的表现如下。
召回率(平均)
固定长度 100 → 动态语义 128+28%
问答准确率
固定长度 100 → 动态语义 122+22%
Recall@5(BEIR 基准)
固定长度 100 → 动态语义 125+25%
Top5 无关块占比
固定长度 100 → 动态语义 88-12%
测试口径为单机私有化部署,基线=100。这组数据是单机实测,样本规模与复现方式未公开,只作方向性参考。除上述四项外,该测试中版式还原度达到 95% 以上,表格结构识别准确率为 92%。这些数据说明,分块策略的改进带来的提升,远大于在检索环节调参的常规收益。
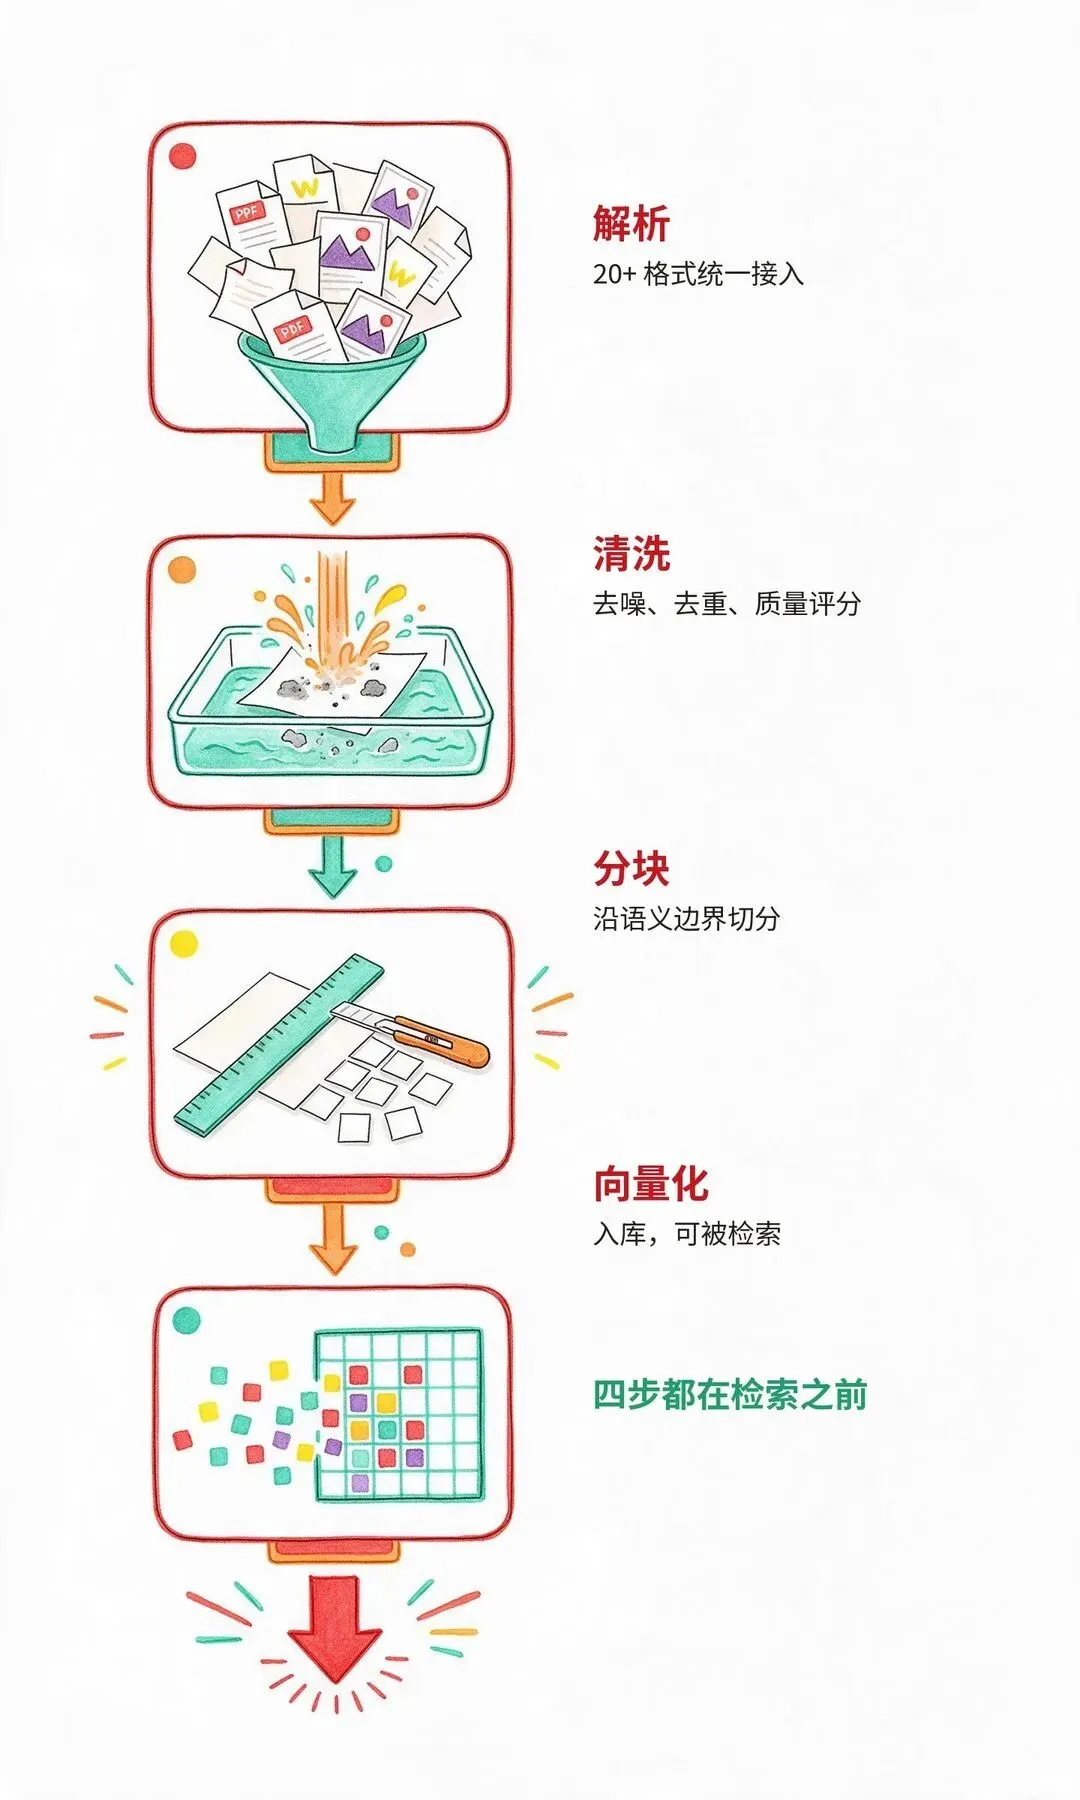
图3:从原始文档到可检索入库的四道工序
知识库的核心工序不是调检索,而是把数据编译好。
解析、清洗、分块、向量化,每一步都在检索之前。检索只是最后一步,不能把全部功夫花在最后一步。很多项目效果不好,不是 RAG 不够强,而是喂进去的数据不够干净。先把数据准备这道工序做扎实,后面的检索和生成才有发挥空间。金仓 KES 的向量能力——原生向量类型、SQL 内向量加关系条件过滤,再加上配套的权限与审计——是检索这一侧的基础设施,可以作为落地时的一个参照。先把数据准备这道工序做扎实,后面的检索和生成才有发挥空间。
本文第三方数据来自 Gartner、IDC、CrowdFlower 公开调研:Gartner 85% 为 2018 年针对“到 2022 年”的预测(指结果出错,非项目失败率);CrowdFlower 数据出自 2016 年 Data Science Report,样本约 80 人,方法学此后有争议;12% 一说有多个转引来源。内部基准数据来自社区案例,测试口径为单机私有化部署、基线=100。