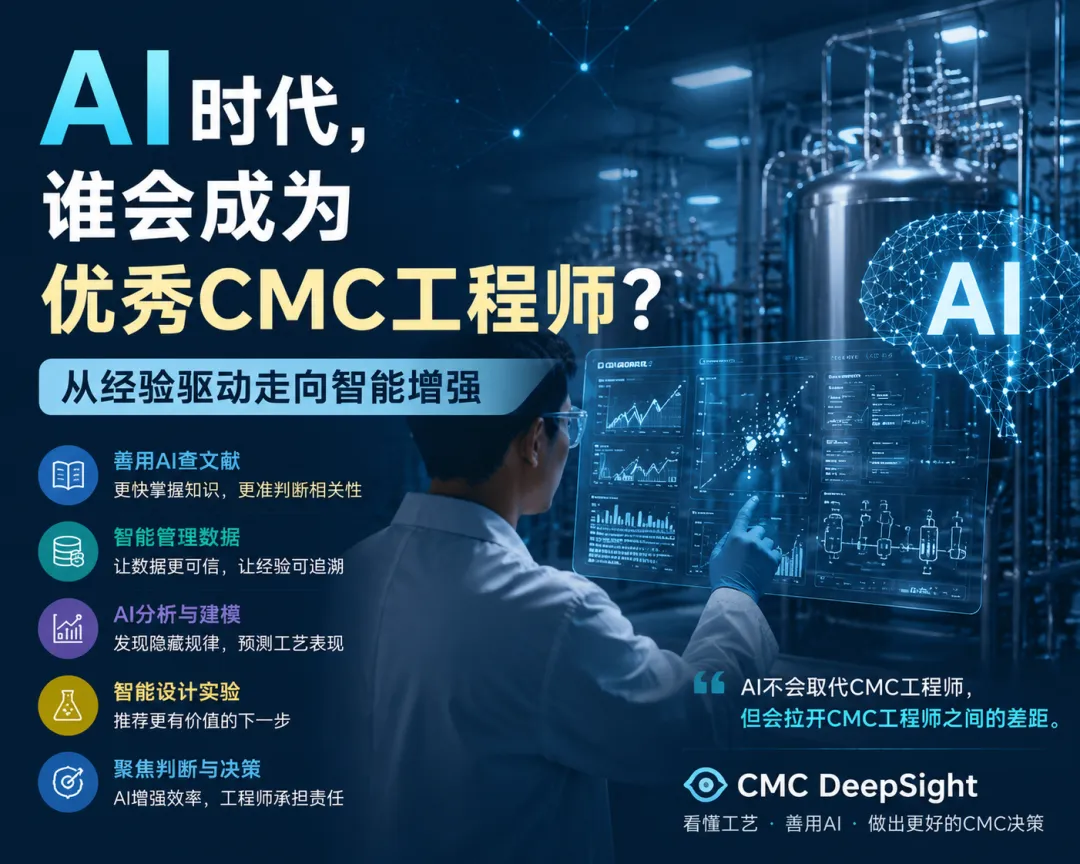
——从经验驱动到智能增强,CMC能力正在发生什么变化
AI会不会取代CMC工程师?
在药物发现领域,AI已经能够预测蛋白质结构、辅助设计抗体序列,并从海量化合物中筛选候选分子。许多过去高度依赖经验和运气的工作,现在可以先在计算机中完成一轮筛选。但在同一条生物药价值链上,AI在CMC端的应用明显还处于早期。无论是工艺开发、技术转移、放大生产还是质量控制,AI能够承担的工作都在快速增加,但距离真正“替代CMC工程师”仍有相当距离。原因并不是CMC比药物发现更保守,而是CMC面对的对象更加复杂:活细胞、复杂物料、真实设备、尺度效应,以及无法完全消除的批次差异。这里的数据天然嘈杂,变量之间相互影响,很多结论还必须通过实验验证,并最终进入生产和质量体系。因此,“AI会不会取代CMC工程师”可能并不是最准确的问题。AI会先改变CMC中的哪些工作?当大量执行性工作被AI提速甚至替代之后,CMC工程师的价值将转移到哪里?
AI不会整体取代CMC工程师,但会取代一部分重复、标准化和低判断密度的工作,并重新定义什么才是优秀的CMC工程师。
CMC为什么既需要AI,又难以被AI取代
一个商业化生物药,从细胞培养、分离纯化、制剂开发到生产放行,会持续积累大量数据:但数据量的快速增长,并没有同步提升工程师理解和利用数据的能力。很多企业并不缺少数据,真正缺少的是把分散数据转化为工艺理解的能力。数据可能分布在不同系统、不同报告和不同人员手中,命名、单位和采样方式也未必一致。一些关键知识甚至只存在于资深工程师的经验中,没有被结构化,更没有形成可以复用和验证的知识体系。AI可以帮助工程师更快地阅读信息、整理数据、发现规律、建立模型和筛选实验方向。但是,CMC的最终目标不是生成一份看起来合理的分析报告,而是形成能够用于产品和工艺的可靠结论。一个结论是否可以用于CMC决策,至少需要回答四个问题:因此,CMC应用AI的真正难点,往往不是模型不够先进,而是数据、机理、验证和质量责任还没有形成闭环。查找文献:AI擅长梳理,但不能替代相关性判断
过去要摸清一个课题的公开文献、监管要求和技术先例,可能需要一个团队花费几天时间。现在借助语言模型,可以很快获得一份初步文献综述、竞品公开信息对比,或者相关法规条款的整理。但语言模型可能编造文献、混淆数据来源,也可能把适用于其他分子、细胞株或表达系统的结论直接套用到当前项目中。AI能够帮助工程师缩小检索范围、整理信息和形成初稿,却无法可靠判断某项研究与当前项目是否真正相关。因此,用AI做文献调研,是提高工作的起点,而不是取消核实和专业判断。管理数据:AI能够执行标准,但标准必须由人定义
CMC数据经常分散在不同批次、不同设备和不同分析系统中。字段名称不统一、单位不一致、人工转录错误和缺失值,都会影响后续分析。AI和自动化工具可以帮助完成数据提取、字段映射、单位转换、异常提示和跨系统关联,从而减少大量重复劳动。但数据治理的核心并不是“如何把数据存起来”,而是“哪些数据可以被信任”。AI可以稳定地执行已经明确的规则,却不能代替工程师决定什么才是合理的数据标准。分析数据:AI能够发现信号,但信号不等于证据
在大量历史批次数据中,某个物料属性、过程参数与产品质量属性之间的潜在关联,可能很难通过人工查看趋势图发现,但多变量分析和机器学习模型能够更早识别这些信号。假设模型发现,培养基中某种微量元素的水平与产品半乳糖基化比例高度相关。仅凭这一结果就调整培养基配方,并不能构成可靠的CMC决策。微量元素变化是否同时伴随细胞生长、渗透压或培养周期变化?AI发现的是信号。工程师需要完成的,是从信号到证据、从证据到机理,再从机理到控制策略的闭环。如果把模型给出的重要变量直接当作根因,最大的风险不是模型“不够准确”,而是我们赋予了相关性并不具备的因果意义。建模预测:模型只能看见它见过的世界
混合模型和数字孪生正在为工艺预测、放大和优化提供新的工具。过去可能需要多个工程批次才能探索的规律,现在可以先通过模型进行模拟,缩小真正需要实验验证的范围。这有助于减少无效实验,也能让工程师更系统地比较不同工艺方案。模型通常只能在训练数据覆盖的范围内保持相对可靠。一旦面对新的细胞株、未使用过的原材料组合、不同尺度的设备或者极端工艺条件,预测就可能变成外推。真正危险的并不是模型给出错误结果,而是模型以一种看起来非常确定的方式给出错误结果。分辨“模型正在可靠预测”还是“模型正在超出经验范围推测”,仍然需要工程师具备底层的工艺理解。辅助实验设计:AI能推荐实验,但不能替你定义问题
贝叶斯优化、主动学习和其他实验优化方法,可以在给定目标和约束的前提下,推荐下一轮最有信息量的实验条件。它们能够帮助工程师减少“凭经验排实验”的盲目性,使有限的实验资源获得更高的信息回报。如果问题定义错误,算法只会更高效地回答一个错误的问题。AI可以帮助我们用更少的实验寻找答案,却不能替代工程师决定什么问题值得回答。AI改变的是工作分工,不只是工作效率
AI在信息检索、数据整理、模式识别、预测计算和方案生成方面进步很快;但在问题定义、证据判断、机理解释和风险决策方面,仍然需要工程师承担主导作用。因此,AI对CMC的影响不会仅仅表现为“工作更快”。部分重复、标准化和低判断密度的工作会逐步被自动化,例如:这意味着,一些以“熟练执行”为主要价值的岗位内容可能会减少。但与此同时,问题定义、跨数据源整合、模型边界判断、实验验证和风险决策的重要性会进一步上升。AI不会消除CMC工程师的价值,却会推动这种价值从“完成任务”向“形成判断”转移。真正被拉开的,是决策闭环的能力
未来CMC工程师之间的差距,不会简单地取决于谁更会使用某一个AI工具,也不会取决于谁掌握了更多提示词。工具会迅速迭代,今天熟悉的平台可能很快被新的平台替代。真正具有长期价值的,是把专业经验、可信数据、适用模型和实验验证连接起来,形成高质量决策闭环的能力:提出正确问题↓准备可信数据↓选择合适方法↓判断模型边界↓设计验证实验↓形成可解释、可追溯的CMC结论
工程师不一定需要亲自开发复杂模型,但必须能够理解模型在做什么、依赖什么数据、可能在哪里出错,以及输出结果能否支持实际决策。未来优秀的CMC工程师,仍然首先是工艺专家,只是需要在原有专业能力之上,建立理解数据、使用模型、识别边界和设计验证的能力。AI不会替代责任,也不会自动产生洞见
什么风险值得继续调查,什么证据已经足够,一个变更是否可以实施,一项结论能否进入控制策略——这些决策最终需要有人判断、签字并承担责任。AI可以提供信息,却不能承担质量责任;可以生成建议,却没有资格替代最终决策。CMC专业能力决定我们能否提出正确的问题;数据和模型帮助我们更快找到可能的答案;机理理解、证据判断和质量责任,则决定这些答案能否真正用于产品和工艺。但它会取代一部分重复、标准化和低判断密度的工作,也会让仅仅依靠过去经验、拒绝使用新工具的工作方式越来越缺乏竞争力。真正被AI拉开的,不是谁更会操作某一个工具,而是谁能够把经验、数据、模型和验证连接起来,形成更加系统、可复制、可验证的科学决策能力。它会让真正有价值的经验,以更高效、更系统的方式发挥作用。 夜雨聆风