ARTICLE · 1050456
Flink 1.20 源码解读:Operator State 到底存在哪里?
这个问题之所以容易混淆,是因为我们经常把两个概念放在了一起:
Runtime State 存在哪里? Checkpoint 数据存在哪里?
实际上,这是两件不同的事情。
本文不从 Checkpoint 基础概念讲起,而是直接从Flink 1.20 源码出发,沿着DefaultOperatorStateBackend的 Snapshot 流程往下追,看看 Operator State 是如何从 JVM Heap 一路变成 Checkpoint 中的StateHandle的。
一、先搞清楚:Operator State 到底存在哪里?
Flink 的 State 大体可以分为两类
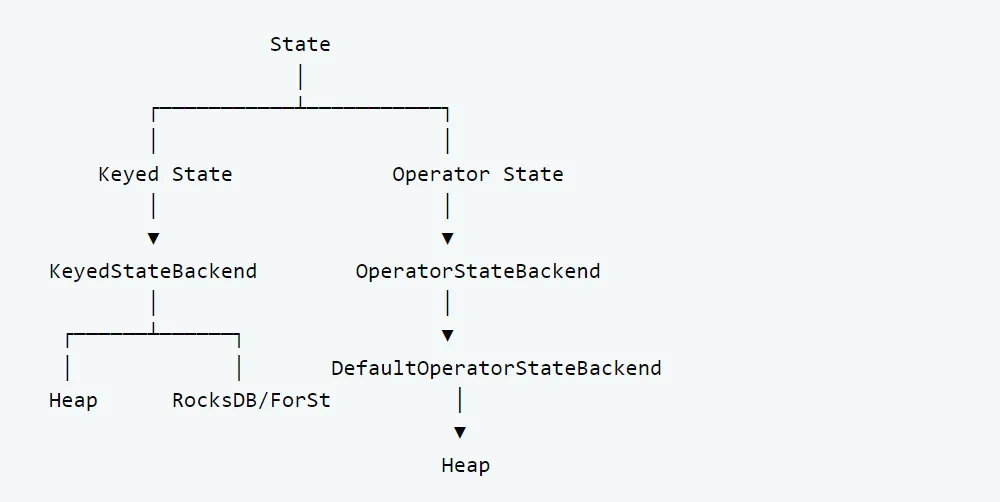
Keyed State 和 Operator State 并不是同一个 Backend。
Keyed State 对应:KeyedStateBackend
而 Operator State 对应:OperatorStateBackend
在 Flink 1.20 中,Operator State 的默认实现是:DefaultOperatorStateBackend
它基于 JVM Heap 管理运行时的 Operator State。
所以,如果一个 Job 同时使用 RocksDB/ForSt 管理 Keyed State,那么运行时完全可能是
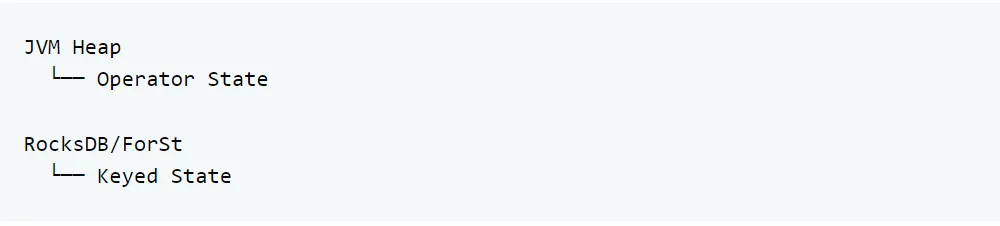
这并不矛盾。
但这里还有第二个问题:
既然 Operator State 在 Heap,那么 Checkpoint 是不是也在 Heap?
答案仍然是否定的。
因为State Backend 和 Checkpoint Storage 是两个不同的抽象。
可以简单理解为
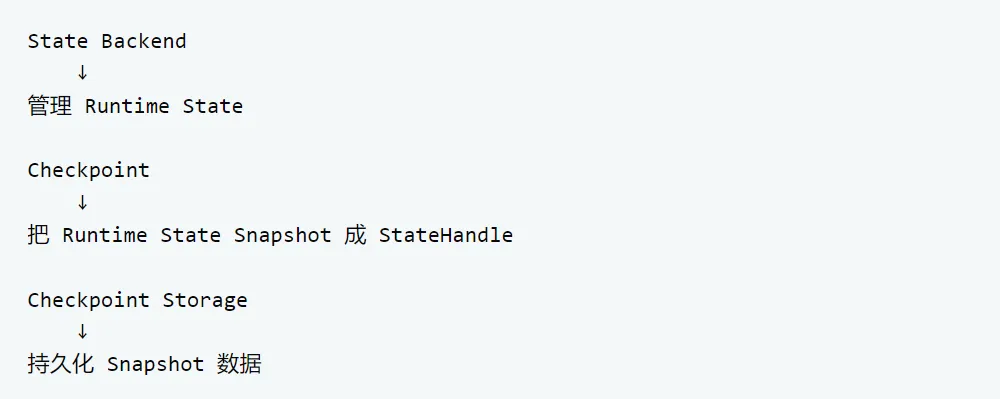
所以 HDFS、S3、OSS 等描述的是Checkpoint Storage,而不是 Operator State Runtime Backend。
二、从snapshot()追进去:Checkpoint 到底做了什么?
知道 Operator State 运行时由DefaultOperatorStateBackend管理之后,直接从它的snapshot()开始追
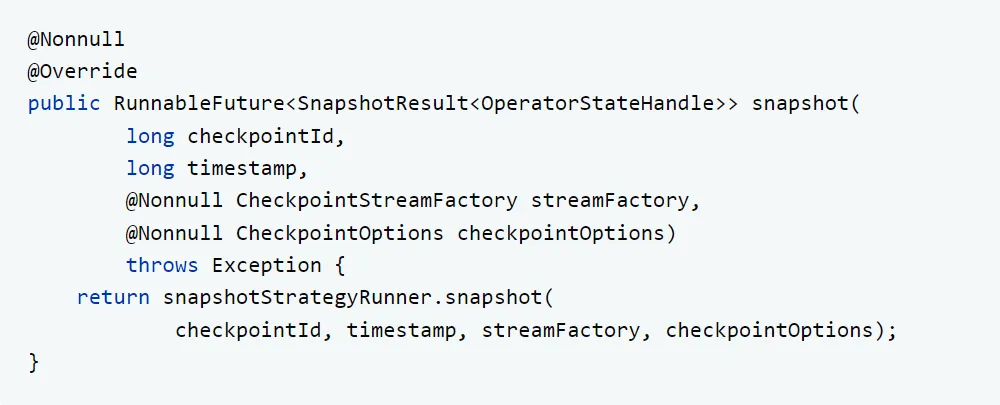
前者负责具体的 Snapshot 流程,后者则是 Runtime State 和 Checkpoint Storage 之间的重要桥梁。
继续往下看,可以看到 Snapshot 被拆成了同步准备和异步写出两个阶段
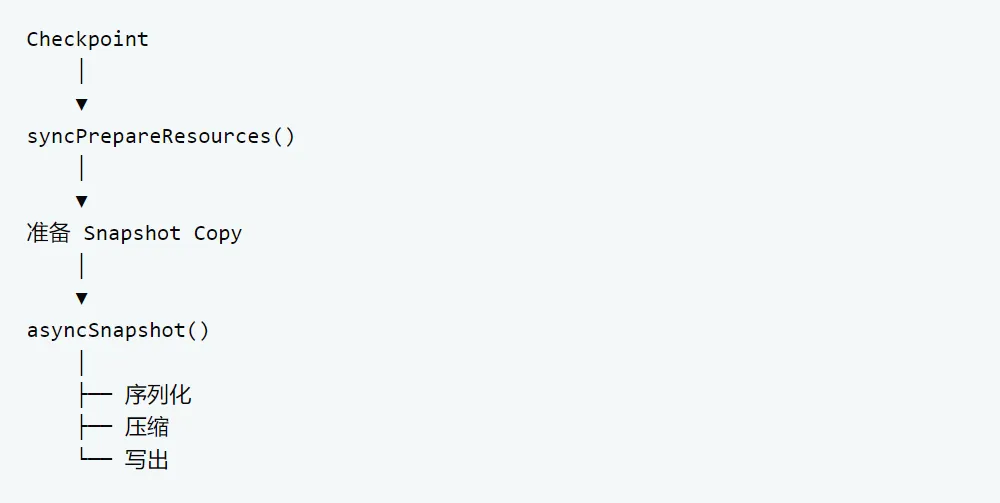
同步阶段:syncPrepareResources()中最关键的代码就是
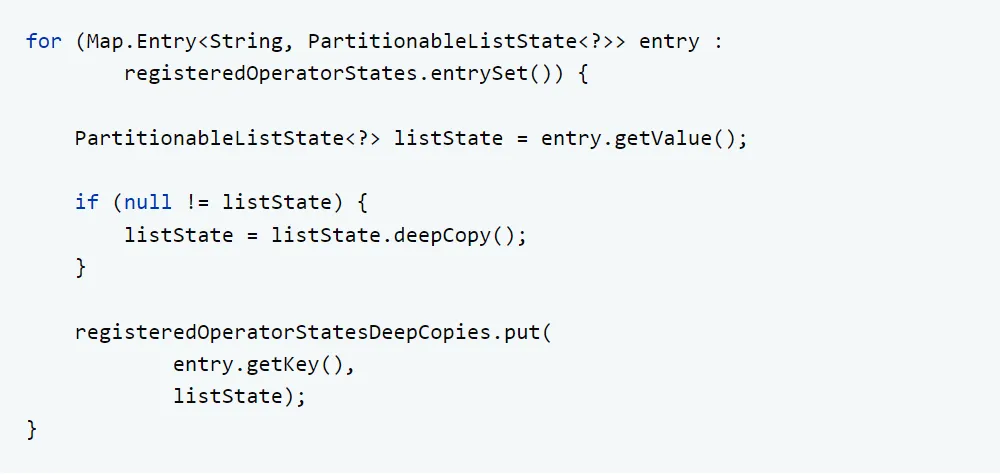
Checkpoint 开始时,并不是立即把 Heap 中的 State 写到 HDFS/S3,而是先在 JVM 内存中创建一份 Snapshot Copy。
也就是
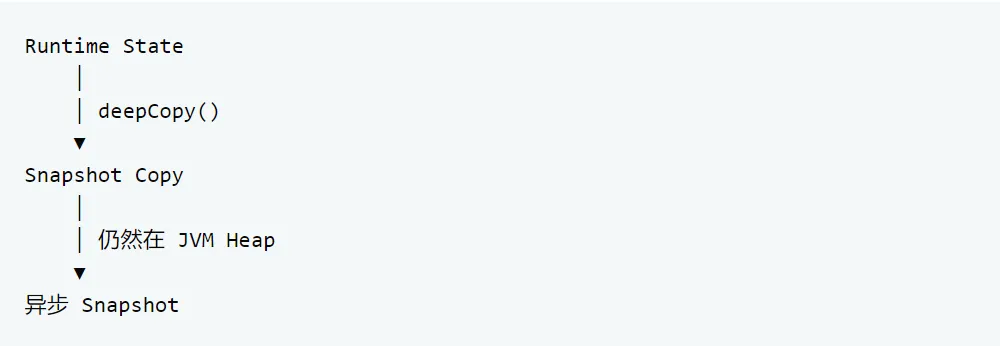
因为 Operator State 还在不断被 Operator 修改。
如果异步 Snapshot 线程直接读取运行中的 State,就可能出现
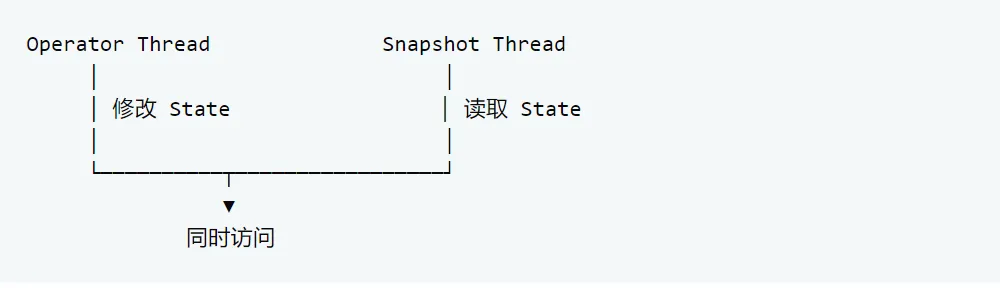
因此 Flink 先在同步阶段创建一份稳定的 Snapshot 数据,之后异步线程只读取这份 Copy。
三、deepCopy()到底复制了什么?
这里继续往PartitionableListState里面追。
它的拷贝构造方法非常直接
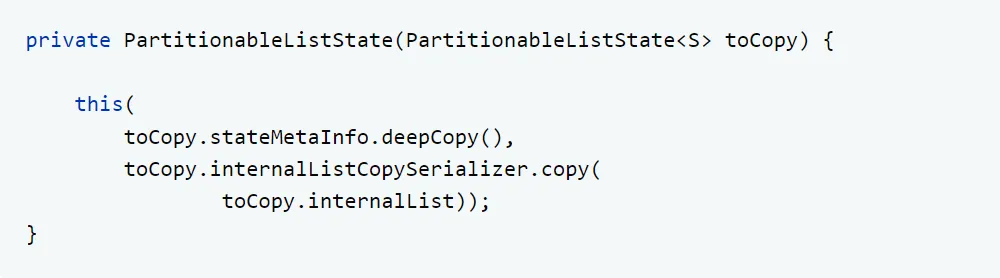
第一部分:复制 State 元信息

复制的是 State 的元信息。
State 并不仅仅是一份数据,还需要知道对应的 State 名称、Serializer、Assignment Mode 等信息。
这些信息最终都会参与 Snapshot 和 Restore。
第二部分:复制 State 数据
更重要的是:
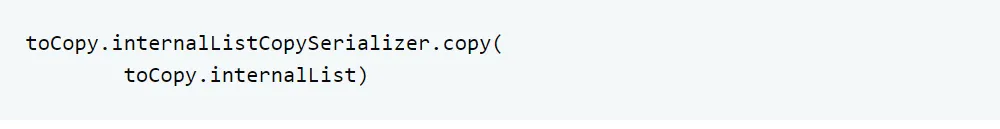
这里通过internalListCopySerializer对真正的数据进行 Copy。
因此:
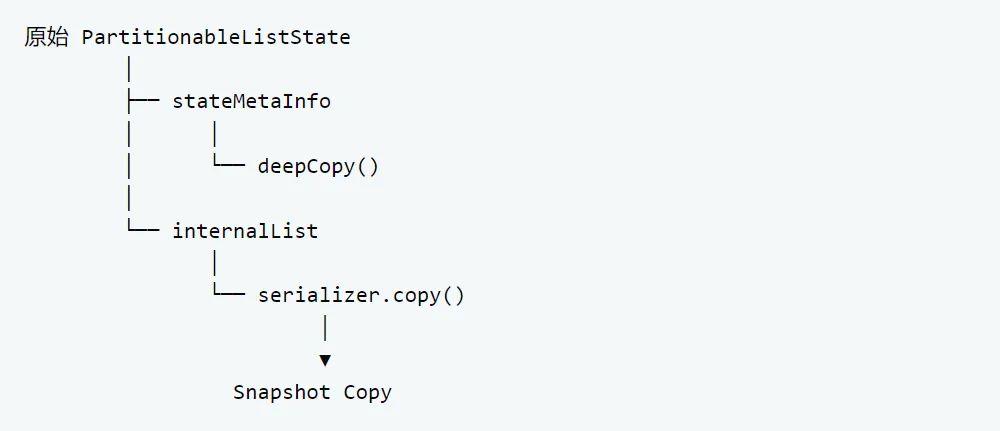
所以deepCopy()并不是:

而是:
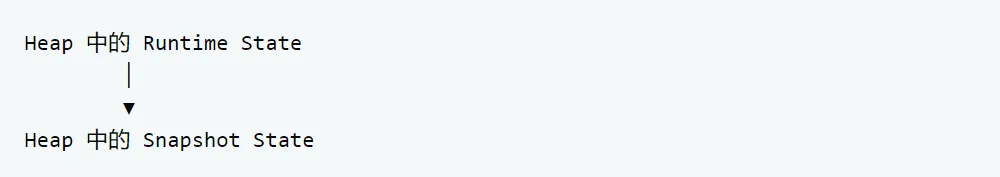
这也是理解 Flink Checkpoint 的一个关键点。
四、从 Heap 到 Checkpoint Storage:完整链路
有了 Snapshot Copy 之后,才进入真正的异步 Snapshot。
asyncSnapshot()中首先通过:CheckpointStreamFactory创建:CheckpointStateOutputStream
核心代码:
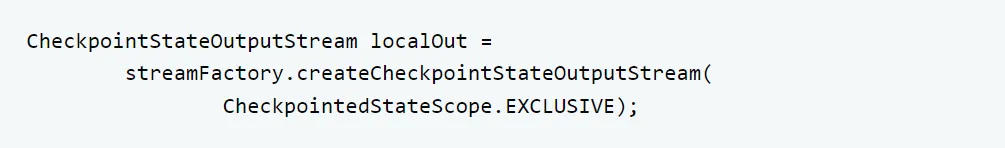
然后对前面准备好的 Snapshot Copy 进行写出:
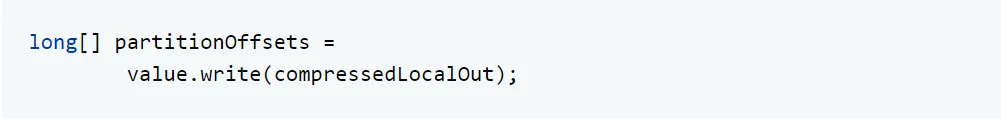
这里的:value.write(...)
才是真正开始把 State 数据序列化到 Checkpoint Stream。
随后:
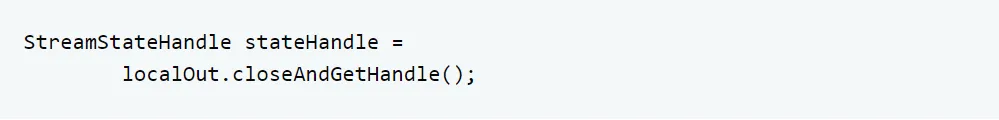
得到:StreamStateHandle
最后再包装成:
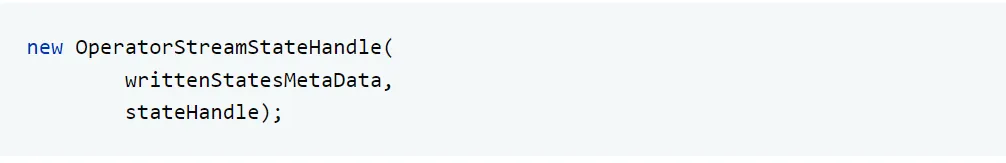
于是,完整链路就出来了:
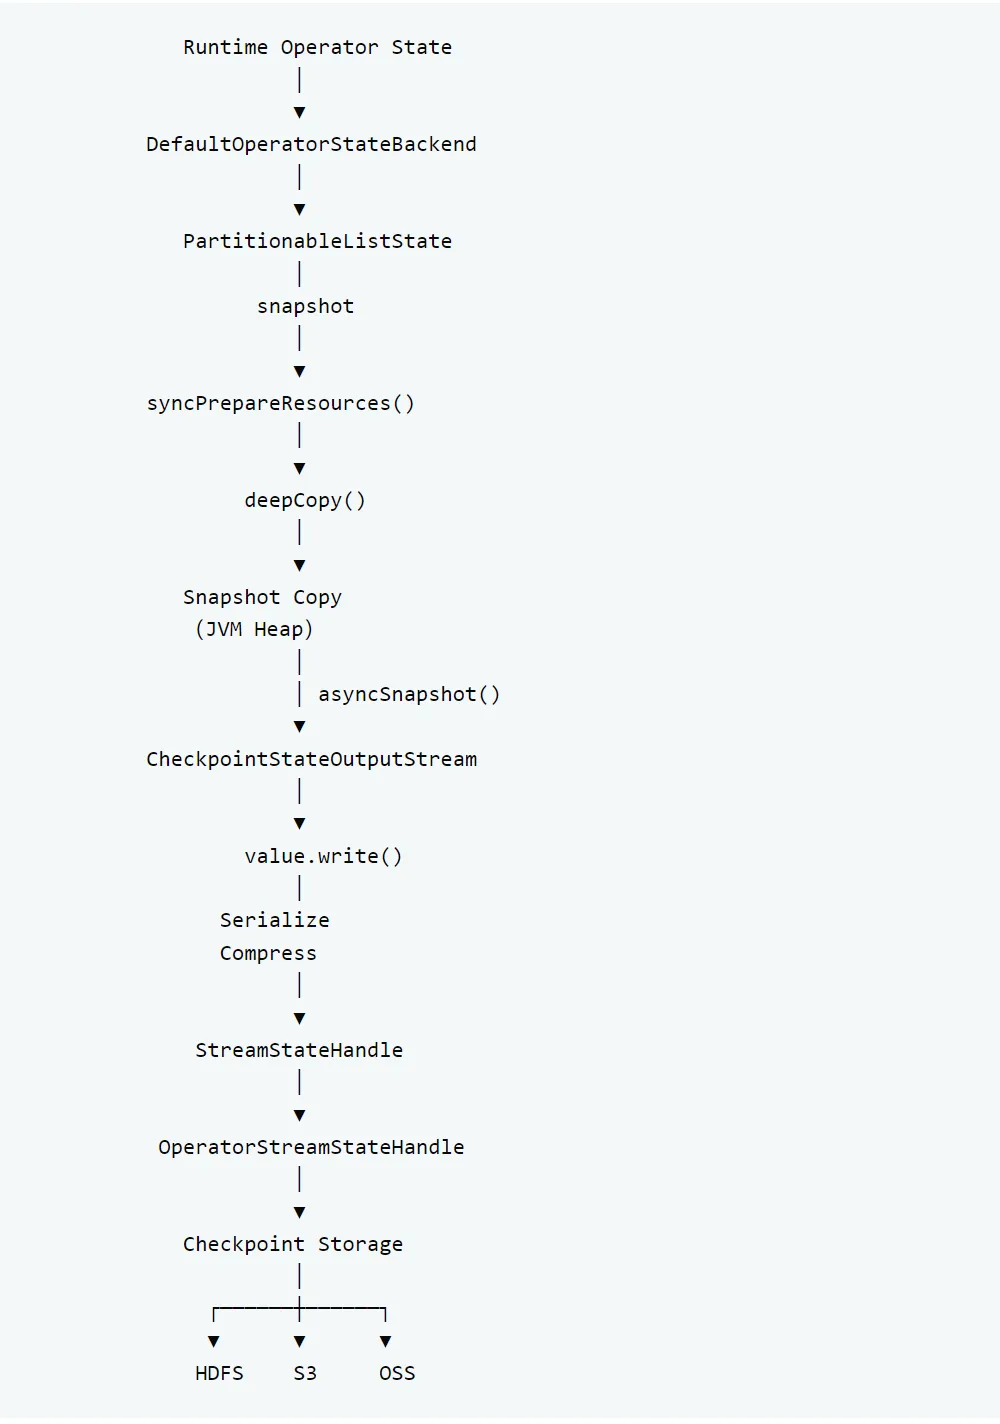
这条链路非常重要。
因为它把几个经常被混为一谈的概念彻底拆开了:
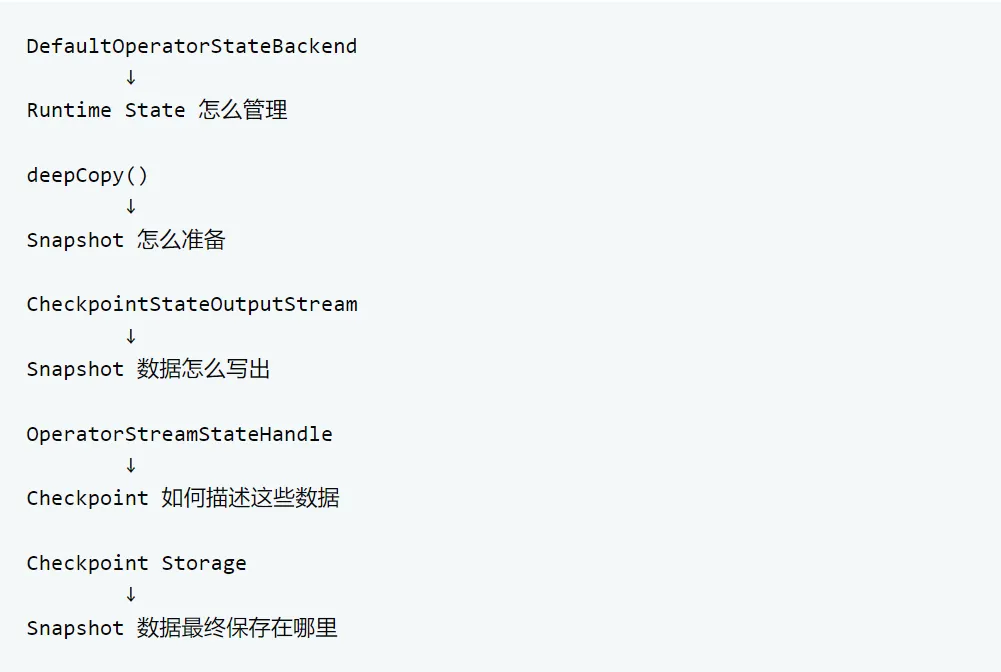
五、为什么还需要 partitionOffsets和 AssignmentMode?
在asyncSnapshot()中还有一个容易被忽略的细节:
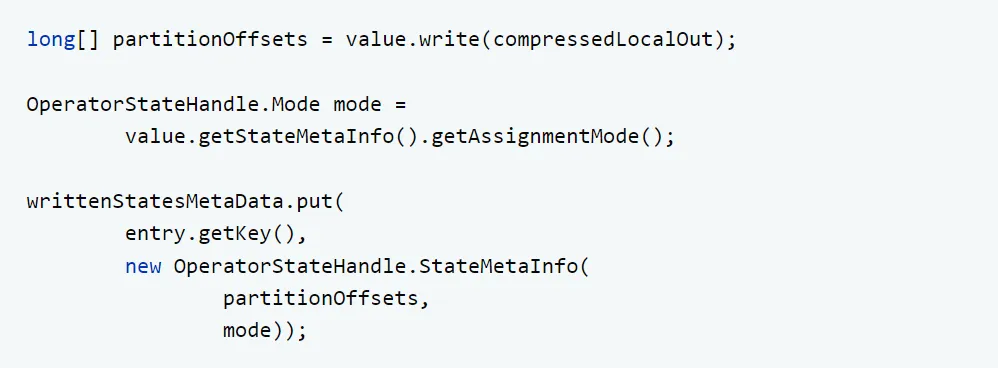
这里保存的不只是 State 数据本身,还保存了:
Partition Offset Assignment Mode State Name State Metadata
原因在于 Operator State 和 Keyed State 的恢复模型不同。
Operator State 需要考虑 Operator Subtask 之间的重新分配。
例如:
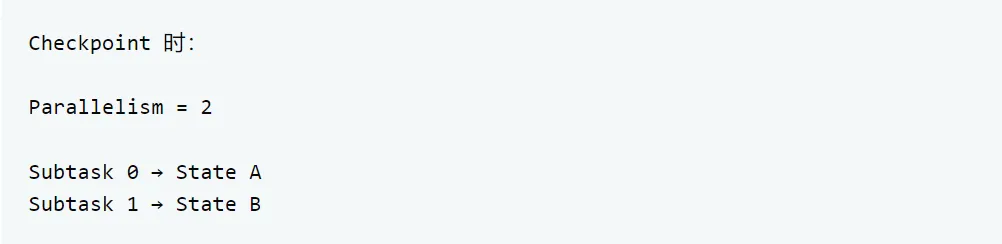
恢复时可能变成:
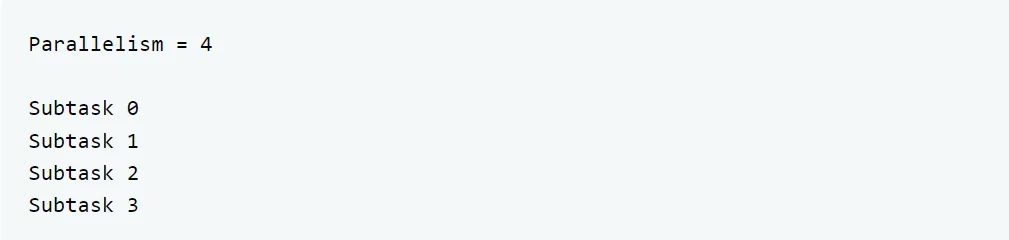
此时不能简单地把原来的 State 原封不动地交给某一个 Subtask。
Flink 需要根据 Operator State 的 Assignment Mode 和 Partition 信息重新分配。
所以OperatorStreamStateHandle并不是简单的“文件句柄”,而是:
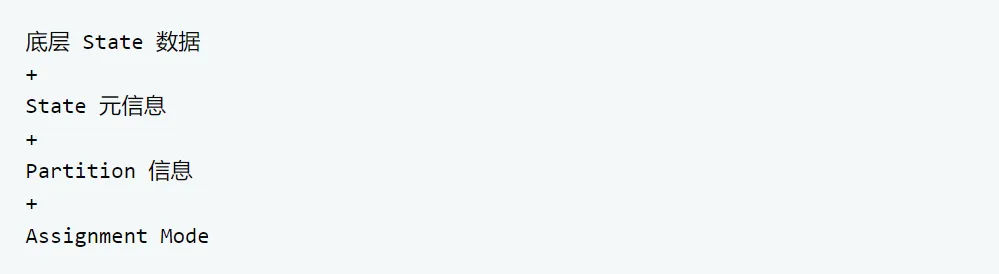
共同组成恢复 Operator State 所需的信息。
六、最后重新回答:Operator State 到底在哪里?
现在可以把最开始的问题完整回答了。
假设:
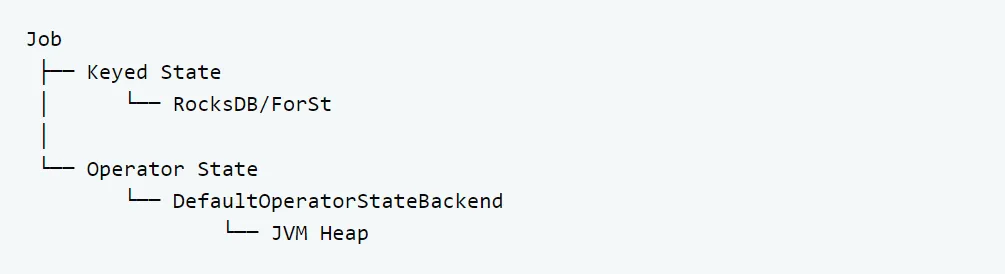
那么运行时:
Keyed State 可以由 RocksDB/ForSt 管理,而 Operator State 默认由 DefaultOperatorStateBackend基于 Heap 管理。
Checkpoint 时:
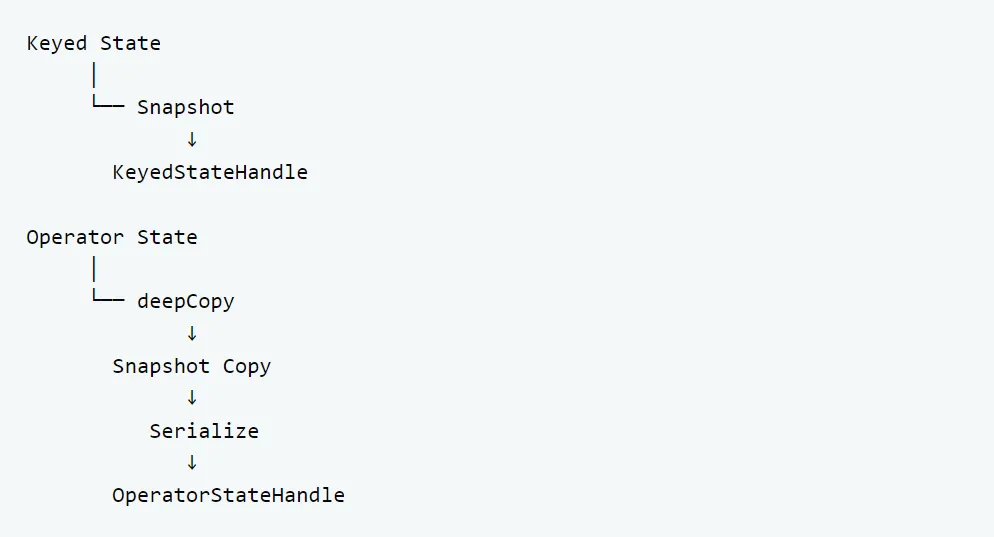
最后它们都可以进入:
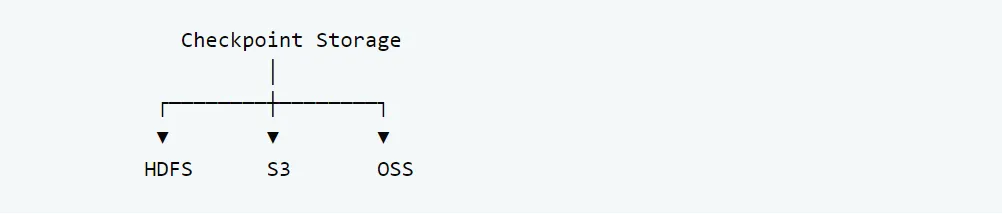
因此:
RocksDB/ForSt 是 Runtime State 的存储实现,而 HDFS/S3/OSS 是 Checkpoint 数据的持久化位置。
Checkpoint 并不是简单地把 JVM Heap 中的 State 对象直接写到 HDFS,而是经历:
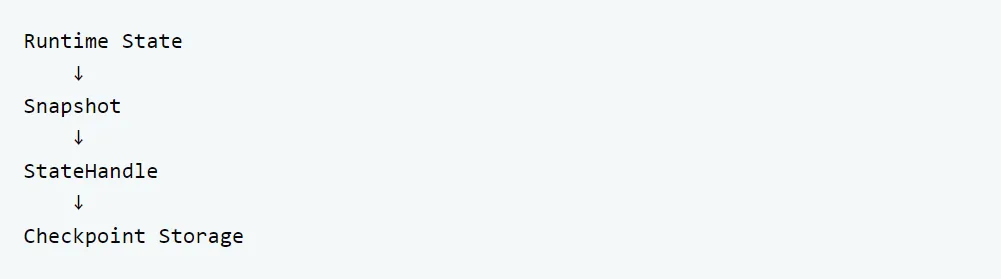
七、总结
从 Flink 1.20 的源码一路追下来,Operator State 的 Checkpoint 流程可以浓缩成下面这张图:
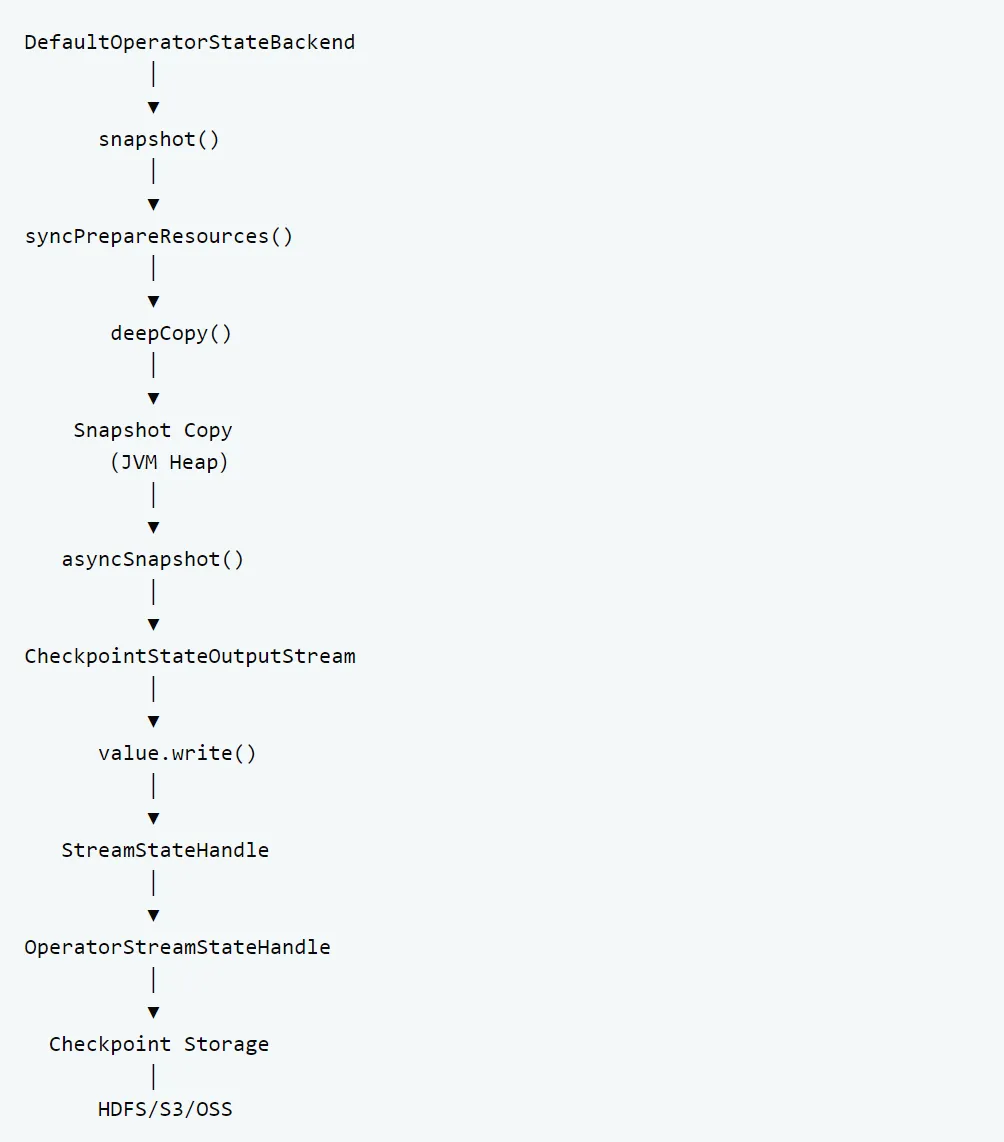
其中最值得记住的是三个层次:
1. Runtime State: State Backend 负责管理。
Operator State 在 Flink 1.20 默认由:DefaultOperatorStateBackend
管理,运行时主要位于 JVM Heap。
2. Snapshot: Checkpoint 把 Runtime State 转换成可恢复的 Snapshot。
对于 Operator State,首先通过:deepCopy()准备一份稳定的 Snapshot Copy,然后异步进行序列化和写出。
3. Checkpoint Storage: 负责保存 Snapshot 数据。
最终形成:OperatorStreamStateHandle等 StateHandle,并由 Checkpoint Storage 持久化到 HDFS、S3、OSS 等外部存储。
所以一句话总结:
State Backend 决定 Runtime State 怎么管理,Checkpoint 决定 Runtime State 怎么 Snapshot,而 Checkpoint Storage 决定 Snapshot 数据最终保存在哪里。