ARTICLE · 1051096
AI 编程工具的出口数据审计:Agent 出口治理的边界
从 ZCode 快照外发说起:企业网关为什么对这条出口链路完全失明
一、一次真实的快照外发
9 月 18 日,智谱旗下的 AI 编程工具 ZCode 被社区开发者质疑"静默上传"代码数据。按官方声明,问题出在"代码库索引"功能上:该功能默认开启,在云端生成 Repo Wiki(代码仓库知识库)页面时会触发仓库数据上传——也就是说,开发者本地的仓库快照,在多数人不知情的情况下出了本机,流向厂商的云存储。9 月 21 日,ZCode 公开致歉并整改:移除 Repo Wiki 功能、切断本地仓库快照生成与上传链路,同时把代码开源交给社区监督,并请中国信息通信研究院与绿盟科技审计,确认云端存储桶"零数据"、不再存在可触发快照或文件外发的功能路径。三天走完"致歉—整改—开源—第三方审计",这个响应速度在同类事件里算得上体面。
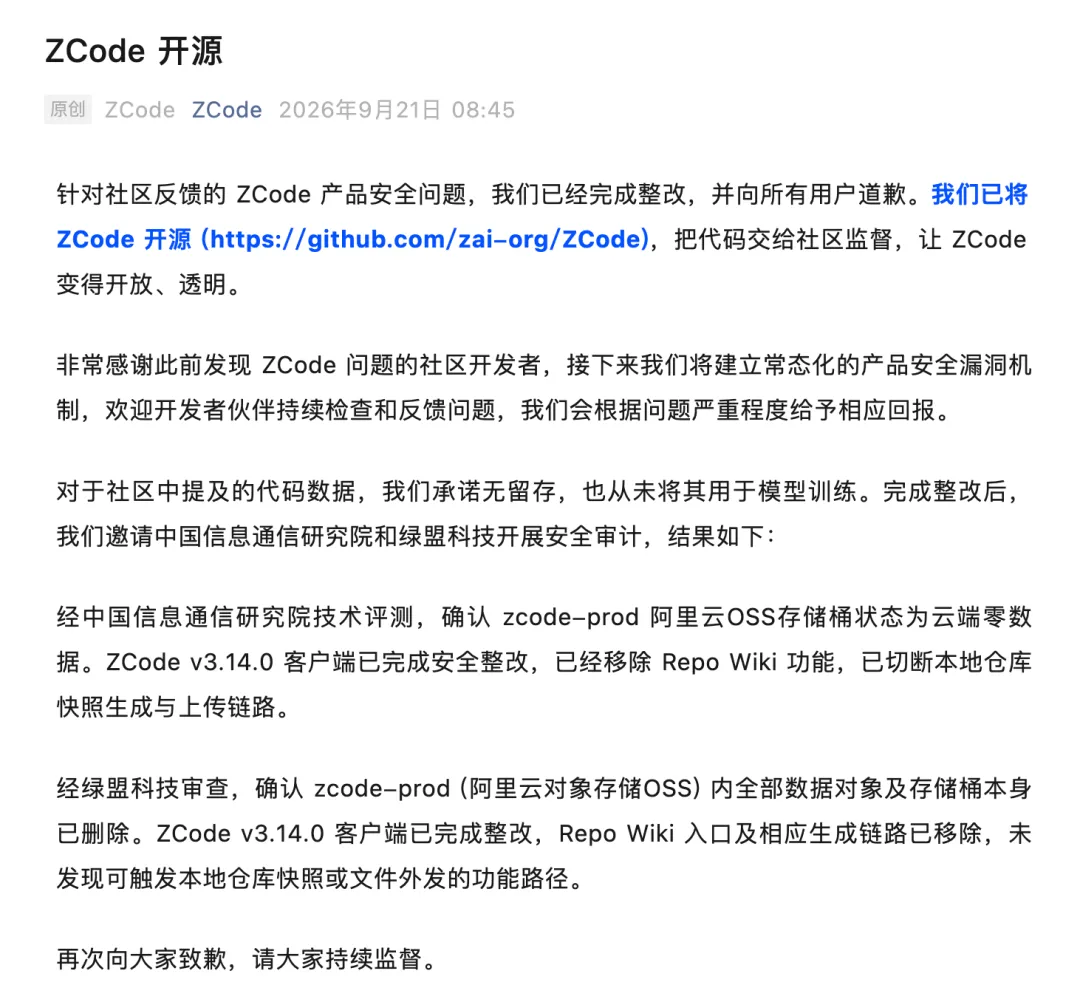
但对企业侧来说,真正扎眼的不是厂商怎么收场,而是这条出口链路的位置:它既不是研发显式贴给模型的 prompt,也不是某个工具调用的返回,而是客户端自带的一条外发链路,走的是厂商自己的基础设施。企业精心配置的出网白名单在它面前完全失明——上传方是工具自身,目的地往往还是研发早已放行的域名。有从业者把相邻的问题说得很直白:光有白名单拦不住泄露,一个被注入的 agent 可以借你早已放行的某个服务的自由文本字段把数据带出去(Deepak Gupta,《Egress Control for AI Agents》);PromptArmor 也持同一判断:域名白名单是防 agent 出网泄露的首要防线,但网络出网只是其中一层。要划的界线在这里:动作层守"能不能发到那个目的地",内容层守"这次请求到底带走了什么"——白名单管前者,审计管后者,两者正交。而仓库快照外发这一类,两层都看不见。
二、动作层守"能不能做",内容层守"带走了什么"
企业 AI 安全的防护通常分两层,但这两层的边界长期被混为一谈。一层是动作层,解决"Agent 能不能做某件事":哪些工具可被调用、是否允许出网、凭据有没有明文躺在配置里。这一类靠端点检测与执行层拦截去守,业界讨论得已经相当充分。另一层是内容层,解决"即便允许出网,这次请求究竟带走了什么":系统提示里嵌着的组织上下文、检索增强召回的相邻仓库代码、MCP 工具返回里混着的生产数据、环境变量里的内部域名——这些载荷和"调用了哪个工具"完全是两件事。OWASP 在 GenAI Top 10 里把 LLM01(提示注入)和 LLM02(敏感信息泄露)分开列,反映的正是这层区分:注入是"动作"被操控,泄露是"内容"被带出,根因不同、处置也不同。拦截管的是"能不能发",审计管的是"发的东西干不干净",缺一个都不算闭环。
把问题量化一下,它远比"感觉上该防"要紧迫。安全厂商 Harmonic 在 2025 年第二季度分析了超过 100 万条 GenAI 提示词和 2 万份上传文件、覆盖 300 多个工具,结论是 4.37% 的提示词和接近 22% 的上传文件含有敏感内容;其中代码泄露是最常见的一类。更刺眼的是编程工具这一档:在它们产生的敏感暴露里,12.8% 是访问密钥(API token、凭据、密钥),而编程工具仅占整体使用量的 0.4%,却在全部密钥暴露中占 5.7%——相当于 14 倍的浓度。换句话说,研发用 AI 编程工具时把密钥带出去,不是偶发,是结构性的高浓度风险。多数团队对出网的默认心态是"能调通就行",把它当成连通性问题的延伸,而不是数据主权问题。这恰恰把内容层交给了运气。
三、出口数据从哪来:四个方向,一条真实请求体
把"出口数据"拆开看,它大致来自三个方向。其一是 prompt 侧:系统提示、检索回来的上下文、被贴进对话的代码片段、散落在配置里的密钥,都会被原样拼进发往模型的请求体——这也是 GitHub Copilot、Cursor 等工具"隐私模式"默认关闭时最容易踩的坑,研发把整段上下文喂给了远端模型。其二是工具返回侧:当 Agent 通过 MCP 调用内部系统,工具回传的内容常包含生产库记录、内部工单、客户信息,而 Agent 很可能不经脱敏就继续往下游送;Red Hat、Checkmarx 与 NSA 都专门点过 MCP 的这一类风险——一段看似正常的工具返回,可能夹着用户对话或所授权限范围内的私有信息。其三是响应回流侧:Agent 生成的产物被用户或下游系统二次转发,原始敏感上下文随之扩散,OWASP LLM02 把这类"输出被下游消费后泄露"单列为一类风险。除此之外还有一类最易被漏掉的"隐性出口":当 agent 走检索增强(RAG)查内部知识库或代码索引时,召回的相邻片段常常夹着本不该对外暴露的密钥或配置,模型为了把"相关上下文"给足,会把整段代码(含其中的 .env 引用)一起拼进请求——这段内容既不在研发的显式输入里,也不在工具返回里,端点两层视角都扫不到。
前三类出口的共同性质是出网即失控:本地文件删了能恢复,发到外部模型或第三方接口的内容没有回收机制。更棘手的是,大模型调用天然会把"上下文"拼进请求——模型要推理就得有上下文,于是上下文必然随请求出海,传统依赖关键字匹配的 DLP 守的是文件落盘和邮件外发,守不住"请求体里多拼了一段上下文"这种新形态。Blackfog 把 LLM 促成数据外泄的路径归纳为五类:提示注入、RAG 滥用、记忆泄露、工具误用、微调泄露——前四类都落在内容层。Zscaler 的 ThreatLabz 2024 AI 安全报告基于超过 180 亿次 AI/ML 交易的分析指出,专门为数据外泄开发的 AI 模块会越来越多;Securelayer7 则把这类泄露概括为注入让模型"phone home"。内容层外泄已经是有规模的现实现象,不是边缘假设。下面是一段做了脱敏、但结构真实的请求体片段:
POST /v1/chat/completions{ "model": "gpt-4o", "messages": [{ "role": "user", "content": "帮看下这个报错:调用 https://gw.internal.corp/api/v2/order 返回 401,鉴权路径 /auth/token 似乎失效。 -----BEGIN RSA PRIVATE KEY----- MIIEpAIBAAKCAQEA...(截取)..... 完整日志见附件。" }]}端点在网络层看到的是一次正常的 API 调用、一个合法的 HTTPS 目标。但它看不见请求体里那段内部网关地址,更看不见那把私钥。一个内部服务命名、一段路径、一个变量名,就足以把家底交出去。
ZCode 事件暴露的则是第四类方向:工具自带的外发链路。索引、Wiki、遥测、崩溃上报这些"产品功能",本质上是客户端内置的一条数据出口——数据在本地生成快照后直接流向厂商基础设施,不经过研发的显式输入,也不经过任何企业声明的代理。企业网关的两个视角在它面前同时失明:网络层看到的是发往厂商域名的合法流量,内容层根本不存在审计点。这类出口的隐蔽性恰恰在于它以"功能"的形态存在:默认开启、随版本升级悄悄变化,安全团队既不知道它的存在,也无从审计它的载荷。
四、三道闸:静态规则 → 语义 → 出网白名单(含可抄规则)
出口审计的工程实现,可以收敛成三道闸,依次从便宜到贵、从确定到不确定。顺序本身就是一条工程纪律:能规则解决的绝不上模型,能网关收口的绝不分散声明。
第一道是静态规则审计,速度快、零模型成本、几乎不引入延迟:用正则和格式识别去扫 PII、密钥、内部域名与 IP 段,在请求出网前直接拦截。前面那 12.8% 的密钥类暴露,绝大部分属于"格式已知",正好是被正则吃掉的那种。下面是一组可直接落地的格式类检测正则(示意):
AKIA[0-9A-Z]{16} # AWS Access Key IDAIza[0-9A-Za-z_-]{35} # Google API Keyxox[baprs]-[0-9A-Za-z-]{10,} # Slack Tokenghp_[0-9A-Za-z]{36} # GitHub Personal Access Token-----BEGIN (?:RSA |EC |OPENSSH |DSA )?PRIVATE KEY----- # PEM 私钥eyJ[A-Za-z0-9_-]+\.eyJ[A-Za-z0-9_-]+\.[A-Za-z0-9_-]+ # JWT正则不是万能:像 JWT 这类模式可能误伤正常 token,需要结合签发方白名单做二次判定,但作为第一道闸,它用近乎零成本拦下了绝大多数"格式已知"的意外泄露。业界的成熟实现不止一种:AWS Bedrock Guardrails 提供 50 多种 PII 实体类型加 6 类内容过滤;Microsoft Presidio 用 spaCy 命名实体识别加正则做脱敏;Gitleaks、TruffleHog 专门扫代码仓库与请求里的硬编码密钥;Fiddler 则把 PII/PHI/密钥的内联检测接到 LiteLLM 上。共同点是都把审计点收口在网关层、零 LLM 成本、毫秒级完成。下面是一段真实的 LiteLLM 配置,用 hide_secrets_guard 在请求出网前做密钥脱敏、用 prompt_injection 做注入检测:
model_list:-model_name:gpt-4olitellm_params:model:openai/gpt-4oapi_key:os.environ/OPENAI_API_KEYlitellm_settings:guardrails:-prompt_injection:callbacks: [lakera_prompt_injection]default_on:true-hide_secrets_guard:callbacks: [hide_secrets]default_on:false配合虚拟密钥,还能按团队把出网口径、预算、速率统一收口——真实密钥不再散落在每个开发机,而是代理在网关层签发与回收:
curl -X POST 'http://0.0.0.0:4000/key/generate' \ -H 'Authorization: Bearer sk-1234' \ -d '{ "models": ["gpt-4o"], "max_budget": 10.0, "budget_duration": "30d", "tpm_limit": 100000, "rpm_limit": 100, "metadata": {"user": "dev-team"} }'第二道是语义审计,专门补规则的盲区:用模型去判读"这段上下文是否泄露了内部语义"。必须诚实——纯靠语义判定必然存在召回上限,误拦和漏拦都不可避免,它只能是规则的补充,不能当主闸。Cyberhaven、Aryaka、Vectoredge 都指出传统 DLP 在 GenAI 场景失灵:模型一次会话会生成多轮草稿,基于单轮匹配的 inline DLP 既看不全上下文,也拦不住"看似正常、实则夹带"的输出。第三道是出网策略白名单,把目标域名、协议、数据类别统一收敛到网关层,非白名单一律 deny——Blaxel、WorkOS、Tensorlake 的沙箱出网策略都默认 deny、由网络代理强制收口,OrbStack 甚至做到容器自身无法从内部退出这条强制白名单。但正如开头所说,白名单管的是目的地,拦不住借已放行服务的自由文本字段把数据带出,所以它必须和审计正交配合。
五、清醒的边界:审计能"看见"泄露,保证不了模型不乱说
这里要划一条清醒的边界:出口审计做的是"看见并拦下可疑出网",而不是"让 Agent 不乱说话"。语义级的泄露,靠审计只能在事后拦截,无法事前保证模型不把敏感信息写进回复。也正因如此,它与动作层的执行层阻断构成纵深——阻断拦"动作",审计拦"内容",而审计跑出来的可疑模式又能反哺成阻断规则,形成可沉淀的闭环。Lakera 的 DLP 指南与 Indusface 对 LLM02:2025 的拆解都强调同一件事:泄露防护的重心在"输出被消费之前拦下敏感内容",而不是假设模型不会生成它。
一个常见误区是把所有希望押在 LLM 语义审计上,结果又回到"召回上限加延迟"的老问题:你要么接受漏报,要么接受把正常代码也拦下来的误报,两边都很难向研发交代。比如一段内部工具函数的命名恰好命中语义审计的"疑似泄露"判据,研发就会被卡在提交之外,久而久之要么关掉审计、要么学会绕过——防线反被自己人拆了。务实的做法始终是规则为主、语义为辅,把确定性留给工程,把不确定性控制在最小范围。
六、执行纪律:收口到网关,还要能回放、能沉淀
把三道闸想清楚之后,真正的难点不在技术选型,而在执行纪律。很多团队不是没能力做审计,而是把审计点拆得太散:host 侧装一个、agent 侧配一个、网关再补一个,策略各写各的,最后谁都说不清全公司的出网口径究竟收在哪。审计一旦分散,就既不方便统一升级规则,也做不到事故时一键溯源,所谓防线其实是一堆对不齐的碎片。正确的收敛方式只有一种:所有出网统一收口到 LLM 网关一层,host 与 agent 侧不再各自声明策略,虚拟密钥和 guardrails 在网关统一挂接,研发机上的真实密钥彻底不落盘。Cloudflare AI Gateway、LiteLLM 虚拟密钥都提供这一层统一控制面,把出网、计费、可观测收口在一处。
收口之后还要具备两样能力,否则审计只是摆设。其一是日志可回放:OpenAI Compliance Logs 提供滚动 30 天留存加 Audit Log API,Langfuse、Arize Phoenix 的 trace replay 能把一次 agent 调用完整回放,事故来了能事件溯源、能复盘。其二是规则沉淀闭环:Promptfoo 的红队测试能基于已识别的泄露生成回归用例,Lakera 强调"检测规则 → 阻断规则"的闭环——某类内部域名的出网被反复拦下,就值得把它固化进白名单或 DLP 字典,让一次性的"发现"变成长期有效的"防住"。组织归属的错位让这件事更难:数据防泄漏(DLP)归安全团队管,但 LLM 上下文里的敏感信息根本不在传统 DLP 的字典里;agent 的编排和出网行为归研发团队管,但研发往往不把"带出去的内容"当成安全事件。于是中间的语义级携带,成了谁都不盯的盲区。
七、落地清单 + 规则沉淀闭环(可复制)
落到落地,出口审计的清单其实不复杂,难的是别把它做成一锤子买卖。下面七条,前五条是防线,后两条是让它持续生效的闭环:
1. 审计点统一收口到网关层,不要散在 host 或 agent 侧各自声明,否则策略永远对不齐、出问题也溯源不了。
2. 静态规则先行,密钥、PII、内部域名这几类正则就能覆盖多数真实风险,先拿到大部分收益;可叠加 Bedrock Guardrails / Presidio / Gitleaks 等做格式与实体双层扫描。
3. 出网白名单收敛,把"默认放行"改成"默认拒绝",非白名单直接 deny;但牢记白名单管目的地、不管载荷,必须配内容审计。
4. 盘点所用 AI 编程工具客户端自带的上传链路——索引、Wiki、遥测、崩溃上报——逐个确认开关默认态、触发条件与载荷内容,拿不准的默认关闭,版本升级后重新核一遍。
5. 语义审计只做可疑项的二次校验,不当主闸。
6. 审计日志必须可回放(网关 Audit Log / trace replay),事故来了能事件溯源、能复盘。
7. 审计跑出来的可疑模式要能反哺阻断规则(红队用例 / 白名单 / DLP 字典),让一次性的"发现"变成长期有效的"防住"。
八、两层合起来,才是一道防线
出口审计和端点拦截从来不是二选一,它们是同一道"别让 Agent 把家底送出去"防线的两层。动作层守得住"它做了什么",内容层才守得住"它带走了什么"。两层都补齐,企业才算真正把 AI 编程工具用在了可控的边界里——否则你以为自己在用工具提效,实际上每次请求都在赌那把私钥没被拼进请求体。
回到开头那次快照外发:问题最终靠社区开发者偶然发现、靠厂商主动整改闭合,这算得上体面。但把防线押在"恰好有人发现"上不是工程,是运气——审计的意义,就是让出口从运气变成清单。
最后留个问题:你或身边团队有没有遇到过 Agent 把内部代码、密钥顺着一次请求发出去的瞬间?怎么发现的,又花了多少代价才堵上?或者说,压根没有发现过?