ARTICLE · 1067731
徐峻教授:从大模型幻觉到本体论智能体,AI药物研发如何回归第一性原理
本文转自【晶泰智药】公众号
生成式AI正在加速进入生物医药研发,但它并不是解决所有问题的万能钥匙。大语言模型(LLM)可以生成文本、总结信息、辅助推理,却也无法天然规避幻觉、偏差、数据质量和安全边界问题。
在由晶泰科技主办的上海张江AI药物研发创新峰会上,徐峻教授以“基于本体论的AI 辅助药物发现”为题,系统拆解AI药物研发底层逻辑:从专家系统到智能体,从生成式模型到产生式逻辑,从数据管理升级至本体论体系,再到生命化学语言与药物发现第一性原理。
本场分享核心并非简单讨论“AI能不能设计药物”,而是抛出更本质的行业命题:若AI要支撑真正的首创药物发现,它必须读懂怎样的知识结构、生命语言与系统运行规则?
本文将围绕以下核心议题展开:
AI药物研发的挑战与对策
形式语言、天然语言与本体论
生成式AI的能力与边界
生命语言学与药物本体
研发第一性原理
报告嘉宾:徐峻 教授
中科院合肥物质院健康所
生物医药大数据研究中心主任
徐峻,中科院合肥物质院健康所生物医药大数据研究中心主任、中山大学教授、英国皇家化学会士。AI研究历程可以追溯到上世纪80年代中期。主攻人工智能和图论算法在药物设计中的应用,发表了本领域许多重要算法,如子图匹配、多维蛋白质NMR自动结构解析、分子图簇分析、关系式化学结构数据库搜索引擎、机器学习辅助药物设计等算法。徐峻在中国科学技术大学获得博士学位后,分别在澳洲国立大学、加拿大麦基尔大学做博士后研究。历任美国TRIPOS分子设计公司资深科学家,BIO-RAD萨特勒实验室研发部总监,德国Boehringer Ingelheim制药公司药物设计主管科学家,美国BioFocus-DPI制药公司药物设计总监和Fellow。徐教授长期在第一线从事AI算法和药物发现实验研究。发现了多种抗病原体、抗代谢类疾病、抗癌药物的新先导化合物和新靶标。曾主持国家 “新药创制重大科技专项”、广东省生物大数据重大专项、广州市药物创新重大科技专项。徐峻以第一或通讯作者在国际主流杂志发表研究论文140多篇,30多项授权药学发明专利实现转化。《药物发现方法学——研究范式的演化》(ISBN:978-7-03-076100-2)是徐教授的与AI制药相关的代表作。
报告主题:
基于本体论的智能体与首创药物创新
AI药物研发的挑战与对策:智能体要给结果,更要可控、可审计、可验证
人工智能的发展脉络,正在从早期“专家系统”转向新一代自主智能体(Agentic AI)。早期专家系统的目标是给出答案,而今天的Agentic AI更强调输出完整多步骤解决方案:它可以自主行动与决策、主动推理与规划、动态适应、调用工具,并通过多智能体协作完成目标导向任务。
但“自主”并不等于更优。徐峻老师提醒,某些完全自主行动或自动化并非必要,甚至可能带来风险。智能体如果缺少边界和审计机制,就可能出现提示注入、权限过度、互联系统级联故障,甚至生成高风险或有缺陷的决策。因此,人在回路(human-in-the-loop)是智能体落地生物医药等高风险场景必不可少的安全机制。
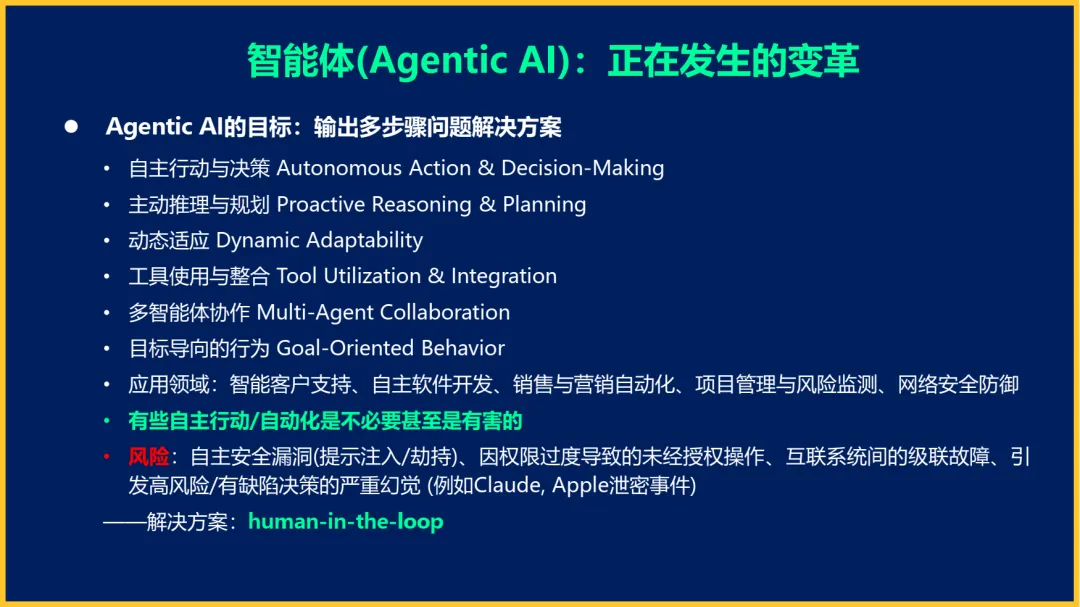
图1:Agentic AI的目标、能力与潜在风险
回归生物医药产业,AI落地遇到的并非单一算法问题,而是三类系统性叠加难题,徐峻教授逐一拆解并给出对应落地路径。
1.科技层面挑战:不能只优化预测算法,必须打通算法-实验闭环
行业普遍聚焦靶点确证、药效毒理预测、作用机制模拟,但单纯优化模型精度无法带来颠覆性创新。真正的突破需要AI与前沿实验技术深度融合:
AI联动自动化高通量筛选(HTS),整合多组学多模态数据;
结合RNAi、CRISPR-Cas9基因编辑技术开展机制验证;
AI驱动细胞成像,量化分析细胞形态变化;
搭建多组学因果网络,挖掘真实生物标志物;
依托类器官、器官芯片、iPS细胞革新疾病评价模型。
简言之,AI药物研发不能停留在“纸上预测”,必须构建算法、实验、疾病模型、因果验证的完整闭环。
2.经济与协作挑战:打通药物发现到临床的全链路反馈
新药研发周期漫长、成本高昂,行业共识是“尽早失败、及时止损”。越早排除无效分子与靶点,越能大幅压缩研发投入。
要实现这一目标,产业必须打破药企、CRO、医院之间的数据孤岛,落地方案包括:
全流程数据遵循FAIR(可发现、可访问、可互操作、可复用)原则;
依靠AI统一行业数据标准、整合研发指南与临床共识;
搭建从早期分子筛选到临床试验的实时反馈链路。
3.AI底层应用挑战:根治大模型幻觉、守住数据合规安全线
仅依靠原生大语言模型,科学幻觉无法根除,而生物医药领域零容错,一旦输出违背生化规律的结论,会造成巨大资源损耗甚至生物安全隐患。针对性解决方案:
大语言模型(LLM)配套人工全流程审计标注数据集;
传统关系型数据库(RDBMS)升级为图数据库(GDBMS);
依托知识图谱对原始数据、模型推理结论双重校验;
以因果逻辑约束分子生成流程,杜绝无规则随机输出;
采用联邦学习保护敏感基因、临床数据隐私;
全程落地人在回路机制,保障知识产权与行业合规。
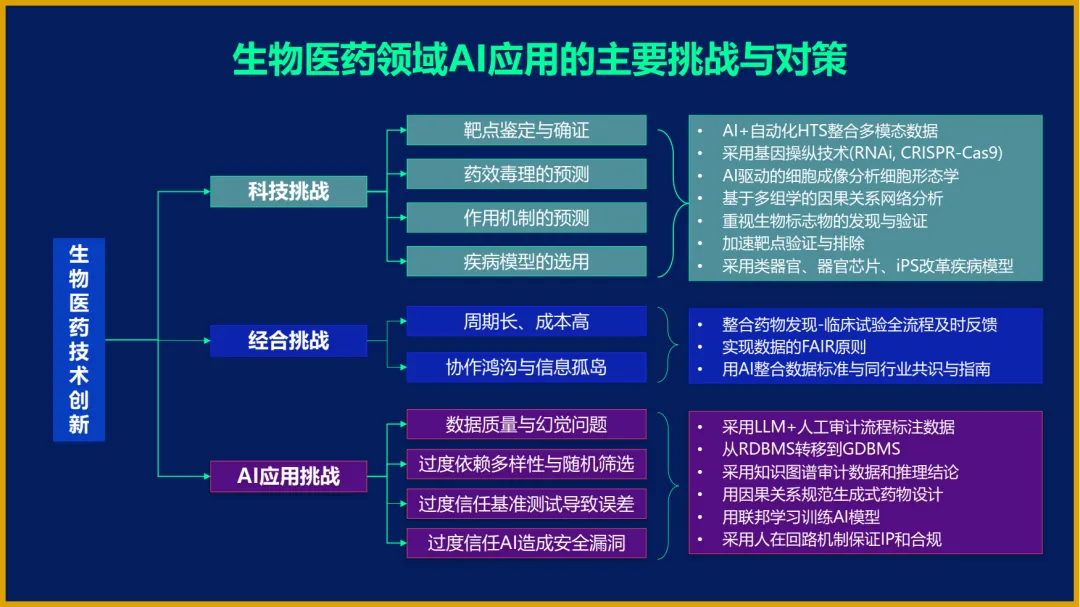
图2:生物医药领域AI应用的主要挑战与对策
重新理解语言:药物研发是在用形式语言理解生命的天然语言
想要看透生成式LLM底层局限,首先要厘清世界上三类完全不同的语言体系。
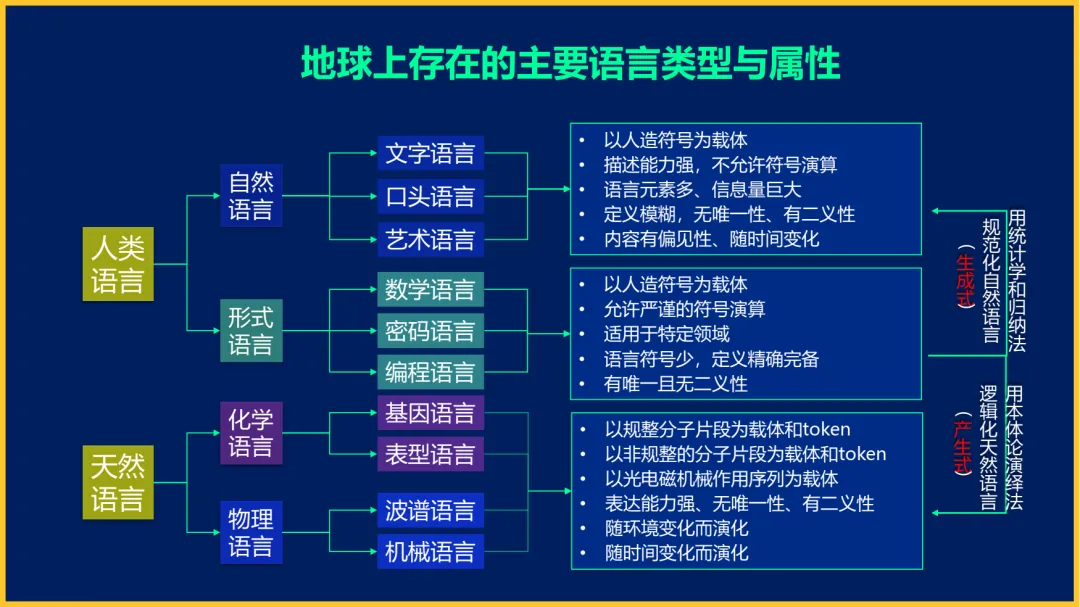
图3:人类自然语言、形式语言与天然语言
人类自然语言:
文字、口语、艺术创作。描述性强,但存在歧义、主观偏见,无法严谨数学演算;
形式语言:
数学、编程、密码。符号定义唯一、可严谨推演,是现代科学的底层工具;
天然生命语言:
化学、基因、表型、波谱、机械语言。以分子、基因片段为基础单元,随环境动态演化。
新药研发、临床诊断的本质,就是用人类构建的形式语言,解析生命自带的天然语言,完成人与生命系统的“对话”。
这里也区分两个极易混淆的概念:生成式(Generative)依靠统计归纳、拟合现有数据;产生式(Production)依托本体论演绎,给天然生命语言建立严谨逻辑规则。徐峻教授认为,行业不能只追求模型“生成内容”,更要让AI真正理解生命里的概念、实体、关联与因果公理。
从程序、数据到知识:本体论是数据走向知识的重要形态
形式语言的发展经历了三个阶段:程序描述、数据描述和知识描述。早期计算机语言主要告诉计算机如何执行;随后人类开始用关系式数据库把自然界数据结构化;当非结构化数据大量出现,知识描述语言成为人工智能时代的重要基础,包括图数据库、知识图谱和本体论等。
数据管理也经历了从图书馆、数据库、数据湖到本体论的演进。徐峻老师认为,本体论是数据发展到知识阶段的重要形态。
本体论四大核心要素:概念、实例、关系、公理。它不只是存储数据,而是搭建完整学科知识框架,把全部实体、层级、因果规则结构化,让机器具备逻辑推演能力。
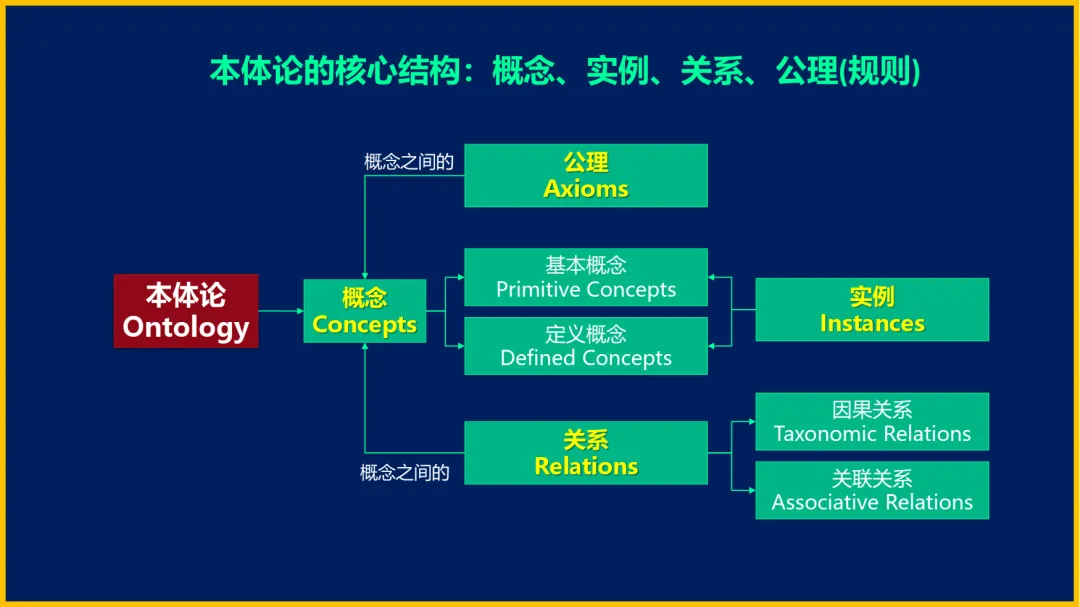
图4:本体论的核心结构:概念、实例、关系、公理
知识本身也有层次。陈述性知识回答“是什么”,过程性知识回答“怎么做”,发现性知识支持抽象与顿悟,调度性知识决定在不同情境下如何组织知识。AI要进入药物研发的深水区,不能只记住事实,还要理解过程、结构、规则和调度逻辑。
这也是人工智能时代的大趋势:知识运用的自动化。未来的AI药物发现,必须把底层的归纳法与顶层的演绎法结合起来:神经网络负责从数据中学习复杂模式,本体论和逻辑规则提供可解释、可追溯、可审计的推理框架。
生成式AI的能力与边界:Transformer解决拟合问题,但不能替代生命底层逻辑
百年以来,科学界依靠函数建模描述变量关系(QSAR、回归分析等),但这套方法存在固有短板:复杂生化曲线难以拟合、存在“活性断崖”蝴蝶效应、生命涌现现象无法用单一局部变量解释。
Transformer神经网络补齐了数据拟合短板:通过海量参数矩阵学习、自注意力机制缓解长距离关联、并行计算处理超大模型,让大语言模型拥有强大内容生成能力。但生物医药场景下,理想与现实存在巨大鸿沟。
理想状态下,AI可以总结海量生物医学论文和临床试验记录,识别疾病相关遗传标记,模拟分子行为,甚至生成自然界不存在的新蛋白或小分子。
但现实问题包括:LLM可能拟合出看似合理的token序列,却产生科学幻觉;临床和基因数据涉及隐私、合规和保密;训练数据可能存在偏差;模型也可能被诱导设计有毒肽、小分子或危险病原体相关方案,带来生物安全风险。
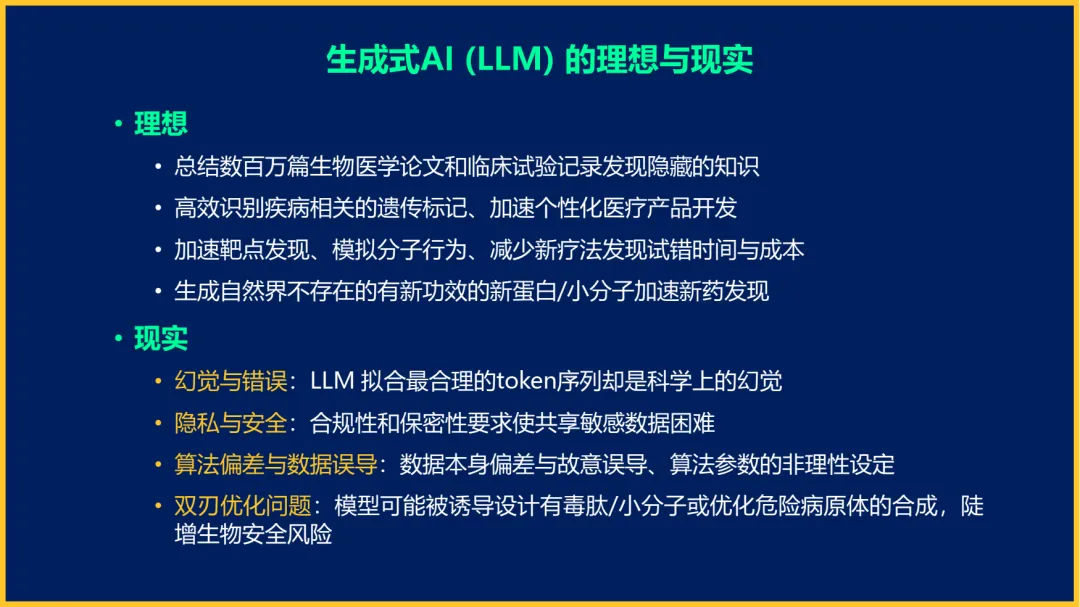
图5:生成式AI(LLM)的理想与现实
因此,生成式AI不能脱离本体论、因果关系、人工审计和实验验证。它需要与符号逻辑、知识图谱、自动化实验共同构成更可靠的研发系统。
生命语言学:细胞膜、药效团、蛋白标签,都是生命的基础词汇
自然界的“天然语言”具体存在于生命化学结构之中。
在细胞膜上,磷脂、糖蛋白、通道蛋白、胆固醇等结构并不是静态材料,而是承担识别、转运、调控和交流功能的化学“词汇”。这些“分子单词”的语义,不能仅靠统计相关性理解,还需要回到化学结构和生理功能。
在天然产物中,异戊二烯规则体现了自然界构建复杂小分子的“语法”。在药物化学中,药效团则是药物分子的基本词汇,包括氢键受体、氢键供体、阴离子、阳离子、疏水团和芳香环等。小分子的每一次结构修饰,都可能对应增加水溶性、提高血脑屏障通透性、改善口服吸收、延缓释放等药学语义。
蛋白质的N端和C端编码了明确的生命语义。某些序列指向细胞外、内质网、高尔基体、溶酶体、线粒体或细胞核;KDEL、HDEL、SKL、CAAX等C端标签,也承担定位、降解、锚定和修饰任务。
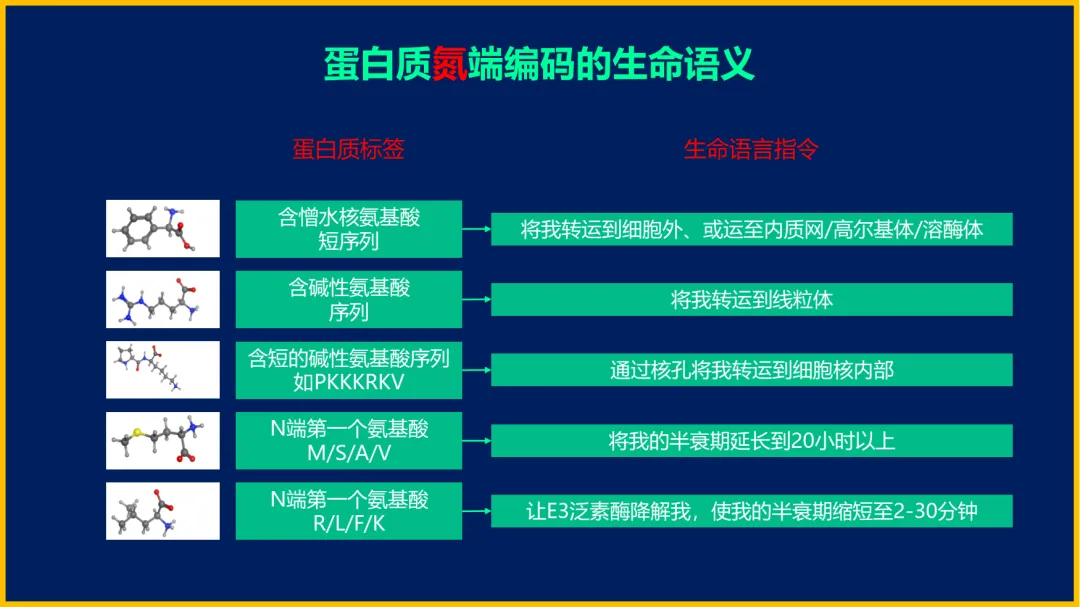
图6:蛋白质N端编码的生命语义
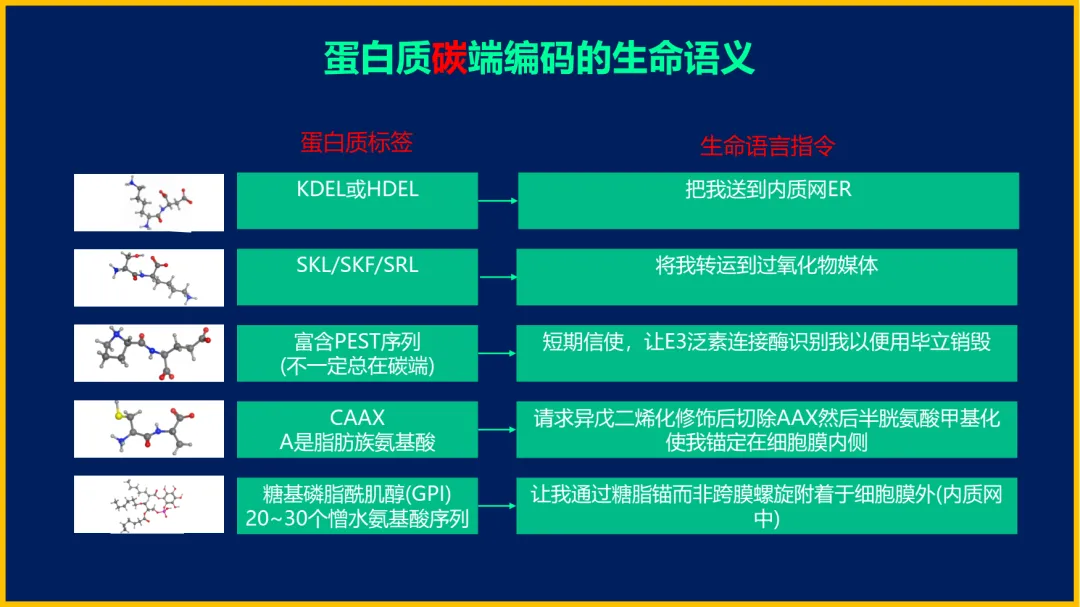
图7:蛋白质C端编码的生命语义
翻译后修饰则进一步提高了生命化学语言的表达能力。乙酰化、磷酸化、泛素化、甲基化、糖基化等修饰,就像语言中的标点符号,决定蛋白质何时被激活、何时被降解、何时进入信号通路。
如果不理解这些语义网络,单纯依赖随机组合式高通量筛选,很难真正触达首创药物创新。
从生命本体到药物本体:AI必须理解生命的世界模型
想要做好AI辅助药物研发,首先要完整定义生命本体。
生命本体具有多重顶层属性:由有机和无机分子构成,有繁殖和进化能力,有信号传导能力,有与环境互动的能力,有开放型耗散结构,也有维持负熵、自组织,以及接收和代谢能量、信息与物质的能力。
生命系统还具有层次关系:分子→超分子→细胞→组织→器官→生理系统→个体→种群→群落→生态。它不是单一分子系统,而是控制论、信息论、系统论共同作用的复杂体系。
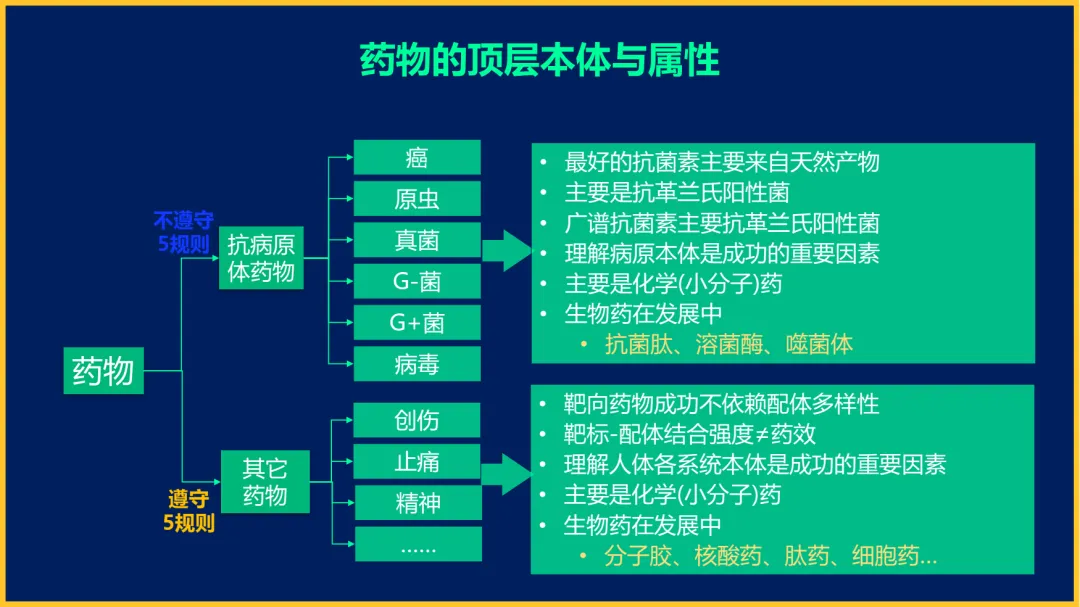
图8:药物的顶层本体与属性
药物本体也需要被重新理解。徐峻老师在报告中将药物分为两类:一类是遵守Lipinski 五规则的药物,另一类是不遵守Lipinski五规则的药物。对于抗病原体药物,包括抗原虫、抗真菌、抗革兰氏阳性菌、抗革兰氏阴性菌、抗病毒以及部分抗肿瘤方向,其成功逻辑不能简单套用常规小分子筛选规则。
真菌含几丁质细胞壁、革兰氏阴性菌双层膜、病毒包膜结构完全不同,如果用常规小分子筛选逻辑开发抗感染药物,会大幅降低成功率。美国NIH早在1986年启动统一医学语言系统(UMLS)本体建设,国内目前缺少同类成熟公共本体中心。
如果不理解本体结构,在错误的规则空间中筛选候选分子,研发难度会被人为放大。
从分子Token到分子谓词演算:让药物设计具备可推理规则
生命化学语言的“单词”可以有多种形式:子结构、分子骨架、分子指纹、拓扑指数、性质指数、分子图、表面图等。
AI的任务不是随意切分分子,而是提取与研究对象的药效学和生理特性真正相关的特征向量。同一个分子进入人体后,可能与多个蛋白发生相互作用,不同靶标会从不同角度 “看见”同一个化合物。因此,分子子结构和骨架的划分,要服务于具体目标、靶标和生物学语境。
在此基础上,可以构建分子化学语句的句法,即分子谓词演算规则。以肽类药物为例,如果目标是提高分子稳定性,可以考虑物理稳定性、化学稳定性和酶稳定性;如果目标是提高细胞穿膜能力,可以考虑带正电荷分子、两亲分子、嵌合序列分子;如果需要引入刺激应答机制,可以考虑二硫键、pH调节等。
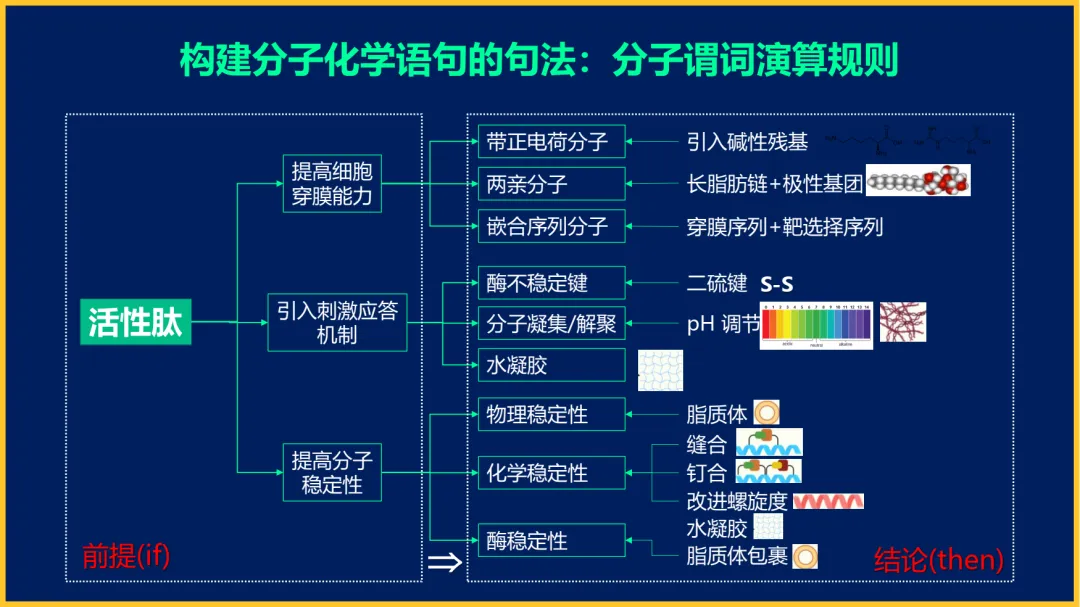
图9:分子谓词演算规则
这类规则不是简单经验堆积,而是把“前提if”和“结论then”组织成可推理的分子设计逻辑。利拉鲁肽到司美格鲁肽的结构演进,也可以被理解为基于分子谓词演算的优化路线。
回归第一性原理:AI药物研发需要三大流派融合
徐峻老师回到人工智能与生物医药的第一性原理表示:
人工智能最终需要三大流派融合:
符号主义:本体论、知识图谱、产生式演绎推理,负责可解释因果推导;
连接主义:深度学习、生成式大模型,负责海量数据模式拟合;
行为主义:智能体、强化学习,负责与实验、临床环境交互迭代。
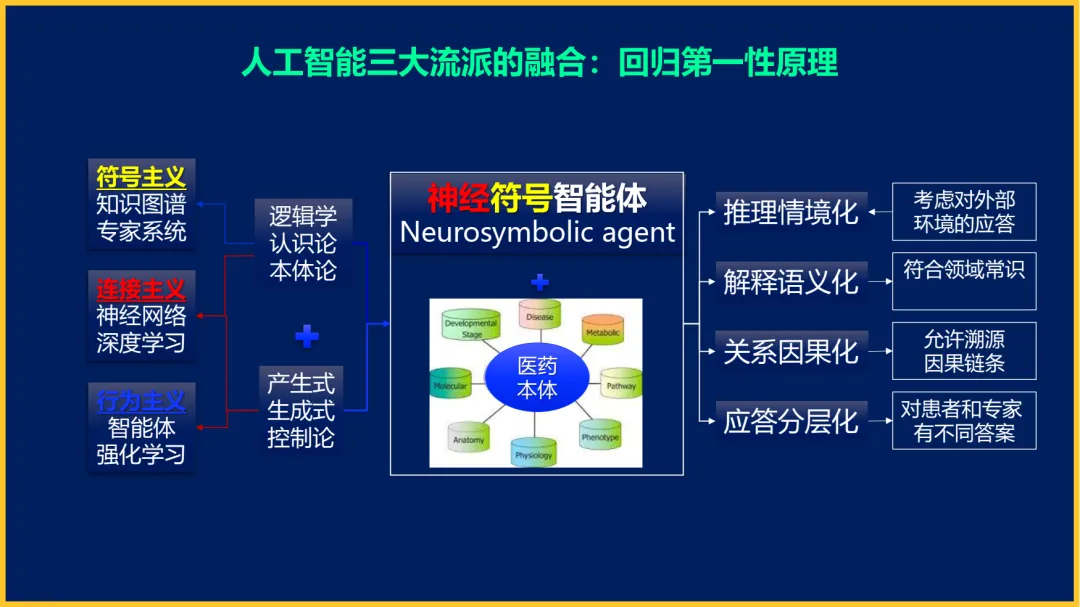
图10:人工智能三大流派的融合:回归第一性原理
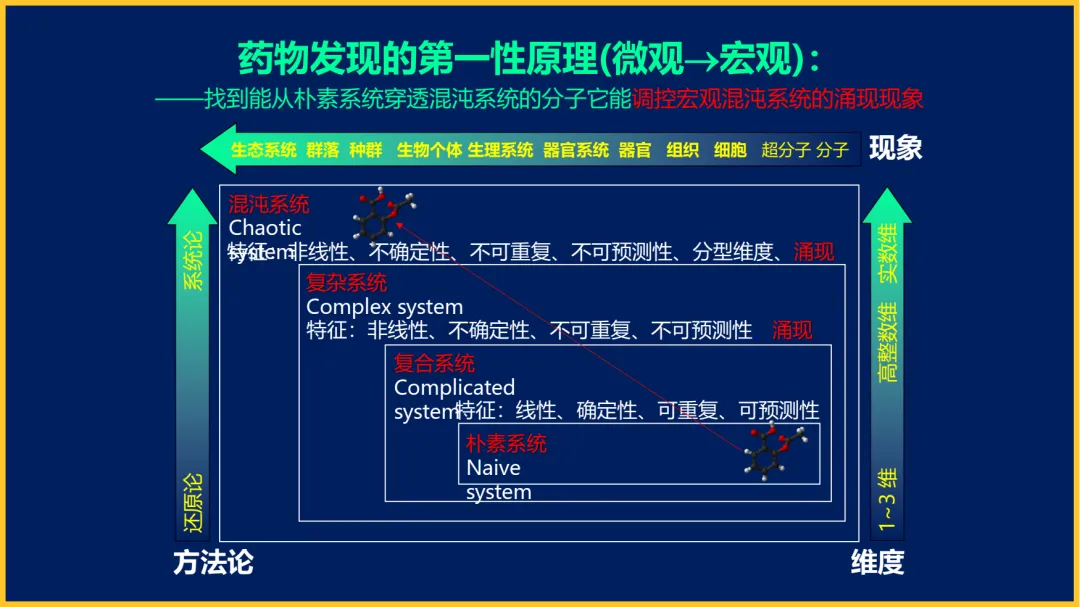
图11:药物发现的第一性原理(微观→宏观)
三者融合,才能形成神经符号智能体,并实现推理情境化、解释语义化、关系因果化、应答分层化。
药物发现的第一性原理,是从微观到宏观:找到能从朴素系统穿透复杂系统乃至混沌系统的分子,调控宏观生命系统的涌现现象。
医学诊断的第一性原理,则是从宏观到微观:医生基于不完备信息反复探试,从患者主诉、感觉、症状等宏观现象入手,追溯导致系统失序的微观机制。
这也提示了AI药物研发未来的方向:不能只停留在docking、分子生成和大模型问答层面,而要把本体论、知识图谱、因果关系、实验验证和智能体行动统一起来。
AI药物研发的未来,不是让模型独立凭空生成分子,而是让AI在完整知识体系、真实实验系统、开放产业协作中学会科学发现。
参考来源:
https://mp.weixin.qq.com/s/gXAD8IPtWaCBhu5xrM4jcg
--------- End ---------
感兴趣的读者,可以添加小邦微信加入读者实名讨论微信群。添加时请主动注明姓名-企业-职位/岗位或姓名-学校-职务/研究方向。