ARTICLE · 1068943
临床科研π第3期——“老树开新花?”:AI工具如何辅助开展系统综述/Meta分析
系统综述/Meta分析已有一套成熟的方法学框架,但真正做起来,文献筛选、数据提取、质量评价和统计分析仍然耗时。面对成百上千篇文献,AI能否真正嵌入这些环节?哪些任务适合交给工具,哪些判断必须由研究者自己把关?
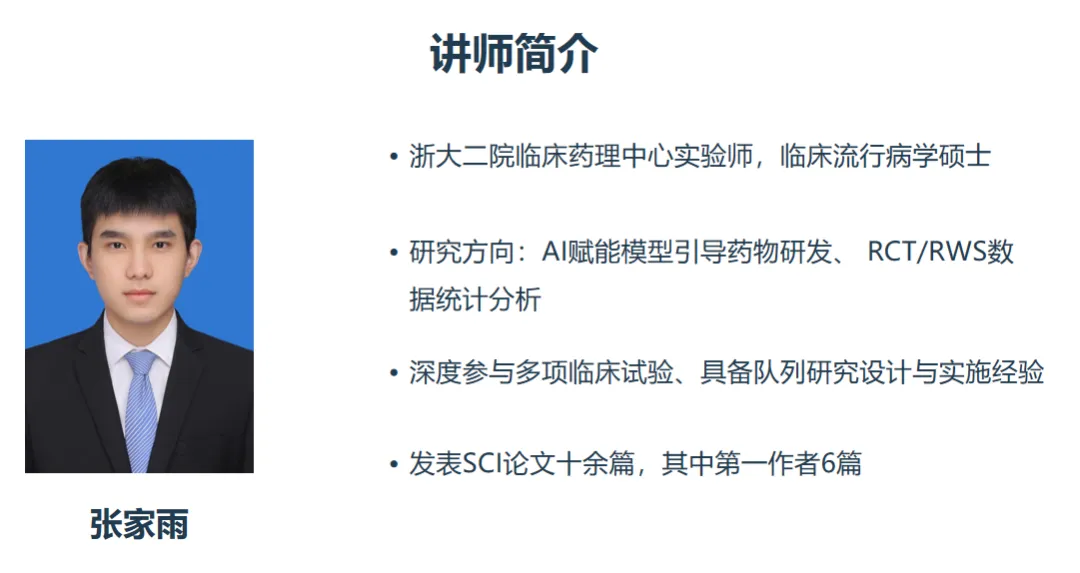
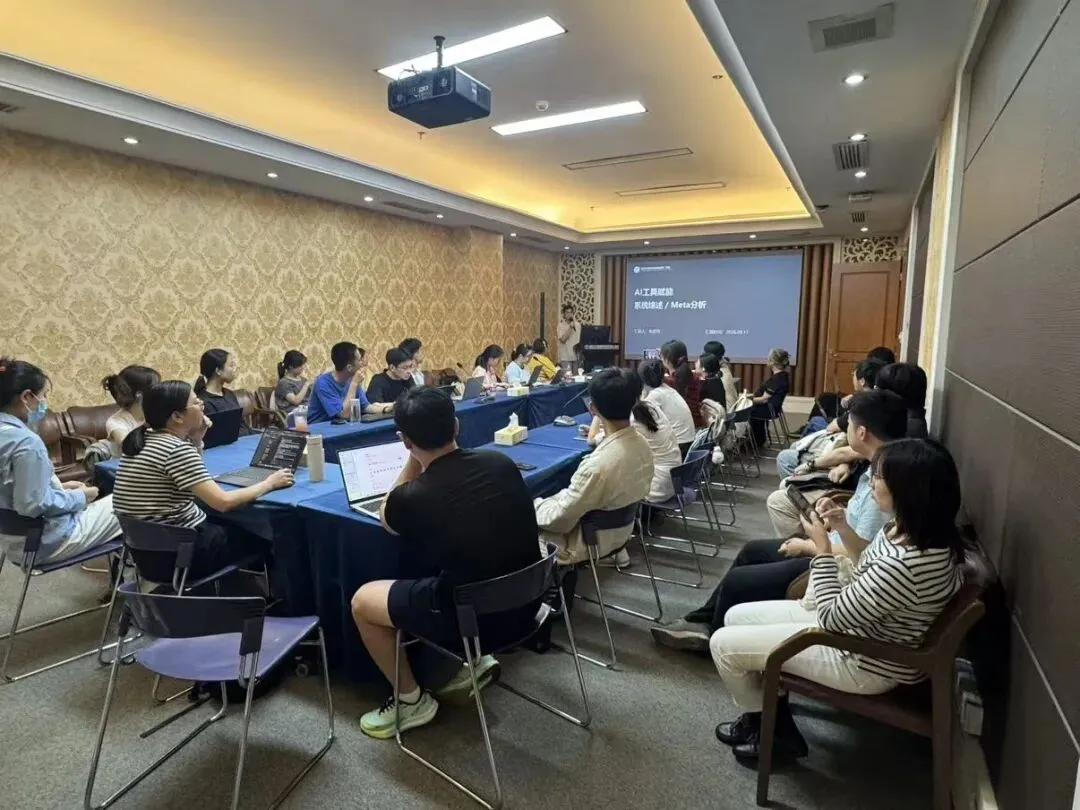
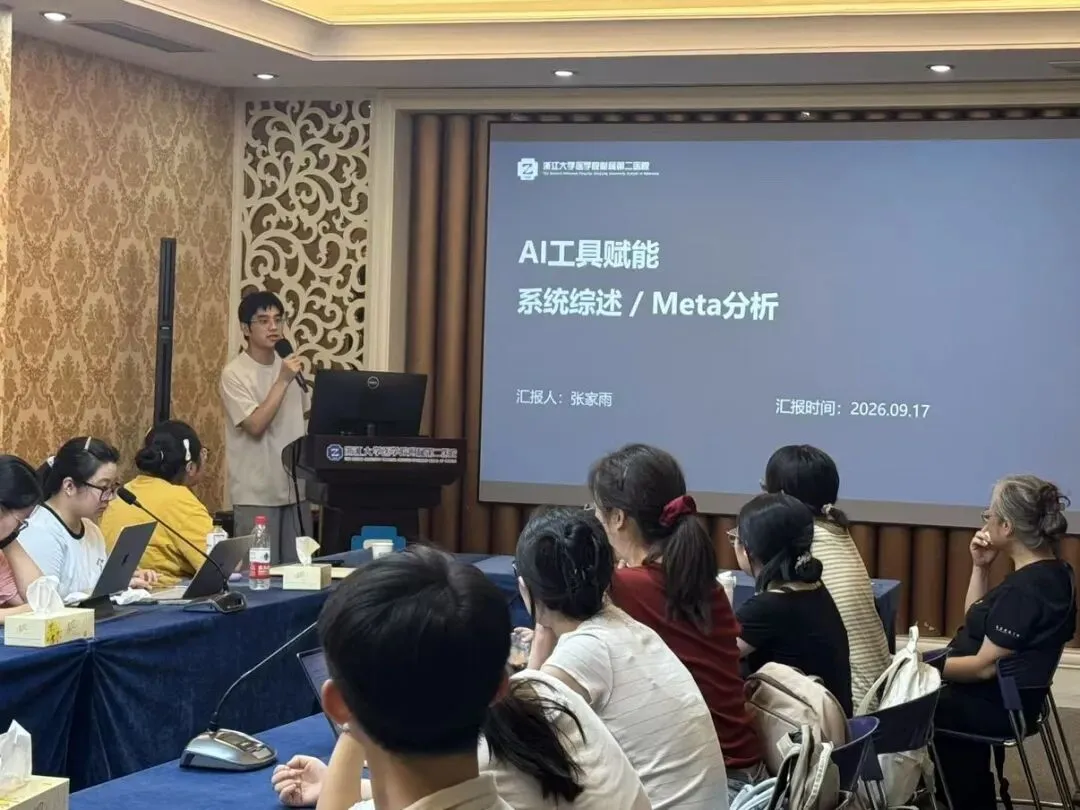
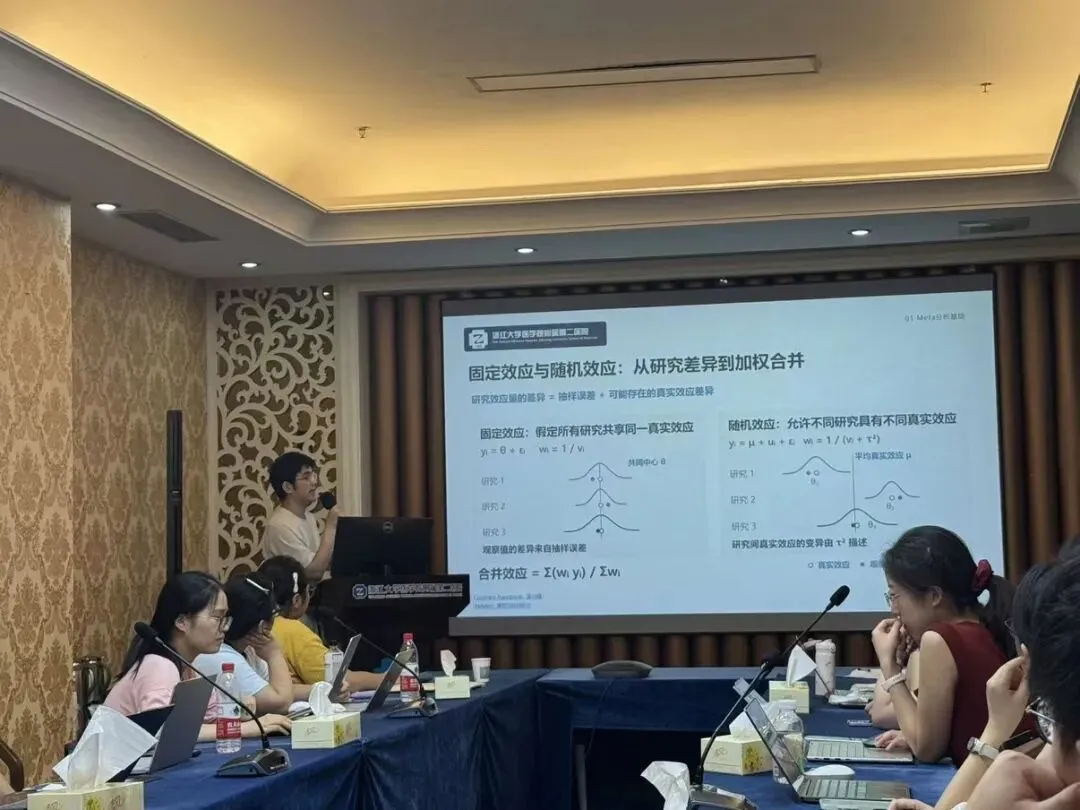
本次临床科研π第3期围绕“AI工具赋能系统综述/Meta分析”展开,由浙大二院临床药理中心张家雨老师主讲。课程从Meta分析基础出发,结合ASReview、Elicit、Gemini Notebook和Codex等工具,依次梳理文献筛选、数据提取、偏倚风险评价与统计分析中的AI应用,并反复强调一个原则:AI可以提效,但方法学规则与人工核验不能省。
系统综述与Meta分析并不等同。前者通过系统检索、研究筛选、数据提取和质量评价组织证据;后者则是在研究具有足够可比性的前提下,对结果进行定量合成。换句话说,Meta分析不是系统综述的“必选项”,而是证据条件允许时采用的一种合成方法。
课程由此进一步介绍固定效应与随机效应模型,以及成对、网状、诊断准确性和模型化Meta分析等常见类型。真正需要先想清楚的,不是“用哪个模型”,而是研究问题是否有临床价值、现有研究能否比较、数据是否足以支持合并。只有先划清这些边界,后续统计分析才有意义。
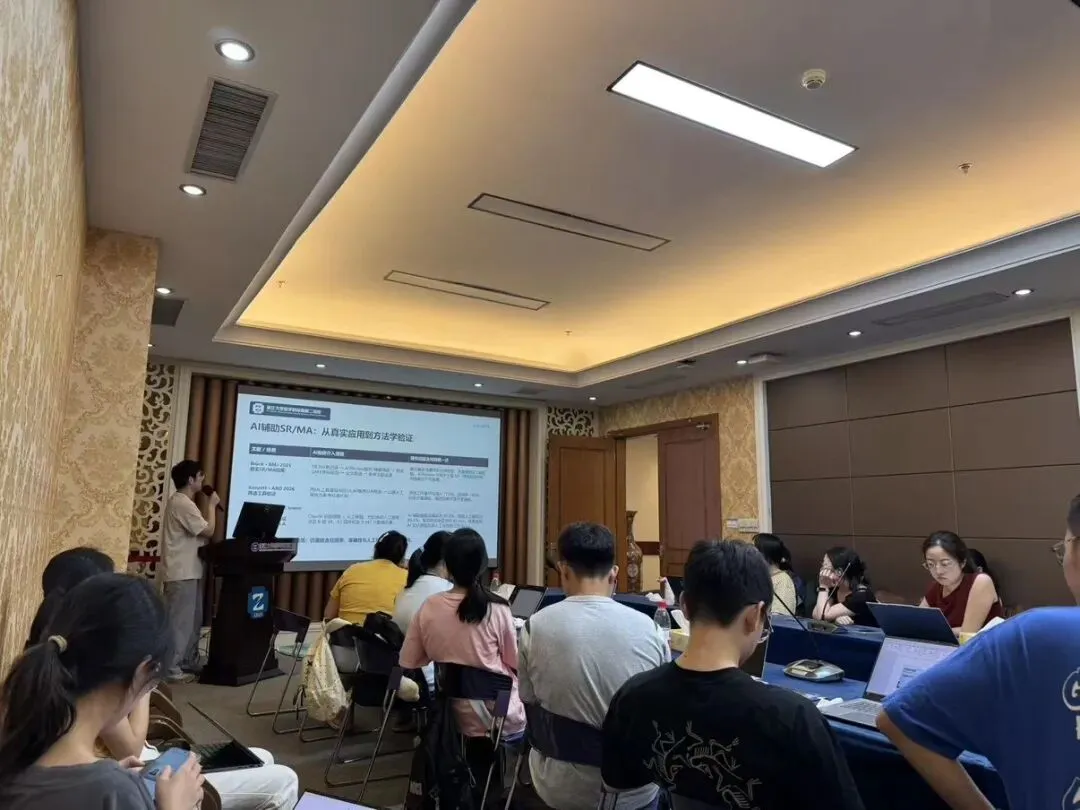
面对大量题名和摘要,ASReview通过“人工标注—模型学习—动态排序”的循环,将更可能相关的研究优先呈现。研究者每做一次纳排判断,模型就利用新增标签更新排序,从而把更多精力放在高相关记录上,而不是机械地逐条浏览。
但AI筛选的前提仍是规则清楚。导入前,需要先明确纳排标准、完成去重,并尽量保留完整题名与摘要;导入后,则用准确的已知文献进行初始标注,再持续开展人工筛选。
“什么时候可以停”尤其不能只看软件提示。Threshold达到设定条件,只意味着出现了停筛信号,并不等于完整的SAFE流程已经完成,更不能据此判断剩余文献全部无关。研究者仍需按照预设方案完成必要的补筛和复核,并保留相关、不相关及未筛记录,使筛选过程可追溯。
先把提取规则说清楚,再让AI整理数据
数据提取看似是“抄数字”,真正的难点却是这个数字对应谁、哪个组、什么结局、哪个时间点。课程以Elicit为例,展示如何把已纳入研究的全文和补充材料转化为结构化提取初稿。关键不是先点“提取”,而是先定义字段和规则,再用2—3篇代表性文献试提取、核对并修订。
例如提取“第28天全因死亡”时,需要分别记录干预组和对照组的事件数与分母,不能把百分比当作事件数,也不能混用不同时间点;未报告的数据应明确标记为NR或留空,而不是用0补齐。
AI生成表格后,工作并没有结束。关键字段仍要回到原文核对组别、人群、时间点、单位和统计量;同一研究的多篇报告也要识别和整合,避免重复计入。保留支持性原文、修订值和修改原因,才能形成真正可用于分析的数据集。
让AI帮忙找证据,不替研究者做判断
偏倚风险评价不是把全文“丢给AI”就能自动完成。课程以Gemini Notebook结合RoB 2为例,将评价指南与试验全文、补充材料、注册记录等放在同一证据环境中,并预先固定目标结局、时间点和效应类型,让AI先帮助定位与每个信号问题相关的原文证据。
随后仍需按照RoB 2的五个领域逐项判断:随机化过程、偏离预期干预、缺失结局数据、结局测量以及报告结果的选择。AI可以提出候选答案和理由,但证据是否适用、规则如何解释、最终风险等级如何判定,仍由研究者负责。
因此,评价过程需要同时保留原文位置、人工核定答案和修改记录,并由第二位评价者独立复核,必要时通过讨论或第三人裁决解决分歧。工具可以加快“找证据”,却不能替代方法学判断。
进入统计环节,AI最直观的价值是降低编程门槛。课程展示了Codex与R协作的路径:研究者提供经过核验的数据、字段字典和预设分析方案,由Codex辅助编写、运行和调试代码,再由统计软件完成实际计算。模型、效应量、区间方法和异常数据处理规则,都应在运行代码前先明确。
课程使用虚构教学数据,演示了从数据质控、合并效应估计、异质性评估,到逐一剔除敏感性分析和森林图输出的过程。遇到缺失值、零事件、多臂研究或数据不一致时,不能让AI“自行决定”,而应按照预设规则处理;方案没有规定的情况,则先报告问题,再确定方法。
更重要的是,代码成功运行不等于分析正确。还要核对输入数据、统计方法与输出结果是否一致,并保存分析脚本、结果表、运行日志和环境信息,通过重新运行验证可复现性。AI让“把代码写出来”更容易,也让研究者更需要说清楚“要算什么、为什么这样算”。
回到临床问题,判断研究值不值得做
工具的终点仍然是科研问题本身。课程最后回到选题:先从临床观察和文献阅读中明确人群、干预、对照与结局,再借助AI快速梳理已有证据、主要结论与争议点,为后续深入阅读找到方向。
包括OpenEvidence在内的工具可以辅助定位文献,但不能替代规范数据库检索、原文核对和综述注册查询。AI“没有找到”并不等于真的没有研究。一个选题是否值得开展,仍要综合判断临床价值、证据增量、数据可得性与研究可行性。
AI负责提效,方法学负责守底线
从文献筛选、数据提取,到偏倚风险评价和统计分析,这堂课展示的并不是“一款AI包办系统综述”,而是把不同工具放到合适的环节:筛选关注漏检,提取回查原文,评价遵循规则,分析保证复现。每一步都要预先定义任务、规则和核验标准。
所谓“老树开新花”,不是用AI重写系统综述/Meta分析的方法学,而是让新工具改善成熟流程的执行效率,把研究者的时间更多留给临床问题的凝练、研究差异的理解和证据的解释。工具可以让流程更快,科研质量仍需要研究者在每一步认真把关。
文字 | 张家雨
编辑 | 王茜妮
审核 | 李红蕾