ARTICLE · 1096026
原先的AI强度榜可能是错的,真正的是这样
今天 AI 圈里被转得比较多的一张图,是一条斜着往上的线。横轴是每个任务花多少钱,纵轴是考多少分。线上串了七个模型,左边便宜的是 DeepSeek V4.1 Flash,右边贵的是 Claude Opus 5,中间那段是 Ember-1、GPT-5.6 Sol、GPT-6 Astra。
这类图有个名字,叫成本-性能前沿。它要回答的问题很实在,拿到同样的分数,谁花的钱少。
今天有人说,这张图从画法上就站不住。
说这话的人叫 Arvind Narayanan,普林斯顿的计算机教授,兼该校信息技术政策中心主任,研究方向之一是 AI 评测方法,X 上有 13 万粉丝。他连着发了几条帖,核心判断是一句话,Ember 和 GLM 这两个被画在线上的模型,并不在前沿上。
01
ON THE FRONTIER
一、什么叫不在前沿上
先把「前沿」这个词拆开。
把每个模型按花费和分数放到一张坐标图上,一个模型一个点。如果某个点上,找不到任何别的点同时在两个方向上都比它好,这个点就落在前沿上。把所有这样的点连起来,就是一条前沿线。
这个词听起来像在说上限,它实际描述的只是这批点里谁没被比下去。
Narayanan 说的问题出在下一步。他说,你可以做一个东西,让它在两个模型之间来回随机切换。这次调用 A,下次调用 B,比例自己调。
这样一来,A 和 B 两点连成的这条线上,任何一个位置你都够得着。哪怕市面上根本没有这样一款模型,你也能拿到线上任意一点的分数和花费。
所以这条线得按凸包来画。凸包这个词听着唬人,意思不难。把图上所有的点用一根橡皮筋从外面箍住,松手绷紧,橡皮筋绕出来的那个轮廓就是它。按这个轮廓看,两个模型之间的整条直线上,每一个位置都算你已经能做到的。
他举的例子是 Sol 和 Gemini。在这两个之间随机切换,就能命中两点连线上的任意一点。这一换,Ember 和 GLM 就被比下去了。在它们那个价位上,混合方案能给出更高的分,它们不再是没被比下去的点。
他还提了一个更省事的检验办法。往图里加模型,只应该让前沿下面的面积变大,绝不会让它变小。假如你加了几个新模型,前沿反倒缩了,那多半是画法先出了问题
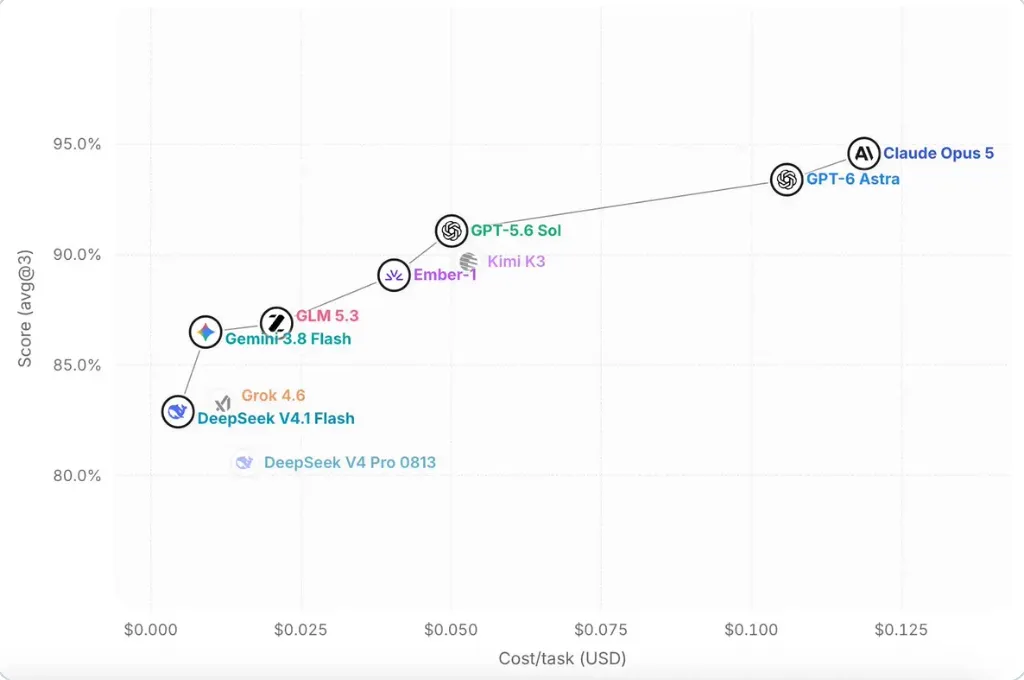
这张图上没有标注出处,我也没查到它出自哪家榜单。这一条只能照实说,不猜。
图上有两处可以对着看。左边那条边几乎是竖着上去的,DeepSeek V4.1 Flash 和 Gemini 3.8 Flash 的花费差不了多少,分数却拉开了一截。右边 Gemini 3.8 Flash 到 GPT-5.6 Sol 是一段长长的边,中间没有别的模型落在上面。Ember-1 就贴在这条长边的下方。
我试着按图上的刻度把两处分差算出来。放大之后读数精度不够,这条路不太靠谱,我也不太确定算得准,干脆不写数。能看清的是相对位置。
02
TWO YEARS AGO
二、这件事他们两年前写过
这不算今天的临时发现。
2024 年 7 月,Narayanan 和普林斯顿的几位同事发过一篇论文,标题是《AI Agents That Matter》。那篇论文干的事,是给当时的 AI 智能体评测挑毛病,一共列了五条,其中一条就是现在说的这个。
论文里专门加了一条脚注,解释为什么要把前沿约束成凸的。原话是这一段。
「我们把帕累托前沿约束为凸的,因为给定图上对应 A、B 两个智能体的两点 a 和 b,我们总可以造出一个新智能体,以概率 p 调用 A、以 1 减 p 调用 B,从而在两者之间做线性插值。所以,比如 zero-shot GPT-4 并不在前沿上。」
这句话的后半段可以停一下看。GPT-4 是 2024 年公认能力靠前的模型,在那个坐标系里,它不在前沿上。
论文当时就是这么画的图。
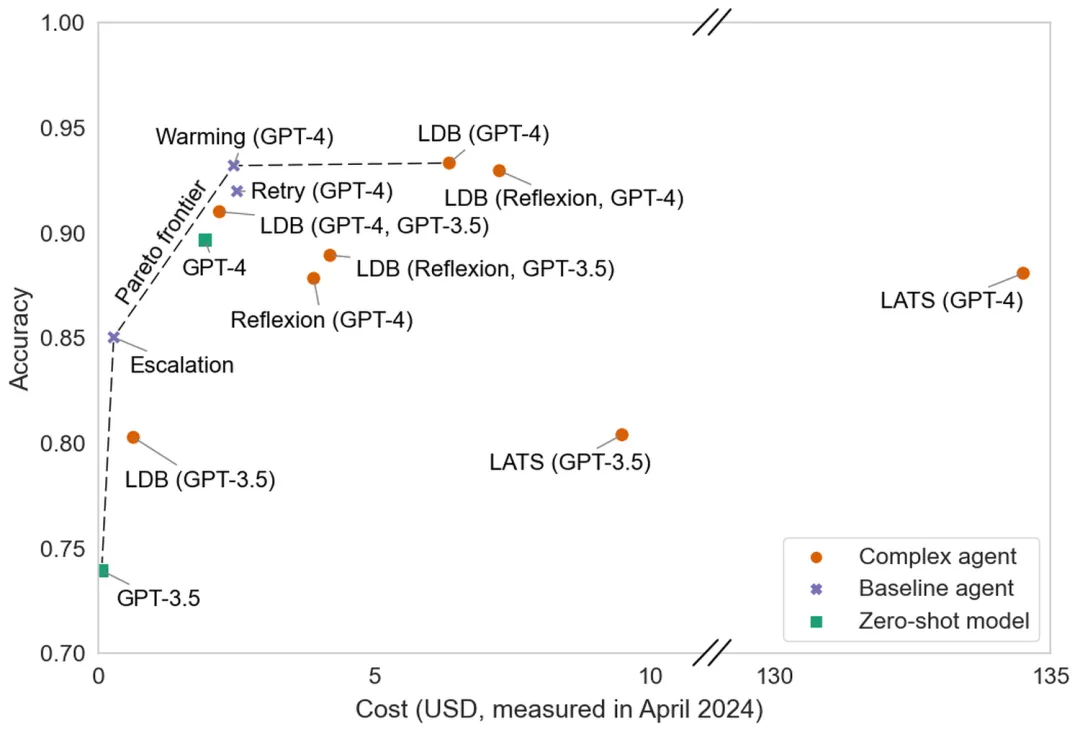
图上几个数字现在看还是扎眼。左上方三个方法名字很短,压着虚线走。右边那些名字很长的复杂架构,花了几十上百美元,分数并没有更高。LATS 花掉约 130 美元,拿到 0.88 分;左上方那个 Warming 花不到 1 美元,有 0.93 分。
03
THE NAMED MODEL
三、被点名的那个模型,这两天本来很热
Ember-1 是 Fireworks 基于 Kimi K3 后训练出来的模型,9 月 23 日发布。
官方的说法是,它在保持 K3 水平的同时把推理 token 少了大约 40%。省下来的钱不来自降价,它的价格跟 K3 一样,每百万 token 输入 3 美元、输出 15 美元。省下的部分全部来自少生成 token。
问题是,这些数字出自 Fireworks 自己的评测,七个基准加上两家客户的生产流量,目前没有第三方复现。
它这两天在 Hacker News 上被顶到 440 分、203 条评论。中文这边也已经有好几篇在写它,算的多半是省下来的钱落在哪一段。
今天另外两篇中文稿里,「帕累托前沿」是当成绩写的,说的是某个模型站上了这条线。
有人拿这张图当成绩念,Narayanan 先问这条线是怎么连出来的。
04
WHY IT MATTERS
四、这张图为什么值得较真
排行榜在传播里经常被读成「谁更强」。而一张成本-性能图里,横轴选什么、放进去哪几个点、线怎么连,都会改变谁看起来在前面。
把「随机切换就够得着」的中间位置当成独立成绩,前沿就会显得更靠前,也更挤。读者看到的是「这么多模型都做到了」,实际上一部分位置是算出来的。
对做模型的公司来说,这个差别不算小。同一批数据,换一种连线方式,自己可能就从线上掉下去,也可能从线下爬上来。选哪种画法,往往不会主动说明。
落到具体选择上,有三个问法可以随手用。
一是这张图的横轴是什么。是每个任务的花费,还是每百万 token 的单价,还是别的。同一个模型换一个横轴,位置就变。
二是这条线是怎么连的。是折线还是凸包。假如是折线,中间那些空档可能是被漏掉的,也可能压根不存在。
三是这些分数是谁测的。厂商自测和第三方复测,读法不一样。
还有一条更省事的。如果两个模型之间随机切换就能拿到中间的成绩,那「选哪个」这个问题本身就没那么要紧了。
05
WHAT TO WATCH
五、接下来可以看什么
Narayanan 这次是把两年前的话重说了一遍。所以短期内,图表的画法大概率不会变。
可以盯三个信号。
一个是接下来两三个月里新出的模型对比图,有没有人把前沿画成凸包,或者至少在图上注明这条线是怎么连的。
一个是 Ember-1 的去向。它现在是两周的研究预览,到期之后是转成常态提供还是下线。
还有一个是第三方复现。Ember-1 和它引用的那些数字,目前公开的都是厂商自己的评测。
三个里面我押头一个会先动。理由是这种图现在是好几家的默认展示方式,一旦有一家开始按凸包画,别家不跟就显得自己在前沿上站得虚。反正这个判断年底前就能验证,翻一眼那时候新出的对比图就知道。
如果三个一条都没动,那到头来,这类图的画法还是会照旧。
榜单是别人画的,横轴和连线都是选出来的。看榜的时候多问一句这条线是怎么连的,就不容易被一个名次牵着走。