ARTICLE · 1097018
KV Cache 卸载之后,扫描本身成了瓶颈:Fathom 让每个 query 自己决定读几位
KV Cache 卸载之后,扫描本身成了瓶颈:Fathom 让每个 query 自己决定读几位
长上下文 Agent 的推理负载有个很具体的形状:一个编码或浏览类会话跑几十万 token,大部分内容不是新生成的而是缓存的;服务器上同时驻留很多这样的会话。这些 KV cache 塞不进 GPU 显存,被放到主机内存或者更慢的层级里。这时候一个 decode step 的开销就不再由算术决定,而是由"什么东西穿过了互连"决定。
稀疏注意力本来是解药:GQA 和 2-4 bit KV 量化把缓存压小,top-k 稀疏注意力把"读"压小,每个 query head 只取打分最高的 k 个 key。但这里有个很多人没细想的环节——分数在读之前是不知道的。所以任何 top-k 稀疏方法都必须先用一个廉价的 key 表示,把全部 n 个 key 扫一遍排个序,再决定取谁。扫描是一个 n 条小记录的流,成本按 bits/token 计,随 n 线性增长;而 winner 行的抓取不会。
Fathom 这篇论文盯的就是这个扫描项。它的核心主张是:扫描的读取深度不应该在设计时就固定下来,而应该由每个 query 按通道重要性自己分配。
先算一笔字节账
论文用 Qwen3-8B(36 层,8 个 KV head,每 head 128 通道,每 KV head 对应 4 个 query head)在 32k 上下文下把账摊开了:
• 稠密注意力读整个 bf16 KV cache,每步 4.8 GB。
• top-k(k=512 每 query head)取四个 head winner 的并集,每 KV head 最多 2048 行,实测大约 200 MB 一步,这个量不随上下文增长。
• Loki / Double Sparsity / SparQ(r=32)的扫描读每个 key 的 32 个坐标、每个 4 bit 加一个 block scale,即 136 bits per token per KV head per layer。摊到 288 个 layer-head 对上,32k 时每步 160 MB。
问题出在最后这项的增长斜率:32k 是 160 MB,到 1M token 就变成 5.1 GB,而 winner 行还是 200 MB 附近。扫描成了 decode 的主导项。
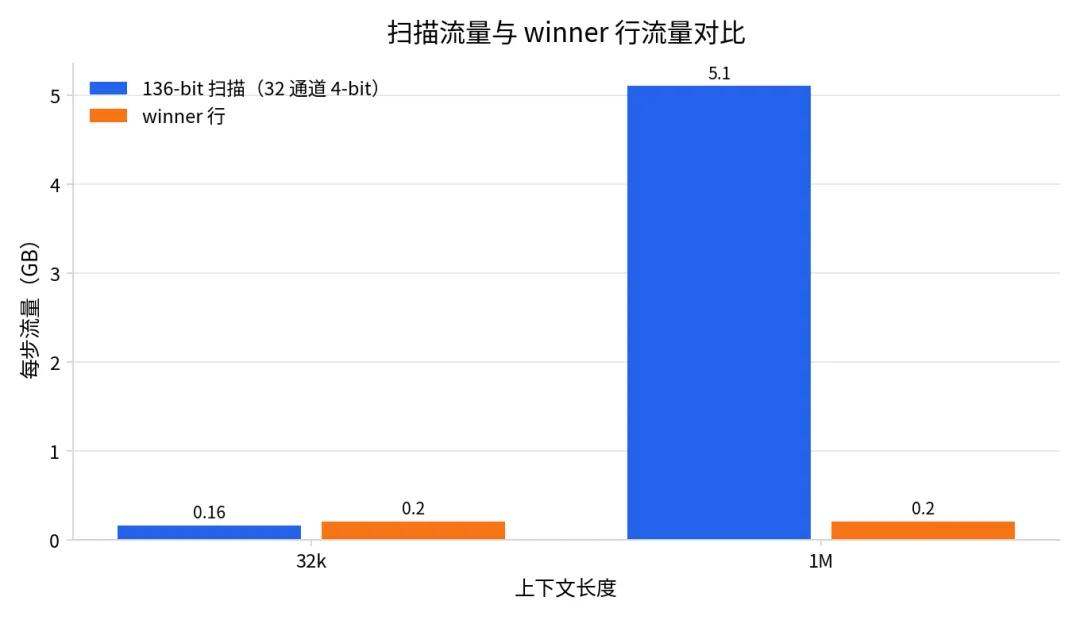
136-bit 扫描的每步流量随上下文线性涨到 5.1 GB,而 winner 行始终在 200 MB 量级不再增长,扫描成为解码的带宽瓶颈。(本文根据材料数据绘制)
这也是为什么"少读一点 bit"是有意义的杠杆。已有的 per-token 扫描都在这条路上,但都把深度写死了:Loki 读主成分坐标、Double Sparsity 读离线挑好的 c 个通道的 4-bit 标签、SparQ 让 query 选 |q| 最大的 r 个通道按全深度读、thumbnail 扫描把每个通道都读 2 bit。共同点是——它碰到的每个通道,读的深度都一样。
固定深度的浪费在哪
论文给了两个观察,把"深度可变"这件事变得可实现。
第一个是量化误差的性质。如果一个 key 的通道 j 已经读到 t 位,再加一位,剩余分数误差的下降量正比于 ,其中 是该通道对这个 query 的分数方差贡献。一个重要通道的第一位,价值远大于它的第四位;反过来,一个重要通道的第四位,可能还不如一个次要通道的第一位。按边际价值排序分配比特,这就是反向注水(reverse water-filling),而且有闭式解。
第二个是存储格式。如果 4-bit K cache 按 bit plane、channel-major 存,那么一个通道的前 t 个 plane 恰好就是它的 t-bit mid-rise 量化器,block scale 不变。前缀读是精确的、连续的,不需要额外的低精度副本。
两件事合起来,一个 4-bit 的 key 副本就被改造成了多分辨率索引,每个 query 按自己的需要决定读到多深。
方法一:把 K 缓存变成 bit plane
具体做法是:key 先用每通道均匀对称的 4-bit code 量化,每 64 token 一个 fp16 scale。均匀性是关键——只有均匀码,位平面的前缀才等价于一个更粗的均匀量化器,非均匀码没这个性质。
对 block β、通道 j,取 为 block 最大值,cell width ,code 为
code 8 对应零,最高位是符号位。block β、通道 j 的 64 个 code 的第 p 位打包进一个 64-bit word ,这就是一个 plane。plane 按 channel-major 排,所以 在序列方向上是连续的。
读前 t 个 plane,得到 。反量化值是 ——正好是 区间上、cell 宽度 的 t-bit mid-rise 量化器。t=4 时退化成原来的 4-bit 形式。
存储开销是每 token 每 KV head 68 字节。这个数字后面要单独算账。
方法二:每个 query 组做一次反向注水
对共享一个 KV head 的 query head 组 ,通道 j 对分数的贡献方差正比于
在 calibration key 上测一次。读 t 个 plane 相当于把 切成 个 cell,误差方差是 ——每多一个 plane,误差方差除以 4。这个误差进入分数时乘以 ,按组求和,于是通道 j 贡献的期望平方分数误差正比于 ,总量是 。
在 下最小化它,就是反向注水:比特优先给 最大的通道,每个通道的深度由它的重要性高出公共水位线 θ 多少决定。整数深度下的最优解是
每个 是 θ 的阶梯函数,随 θ 上升而下降,所以 也是。水位线取"让总和刚好塞进预算的最小 θ",每个 query 组做 30 步 log θ 上的二分就能找到。 的通道直接跳过,剩下的叫 active channels。论文实测在均值 48 bits 的读取下,128 个通道里会碰到 30-34 个,每个读 1-4 层。
这里跟 SparQ 有两个明确区别,值得单独记一下:
• 权重里加了 key 方差。SparQ 是直接按 排序,Fathom 用的是 。也就是说,同样是 query 权重很大,一个方差很小的通道不值得读太深。
• 深度是分级的,不是全有全无。SparQ 挑出 r 个通道就按满深度读,Fathom 在同一份预算下会让重要通道读 4 层、次要通道读 1 层、无关通道读 0 层。
计划由组内 G 个 head 共享,所以 K 字节只读一次。另外还有一个可选细节:不同层的分数分布尖锐程度不同,可以用贪心在 calibration 文本上给每层分配不同预算(per-layer plan),但论文的默认建议是 flat budget——不需要校准,也不依赖上下文长度。
一个绕不开的细节:基座选择
对原始通道做注水,前提是分数方差集中在少数通道上。论文发现这个前提成立与否取决于模型有没有 QK-norm:
• Qwen3 有 QK-norm,通道尺度被拉平,per-query 稀疏性本来就留在原始基座里。这时候旋转 key(KLT)反而会把稀疏性摊开,误差猛涨——Table 11 里 Qwen3-8B 32k 在均值 48 时,raw 是 0.0081,KLT 是 0.2908。
• Llama-3.1-8B、Qwen2.5-7B 系列没有 QK-norm,同样的旋转会降低误差(Qwen2.5-7B-1M 128k 从 0.0300 降到 0.0196)。
所以规则是:每个模型评估两种存储,Qwen3 用原始通道,另外三个用旋转后的 plane。旋转版本存 的 plane, 是 calibration key 的分数方差序特征基, 换成 ,其他不变。跟 Loki 不同的是——Loki 是截断到 r 个坐标,Fathom 把全部 D 个旋转坐标都存下来,由 query 决定每个读多深。
这条规则本身也说明了这个方法的定位:它不是量化格式无关的通用加速器,而是一个需要跟具体模型的注意力结构对齐的存储+读取联合设计。
实验:三种口径,三个不同的问题
论文在 A100-SXM4-80GB 上测了 7 个模型/上下文设置,把结果分成了三层来看,这个分层本身挺有信息量。
目标场景:索引在主机内存
这是方法真正面向的工况。1M token 下,Fathom 56-bit 读的单步 GPU 时间比 136-bit 扫描(也就是 SparQ r=32、Double Sparsity、Loki 的字节数)快 1.67×,比 landmark 索引快 2.50×,比 thumbnail 快 3.12×。wall-clock 口径下比值分别是 1.38、2.07、2.59×。
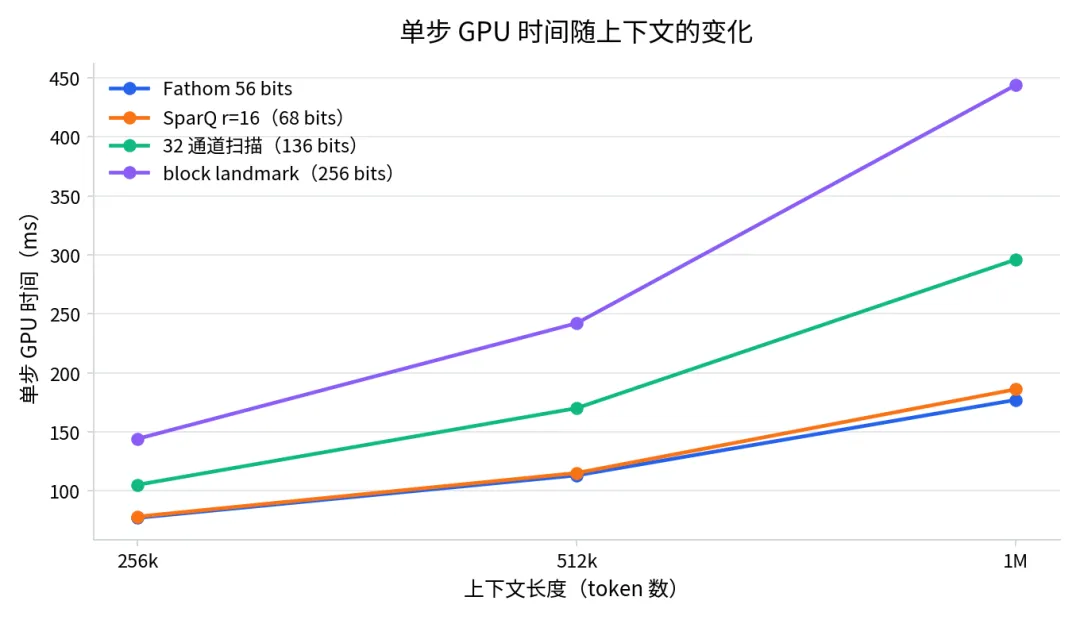
KV 行与扫描索引都在主机内存时,Fathom 56-bit 读的单步 GPU 时间随上下文增长最慢,到 1M token 时对 136-bit 扫描拉开 1.67× 的差距。(本文根据材料数据绘制)
为什么 GPU 时间和 wall-clock 差这么多?论文解释了:这是研究用的 harness 的 Python 侧开销,不同方法还不同,融合实现里不会有。所以论文把 GPU time 作为主指标。Table 4 把 1M 步拆开看,每个扫描都以大约 26 GB/s 的链路速率搬自己的字节,transfer 那一列就是字节数除以链路速率——Fathom 省的就是这里;它的 scan kernel 因为要提取比特,每字节成本大约是 SparQ 的两倍。共享成本(top-k 选择、winner 行抓取、权重 GEMM)占 Fathom 一步的 33%,占 32 通道扫描的 20%。
真实的 32k-128k prefill 下排序一致:128k 时对 32-channel 扫描快 1.26×,跟 SparQ r=16 打平(1.00×)。
与 SparQ r=16 同 GPU 时间比
这是我觉得最有意思的一组对照。SparQ r=16 读 68 bits/token,Fathom 56 bits,两者单步 GPU 时间几乎一样(1M 时 SparQ 是 Fathom 的 1.05×)。
时间固定之后比字节和误差:Fathom 少读 18% 的扫描字节,在 7 个设置上注意力输出误差低 1.1-5.3×(用两种计划里更好的那个;flat 默认在 6 个上成立)。差距最大的是下游最在意的选择比例——Qwen2.5-7B-1M 在 128k、k=2048 时是 5.3×;最小的是 Qwen3-8B 在 32k 配 flat budget,基本打平。
再往下压到均值 40 bits(约 47 bits),比 SparQ r=16 少 31% 字节,1M 时快 1.11×。
论文自己主动加了两条限定:wall-clock 口径下 SparQ r=16 在 1M 快 7%(还是那个 host 侧开销问题);如果所有索引都放进 HBM,两者耗时相同。另外 SparQ r=32(136 bits)在 7 个设置中有 3 个比 Fathom 的 56-bit 读更准,代价是 1.67× 的 GPU 时间——Fathom 需要读到 74-92 bits 才能在那几处追上。
等误差口径
以 Double Sparsity 的 136-bit 扫描误差为目标,Fathom 在全部 7 个设置上只需要 46-74 bits,即 1.8-2.9× 的节省。SparQ r=32 在 7 个里有 6 个是最强的固定深度扫描,达到它的误差需要 38-92 bits。Loki 在它没被 rank 限制的 4 个设置上,136 bits 的误差可以用 56-75 bits 复现;在 Qwen3 模型上它直接崩了——论文的 ablation 说明这是 rank 问题不是量化问题,r=32 用 fp16 坐标也修不好(0.4007),r=64 才行(0.0008)。
还有一个控制实验值得一提:如果索引放在 HBM、只有行在主机内存,所有 per-token 扫描在 128k 都落在 45-48 ms 一步,landmark 44 ms,thumbnail 55 ms,Fathom 并不更快。这个反例在后面还要说。
下游任务:RULER 分不出来,agent 会话能分出来
RULER 风格的合成检索和状态跟踪任务上,每个 per-token 扫描都落在 exact top-k oracle 的统计误差范围内:32k 时都在 0.008 以内,128k 时都在 0.025 以内,样本标准误是 0.014 和 0.034。换句话说,这类任务根本区分不出 per-token 扫描之间的差异,它区分的是选择粒度(block vs token)和 top-k 预算本身——block-landmark 索引在 32k 掉 0.043、128k 掉 0.130,就是被 block 均值掩盖了最佳 token。
真正能分开的是真实 agent 会话。论文用 OpenHands 在 SWE-rebench issue 上的真实轨迹拼成 80k-100k token 的会话,让每个方法从同一个 prefill 解码 agent 的下一步,指标是与 exact top-k 解码的 step agreement:
• k=2048(2% 上下文):Fathom 56 bits 是 0.67,SparQ r=16 是 0.49,block landmark 是 0.47。配对看每会话,Fathom 对 SparQ r=16 的优势是 +0.18 ± 0.05。
• k=512(0.5% 上下文):最准的是 SparQ r=32(136 bits)的 0.60;Fathom 用 92 bits 达到同样的 0.60,省 32% 字节。它的 56 和 74 bits 读则跟 Double Sparsity 的 136-bit 扫描同档,不差于 SparQ r=16(0.53 vs 0.49)。
论文还验证了 calibration 域的影响:换到 agent 领域或者干脆用会话自己的 prefill key 现算统计量(每 KV head 一个协方差,100k token 下不到一毫秒),step agreement 提升 +0.01 到 +0.07,在 1.5 个标准误以内,跟 SparQ r=32 的排序关系不变。也就是说,省字节省出来的优势不是靠 calibration 数据对齐换来的。
边界:这个方法的成立条件很硬
论文的 Limitations 写得相当老实,我挑几个关键的:
索引必须在慢速层。 这是最核心的前提。索引如果常驻 HBM,方法就不快,原因是 plane 提取是算术受限的——它每提取一个 bit 要做一次 shift-and-mask,还要做 G 次 multiply-add,而一个 4-bit nibble 每提取一次元素携带四倍的信息量。A100 上 32-channel 扫描的 kernel 时间在 32k 是 Fathom 的 0.73×,128k 是 0.70×,尽管 Fathom 读的字节少 38%。论文算了一笔:108 SM × 64 lane × 1.41 GHz 对 2.0 TB/s,A100 每字节约 5 次整数运算,H100 差不多,带宽偏弱的 L4 约 25——也就是说,在 A100 上算术受限的扫描,在任何当前数据中心 GPU 上都会算术受限。
而且还有个 Amdahl 的问题:如果扫描在稀疏注意力里只占少数,那即便扫描时间归零,收益也有限——这正是 HBM 索引那一组实验里所有 per-token 扫描都落在 45-48 ms 的原因。
per-layer 预算需要按部署校准。 16k 校准出来的 plan 用在 32k 上比 flat budget 还差。所以论文的默认是 flat budget:不需要校准,也不依赖上下文长度。
额外内存开销是真金白银。 作为独立索引,plane 存储是 68 bytes/token/KV head,是 Double Sparsity 17 字节的 4 倍,是 32 字节 landmark 索引的 2 倍。论文明确说:只有在 K cache 本身就是 4-bit 且 channel-major 的栈里,这份存储才可能是免费的(winner 的 key 直接从四个 plane 重建),而这条路"我们没有建,也没有测",而且从 channel-major 布局里重建单个 token 并不便宜。
量化格式的兼容性不通用。 只有标量均匀码(包括 KIVI 带 zero point 的 per-channel code、INT8)能直接兼容,因为均匀码的前缀还是更粗的均匀码。非均匀码失去精确性;KVQuant 的查表类型需要按值序存表并按深度分表,而且它的 pre-RoPE 量化和 outlier 分量各有需要处理的地方,论文没做;TurboQuant 的随机旋转会摊平方差(注水没东西可分),它的 Lloyd-Max 量化器还是非均匀的;codebook 向量量化没有 per-channel 位深的概念。
实验覆盖面的限制。 端到端任务成功率(带测试执行)没测,留给未来工作;多会话场景是从索引大小推算而不是实测——17 bytes/token 的 label cache 在 Qwen3-8B 的百万 token 序列上是 5.1 GB,32 bytes/token 的 landmark 索引是 9.7 GB,都不够跟权重挤在一起;128k 以上的计时用合成 KV 内容(因为这里没有模型能 prefill 一百万 token);k=512 的会话测试计划 100 个只跑了 40 个(k=2048 是 20 个);offload 表格是 batch 1,只有一次 batch 2 的检查;fidelity 每个设置只测一个 held-out window。landmark 基线是 ShadowKV 的 chunk mean 在一个它自己不使用的设置里的重实现,CPU 侧检索(RetroInfer、MagicPIG 这类)没有对比。
我的判断
这个工作的价值不在"又一个稀疏注意力优化",而在于它把存储格式和读取策略当成一件事来设计。bit plane 布局让"读前缀"这件事在物理上是连续 IO,反向注水让"读多深"这件事变成了 per-query 的决策。这两块是耦合的:没有前者,后者没法高效实现;没有后者,前者只是个没什么用的存储布局。
但它同时是一个前提非常多的工作。收益严格绑定在"索引也在慢速层"这个条件上——如果你的索引还在 HBM,或者你的 serving stack 不打算把 K cache 做成 4-bit channel-major,那这套东西的前提就不成立,而且在 HBM 场景下它会因为算术受限而变慢。68 bytes/token/KV head 的存储开销也是真实成本,论文没有回避。
另一个我觉得诚实的地方是实验分层。RULER 这类合成任务分不出 per-token 扫描的差异,论文没有拿它硬凑结论,而是另做了真实 agent 会话的 step agreement,并且明确说这仍然不是端到端任务成功率。从 measured 到 validated 之间还差一层,这一点作者自己标出来了。
如果要在实际系统里考虑这个方法,我会先问三个问题:索引现在住在哪一层;K cache 是不是(或能不能变成)4-bit channel-major;扫描在 decode step 里占多大比例。三个答案里只要有一个不对,这个方法的适用性就要重新评估。
原始链接
论文:https://arxiv.org/abs/2609.17652
代码与结果:https://github.com/vivekkalyanarangan30/fathom