ARTICLE · 1098197
让 AI 写代码别再过度设计:开源插件「马尾辫」怎么做、省多少、哪里会出错
让 AI 写代码别再过度设计:开源插件「马尾辫」怎么做、省多少、哪里会出错
用 AI 写过代码的人,多半遇到过这种情况:你只想在页面上加一个日期选择框,大模型却先安装第三方库,再编写包装组件、配置样式表,最后还讨论起了时区问题。
事实上,浏览器本来就自带日期选择框,只需要写一行代码就够了:
<input type="date">GitHub 上有一个专门解决这个问题的开源项目,名叫 Ponytail,中文意思是「马尾辫」。名字取自程序员熟悉的形象:扎着长马尾、戴椭圆眼镜的资深工程师,一言不发地把五十行代码改成一行。
一句话结论: 在容易过度设计的需求上,马尾辫能让 AI 少写一半以上的代码,而且不会省掉安全检查;但对于需求中没有写明的边界情况,精简后的代码更容易出错,档位开得越高,问题越明显。
本文围绕五个问题展开:AI 为什么总是多写 → 马尾辫如何约束 → 实际减少了多少 → 在哪里容易出错 → 如何安装、是否值得安装。 每部分末尾附有给工程师的要点。
一、AI 写代码,为什么总是写多
卡在哪
大模型写代码有一个倾向:宁可多做,也不少做。它习惯引入成熟的第三方库、抽象出可复用的组件,并尽量把各种可能情况都考虑进去。每一步单独看都有道理,但叠加起来,一个简单的需求就会膨胀成几百行代码。
代码每多一行,就多一处需要测试和维护的地方,也多消耗一份 token 和时间。
常规做法为什么不行
问题的根源在于:只要求"写少一点",AI 并不知道哪里可以省、哪里不能省。马尾辫提供的正是这样一套判断顺序。
二、马尾辫如何约束 AI
解法:七级台阶
马尾辫模仿的是资深工程师的思考顺序。 在动手写代码之前,AI 需要从上到下依次回答七个问题,并在第一个回答"是"的地方停下:
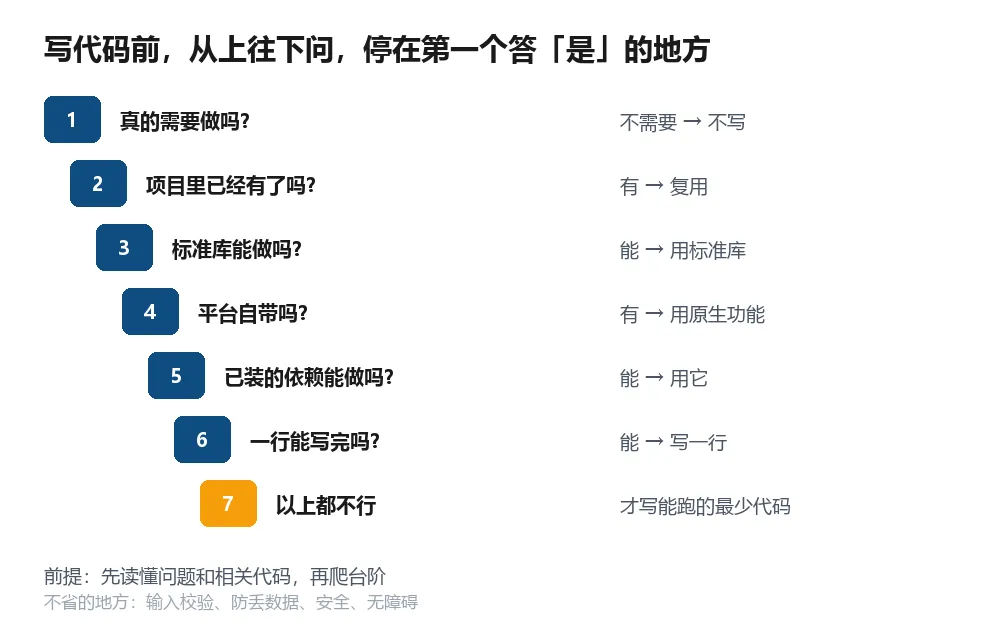
日期选择框的例子停在第 4 级:浏览器已经自带这个功能,直接使用即可。
规则中明确写了两个前提:
此外,规则要求不加无需求的抽象层、不引入新依赖、优先删代码;修复 bug 时要检查所有调用方,在共用函数中统一修复。
给工程师的要点
/ponytail lite 等命令切换,/ponytail off 为关闭;/ponytail-review 检查当前改动中的过度设计,/ponytail-audit 检查整个仓库,/ponytail-debt 把有意保留的简化写法汇总成清单;ponytail: 注释,注明适用上限和后续的升级方式。这些规则听起来很合理,但合理并不等于有效。它究竟让代码减少了多少?
三、实际减少了多少
证据:官方对照测试
作者最初公布的数据是"代码减少 80%~94%"。有开发者指出对照组回复过于冗长、数字被放大,作者随后重做了更严格的测试:让 Claude Code 在一个真实的 FastAPI + React 全栈项目中完成 12 个功能需求,每个需求运行 4 次,模型使用 Haiku 4.5。
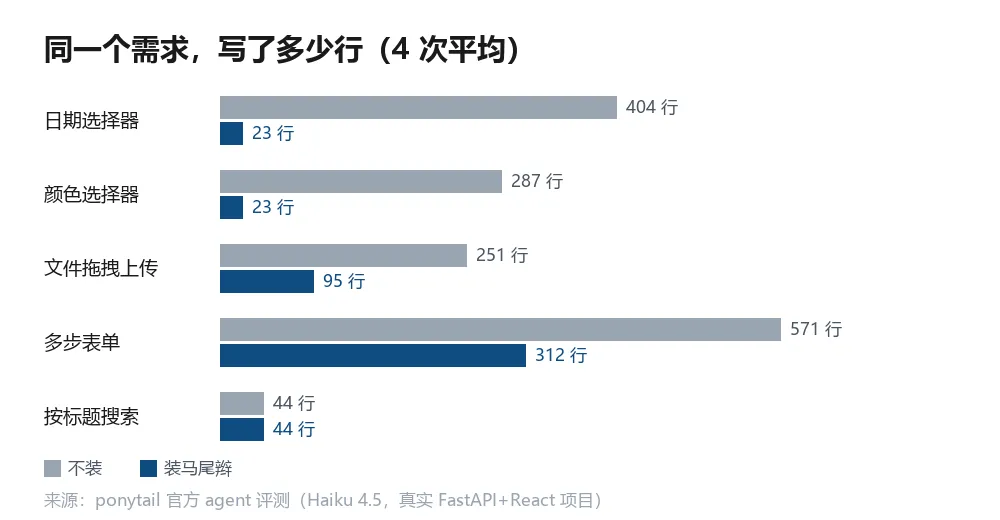
减少幅度最大的,都是浏览器已有原生功能的场景:日期、颜色选择框直接使用原生控件,代码从四百行降到二十几行。后端增删改查这类本身就不复杂的需求,代码量几乎没有变化。
在安全方面,5 个安全相关任务各运行 4 次,马尾辫全部保留了安全检查;而只要求"能一行就一行"的提示词,在一个处理文件路径的任务中删掉了防止路径穿越的检查。马尾辫多保留的那三行代码,恰好就是这项检查。
证据:第三方测试
另一位开发者使用 Opus 4.8 做了规模更大的独立测试,覆盖 24 个任务、480 次构建,通过实际运行代码评分。结果显示:full 档位下代码减少约 44%,两组的正确率都是 99%,所有攻击测试均未成功。
给工程师的要点
不过,第三方测试中还有一个结论更值得关注。
四、在哪里容易出错
边界情况变脆
在同一份第三方测试的 24 个任务中,有 5 个包含需求中没有写明的边界情况,例如输入格式错误或值为空。不安装插件时,AI 通常会主动处理这些情况;安装之后,这 5 个任务的异常输入处理率从接近满分降到接近零,而且档位越高,下降越明显。其余 19 个任务没有出现这个问题。
原因在于:马尾辫要求 AI 只做明确要求的事,而这些边界情况恰好没写进需求。
小模型通过率下降
有用户用两个小模型各运行了 15 个任务:gpt-4.1-mini 的通过数从 15 个降到 10 个,gpt-5.4-mini 从 15 个降到 14 个。模型越小,越容易把"少写"执行成"漏写"。作者也承认尚未在 SWE-Bench 等标准评测上测试。
注释标记过多
ponytail: 标记的本意是只标注有意为之的简化,但有用户反馈,AI 每次改动都会添加这类注释,甚至改写原有注释,有人因此卸载。作者确认规则只规定了何时加标记,没规定何时不加。
也有人指出其中的矛盾:反对过度设计的工具,本身却做成了一整套插件体系,于是社区出现了只含一个 AGENTS.md 的精简版 ponytail-lite。
给工程师的要点
了解了它的局限,最后来看如何安装,以及它适合哪些人。
五、如何安装、是否值得安装
安装方法
项目采用 MIT 协议免费开源,地址是 github.com/DietrichGebert/ponytail,支持约 20 种 AI 编程工具。
/plugin marketplace add DietrichGebert/ponytail,再发送 /plugin install ponytail@ponytail(两条命令需分开发送,且需要已安装 Node) | |
codex plugin marketplace add DietrichGebert/ponytail 和 codex plugin add ponytail@ponytail,再在 /hooks 中信任钩子 | |
node ponytail/scripts/cursor-hooks.js install | |
.kiro/steering/ponytail.md 复制到 ~/.kiro/steering/ | |
卸载前需要先运行 node scripts/uninstall.js,清除残留的状态文件。
总结
是否值得安装
归根结底,马尾辫纠正的是 AI 的一个坏习惯:做了没人要求的事情。它能让 AI 少写很多代码,但那些"应该做却没人提出"的部分,仍然需要你写进需求和测试中。