ARTICLE · 1122242
踩过 4 次 AI 代码的坑,团队把交付链路重排了一遍:事故追溯 3 天 → 40 分钟|附 5 段可复制源码
周五 23:47,值班电话紧急告警:优惠券叠加金额计算错误,波及 1.4 万笔订单。 排查到凌晨 3 点,问题代码的 git blame 指向一名已离职同事,但这段逻辑实际是 AI Agent 批量重构生成。提交记录干净,仅有一句 LGTM,没人知晓这是 AI 产出,也不知道当时的输入上下文。
经历这次事故,我们完整重构交付链路。两个季度落地后:事故追溯由 3 天缩短至 40 分钟,PR 审查等待从 6.5 天降至 1.2 天,版本准时率 74% 提升至 93%。
阅读收获:
📊 AI 落地后交付瓶颈对比图 🏷️ AI 代码溯源提交规范(源码) 🚧 AI 代码专属 CI 门禁配置(源码) 📈 工程效能指标替换对照表
01|AI 产出 62% 代码,版本依旧延期 9 天
我们 34 人电商研发团队接入 AI 编码 Agent,统计显示 62% 代码由 AI 生成,人均每周 PR 从 4.2 上涨至 9.1。 看似效率大涨,但 Q1 版本准时率从 91% 跌到 74%,大促迭代直接延期 9 天。问题并不出在编码环节:
表格
重点提醒:AI 同时生成业务逻辑和单测,测试会自动适配错误逻辑,这种 “互相欺骗” 是极高风险场景。
02|瓶颈已经搬家,编码变快,后续环节被压垮
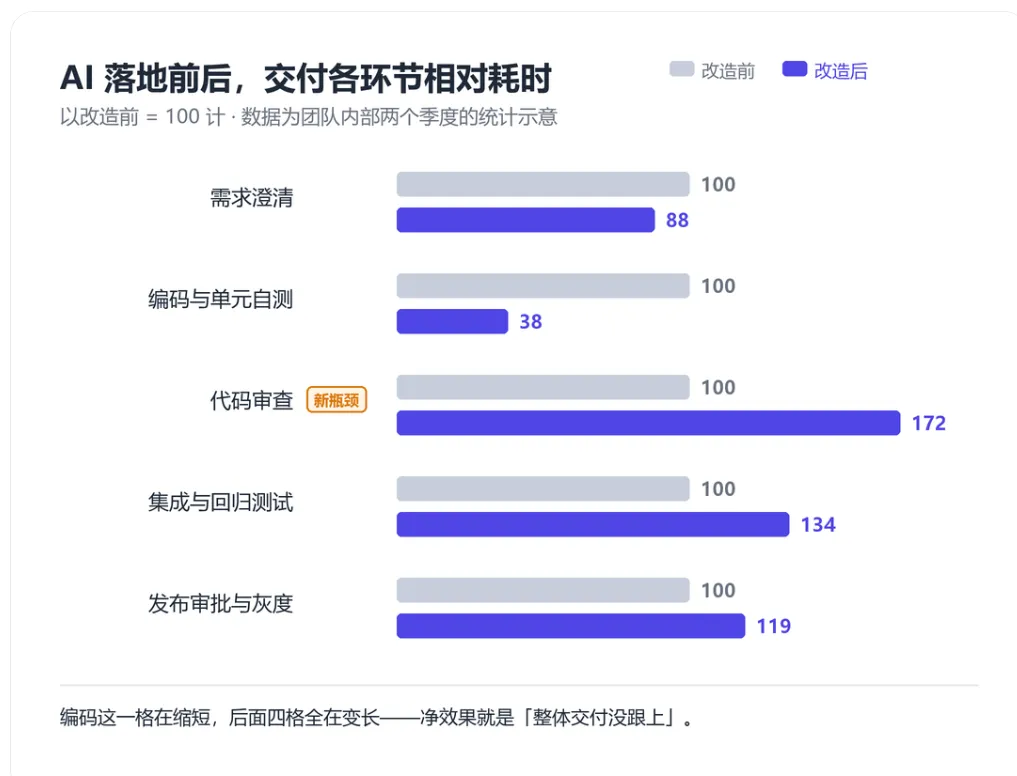
编码自测耗时:100 → 38,AI 极大加速写代码; 但代码审查 100→172、集成回归 100→134、灰度发布 100→119。
根据阿姆达尔定律,系统上限由最慢环节决定。把编码速度拉满,但评审吞吐量没有提升,瓶颈直接转移到评审、集成阶段。 解决思路不是继续优化模型生成速度,而是改造下游整套交付流程。
03|第一步:给 AI 代码打上出身标记,实现可追溯
事故难以排查的核心:不知道代码来源、AI 输入上下文、谁做的审批。 团队强制规则:所有 AI 参与的提交,commit 信息必须追加溯源 trailer。
feat(coupon): recalculate stackable discount ceilingWhy: 大促券叠加时,优惠金额可能超过券面总额上限What: 引入 DiscountCeilingGuard,在优惠中心收口所有叠加计算AI-Generated: trueAI-Tool: claude-codeAI-Model: claude-sonnet-4.6AI-Prompt-Hash: 7f3a91c4Context-Files: src/coupon/stack.ts,docs/promo/rules.mdRisk-Level: highReviewed-By: @li-zhangRefs: PROMO-2291
靠人工填写不可靠,编写 git 钩子脚本自动生成元数据:
# tools/stamp_commit.py —— Agent会话元数据自动生成提交trailerimport json, sys, hashlib, pathlibSESSION = pathlib.Path(".ai/last-session.json")REQUIRED = ("tool", "model", "prompt")def main(msg_file: str) -> int:meta = json.loads(SESSION.read_text("utf-8")) if SESSION.exists() else {}missing = [k for k in REQUIRED if not meta.get(k)]if missing:print(f"::error::AI 提交缺少元数据字段: {missing}")return 1p_hash = hashlib.sha1(meta["prompt"].encode()).hexdigest()[:8]trailer = "\n".join(["AI-Generated: true",f"AI-Tool: {meta['tool']}",f"AI-Model: {meta['model']}",f"AI-Prompt-Hash: {p_hash}",f"Context-Files: {','.join(meta.get('context', []))}",f"Risk-Level: {meta.get('risk', 'medium')}",])p = pathlib.Path(msg_file)p.write_text(p.read_text("utf-8").rstrip() + "\n\n" + trailer + "\n",encoding="utf-8")return 0if __name__ == "__main__":sys.exit(main(sys.argv[-1]))
挂载到prepare-commit-msg钩子自动执行,人仅补充风险等级与评审人。
04|第二步:CI 流水线分流,AI 代码走更严格门禁
打上标记后做流程分流,AI 生成代码触发一套更强校验规则,人工代码走原有通道。
# .gitlab-ci.yml(节选)stages: [lint, test, ai-review, deploy]ai-review-gate:stage: ai-reviewrules:- if: '$CI_COMMIT_MESSAGE =~ /AI-Generated:\s*true/'script:- python tools/stamp_verify.py # 校验溯源元数据完整性- complexity-check --max 8 src/ # AI代码收紧复杂度阈值- coverage-delta --min 8 # 强制单测覆盖率增量- security-scan --level high- clone-detect --across-modules # 检测跨模块复制粘贴重构allow_failure: falseartifacts:when: alwayspaths: [ai-review-report.html]
依据第三方统计:AI 产出代码问题密度约为人写代码 1.7 倍,因此需要差异化门禁,而不是完全不信任 AI。同时在仓库增加AGENTS.md,硬约束 AI 编码智能体的权限和编码规范:
# AGENTS.md — AI编码智能体硬约束## 你必须先读- docs/promo/rules.md 优惠结算业务规则- docs/arch/decisions/ ADR架构决策记录## 你不能做- 不得修改 src/settle/**(结算域仅允许人工修改)- 新增第三方依赖必须在PR给出方案对比- 禁止为通过测试而直接修改单元测试## 你必须做- 金额统一使用Money类型,禁止float- 改动必须满足coverage‑delta >=8- 提交trailer由脚本自动生成,禁止手写
05|第三步:不靠加人,用规则解决评审雪崩
单纯增加评审人员无法应对 2.1 倍的 PR 产出。我们落地风险分级、小批次、限流策略。
# review-policy.yaml 风险分级评审策略tiers:high:match: [支付, 结算, 优惠计算, 权限, 数据迁移]reviewers: 2require: ["coverage-delta>=8", "security-scan=high", "manual-signoff"]sla_hours: 4medium:match: [核心域服务, 对外接口]reviewers: 1require: ["coverage-delta>=5", "security-scan=medium"]sla_hours: 12low:match: [文档, 样式, 测试用例, 内部工具]reviewers: 1require: ["lint"]sla_hours: 24limits:max_open_prs_per_dev: 3max_pr_loc: 400 # PR超过400行强制拆分wip_limit_per_team:
max_pr_loc:400效果显著:拆分大 PR 后,单 PR 平均评审耗时从 47 分钟降至 11 分钟,团队整体吞吐反而提升。
06|全新交付链路,替换过时工程指标
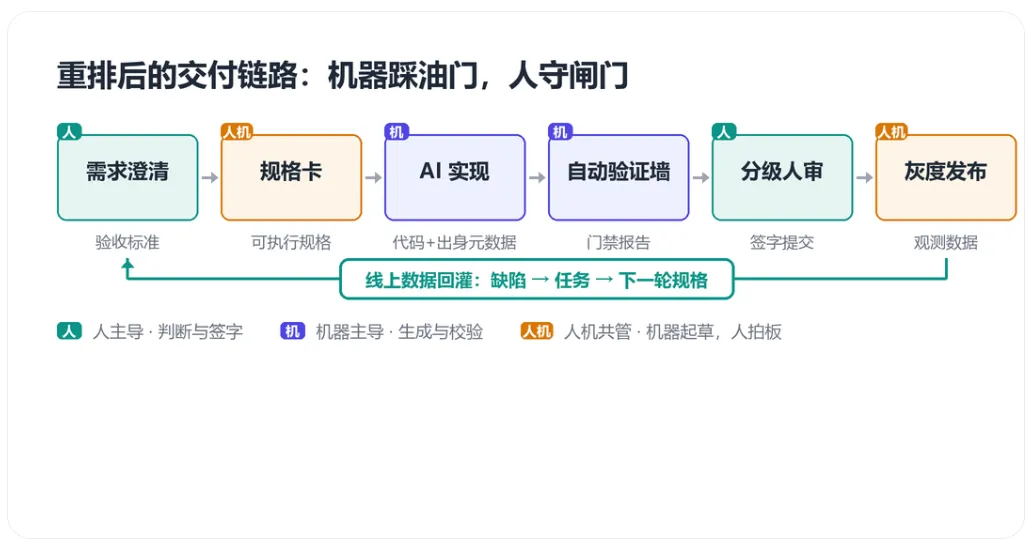
新链路逻辑:AI 负责生成、基础校验;人类做业务判断与审批;线上缺陷回流反向优化需求规格,形成闭环。
淘汰只看产出的虚荣指标,换成面向交付结果的统计口径:
表格
07|写在最后
AI 可以快速产出代码,但代码编写≠软件交付。交付要覆盖:生成、校验、评审、上线、故障可追溯完整全链路。 脱离流程管控,AI 带来的开发速度就是一笔随时爆炸的技术负债;把速度关进流程,AI 才是真正的工程资产。
互动:你们团队 AI 代码占比多少?评审流程跟得上吗?欢迎评论区交流。