ARTICLE · 1155357
AI 概念学习 · 第 2 期 :数据喂进去,模型长出来
长川投研 · AI 概念学习
AI 概念学习 · 第 2 期 · 基础篇
数据喂进去,模型长出来
2026 年 10 月 11 日 · 约 3300 字 · 阅读 9 分钟
上期回顾:第 1 期我们理清了三个大词——AI 是目标,机器学习是路径,深度学习是引擎。核心一句话:机器学习 = 不写死规则,给例子让机器自己学。
那问题马上就来了:例子从哪来?"学"这个动作具体是怎么发生的?学完之后,学到的成果又是什么、放在哪?这一期就把这台"学习机"拆开给你看——它的三样东西:数据、训练、模型。以后你听到的几乎所有 AI 新闻,都能放进这三个词的框架里。
1数据 Data · 学习机的原料
准确释义数据是机器学习的原料:以特定格式记录下来的事实与样本。在监督学习(最常见的机器学习方式)中,数据通常由两部分构成——输入信息(如图片的像素、一段文字、一笔交易记录)和对应的标签(正确答案,如"这张图是猫""这封邮件是垃圾邮件")。数据的数量与质量,直接决定了模型学习效果的上限。
大白话解释第 1 期说过,机器学习是"给孩子看几十只真猫和几百张照片"。那些照片,就是数据。它是学习机的课本和习题册。
拆开看,一份训练数据通常有两半:
▸ 题目(输入):一张图片、一句话、一条记录——"是什么样子"。
▸ 答案(标签):这张图是猫、这句话是好评、这笔交易是盗刷——"正确答案是什么"。
机器学习行业有句老话:Garbage in, garbage out(喂垃圾,吐垃圾)。课本印错了,学生再聪明也会学歪——数据质量不行,再先进的方法也救不回来。
🌰 举个例子:要做一个识别猫的模型,得先准备几百万张照片,而且每张都要标好"是猫 / 不是猫"——光这个标注活儿,就可能需要几千人干几个月。ChatGPT 这类大模型更夸张,它读的"数据"是互联网上海量的文章、书籍和对话,相当于一个人几辈子都读不完的书。
实际应用场景你每天都在生产数据:刷短视频时的每一次点赞和划走,都在教推荐系统"你喜欢什么";地图导航里你的每一次行程,都在帮它预测哪条路会堵;人脸支付时你的照片,就是刷脸系统的训练数据。可以说,在 AI 时代,数据就是新石油——谁手里有大量高质量的数据,谁就握住了训练 AI 的原料。这也是为什么互联网大厂在 AI 竞争中占尽先机。
与已学概念的关联第 1 期那句"机器学习 = 给例子和答案,让机器自己总结规律"——例子和答案,就是今天讲的数据。还记得第 1 期说过 AI 近十年才爆发吗?三要素之一就是养料(互联网海量数据)。没有数据,再好的方法也是巧妇难为无米之炊。
2训练 Training · 学习机的加工过程
准确释义训练是模型学习的过程:把数据反复输入模型,模型先对每条数据做出预测,再与正确答案对比、计算出误差,然后按误差方向微调模型内部的参数,如此循环成千上万乃至数百万次,直到预测误差足够小。这个"按误差方向调整参数"的核心机制,最常用的是梯度下降算法(后面讲神经网络时会再展开)。
大白话解释"训练"这个词本来就是体育界借来的——跟教练练运动员一个道理。它的本质是一个笨拙但诚实的循环:
▸ 先猜:模型拿到一道题,凭当前的"手感"给一个答案;
▸ 对答案:跟标准答案比一比,看差了多少;
▸ 改一点:按差距的方向,把自己内部的参数微调一点点;
▸ 再来:做下一道题,再猜、再对、再改。
就像练投篮:投一个(猜),看进没进(对答案),调整姿势(改),再投。没有哪个球一次就学会,靠的就是几百万次小修正的累积。
🌰 举个例子:下棋 AI AlphaGo 的训练,就是让 AI 自己跟自己下了几千万盘棋——每一步都"猜"最优走法,赢了输了都是反馈,反复修正。人脸识别模型的训练也一样:几百万张照片要来回过好多遍(每一遍叫一个"轮次"),每过一遍,参数都被微调一次。所以训练大模型往往要几万张 GPU 卡连续跑几周到几个月——为什么这么烧钱?第 3 期讲"算力与 GPU"时就明白了。
实际应用场景你听过的很多 AI 新闻,主角都是"训练"这个环节:"某公司花数亿元训练新模型""OpenAI 预训练出新版本""这家初创只用了 1/10 的算力就完成了训练"。另外还有一个行业术语"炼丹"——工程师们戏称训练模型像炼丹:把数据(药材)投进炉子(GPU 集群),守着火候(参数配置),盼着炼出好丹(好模型)。叫法戏谑,说的都是同一件事:训练。
与已学概念的关联第 1 期说机器学习是"机器自己总结规律"——但规律不是"叮"一下想出来的,而是在训练这个循环里一点点磨出来的。数据是训练的粮食(第 1 节),训练是深度学习的发动机在转(第 1 期的"引擎"比喻),而它磨出来的东西,就是马上要讲的第三个词——模型。
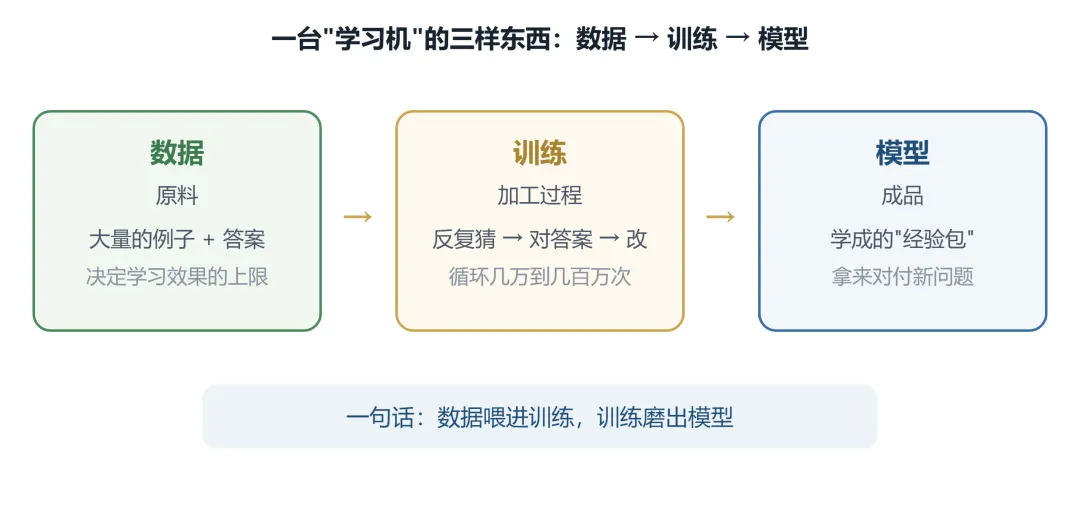
图 1:数据是原料,训练是加工,模型是成品
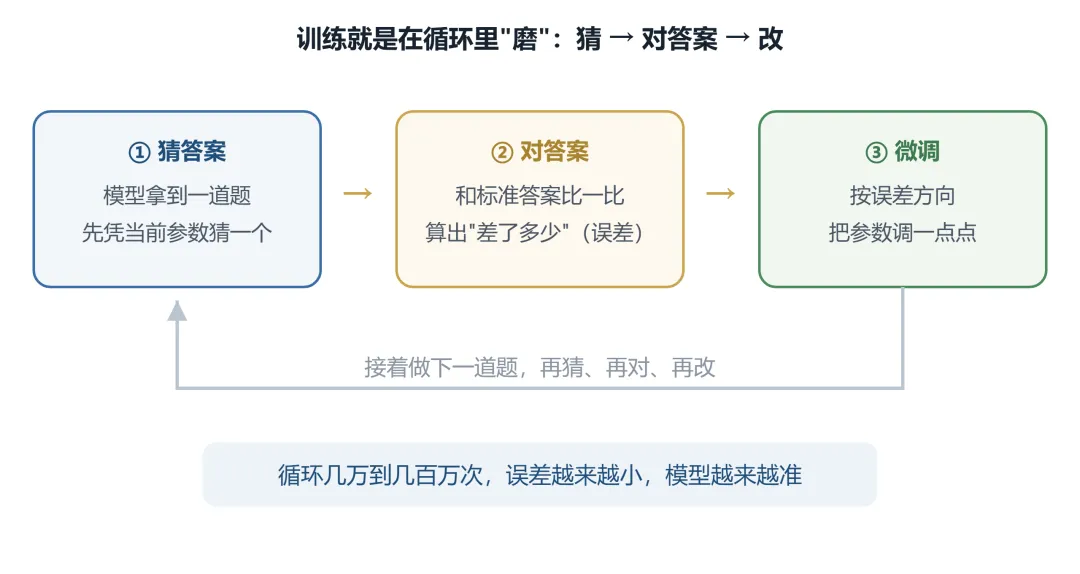
图 2:训练的本质是一个"猜 → 对答案 → 改"的循环
3模型 Model · 学习机的成品
准确释义模型是训练完成后沉淀下来的规律本身:一组数值上已经调好的内部参数。给它输入新的、没见过的数据,它就能给出预测或答案。训练前的模型像一颗空白大脑,训练后的模型是装满经验的成品——严格说,模型 = 结构(骨架)+ 参数(经验数值),训练只改参数,不改结构。
大白话解释分清三个词最关键的一步来了——训练是过程,模型是成果。就像"学生"和"学成的本事":练习册(数据)做完、上课(训练)上完,最后留在脑子里那套本事,就是模型。
两个直观理解:
▸ 模型是一个压缩的经验包:你手机里的人脸识别模型可能就几 MB 大,但它是几百万张人脸浓缩出来的规律——不需要把那些照片全存着,规律已经在参数里了。
▸ 新闻里说"GPT-4 这个模型""DeepSeek 发布了新模型",指的都是这个训练完成的成品。换模型 = 给产品换脑子。
🌰 举个例子:把手机里的翻译 App 断网试试——照样能翻。因为模型(连同参数)已经装在你手机里了,运行时不需要联网查"课本"。这恰好回答一个常见疑问:模型运行时还需要训练数据在场吗?不需要。规律已经长在参数里,就像你学会骑自行车后,不需要把教练带在身边。
实际应用场景"模型"是 AI 行业出现频率最高的词之一:大语言模型(GPT、DeepSeek,第 4 期细讲)、手机里的美颜模型、输入法的语音识别模型、量化基金里的预测模型……甚至"开源模型"指的就是把这套训练好的参数公开下载。模型好、模型差,直接决定产品智能与否——所以各家公司的军备竞赛,本质上是模型竞赛。
与已学概念的关联记得第 1 期图 1 里那个金色的框吗?——"机器学习:总结出规则(模型)",当时括号里埋了个伏笔,今天填上了:那条规则,就是模型。至此三个新概念闭环:数据是原料,训练是加工,模型是成品;再套上第 1 期的大框架——AI 是目标,机器学习是路径,深度学习是引擎,而引擎烧的是数据,转的是训练,产出的是模型。
📌 本期小结:一张知识卡带回家▸ 数据——原料:大量的例子(输入)+ 答案(标签)。质量不行,喂垃圾吐垃圾。
▸ 训练——过程:猜 → 对答案 → 改参数的循环,磨几万到几百万次。
▸ 模型——成果:调好的参数 = 压缩的经验包,拿来对付新问题。
▸ 一句话记住:数据喂进训练,训练磨出模型,模型拿去用。
✍️ 自测两道题(答得出,才算真懂):
1. 一个模型训练完成后,它运行时还需要把当时的训练数据带在身边吗?为什么?
2. 同样的方法,A 团队的数据又多又准,B 团队的数据又少又脏,谁的模型大概率更强?(提示:Garbage in, ______)
答案:1. 不需要,规律已沉淀在模型参数里。2. A,数据质量与数量决定模型上限,方法再先进也难弥补原料差距。
下期预告 · 第 3 期神经网络、参数、算力与 GPU——本期反复提到"参数",它到底长什么样?训练为什么动不动要几万张显卡、烧掉几亿元?下期拆开模型的"骨架",看看深度学习这台引擎的机械结构。
往期回顾AI 概念学习 · 第 1 期 :AI、机器学习与深度学习(每周日更新,建议从第 1 期看起,概念前后衔接)
长川投研 · AI 概念学习 · 每周日更新 · 仅供参考