ARTICLE · 1192205
8160亿参数免费下载 门槛搬到了内存条上
8160亿参数免费下载 门槛搬到了内存条上
但这次发布里,最值得注意的一句话既不在标题里,也不在那张漂亮的跑分表里。它在模型卡的一行小字里:
NVFP4 版本至少需要 700GB 加速器内存,BF16 版本需要 2TB。
权重是免费的。装下它的机器不是。
01 免费的东西,为什么还是拿不到
Muse Spark Open 的规格很漂亮。
模型规格 总参数 8160亿 | 每 Token 激活 420亿 | 专家数 / 激活 256/ 8 | 上下文 1Mtoken
这里有一个几乎所有人都会踩的坑:既然每一步只激活 420 亿参数,那是不是只需要装下 420 亿的参数量就够了?
不是。
混合专家架构省的是计算,不是内存。路由可以在每一步挑 8 个专家出来算,但"挑"这个动作发生之前,256 个专家的权重必须全部躺在内存里等着被挑。你没法在需要某个专家时才去硬盘里翻它——那个延迟会把每个 token 的生成速度拖到不可用的水平。
所以模型卡写得很清楚:量化到 NVFP4 至少要 700GB,原始 BF16 精度要 2TB。
Meta 给的解法是两台 M5 Ultra 的 Mac Studio。每台 512GB 统一内存,两台凑成 1TB,刚好卡在能装下量化版权重的门槛上。
载重清单 · LOADING单位 GB
BF16 原精度 2048超 2 倍
NVFP4 量化 700
两台 Mac Studio 1024
单机 512GB 512
标尺以 2048GB 为满格。BF16 权重需要两台机器再翻一倍;NVFP4 版本 700GB,两台 512GB 的 Mac Studio 才勉强装得下,单机不够。
支撑这套方案的不是 CPU,也不是 GPU 核心数,是 M5 Ultra 那 1.2TB/s 的内存带宽。大模型推理的瓶颈从来不是算得够不够快,而是把权重搬到运算单元面前那趟搬运够不够快。在 GPU 服务器里最贵的也正是 HBM 和互联,不是浮点算力本身。
问题在于:苹果这台 512GB 的机型要到 10 月底才上市,价格到现在还没有公布。
目前能查到的参考价是,一台 256GB 内存、1TB 固态的 M5 Ultra Mac Studio 售价 10799 美元。按这个价格凑够 1TB 内存需要四台,合计 43196 美元,不含税和配件。
也就是说,这次"开放"的价格标签,大致落在 4.3 万美元这一档。
顺带说一句,量化本身也是一笔交易。NVFP4 把权重压到 700GB,代价是精度;BF16 保住精度,代价是 2TB。你省下来的那 1.3TB 内存,是用模型的准确度换的。开放给你的不是一个模型,是一排档位,每一档都在让你自己选放弃什么。
这里藏着一个更本质的变化:"开放"这个词过去承诺的是权利,现在承诺的是权限。权利是别人给不给,权限是你够不够。权利可以靠一纸许可解决,权限只能靠硬件解决。
这不是批评,这是这次发布里最真实的信息。
过去二十年,"开放"这个词要解决的问题是"能不能合法拿到"。这个问题今天基本被解决了:你可以下载、修改、微调、蒸馏、再分发,不需要给 Meta 打任何一个电话。
新的问题是"能不能装下"。而这个问题,Meta 帮不了你。
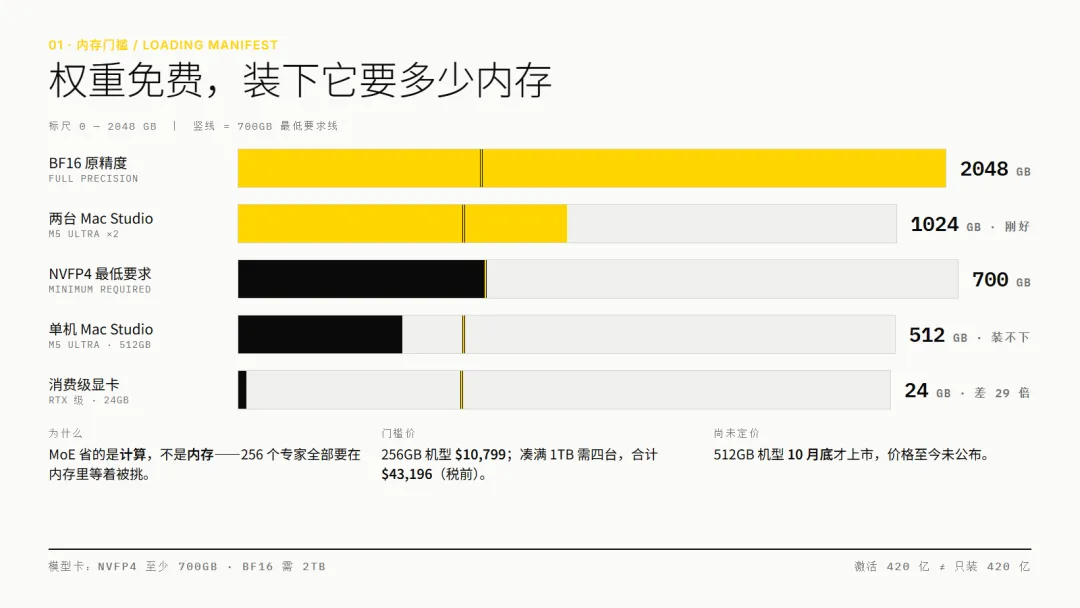
模型卡上的内存需求,才是这次开放真正的价格标签。
02 "美国最强"这四个字,才是发布的正文
Meta 的原话是:迄今美国能力最强的开放权重模型。
请注意"美国"这两个字。它是这次发布里信息量最大的限定词。
在 Meta 自己公布的表格里,Muse Spark Open 的 Artificial Analysis 智能指数是 39 分。同一张表里,智谱 GLM 5.3 是 45 分,月之暗面 Kimi K3 是 44 分,阿里 Qwen3.8 是 40 分。第三方独立榜单上,小米 MiMo-V2.6-Pro 是 46 分。
四个更高的分数,三个来自中国。
Meta 赢在哪儿
JobBench 工作流 61.8
MCP-Atlas 工具调用 89.2
HLE-Diamond 无工具推理 26.1
GPQA Diamond 科学 89.0
Terminal-Bench 2.1 终端编码 76.4
DeepSWE 1.1 软件工程 60.0
GDPVal-AA v2 专业工作 1401
SciCode 科研编码 58.5
OSWorld 桌面操作 80.4
绿色为 Meta 领先项,红色为中国模型领先项。数据来自 Meta 公布的评测表。
规律相当清楚:Meta 赢在工具调用和通用推理,中国模型赢在软件工程和专业工作。
有一项数据的差距大到不像同一量级:StrongREJECT v2 有害请求服从率,Spark Open 只有 0.5,越低越好,而三家中国模型在 62.9 到 66.6 之间。Meta 明确说,因为权重是公开的,它为 Spark Open 额外做了一轮安全后训练,并按"超级智能扩展框架"评估后才放行。
这同样是"开放"的代价之一:权重一旦公开就收不回来,所以开放的模型必须比闭源的更安全。这道成本,闭源厂商不用付。
一句话总结就是:Meta 赢了它自己选的榜单,输在别人选的榜单上。发布自家评测结果永远带着选样偏差——这不是造假,这是行业惯例,但读者要自己打折。真正独立第三方的复评,到发稿时还没有出来。
把镜头拉远一点,更能解释为什么"美国"这个限定词必须存在。
截至 2026 年 7 月,全球参数量最大的开放权重模型是月之暗面的 Kimi K3,2.8 万亿参数。阿里 Qwen 3.8-Max 的 2.4 万亿参数权重也在开放计划里。Spark Open 的 8160 亿,在这个坐标系里排不到第一。
更能说明问题的是份额。Hugging Face 在 2026 年 3 月的统计说,过去一年中国模型占平台下载量的 41%,第一次超过美国模型。OpenRouter 在 9 月报告,来自美国的请求中,开放权重模型吃下了 60% 的 token 量,其中大部分由中国实验室供应。
开放权重这件事的坐标系,已经不在美国了。Meta 加上"美国"两个字,是在承认这件事。
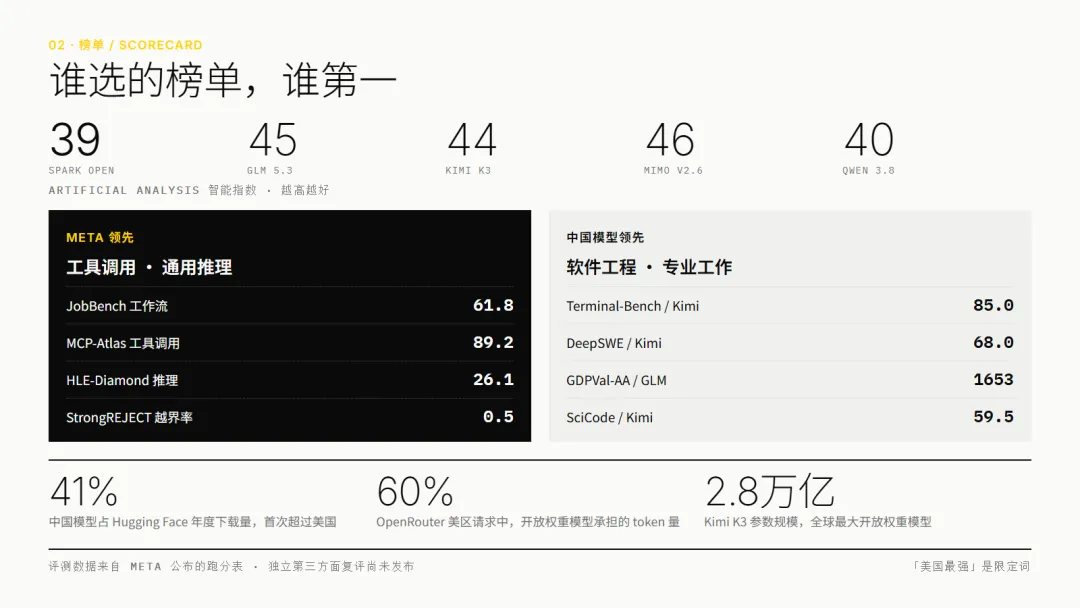
工具调用它赢,软件工程中国模型赢——榜单是谁选的,决定了谁第一。
03 免费是给用户的,不是给卖家的
Muse Spark Open 用的是 Muse Model License,不是 Apache 2.0。它给了你很多权利:运行、修改、微调、蒸馏、再分发。但有三个条件值得逐条读。
Clause 01 · 署名 所有产品必须带上"Built with Muse Spark Open"的标注,位置可以是文档、网站或设置页。
Clause 02 · 衍生品 衍生品的定义很宽——用它生成的输出去改进别的模型,也算衍生品。Meta 声明对生成内容不主张所有权,但这条口子开得很大。
Clause 03 · 2000 万美元 如果你和你的关联方在任意连续 12 个月内总营收超过 2000 万美元,并且想把它或其衍生品放进"模型即服务"业务,你必须先通知 Meta,并单独签一份书面协议。
第三条里有两个细节必须看清楚。
第一,这个数字算的是你和关联方的全部营收,不是 Spark Open 带来的营收。第二,它明确豁免了内部部署、研究、非模型服务的商业活动,以及把模型放进自家产品——只要这个产品本身不是模型服务。
所以这条条款真正的意思是:免费面向使用者,收费面向转卖者。
一家公司想给自己做一个内部助手,免费。一个创业团队想把它塞进自己的应用,免费。一家云厂商想把它挂出去按 token 卖,对不起,先谈。
Meta 让出了分发权,留住了分销权。
这是它 2026 年更精细的分层策略的一部分:小而快的 Muse Glimmer 走 Apache 2.0,大而强的 Spark Open 走自定义许可,托管的 Spark 走低价 token,最强的 Wonder 和 Full 只走 API 和订阅。权重、算力、服务、能力,四件事拆开卖。
这里必须厘清一个被长期混用的概念。
开放源代码促进会(OSI)的 OSAID 1.0 定义要求三件事:模型参数、完整的训练与推理代码、以及足以重建一个实质等效模型的训练数据信息。按这个标准,Llama、Qwen、Gemma 都不算开源模型,Spark Open 也不算。
第三方给英伟达 Nemotron 系列打出的"开放度指数"是 83%,而中国前沿开放权重模型普遍低于 50%。
这不是道德指控,是一个事实判断:你能拿到权重,但你复现不了它。开放给你的,是使用权,不是解释权。
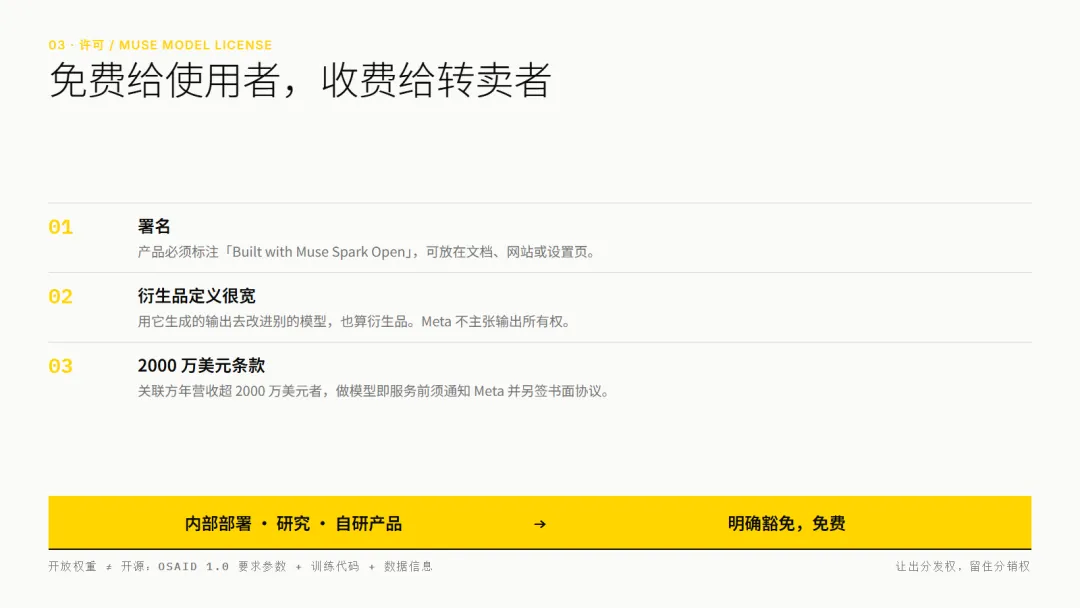
三条条款划出的边界:使用者免费,转卖者要谈。
04 苹果为什么成了这场开放运动的载体
这次合作最反直觉的地方,在于它是苹果和 Meta。
库克时代的苹果与 Meta 是公开的对手。库克多次指责 Meta 侵犯用户隐私,扎克伯格则公开嘲讽苹果"自 iPhone 之后就再也没有发明出任何了不起的东西"。
促成这次合作的,是双方各自都缺的那块东西。
Meta 需要证明自己的模型有竞争力,而且不只是跑分表上的竞争力——它需要一个"能在别人的硬件上真正跑起来"的证明。苹果需要证明整套 Mac 软硬件适合在本地跑 AI,而不是只在发布会的幻灯片上跑。
Meta AI 负责人汪滔说得很直白:双方的大部分积怨都形成于我加入公司之前。他还点名了两个关键人物——Meta 算力部门联合负责人、曾任苹果总监的丹尼尔·格罗斯,以及前 GitHub CEO 纳特·弗里德曼。(苹果方面的合作签署方为现任 CEO 约翰·特努斯团队,待确认。)
技术上真正的关键,不是芯片的算力,是内存的带宽。
M5 Ultra 的统一内存架构让集成 GPU 可以用到单台 512GB,两台合成一个 1TB 的池子;1.2TB/s 的带宽足以支撑每个 token 需要读取的那一小片参数。Meta 还为此写了自研的 Helion GPU 内核,在 SGLang 上取得 1.03 到 3.95 倍的内核级加速,在 AMD MI350 上端到端提速 3%。
Meta 演示了两组完全本地运行的智能体工作流:用 Muse Code 给开源 Mastodon 客户端 Ice Cubes 改 iOS 代码——修 bug、加功能、跑完整构建;以及驱动 DaVinci Resolve 逐帧审片,挑出最值得保留的片段并裁成竖屏。
如果这些演示站得住,含义很大:8160 亿参数的模型能装进两台台式机,"模型必须住在数据中心"这件事开始松动。数据不出门,第一次有了可以接受的代价。
这笔账之所以值得算,是因为它对立面是云。4.3 万美元是一次性支出,换来的是一份不会涨价、不会被下架、不产生每 token 账单的能力。云端的前沿模型按每百万 token 几美元到几十美元计价,用到一定量级,两年就能超过这笔钱。而且云端的合同可以随时改价,你手里的机器不会。
但要冷静。Meta 没有公布任何 token 生成速率,也没有公布整套硬件的完整成本。512GB 机型的售价至今未定。演示是演示,不是基准测试。
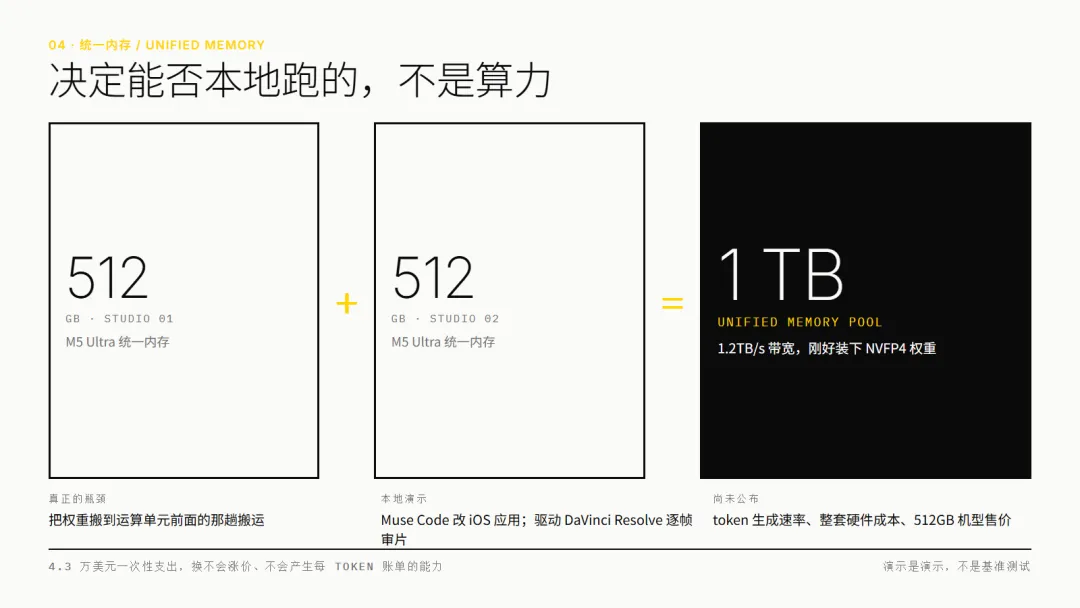
决定能否本地跑大模型的,不是算力,是 1.2TB/s 的那趟搬运。
05 真正稀缺的,从来不是权重
把时间线拉长看,这道门槛一直在移动。
2023.02 初代 LLaMA 发布,最大 65B 参数,仅允许研究用途。门槛在许可。
2023.07 Llama 2 放开商用。门槛从"能不能用"开始松动。
2024.07 Llama 3.1 的 405B 发布。参数规模第一次成为门槛。
2025.04 Llama 4 的 Scout 与 Maverick 带上原生多模态与 MoE——这套架构今天原封不动出现在 Spark Open 里。
2025 下半年 Llama 4 表现未达预期。扎克伯格重组 AI 研发体系,挖来格罗斯与弗里德曼,转向闭源。
2026.10.15 Muse Spark Open 发布。门槛不再是许可,也不再是规模,而是能不能装得下。
门槛的位置,从"能不能合法用"(许可),移到"能不能训出来"(规模),现在移到了"能不能装得下"(内存)。
每移动一次,能过线的人就少一批。开放并没有变得更封闭,它只是变贵了。
而且这道新门槛有个过去两道都没有的特点:它对所有人一视同仁。许可可以谈判,规模可以融资,唯独内存条的价格不讲情面,也不看你来自哪国。Meta 的工程师和一家中国创业公司,面对的是同一个 1TB。
这对中国模型是一句提醒。41% 的下载量和 60% 的 token 量都是很好的成绩,但下载量第一不等于装机量第一。下载是一个动作,装机是一次支出;动作可以重复,支出只能发生一次。
真正决定下一轮的,是一个更朴素的问题:每一美元能装下多少参数。
谁能把这个数字做低,谁才真正拿到下一轮的门票。这也是为什么这次发布里最值得记住的不是"8160 亿",而是"700GB"——前者是能力,后者是门票的价格。
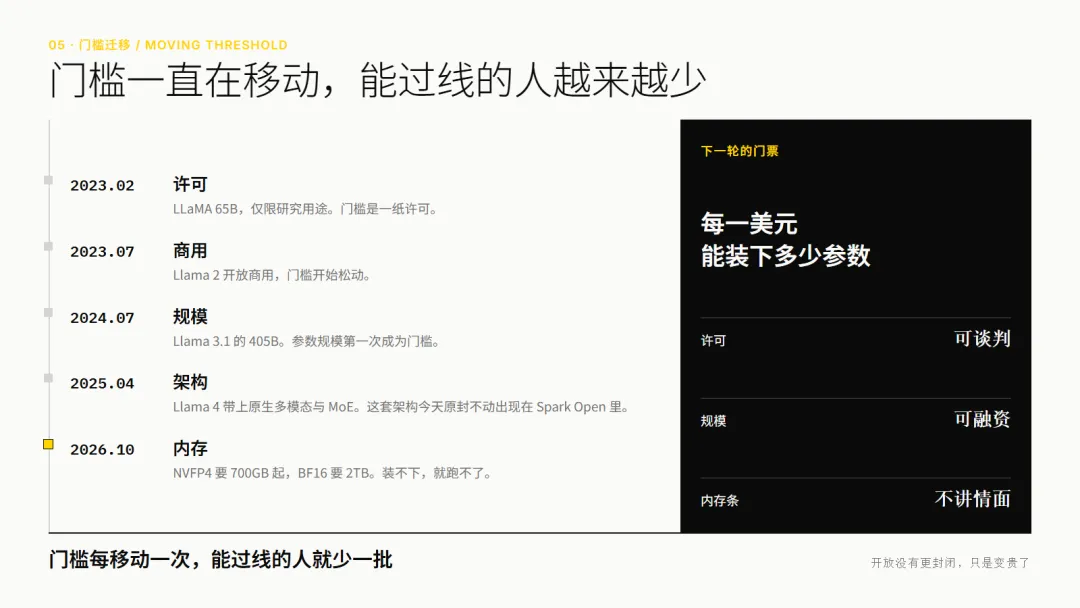
门槛从许可移到规模,现在移到了内存。
06 结论
一句话概括:权重免费的那一刻,门槛就搬到了内存条上。
01 别再把"开源"和"开放权重"当同一个词用。 ****它们对应的是两套完全不同的权利。采购合同里写错一个词,后面是法律问题,不是技术问题。
02 评估一个开放模型,先看内存需求。 ****顺序应该是:模型卡的内存要求 → 你的硬件有没有余量 → 最后才是跑分。一个你跑不起来的 8160 亿,不如一个你跑得动的 400 亿。
03 有"数据不能出门"场景的,现在值得重新算一次账。 ****4.3 万美元换一个本地可跑的前沿模型,在两年前是不可想象的报价。这笔账今年第一次算得过来。
这件事的影响,会比一次跑分排名深远得多。
参考资料
Meta 官方博客《Introducing Muse Spark Open, The Most Capable US Open-Weight Model to Date》,2026/10/15
VentureBeat《Meta unveils Muse Spark Open...》,2026/10/15;TechCrunch 同日报道
财联社《Meta发布美国最强开源大模型》,2026/10/16;腾讯新闻、站长之家同日报道
Wikipedia "Open-source artificial intelligence" 条目(2026/7 数据)
本号历史深度文(乐享知识库归档):《Kimi K3 2.8万亿参数开源 美国企业为什么开始集体转向中国AI》《内存涨了175% AI的第一张账单寄到了消费者手上》《内存涨了7倍 AI的胜负手从芯片挪到了仓库和电表》《OpenAI憋了四年突然开源 不是大方是害怕》《美国AI独角兽反水 中国开源模型正在成为别人的地基》
欢迎关注【铭心程行】
洞悉AI风向,掌握前沿资讯
[往期回顾]
作者提示:个人观点,仅供参考