ARTICLE · 1242794
3万亿王炸!AI突然不香了?
2026年10月24日 · 星期六 · 玄洲科技
今天的AI圈,上演了一出罕见的"冰火两重天"。
凌晨一点,月之暗面悄悄甩了个王炸——Kimi K3.1 Pro,3万亿参数,全球最大开源模型,跑分直接杀进全球前四。而同一天的资本市场,美股半导体板块10月已经蒸发了2.2万亿美元,"AI算力过剩"的恐慌正在席卷华尔街。
一边是模型能力还在狂飙突进,一边是资本开始怀疑烧钱故事讲不下去了。这到底是AI的新起点,还是泡沫破裂的前兆?
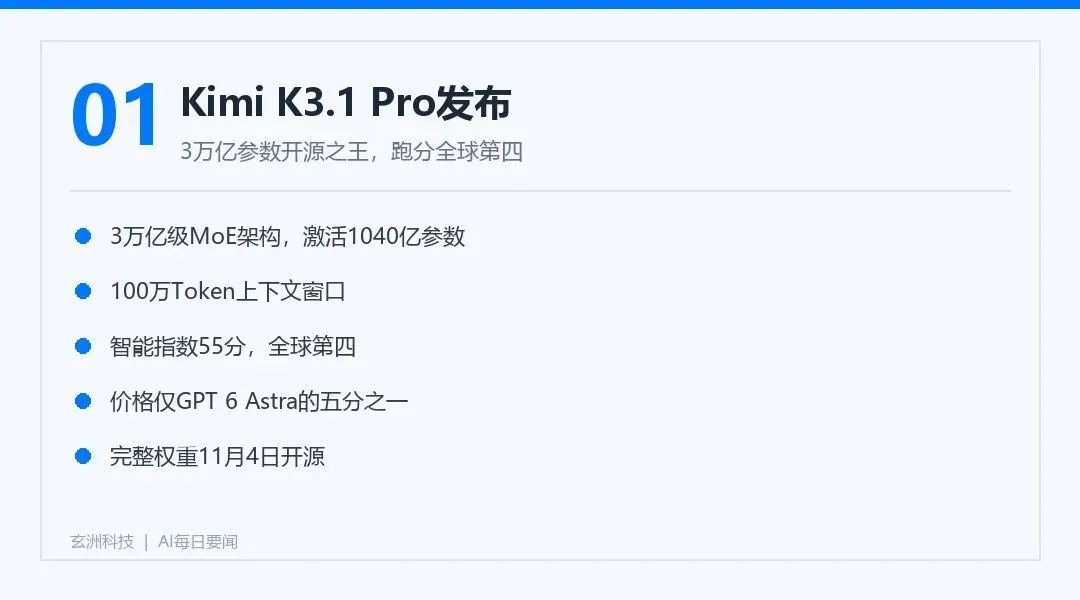
01 / 3万亿开源王炸,Kimi杀进全球前四
10月24日凌晨,月之暗面正式发布Kimi K3.1 Pro。这是K3.1系列的第一个模型,也是月之暗面迄今能力最强的3万亿级参数模型。
先看硬指标:
▸ 总参数规模:3万亿级(MoE架构,激活约1040亿)
▸ 上下文窗口:100万Token,一次读完一整套百科
▸ 跑分成绩:Artificial Analysis智能指数55分,全球第四
▸ 定价:输入$2/百万Token,输出$10/百万Token,比上一代再降三分之一
这个分数是什么概念?排在它前面的,全是GPT 6 Astra、Opus 5.5这个级别的顶级闭源模型。而K3.1 Pro是开源的——完整模型权重将于11月4日放出。
打个比方:以前你想开一辆顶级跑车,只能去4S店租,按分钟计费。现在有人直接把这辆车的图纸免费发给你,你可以在自家车库里组装,还能随便改装。而价格,只有租的五分之一。
这次升级的重点很明确:代码能力、3D创作、金融研究,以及长程Agent任务。月之暗面同步推出了Highspeed高速版,同等智能水平下输出速度快2-3倍,网页端、App、API全渠道即日可用。
值得注意的是,官方在开源前特意"削弱了黑客能力"——这是开源大模型第一次主动做安全降级,说明行业对开源模型的安全边界已经有了共识。
02 / 2.2万亿美元蒸发,AI烧钱故事讲不动了?
就在模型圈狂欢的同时,资本市场正经历一场剧烈的信任危机。
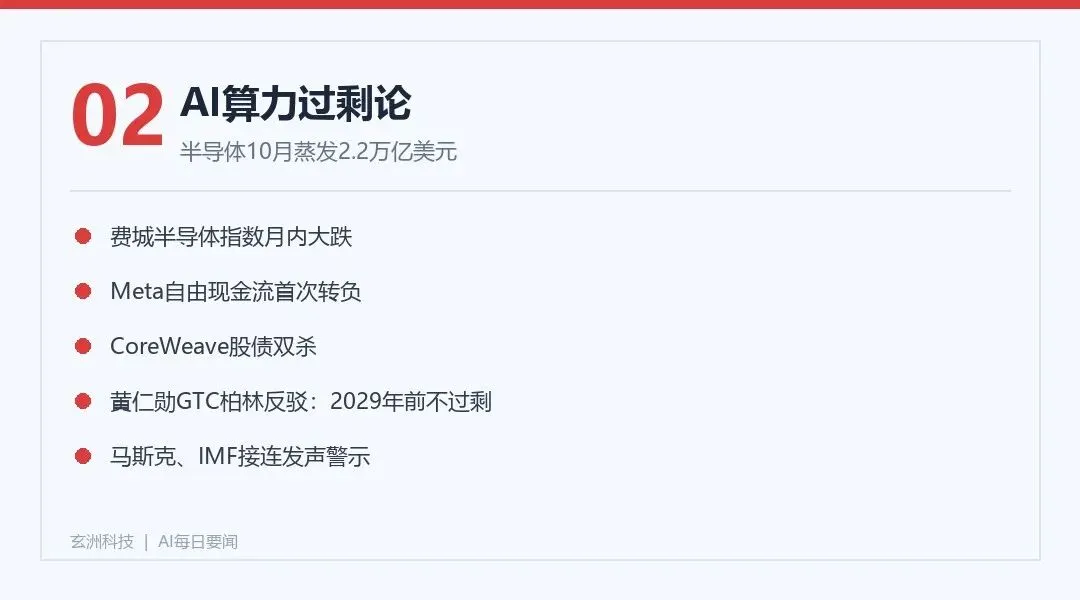
10月以来,美股半导体板块市值蒸发了2.2万亿美元。英伟达九个交易日回撤超12%,账面蒸发约6000亿美元;AMD跌16%,CoreWeave跌近30%,美光跌17%。
导火索是什么?三个信号同时引爆了市场情绪:
▸ Meta自由现金流首次转负——这家每年花几百亿买GPU的公司,自己都开始缺钱了
▸ CoreWeave股债双杀——英伟达的"亲儿子"云服务商,被市场质疑订单可持续性
▸ 存储芯片股集体抛售——市场开始担心HBM产能过剩
黄仁勋在GTC柏林大会上拼命"吹票":宣布联合供应链伙伴开启产业链大扩产,涵盖CPO、基板、先进封装,还给京元电子11亿美元产能预留预付款。他说:"到2029年内存供应过剩的可能性不大,AI革命才刚刚开始。"
但市场不买账。马斯克也出来喊话,IMF也发了警告——核心就一个意思:AI投资正在虹吸全市场的流动性,但回报周期越来越长。
有意思的是,企业端的数据和资本市场的情绪完全相反:SpaceX超智能业务单季营收76亿美元,资本开支高达164亿;Meta把全年资本开支计划提升到1350-1450亿美元。公司在拼命砸钱,投资者在拼命跑路。
这像极了2000年互联网泡沫的中段——基础设施还在疯狂建设,但华尔街已经开始算ROI了。区别在于,这一次AI确实有真实的产品收入,只是收入增速暂时跑不赢资本开支的增速。
03 / 一天650万亿Token,算力进入"有效产出"时代
不管是狂欢还是恐慌,有一个底层数据是绕不开的——Token消耗量。
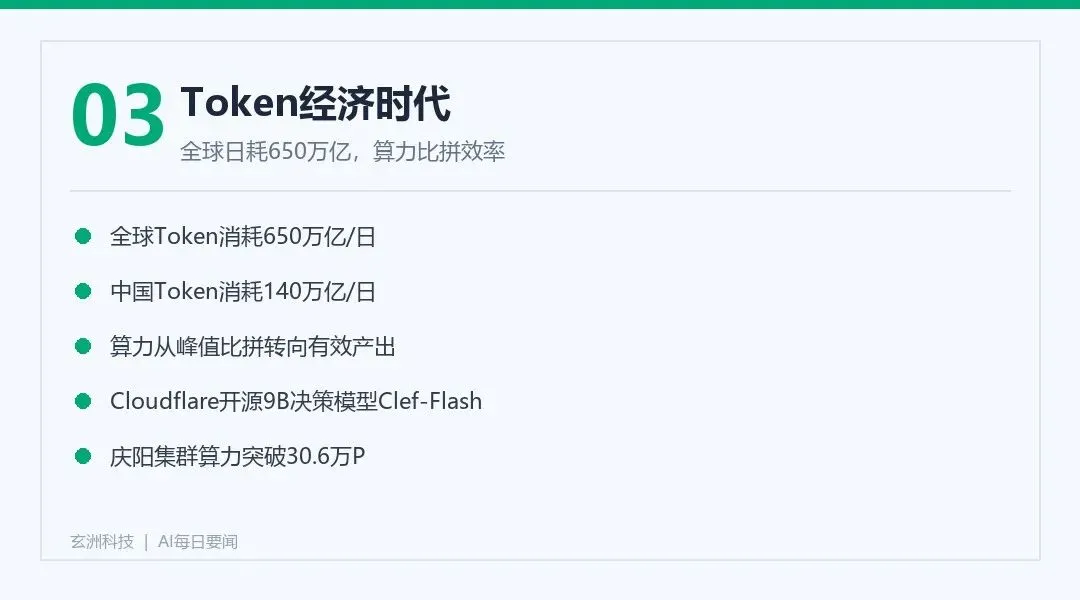
海光信息在最新演讲中披露了一组数据:当前全球Token消耗已达到650万亿/天,中国Token消耗达到140万亿/天,且仍在高速增长。
650万亿是什么概念?如果把每个Token比作一个字,全球AI一天"说"的话,足够全人类从宇宙大爆炸聊到现在。这不是虚的,这是真金白银在算力上烧出来的消耗量。
但关键变化在于:随着主流大模型参数向10T突破、上下文窗口扩大到10M级别,单纯堆叠硬件峰值已经不够用了。行业正在从"比谁算力多"转向"比谁的Token产出效率高"。
这就像发电站建设:早期大家比的是装机容量,谁建的大坝大谁牛。但到了后期,真正决定胜负的是输电效率、调峰能力和实际上网电量。装了一亿千瓦但发不出电,等于零。
与此同时,Cloudflare昨天开源了Clef-Flash——一款9B参数的多模态决策模型,专门为智能体场景优化,摒弃了传统逐Token生成的范式,直接输出可执行判断。这代表了另一个方向:不一定非要更大的模型,更聪明的推理路径同样重要。
庆阳数据中心集群的算力规模突破30.6万P,较去年底增长168%——"东数西算"还在加速落地。中国的算力基建没有因为资本市场波动而减速。
所以,真正的问题不是"AI有没有泡沫",而是:当模型能力还在每三个月翻一倍,而资本市场已经开始要回报的时候,中间这个时间差,谁来填?
写在最后
今天这三条新闻放在一起看,其实指向同一个趋势:AI正在从"拼参数、拼算力"的粗放阶段,进入"拼效率、拼商业化"的精细阶段。
3万亿参数的开源模型告诉我们,技术红利还在扩散;2.2万亿美元的蒸发提醒我们,资本开始要算账了;650万亿的日Token消耗则说明,真实需求比所有人想象的都要旺盛。
泡沫论者看到了估值,乐观者看到了渗透率。你站在哪一边?
如果觉得今天的内容有价值
点个「赞」和「在看」,转发给同样关注AI的朋友
玄洲科技 · 每天为你解读AI一线动态