ARTICLE · 1033804
AI 开始"自己改自己"了:智谱在十万张国产芯片上,两周让效率提升 3 倍
如果你雇了个员工,他不但干活,还会偷偷把自己干活那套机器整个拆了重装一遍,让整条产线快了 3 倍——你第一反应是高兴,还是有点发毛?
过去两年,你大概反复听过一句话:"国产芯片能买到,但训不出好模型。" 你是不是也默认了?
当"AI 又变强了"这条新闻越来越不值钱的时候,你有没有想过——强到什么程度,才算真正的质变?
这三个问题里,只要有一个让你顿了顿,这篇就是写给你的。
一、它干的不是"写代码",是把机房的命脉握在自己手里
先看事件本身。9 月 17 日,智谱 GLM 创始人唐杰在 X 上发了篇长文,披露了团队在"递归自我改进"(RSI)方向的第一个工程化成果。一句话说清楚:一个叫 Infra Agent 的 AI,自己动手搭好了自己赖以为生的整套推理系统,并且把性能优化到了 3 倍。
不是实验室 Demo,不是演示片,是已经上了生产环境的真东西。
你可能会说:AI 写代码不是早就有了吗?ChatGPT 不也能写 Python 吗?这有什么稀罕的?
差别就在这儿——过去我们让 AI 写的,是"给别人用的代码";这次它改的,是自己运行所依赖的基础设施。打个比方:以前 AI 是个熟练的工人,能帮你加工零件;现在它开始自己改装那台加工零件的机床,甚至决定机床该怎么保养、怎么排班。对象从"产品"变成了"自己跑在上面的那台机器"。
这笔账有多划算?同样十万张卡,同样的电费单,原来一天能服务的请求量,现在翻了 3 倍。智谱给出的口径是:不到两周,端到端吞吐提升到初始基线的 3 倍,硬件利用效率和单个 Token 的成本,已经逼近主流英伟达 GPU 的水平。它还支持 1M 的上下文窗口和多模态请求——这些不是 PPT 上的饼,是已经在线跑着的。
这套系统已经在真实流量里经受检验:GLM-5.3-Flash 化名 Ox-Alpha 挂在 OpenCode、OpenRouter 上,上线 6 天,Token 调用量超过 62 万亿。
全程实操向,建议先收藏,再往下看——后面有你能直接拿去用的对照表和判断清单。
二、先纠正一个认知:我们以前理解的"AI 会写代码",格局小了
在聊它到底怎么做到之前,得先拆掉两个刻板印象。不拆掉,你后面很难看清这件事的真正分量。
第一种误解:AI 变强,只是"答案越来越对"。很多人对 AI 的认知还停留在"问答机器人"——我提问,它答得更准。但真正让行业震动的,是 AI 开始动手执行工程闭环:自己分析性能瓶颈、自己定位精度缺陷、自己改底层代码、自己做分层测试,再根据实验反馈继续迭代。翻译成人话:它不是给你出主意的军师,是亲自下场干活、干完还自己复盘的项目负责人。
第二种误解:国产芯片"只能买,没法用"。过去两年,国产算力最大的尴尬就在这儿:卡能买到,但生态年轻、文档少、工具链新、坑还特别多,很多团队买回去只能吃灰,或者靠人肉调优勉强跑起来。智谱这次选择的,恰恰就是这块最难啃的"新手村"。
结果呢?那个 Agent 在十万张国产卡上,不到两周就跑通了,而且跑出了 3 倍吞吐。这背后是一个反直觉的事实:人类工程师最依赖的经验直觉,恰恰是 AI 能用穷举和快速试错替代的东西。文档少?它可以直接读代码。坑多?它一格一格去试,试错的成本远低于请一位高级工程师熬几个通宵。
所以真正的分水岭不是"AI 会不会写代码"——AI 写代码只是生产内容,AI 改自己才是参与运转。前者产出的是作品,后者影响的是整个系统的命脉。
三、它到底怎么"自己改自己"的?拆开给你看
按智谱披露的口径,Infra Agent 在十万卡集群上干了三件事:设计、调试、优化推理基础设施。
这三件事,平时分别对应三拨人,各管一摊:
设计,是架构师的活。以前要开一堆评审会,过五关斩六将才能定方案; 调试,是 SRE 和运维的活。半夜盯监控、翻日志、定位故障,那份苦只有他们懂; 优化,是推理工程师的活。拿着性能数据一点一点抠,抠出百分之几的收益都够写进年度总结。
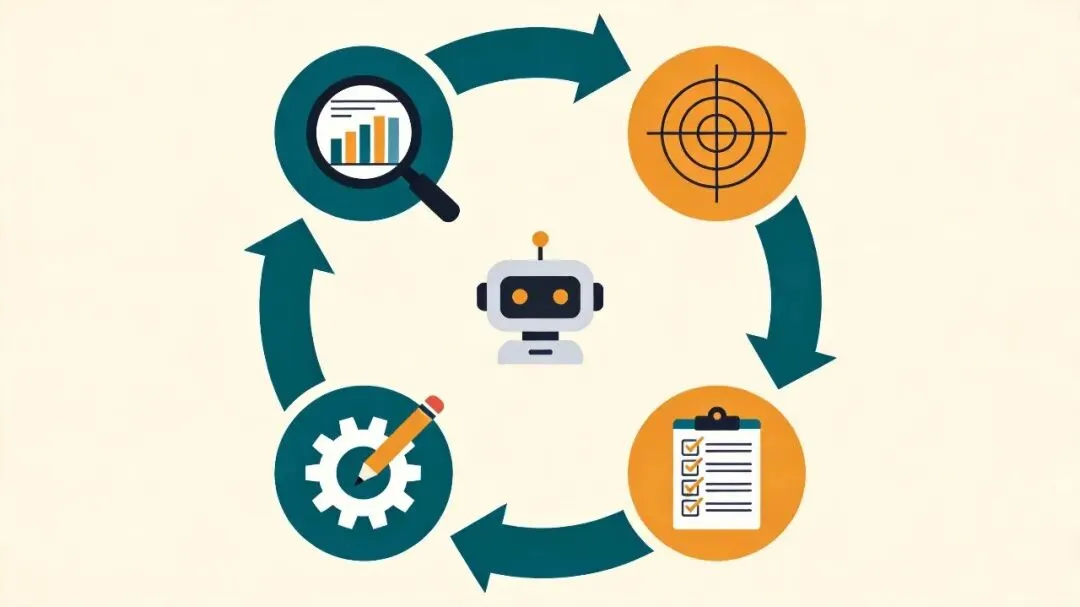
现在,这三摊活被同一个 AI Agent 接了过去。它不需要睡觉,不会因为"这是我搭的系统"而护短,也不会在凌晨三点盯着日志犯困。它会先跑一遍基准测试,找出吞吐的瓶颈卡在哪一层;然后去改底层代码,改完自己写测试来验证,不行就退回重来。
这套闭环跑起来之后,一个更深的意义浮现了——模型的迭代速度,不再线性依赖工程师的人力。以前优化一个系统,排期、评审、上线、复盘,按周算甚至按月算;现在 Agent 是全天候的,改一个版本可能只要几小时。这才是"复利"真正开始的地方。
四、三个对照表,看懂这次事件的分量
这里给你三张可以直接收藏的对照表,用来判断这次事件、以及未来所有"AI 自我改进"新闻到底值几个钱。
第一张:AI 写代码 vs AI 改自己
第二张:RSI 走到哪一步了(里程碑时间线)
第三张:国产算力的质疑清单,这次对上了几条
这三张表合起来,其实指向同一个判断:大模型竞争,正在越过"参数规模"和"榜单成绩"的比拼,进入一个更根本的阶段——AI 研发效率本身,成了被竞争的对象。
五、这事跟普通人有关系吗?
有关系,而且关系比你想象的大。
对普通人来说,最直接的信号是:AI 会越来越便宜、越来越快。当推理成本逼近主流 GPU、吞吐翻 3 倍,意味着同样的钱能买到 3 倍的算力服务,模型的下放门槛进一步降低。你我正在用的 AI 产品,背后很可能就跑在类似这样的系统上。
对做技术的朋友来说,这是个值得警惕又兴奋的信号。那些需要熬人力的脏活累活——半夜盯监控、抠几个百分点的性能——正在被 Agent 接管。别慌,这恰恰是提醒:人应该去做 AI 暂时做不了的事,而不是跟 AI 抢它已经学会的苦力。
有一个判断值得记住:AI 不再只是被造出来的工具,它开始参与决定自己怎么跑。这句话,是过去十年 AI 叙事的转折点,也是未来十年所有争论的起点。
写在最后
回到开头那个问题:如果 AI 开始改自己运行的机器,你是高兴,还是发毛?
这两种情绪其实都对。高兴,是因为迭代速度的复利意味着更强的能力、更低的价格;发毛,是因为"人"在这个循环里的位置,第一次变得可以替换。
但眼下,更值得关注的是另一件事:当国产芯片+国产模型第一次跑通"自己造自己"的自循环,过去那句"卡能买到但训不出好模型"的质疑,正被一个不知疲倦的 AI 亲手改写。