ARTICLE · 1065333
Voice AI * Robot: 从 Voice 到 Action:Voice Agent 如何进入 Robot Stack
纯软件的 Voice Agent 被打断,只需要停掉 TTS;但一个几百斤的机器人被打断,涉及到惯性、安全控制器与物理 Goal 的抢占(Preempt)。
从 SayCan、LMPVC 到 VLAS 和 MIRA,本文沿着“Voice 信号介入 Robot Stack 的深度”,拆解不同架构如何处理高层 Intent 分发、ROS2 异步 Action 反馈、声纹保留以及全双工物理打断。
最近一直在写 PHYSICAL AI 系列,大部分内容都围绕 Robot 本身:感知、VLA、Action、Controller、World Model,以及这些东西最后怎么落到一副真实的身体上。
我以前做过 Meeting 和 VoIP,这两年也一直在关注 Voice Agent。前段时间又看了不少 AI 陪伴玩具、社交 Robot 和 Humanoid 的产品。Voice 和 Robot 放在一起并不是什么新想法,很多产品已经能听、能说,也能配合表情、头部动作或者身体动作。
反而是因为这些东西已经存在,我开始想把 Voice Agent 这条技术线认真往 Robot 里面看一层。
一个 Voice Agent 在电脑或者手机里,最终输出一段文字或者声音就结束了。Robot 不一样。
“去门口等我。”
Voice Agent 可以很快理解这句话。但它理解完以后,究竟把什么交给 Robot?
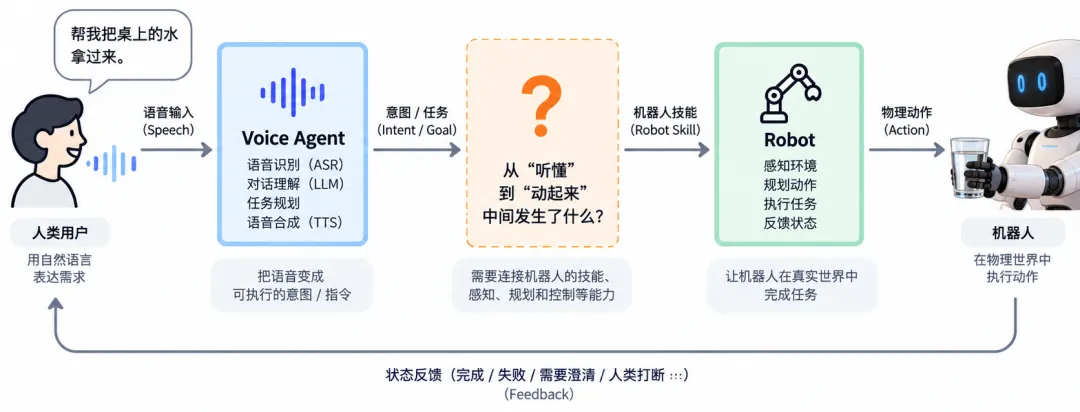
从 Voice 到 Robot,中间不是一个 Tool Call
现在的 Voice Agent 已经有不同的实现路径。
最传统的是 Cascading Pipeline:
Speech → ASR → Agent / LLM → TTS
中间文本可见,每一层都可以单独替换。另一种是 Realtime Voice-to-Voice,模型直接处理 Audio,再直接输出 Audio,不一定需要显式经过中间的 STT / TTS 接口。
Full Duplex 又是另外一个问题:系统能不能一边说,一边继续听用户讲话;用户插话以后,当前 response 能不能马上被打断。
不管前面是哪种 Voice architecture,只要最后接的是 Robot,后面的链路都会变长。
用户说“去门口等我”,Agent 最终也许生成:
move_to(location="entrance")
看起来已经很接近 Tool Calling 了。可 Robot 不能拿着字符串 entrance 去驱动电机。
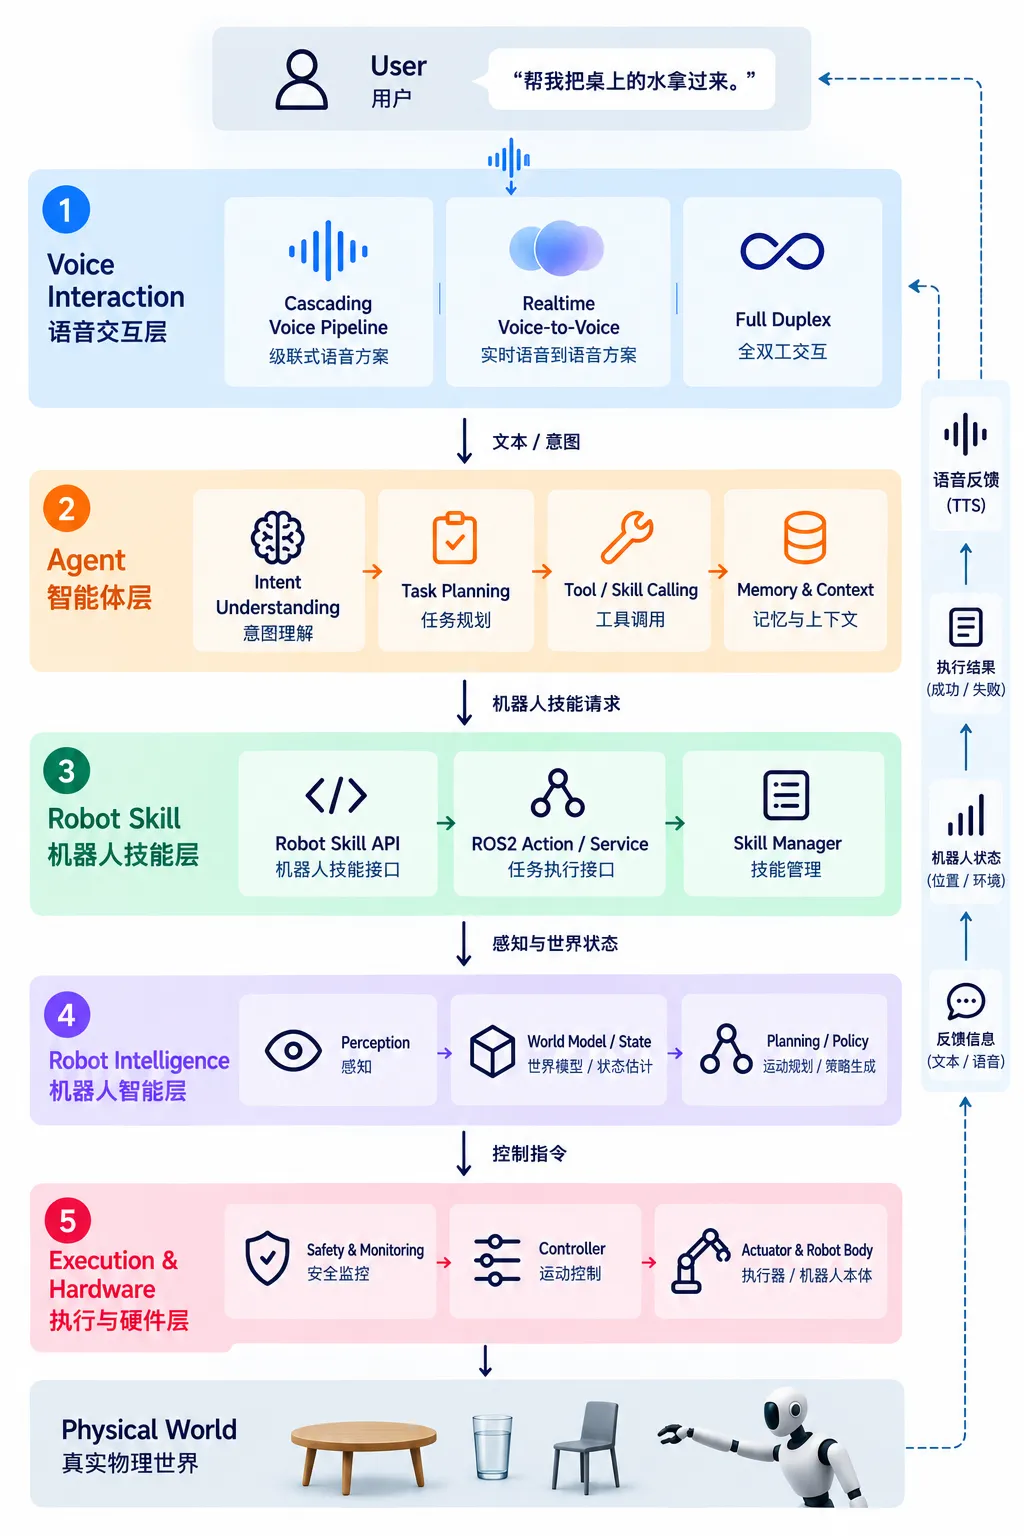
这张图不是某篇论文定义的标准架构,只是为了把后面的几个边界拆开。
VOICE INTERACTION
处理 Speech。可能是 Cascading,也可能是 Realtime Voice-to-Voice;Turn-Taking、Barge-in、Full Duplex、Streaming 都发生在这一带。
AGENT / REASONING
处理 Intent、上下文、Tool / Skill 选择,以及复杂任务的拆分。
ROBOT SKILL RUNTIME
更合理的接口通常是 move_to()、pick()、stop_current_task() 这样的 Robot 能力,而不是直接生成电机指令。
ROBOT INTELLIGENCE
Perception、Spatial Memory、World State、Planner、Policy、VLA 都可能出现在这一层。
EXECUTION & HARDWARE
再往下才是 Safety、Controller、Actuator 和 Robot Body。这里的运行频率、延迟要求和大模型完全不是一个量级。
“去门口”,门口到底在哪里?
move_to(location="entrance") 这个例子里,有一个很容易被 Tool Calling 掩盖的问题:
entrance 是语义,不是坐标。
Agent 知道“门口”的含义,Robot Navigation 需要的却可能是一个 pose、region、waypoint 或 door instance。
“去门口”
↓
Semantic Goal: entrance
↓
Spatial Memory / Semantic Map / Scene Graph
↓
entrance_door / entrance_region
↓
Target Pose
Hydra、Kimera 这一类 Spatial Perception 系统提供了一个很直观的参考。3D Scene Graph 可以把环境组织成 object、place、room 等不同层次的空间概念,并保存它们之间的关系。
这里不代表 Voice Robot 一定要使用 3D Scene Graph。Semantic Map、Spatial Memory、World Model 都可能承担其中一部分职责。关键是 Language 里的 Entity 最终必须落到当前 Physical World 里的 Entity。
Robot Skill 为什么更适合 Action,而不是普通 RPC
软件 Tool 很多时候可以一次 request / response。Robot Skill 经常持续几秒、几十秒,甚至几分钟。
ROS 2 的 Action 很适合拿来理解这种接口。Client 发送 Goal,执行过程中持续获得 Feedback,最后收到 Result,同时还可以 Cancel 或 Preempt 正在执行的 Goal。
GOAL
目标位置 · 对象 · 约束 · goal_id
↓
FEEDBACK
Executing · 剩余距离 · 当前状态 · 是否被阻挡
↓
RESULT
Succeeded · Aborted · Canceled
↑
CANCEL / PREEMPT
用户改变主意 · 环境变化 · Safety 要求停止
用户说“去门口等我”,Robot 已经走到一半,又说“算了,回来”。前一个 Goal 还活着。系统首先需要知道当前有哪些 Physical Goal 正在运行,再 Cancel 或 Preempt 旧 Goal,新的 Goal 才能接上。
Cancel 也不能直接等于“电机马上停”
软件 Voice Agent 被打断,很多时候 stop TTS 就够了。Robot 已经在运动时,cancel(goal_id) 并不等于 motor power = 0。
一条机械臂正在高速移动时,突然切断所有控制甚至可能比正常停止更危险。Robot 需要决定怎么停:受控减速、撤销后续 trajectory、保持姿态,或者在接触任务里继续维持一定的 force / impedance control。
Voice Agent 可以表达“停止当前任务”,但怎么安全停下来,仍然是 Robot runtime、Controller 和 Hardware Safety 的事情。
真实 Robot 的 Safety 往往分散在不同层:Planner 负责 collision checking,Controller 负责 joint / velocity / torque limit,Servo drive 还有自己的限制,工业 Robot 下面还可能接 PLC、Safety Controller、E-Stop 和硬件 functional safety。
重点不是某个组件必须叫 Safety Shield,而是这条 Safety Path 不应该依赖 LLM Reasoning 才成立。
SayCan:Language 先停在 Robot Skill 这一层
Google 2022 年的 SayCan 输入还是文字,不是今天意义上的 Voice Agent,但它很适合拿来理解 Language 和 Robot Skill 的边界。
Robot 先有一组已经训练好的 Skills / Policies。Language Model 判断某个 Skill 对当前任务有没有帮助,Robot 的 affordance / value function 再判断当前状态下这个 Skill 做不做得到。两边结合以后选择下一项 Skill。
Language / Reasoning → Skill Selection → Existing Robot Policy
LLM 负责高层语义,Robot Skill 负责可执行能力。把文字入口换成 Voice Agent,这种结构依然成立。
LMPVC:Voice 开始继续往 Robot Runtime 里面走
2025 年的 LMPVC 已经直接把 Voice Control 和 ROS2 放在一起。它除了使用 LLM 做 code generation,还加入了 Policy Programming、Teaching,以及一个可复用的 Policy Bank。
Voice → LLM / Program Generation → Policy Bank → ROS2 → Robot
Robot 的 capability 不再完全是一组开发阶段写死的固定 Tool,LLM 开始参与 Policy 的组合和生成。但 Voice 介入 Robot Stack 越深,执行边界反而越需要明确。
VLAS:Speech 不再只是入口,它直接进入 Robot Policy
VLAS 又往下走了一步。它把 speech recognition 能力整合进 VLA Policy,通过 speech-text alignment 处理 spoken instruction。
Speech + Image + Robot State → Robot Policy → Action
这里还有一个很有意思的点:如果所有 Voice 都先经过 ASR,进入 Robot Policy 的只是文字,原始 Speech 里的 voiceprint 会在 transcription 过程中消失。
VLAS 因此又设计了 voice retrieval-augmented generation,用 voice information 处理需要 individual-specific knowledge 的任务。Speech 在这里已经不只是 UI,它成了 Robot Policy 的一个原生输入模态。
MIRA:Full Duplex 往下走以后,变成 Physical Interruption
MIRA 研究的是 Real-Time Full-Duplex Human-Robot Interaction,并部署在 Astribot S1 humanoid 上。
用户还在说,Robot 已经开始回答,身体同时在做 gesture,用户又突然插话。系统需要同时决定 Speech、Turn、Gesture、Motion 和 Interruption。
MIRA 的 CORTEX 使用 dual-timescale interaction policy:一条时间尺度负责 low-latency streaming interaction,另一条负责相对慢一些的 turn decision。
Motion 部分用了一个很具体的设计:predict-more-than-commit。
PREDICT
先预测更长的一段 Motion
↓
COMMIT
只提交较短的 Prefix 给 Robot 执行
↓
下一窗口重新预测
用户插话时,未提交部分可以不再执行
Voice Agent 里的 Barge-in 到了 Robot 里,可能同时意味着 Stop / Change Response、Cancel Gesture、Cancel / Preempt Motion、Replan、Safety Check 和 Controller Transition。
从 SayCan 到 MIRA,不是一条模型升级路线
SayCan
Language → Skill Selection → Existing Robot Policy
LMPVC
Voice → LLM Programming → Policy Bank → ROS2
VLAS
Speech + Vision + Robot State → Robot Policy → Action
MIRA
Streaming Speech → Interaction Policy → Motion → Robot-side Execution
这几项工作并不是后一个取代前一个。它们解决的场景不同,但放在同一张 Robot Stack 上看,会出现一个很有意思的差异:
Voice 可以停在最上面的 Intent 层,也可以一路进入 Policy,甚至进入 realtime physical interaction loop。
介入得越深,Voice Agent 原来那些熟悉的问题也会发生变化。Turn-Taking 决定的不再只是“什么时候回答”,它还可能决定一个 Robot Skill 什么时候被 dispatch;Barge-in 也不再只是打断一句话,它可能变成一个正在运行的 Physical Goal 的 Cancel。
还有一个问题发生在所有 Robot Skill 之前
“帮我把……嗯……桌上的水拿过来。”
“帮我把……”后面停了 500ms。如果 Voice Agent 以为用户已经说完,它可能已经开始做 Intent Detection,甚至开始选择 Robot Skill。
在普通 Voice Assistant 里,抢话最多让人觉得烦。如果后面接的是一个 Robot Skill,Turn-Taking 的判断甚至可能影响 Physical Action 什么时候开始。
它凭什么认为,现在已经可以开始动了?
参考资料
Google Research, 2022. Do As I Can, Not As I Say: Grounding Language in Robotic Affordances / PaLM-SayCan.
ROS 2 Documentation. Actions.
Ossi Parikka, Roel Pieters, 2025. LMPVC and Policy Bank: Adaptive voice control for industrial robots with code generating LLMs and reusable Pythonic policies.
Wei Zhao et al., 2025. VLAS: Vision-Language-Action Model With Speech Instructions For Customized Robot Manipulation.
Nathan Hughes, Yun Chang, Luca Carlone, 2022. Hydra: A Real-time Spatial Perception System for 3D Scene Graph Construction and Optimization.
MoveIt / ros2_control Documentation:Realtime Servo、Controller Manager、command limits 与 controller fallback。
Lijian Lin et al., 2026. MIRA: Real-Time Full-Duplex Human-Robot Interaction for Embodied Companions.
事实边界
本文的分层架构是为了分析 Voice AI 与 Robot 接口而做的工程抽象,不是 ROS 2 或某篇论文定义的标准 Robot Architecture。
SayCan 本身使用的是自然语言文本,不是 Voice Agent;这里引用它,是因为它把 Language Model 与 Robot Skill / Affordance 的职责边界画得很清楚。
3D Scene Graph 只是 Spatial Grounding 的一种实现。实际 Robot 也可能采用 Semantic Map、Object Map、Spatial Memory 或其他 World Representation。
Safety 也不等于一个统一的 Safety Shield 进程。Collision Checking、Joint Limit、Force Control、Controller、Servo Drive 和 Hardware Safety 往往分布在不同层。