ARTICLE · 1092460
六种 RAG 框架的技术实现对比:从文档切分到问答生成
本文目录
一、Chunk 切分方法对比
二、索引构建方法对比
三、索引冲突与更新机制对比
四、检索实现对比
五、问答实现对比
六、总结与选型建议
附录:版本与源码位置
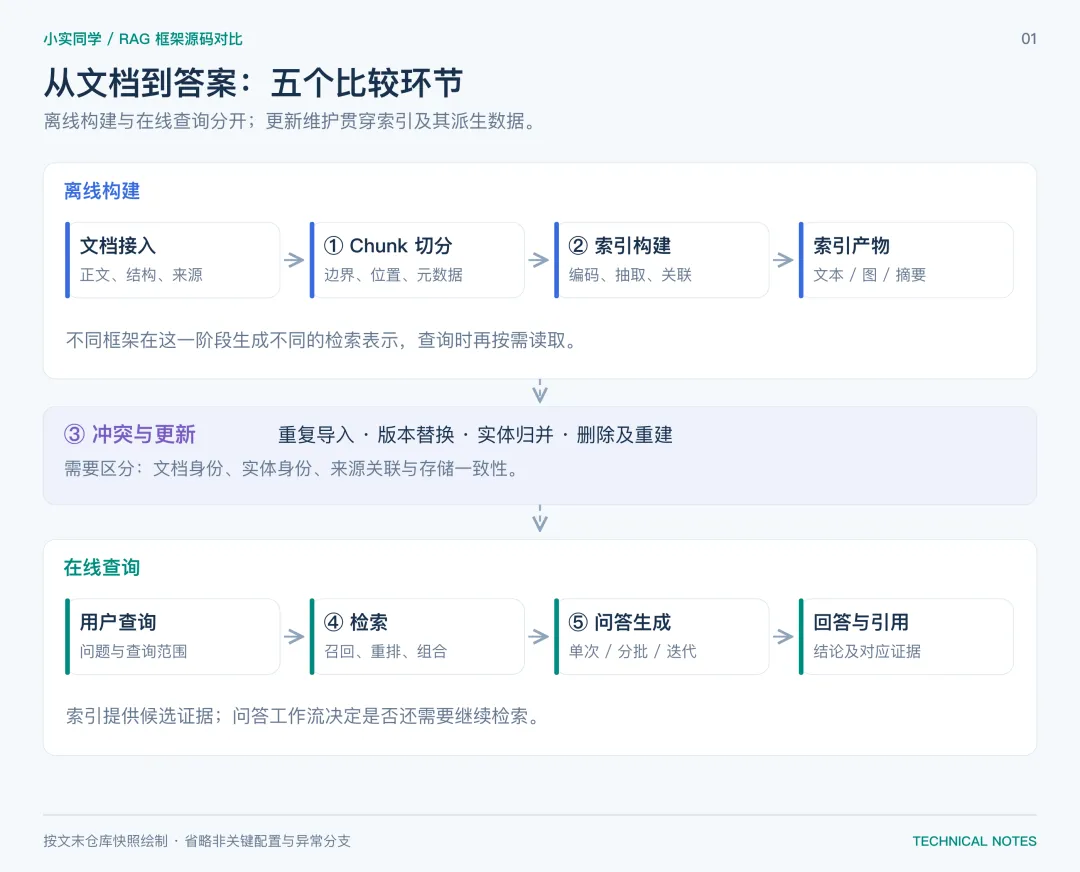
这篇文章把 dsRAG、GraphRAG、KAG、LangChain、PIKE-RAG 和 LightRAG 放到同一条处理流程里,比较五件事:文档怎么切,索引怎么建,重复和更新怎么处理,查询怎么检索,答案怎么生成。比较时有个前提:LangChain 提供的是可组合的组件和接口,其余项目则封装了各自的 RAG 流程。因此,下文比较的是具体实现,不把某条流程没有使用的能力,直接记成整个框架“不支持”。本文基于文末列出的六个仓库快照。代码路径、接口和默认行为以这些快照为准;这里只分析源码,没有进行六套框架的同条件跑分。文中的短代码均为流程伪代码,用于省略日志、异常处理和配置细节,不是可直接执行的仓库源码。
图1:RAG 总体处理流程
一、Chunk 切分方法对比
切分的结果不只是几段字符串。后面的检索、引用和删除都要依赖这些块的标识、位置与来源。看切分实现,除了边界,还要看输出保留了什么。
1.1 dsRAG:先分章节,再在章节内切块
dsRAG 的 chunk_document() 接收已经识别好的 Section 和文档行信息。它先遍历章节,把其中的视觉元素单独隔开,再对文本部分执行切分。视觉元素直接作为独立块;短文本保留为一块;超过阈值的文本交给 RecursiveCharacterTextSplitter。在这一层,长度按字符计算,overlap 设为 0。得到的 Chunk 保留行号、页码、章节索引和 is_visual 标记。这里还有一个细节:如果最后一块小于目标长度的一半,会与前一块合并。因此,chunk_size 不能简单理解为最终输出绝不超过的上限。
# 流程伪代码
for section in sections:
    for part in separate_visual_elements(section):
        if part.is_visual or part.is_short:
            keep_as_one_chunk(part)
        else:
            chunks = recursive_split(part, overlap=0)
            merge_short_tail(chunks)
        preserve_source_positions()
章节内使用普通切分器,不代表整条管线不使用 LLM。add_document() 接受语义分节配置,上游可以先用模型识别章节。分节与切块是两个阶段,要分开看它们是否调用模型。
1.2 GraphRAG:Token 与句子策略
当前快照已将相关实现拆到 graphrag-chunking 包。TokenChunker 把文本编码成 Token,按 size 取窗口,再以 size - overlap 向前移动。SentenceChunker 使用 NLTK 切句,并修正句子在原文中的字符位置。两种策略的边界依据很清楚:一个按 Token 数量,一个按句子边界。按句子切分能减少句子被截断的情况,但并没有执行主题理解或篇章级语义判断,不能与 LLM 语义分节放在同一列打勾。
1.3 KAG:按长度、语义、大纲或模式切分
KAG 的 splitter 是可配置组件。LengthSplitter 提供长度和滑动窗口控制,strict_length 决定是否严格按长度切;非严格模式会尝试保留句子边界。SemanticSplitter 调用 LLM 获取分段信息,再解析模型给出的段落位置和摘要;OutlineSplitter 围绕文档大纲组织内容;PatternSplitter 提供规则匹配切分。这几种实现的成本不同。规则和长度切分主要消耗本地计算;语义与大纲方案还要考虑模型调用、输出解析和分段失败后的处理。选择哪一种,需要结合文档结构,不能仅凭“带语义”判断效果。
1.4 LangChain:切分器与文档类型解耦
LangChain 将切分器独立在 langchain-text-splitters 包中。递归字符、Token、Markdown 标题、HTML、代码等切分方式可以单独使用,并不要求整套 RAG 都采用 LangChain。RecursiveCharacterTextSplitter 的基本过程是:从分隔符列表里找合适的分隔符;较短片段参与合并;仍然过长的片段继续用更细的分隔符切分。它根据字符结构工作,不会自行识别一段话的业务含义。标题切分器的价值则在于把层级信息写入元数据。之后是否把标题送进 embedding、是否用于过滤,取决于应用如何使用这些元数据。
1.5 PIKE-RAG:切分时同步生成摘要
PIKE-RAG 提供递归句子切分和 LLM 增强切分。LLMPoweredRecursiveSplitter 先生成初始摘要,再用基础 splitter 得到候选块;随后反复调整当前块的边界、生成摘要,并继续处理剩余文本。摘要保存在输出文档的 metadata 中。这里的特点是前后处理有依赖:本轮摘要会参与后续处理。与独立处理每个固定窗口相比,它多了一条上下文传递链,也增加了建库时的模型调用。
# 流程伪代码
summary = summarize_initial_context(text)
while remaining_text:
    candidates = base_split(remaining_text)
    chunk, summary, next_summary, consumed = refine(candidates, summary)
    emit(chunk, metadata={"summary": summary})
    remaining_text = remaining_text[consumed:]
    summary = next_summary
1.6 LightRAG:保留 Token 路径,扩展文件切分策略
chunking_by_token_size() 在当前快照位于 lightrag/chunker/token_size.py,仍然承担旧六参数接口的 Token 切分。字符分隔、Token 窗口和 overlap 的基本逻辑仍在,同时增加了对来源范围的处理。仓库还包含递归字符、向量语义、段落语义等文件切分实现,以及 chunker 注册机制。旧接口默认路径与文件解析管线可选策略需要分开说明,只查看旧接口,会漏掉文件管线提供的其他切分能力。
1.7 切分方式小结
切分效果要连着索引方式看。同样保留了章节标题,一个系统只把它用于展示,另一个把它加入 embedding 输入,后面的召回行为就可能不同。
二、索引构建方法对比
切分完成后,几个框架开始出现更明显的分歧:有的主要建立文本向量索引,有的继续抽取实体关系,有的再生成摘要、原子问题或社区报告。
图2:六种框架的索引构建流程
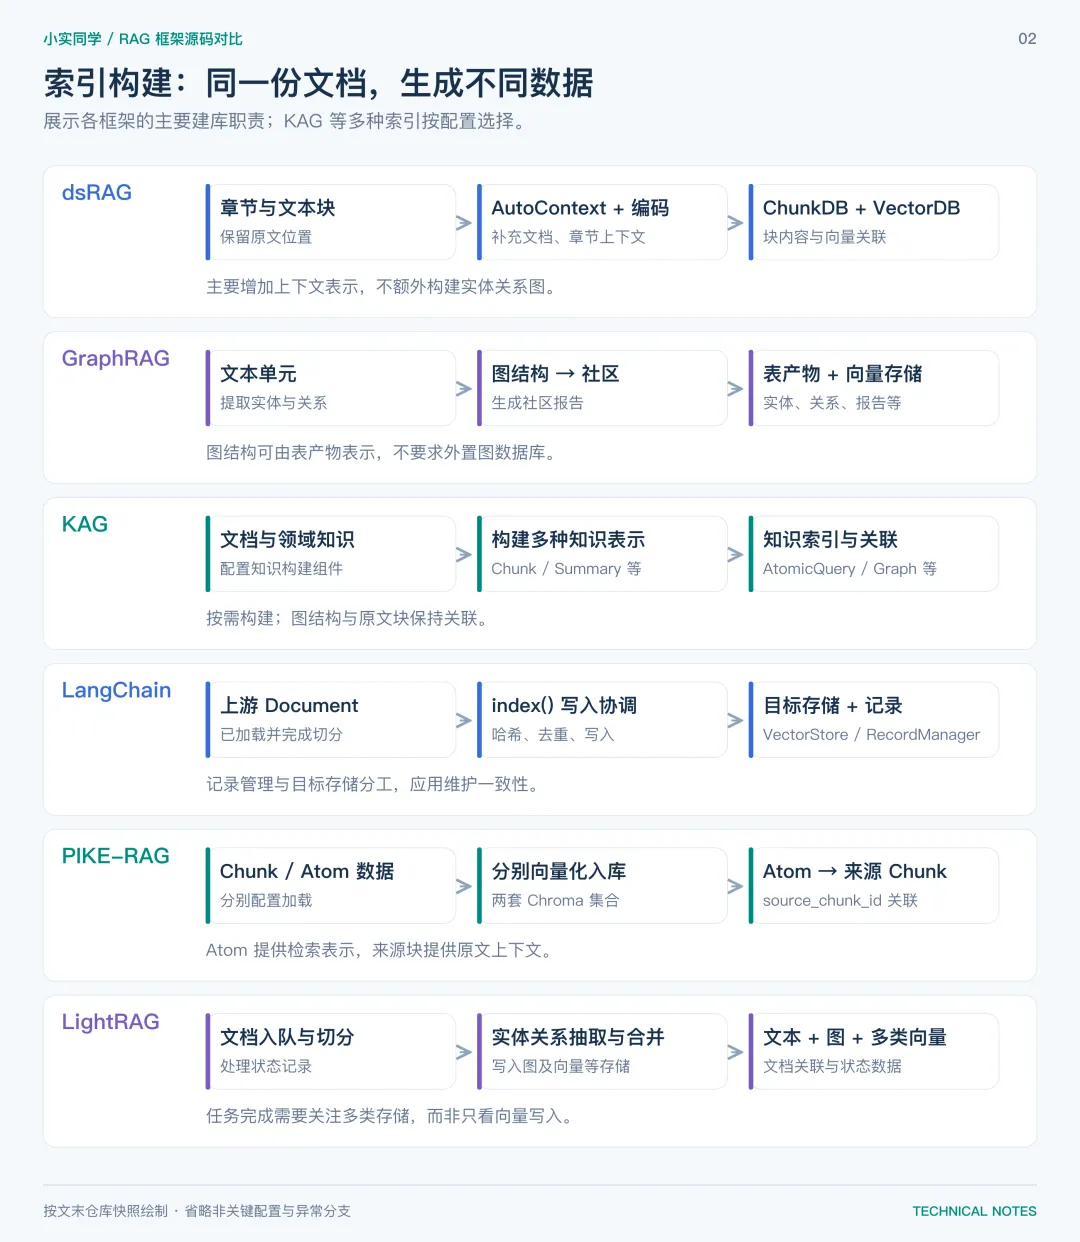
dsRAG 的建库入口依次执行解析与切分、AutoContext、embedding 和存储。AutoContext 生成或使用文档标题、文档摘要、章节标题等信息,按配置组织 chunk header,并形成待编码文本。
这里应区分原始块内容与 chunks_to_embed。向量表示可以带上额外上下文,检索后仍然能够根据块记录恢复原文。ChunkDB 与 VectorDB 分别承担块数据和向量检索的职责,由文档 ID、块索引等信息关联。
这条路线没有额外建立实体关系图。新增复杂度集中在上下文补充,以及查询时如何把块重新组织成片段。
2.2 GraphRAG:文本单元、图结构和社区报告
GraphRAG 的典型图索引流程包含实体关系抽取、描述处理、社区检测和社区报告生成。文本单元、实体、关系、社区、报告之间保留关联,查询模式再选择其中相应的数据。
不能把整个过程简单画成“所有 chunk 做 embedding,然后存进图数据库”。图结构可以由实体表、关系表等产物表示,不意味着必须部署一个外部图数据库;需要编码的对象也与检索配置有关。
社区报告是额外生成的知识表示。它能参与较大范围的查询,也意味着建库多了一层模型生成结果,需要保留与下层数据的关联。
2.3 KAG:多种知识表示共存
KAG 的 kag_index.py 中定义了 Chunk、Summary、Event、AtomicQuery、Outline、Graph 等索引类型。它们表示不同的知识组织方式,并非同一段文本换几个索引名称。
Chunk 保留文本,Summary 提供压缩表达,AtomicQuery 提供面向问题的表示,Outline 保留层次结构,Graph 组织实体关系。具体构建哪些索引由配置和构建组件决定。KAG 基于 OpenSPG,支持图结构与原文块的关联。仓库存在 Neo4j 适配实现,但不能据此把整个 KAG 的存储限定为 Neo4j。
2.4 LangChain:索引写入与状态记录分工
LangChain 的 index() 接收文档来源、RecordManager 和目标存储。文档加载、切分一般由上游完成;索引接口处理哈希、去重、写入、刷新记录和旧数据清理。
RecordManager 记录哪些文档已经索引、何时刷新、属于哪个来源。正文和向量仍由目标存储负责。接入时要维护这两部分的一致性:目标存储写入失败、记录刷新失败或清理中断,都是需要处理的情况。
2.5 PIKE-RAG:Chunk 与 Atom 双索引
基础流程可以把文本块写入 Chroma。启用 ChunkAtomRetriever 时,会加载两套向量集合:_chunk_store 存放 Chunk,_atom_store 存放 Atom 文档。后者通过 metadata 中的 source_chunk_id 指向来源块。
在这个实现里,Atom 还包含原子问题一类面向检索的表示,不能一律理解成原文截取出来的一小句。它与 Chunk 的关系是:Atom 提供另一个匹配入口,Chunk 提供来源上下文。两套集合来自各自的数据加载配置。Chunk 的切分与 Atom 的构建属于不同处理步骤,不应合并描述成一次普通切块。
2.6 LightRAG:多类存储共同组成索引
LightRAG 将原文、文本块、实体、关系和文档状态分开管理。主要对象包括:
text_chunks | |
chunks_vdb | |
entities_vdb | |
relationships_vdb | |
chunk_entity_relation_graph | |
full_entitiesfull_relations | |
doc_status |
文档先入队,再经过切分、实体关系抽取、合并和存储等步骤。任务状态用于记录处理进度、失败与恢复;仅有一部分向量写入成功,不等于整份文档已经处理完成。
2.7 索引构建小结
索引产物越多,查询时可用的入口越多,更新时需要维护的派生数据也越多。接下来单独看这一部分。
三、索引冲突与更新机制对比
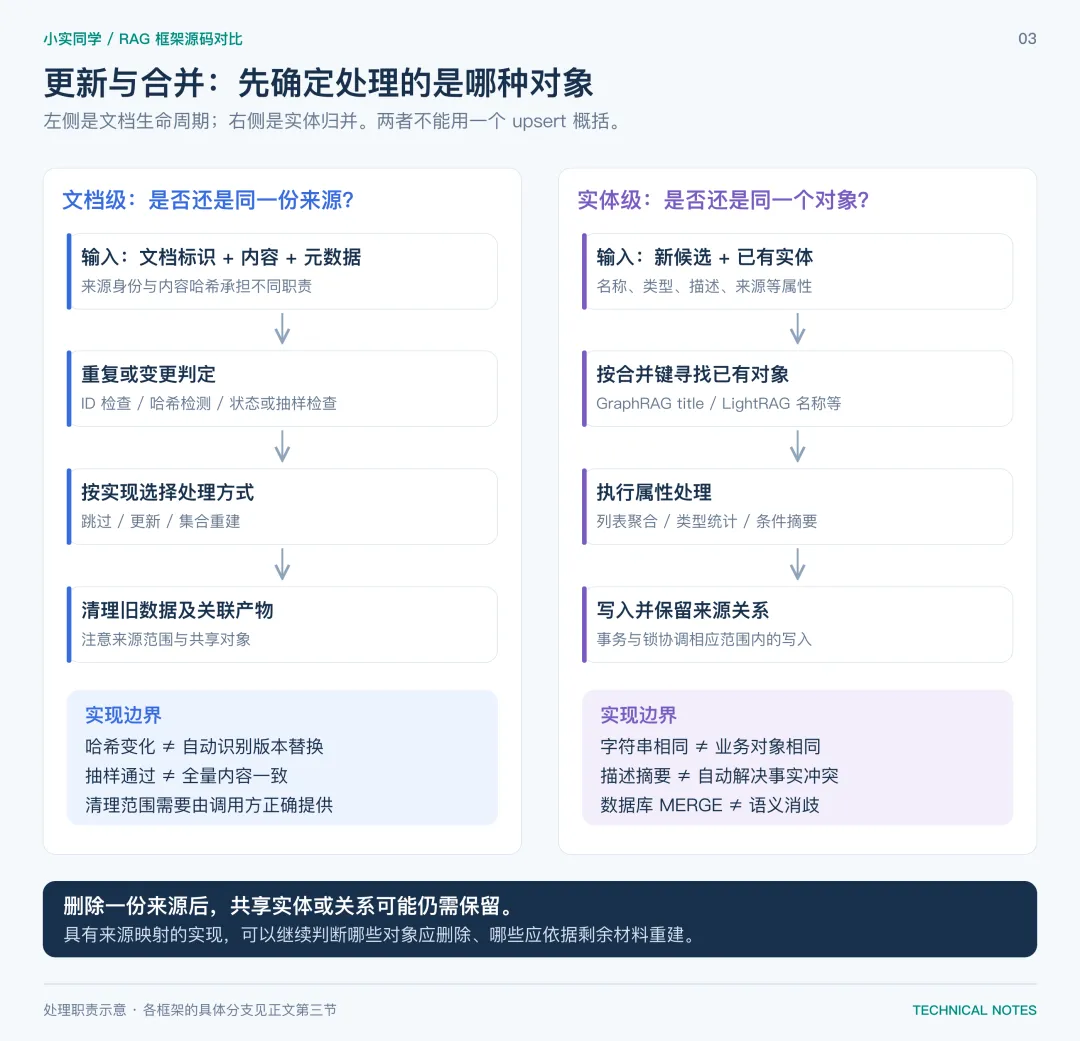
文档去重、实体合并和数据库事务常被一起称为“冲突处理”,但它们处在不同层次:重复写入关心是否出现两份相同数据;更新关心旧数据如何退出;实体消歧关心两个名称是否指向同一对象;事实冲突关心两种说法如何处理。
3.1 dsRAG:已有文档 ID 直接跳过
add_document() 在处理前检查 doc_id 是否已存在于 ChunkDB。存在就记录日志并返回,不会因为传入正文变了便自动更新。
# 流程伪代码
if doc_id in existing_document_ids:
    return
parse_and_index(document)
这个行为能阻止同 ID 的重复导入。但要替换内容,需要由调用方安排删除和重新加入;“跳过重复 ID”与“检测正文变更”是两种不同能力。
3.2 GraphRAG:按 title 对增量实体进行归并
在 _group_and_resolve_entities() 中,新旧实体先按 title 匹配,生成新 ID 到旧 ID 的映射,然后拼接、分组并聚合属性。
这个函数里的规则比较直接:id 和 type 取 first;description 收集为列表;text_unit_ids 展平合并;frequency 根据合并后的文本单元列表长度重算。这段代码能证明的是这个归并步骤采用字符串匹配和属性聚合。它不能证明整个 GraphRAG 管线“从不融合描述”,因为描述摘要还涉及其他处理阶段。同样,title 一致也不是语义消歧的充分条件。关系增量处理还有自己的归并代码,不宜把实体的 title 匹配规则直接套到关系上。
3.3 KAG:存储层按标识 Upsert
以 Neo4j 适配器为例,upsert_node() 使用标签和 id_key 指定的属性匹配节点,执行 MERGE,随后更新属性。关系写入按端点和关系类型等条件处理。
事务与唯一性约束解决的是存储一致性。如果上游把两个不同对象分配了同一个 ID,数据库仍会按这个 ID 合并。是否同名同物、别名如何归一,需要看上游知识构建和实体链接,不能仅凭 MERGE 下结论。
3.4 LangChain:哈希检测与按范围清理
index() 对文档内容及 metadata 生成哈希,再通过 RecordManager 判断是否已经处理。已有记录可跳过或强制更新;旧数据是否删除,由 cleanup 控制。
None | ||
incremental | ||
full | ||
scoped_full |
full 有明确前提:这次输入应当包含完整数据集。如果只传入一个更新文件,其余没有出现的文档就可能被清理。incremental 和 scoped_full 则需要正确提供来源标识;同一来源的数据也应完整提供,避免把仍然有效的块当成旧数据。内容哈希负责判断记录是否相同,source ID 负责确定它属于哪份来源。两者不能互相替代。完全消失、此次没有出现的来源,也不会仅靠一次限定来源的清理自动处理。
3.5 PIKE-RAG:抽样匹配,不匹配则重建集合
load_vector_store() 先检查集合记录数,再通过 _documents_match() 检查内容与元数据。如果不匹配,删除该 collection,重新从传入文档构建。
这里最容易漏看的代码是 np.random.choice(len(docs), 3):它抽取三个索引做检查,且没有设置不放回抽样。也就是说,三个索引可能重复,检查通过不代表每条记录都一致。因此,这条实现适合按给定数据集加载或重建索引,不能称为严格的逐文档变更检测。数据量大、更新频繁时,集合级重建的成本也需要单独评估。
3.6 LightRAG:文档状态、实体合并与删除重建
文档层面,LightRAG 使用文档标识和状态记录参与去重、处理与恢复。默认内容哈希有助于识别相同文本;如果文本改了产生新哈希,并不天然表示“用新版替换旧版”,业务来源和替换关系仍需明确。
实体层面,合并路径按实体名称组织候选,读取已有节点,再处理类型、描述和来源。类型选择使用频次统计;描述去重后,根据数量和 Token 等条件决定直接组合还是调用模型摘要,不能写成每次合并都调用 LLM。
并发处理使用 keyed lock。当前共享锁实现涉及 asyncio 和 multiprocessing,应描述为相应运行范围内的异步/多进程协调,不能直接等同于跨机器分布式锁。
删除文档还会牵涉图中的共享实体与关系:完全失去来源的对象与仍有其他来源的对象需要区别处理;后者可能需要依据剩余材料重建描述。当前文档删除入口为 adelete_by_doc_id()。
图3:文档变更与实体归并的处理边界
四、检索实现对比
这一节把边界划在上下文输出:查询怎样进入系统,候选从哪里来,经过哪些处理,最终交给生成模块什么内容。
图4:六种框架的检索链路
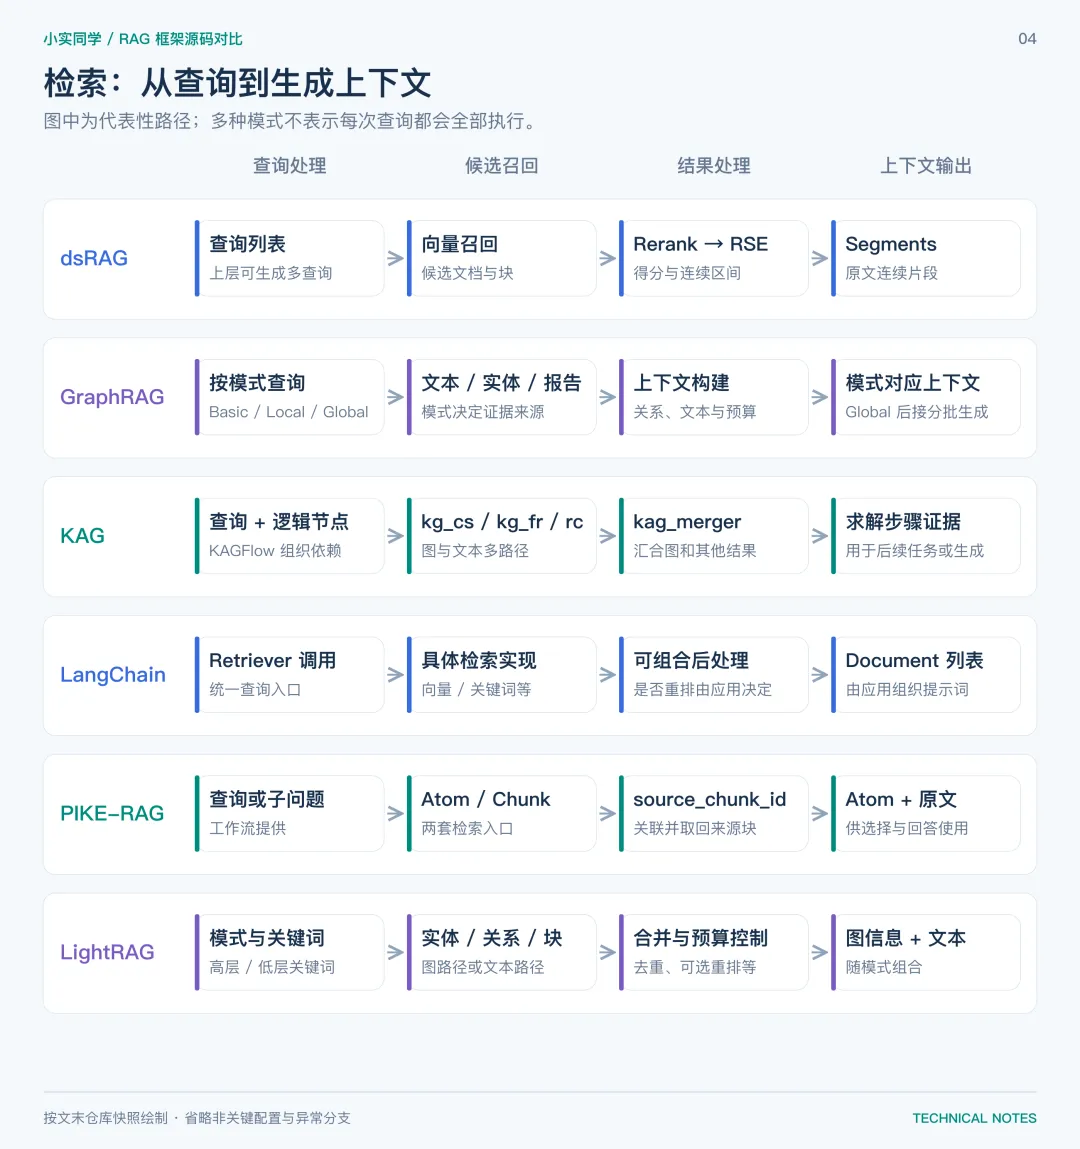
KnowledgeBase.query() 接收 search_queries 列表,多查询生成位于上层聊天流程,不是每次调用检索接口都会自动发生。
检索过程结合向量召回与 reranker,再把各块的相关性用于 RSE。get_best_segments() 在文档边界、单段长度、总长度和最低得分等约束下选择连续块区间,已经选择的区间不会重复入选。
# 流程伪代码
candidates = retrieve_for_queries(search_queries)
scores = rerank(candidates)
segments = select_contiguous_ranges(
    scores, document_boundaries, segment_limit, total_limit
)
return load_original_text(segments)
最终返回的是包含起止块位置的 segment,而不只是彼此独立的 Top-K Chunk。需要注意,RSE 参数中的长度约束以块数表达,不能直接当成 Token 预算。
4.2 GraphRAG:不同模式使用不同层次的索引
Basic Search 主要利用文本检索。Local Search 从查询相关实体出发,组织实体、关系、文本单元等信息;Global Search 使用社区报告构建较大范围的上下文,再进入 Map-Reduce。当前官方还提供 DRIFT;本文重点比较 Basic、Local 和 Global 这三种路径。
Local 的实体选择包含向量映射,并非必须先用一次 LLM 显式抽出查询实体。后续如何分配文本单元、社区和关系的上下文预算,由配置控制。
Global 与 Local 的差别首先是证据组织层次不同,不能仅理解为同一检索器的不同 Top-K。
4.3 KAG:逻辑节点与多路径检索
KAG 的 KAGFlow 解析流程字符串,建立组件之间的依赖,再针对逻辑节点执行。下面的流程字符串表示三条路径汇合到一个组件:
kg_cs,kg_fr,rc -> kag_merger
kg_cs、kg_fr 和 rc 分别对应较精确的图检索、模糊图检索和文本向量召回路径,结果交给 merger。代码会按依赖安排可执行节点,并合并图数据与其他检索结果。Merger 是结果汇合组件,不能在对比表里直接等同于 reranker。是否执行重排,还要看具体组件及生成阶段。
4.4 LangChain:统一检索器接口
BaseRetriever 把检索抽象为查询到 Document 列表的调用,具体实现通过 _get_relevant_documents() 等方法提供结果。
向量检索、关键词检索、集成检索和重排可以在应用中组合。LangChain 本身不规定六个步骤必须怎样排列,也没有一个统一的“默认最优检索算法”。评价时应把实际使用的组件组合列出来。
4.5 PIKE-RAG:通过 Atom 命中,再取回来源块
ChunkAtomRetriever 提供从 Atom 检索、从 Chunk 检索,以及组合获取内容等接口。从 Atom 检索时,先查 _atom_store,再收集结果的 source_chunk_id,到 _chunk_store 获取原文。
返回的 AtomRetrievalInfo 同时携带查询、Atom、来源标题、来源内容、来源 ID 和得分。这样,问答工作流可以用细粒度表示匹配子问题,同时保留较完整的原始证据。它并不只是把 chunk size 调小,而是增加了一层检索表示和明确的回源关系。
4.6 LightRAG:实体、关系和文本块的组合检索
LightRAG 的查询模式决定走哪条分支:
local | |
global | |
hybrid | |
mix | |
naive | |
bypass |
图路径会组织实体、关系和关联文本,随后进行合并、去重、预算控制等处理。这里的 global 围绕关系检索展开,不是 GraphRAG 的社区报告 Map-Reduce;名称相同,执行过程不同。
4.7 检索小结
五、问答实现对比
检索结果并不总是直接拼成提示词。部分框架只进行一次最终生成,部分会分批生成再合并,还有一些会根据中间结果继续检索。
图5:问答执行方式对比
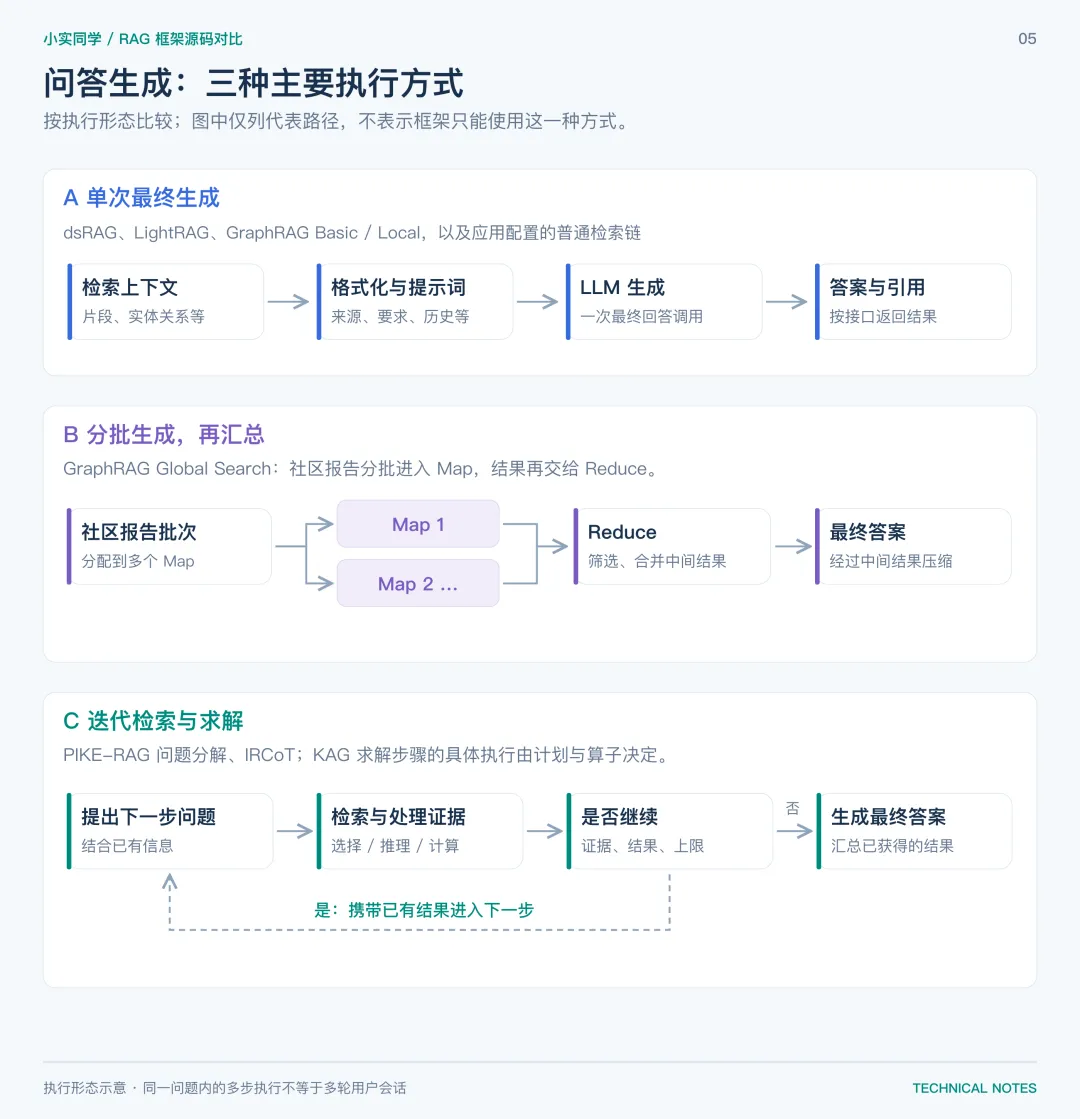
dsRAG 的聊天模块准备历史和知识库信息,生成搜索查询,调用知识库检索,再把来源片段组织到回答上下文中。回答使用 ResponseWithCitations 这样的结构化模型,并有流式与非流式处理路径。
这意味着查询生成与最终回答是不同环节,结构化引用则属于回答协议。协议可以约束输出字段,但引用是否真正支持对应结论,仍需要核查原文。
5.2 GraphRAG:单次生成与 Map-Reduce
Basic、Local 路径根据各自构建的上下文生成答案。Global Search 则先处理多个社区报告批次,在 Map 阶段产生中间回答及得分,再在 Reduce 阶段筛选、组织并生成最终答案。
并行 Map 能分摊长上下文的处理,但会产生多次模型调用。最终答案也经过了中间回答这一层压缩,所以排查遗漏时,需要同时查看报告、Map 输出与 Reduce 输入。
5.3 KAG:汇总求解步骤后生成
LLMGenerator.invoke() 遍历任务上下文,收集步骤结果、检索文本和查询信息;调用 chunk_reranker 后构造参考数据,再组织最终生成输入。默认可创建 RerankByVector,不能把它直接描述成与交叉编码器相同的重排方式。
是否启用引用提示词受 enable_ref 等配置影响。生成模块消费的是前面求解步骤的结果,因此答案质量同时依赖任务分解、检索和结果汇总,不能只看最后一个 prompt。
5.4 LangChain:问答流程由应用组合
LangChain 的检索器返回 Document,应用继续负责上下文格式化、提示词、模型调用及输出解析。可以组成一次检索后生成,也可以让更上层的工作流决定是否继续检索。
RetrievalQA、ConversationalRetrievalChain 属于经典链实现,在当前仓库中应按 langchain_classic 的代码位置理解,不能与新入口不加区分地并列。
多轮会话、结构化输出和引用处理也需要看具体组合,不能从“采用 LangChain”直接推断已具备这些行为。
5.5 PIKE-RAG:问题分解与迭代检索
QaDecompositionWorkflow 的核心循环是 proposal、retrieval、selection:先提出子问题,再检索候选 Atom,最后选择有用信息加入已知上下文。停止条件包括不再分解、没有候选、没有选中信息,以及达到配置的数量上限。循环结束后,才回答原始问题。
# 流程伪代码
while selected_count < limit:
    proposals = propose_subquestions(question, evidence)
    if not proposals:
        break
    candidates = retrieve_atoms(proposals)
    chosen = select_candidate(candidates, evidence)
    if chosen is None:
        break
    evidence.append(chosen)
answer_original_question(question, evidence)
QaIRCoTWorkflow 则交替检索与生成中间推理文本,利用上一步输出推进下一轮检索,或在得到答案时结束。
这里的多轮是一个问题内部的多步执行,不等同于保存用户历史的多轮聊天。官方 PIKE-RAG 仓库目前已归档,采用时还需要考虑维护安排。
5.6 LightRAG:检索数据与生成答案分开暴露
LightRAG 提供 aquery_data() 获取检索结果,aquery_llm() 执行检索与答案生成,aquery() 则承担兼容包装。图路径、文本路径和 bypass 路径按参数选择。
返回对象可以同时包含实体、关系、文本块、引用等检索数据,以及回答内容或流式迭代器。这种接口分工便于应用单独检查检索结果,也允许在生成前增加自己的处理。
5.7 问答方式小结
六、总结与选型建议
把五个环节放回一起,几个项目的主要差别可以收束到下面这张表。
如果主要需求是文档内问答,可以先比较普通 Chunk 检索与 dsRAG 的上下文、segment 方案,观察完整条件是否进入回答上下文。如果需要跨文档归纳,GraphRAG 的社区报告值得单独验证;如果主要围绕实体和关联查证据,可以验证 LightRAG 的图文组合。两者不应仅凭“都有图谱”互相替换。如果问题需要分步求解,KAG 的逻辑形式和算子组织、PIKE-RAG 的知识感知分解,提供了不同实现参考。组件需要自由组合时,LangChain 可以承担接口和编排工作,但仍要明确实际使用的检索与更新方案。这些判断来自实现结构,效果需要用同一批问题验证。测试除了答案,还应保留预期证据、实际召回、最终上下文和引用;同时记录建库成本、查询延迟以及一次更新影响了哪些数据。源码对比能说明一个框架做了什么、代价花在哪里。至于值不值得用,最终要看它是否改善了自己数据上的具体问题,以及这部分改善是否值得后续的维护成本。
附录:版本与源码位置
本次核对时间为 2026 年 9 月 28 日。以下 commit 是本次读取的仓库快照,不是六个项目的兼容版本组合。不同包的版本号不直接用仓库提交时间替代。
dsRAG
dsrag/dsparse/sectioning_and_chunking/chunking.py
dsrag/knowledge_base.py
dsrag/rse.py
dsrag/chat/chat.py
dsrag/auto_context.py
graphrag
packages/graphrag-chunking/graphrag_chunking/token_chunker.py
packages/graphrag-chunking/graphrag_chunking/sentence_chunker.py
packages/graphrag/graphrag/index/update/entities.py
packages/graphrag/graphrag/index/update/relationships.py
packages/graphrag/graphrag/query/structured_search/local_search/mixed_context.py
packages/graphrag/graphrag/query/structured_search/global_search/search.py
KAG
kag/builder/component/splitter/semantic_splitter.py
kag/builder/component/splitter/outline_splitter.py
kag/indexer/kag_index.py
kag/common/graphstore/neo4j_graph_store.py
kag/solver/executor/retriever/local_knowledge_base/kag_retriever/kag_flow.py
kag/solver/generator/llm_generator.py
kag/builder/component/splitter/length_splitter.py
kag/builder/component/splitter/pattern_splitter.py
langchain
libs/core/langchain_core/indexing/api.py
libs/text-splitters/langchain_text_splitters/character.py
libs/core/langchain_core/retrievers.py
libs/langchain/langchain_classic/chains
PIKE-RAG
pikerag/document_transformers/splitter/llm_powered_recursive_splitter.py
pikerag/knowledge_retrievers/mixins/chroma_mixin.py
pikerag/knowledge_retrievers/chunk_atom_retriever.py
pikerag/workflows/qa_decompose.py
pikerag/workflows/qa_ircot.py
LightRAG
lightrag/lightrag.py
lightrag/operate.py
lightrag/chunker/token_size.py
lightrag/kg/shared_storage.py
lightrag/chunker