ARTICLE · 1095874
AI 开始自己改自己了:RSI 最麻烦的,可能不是自我进化
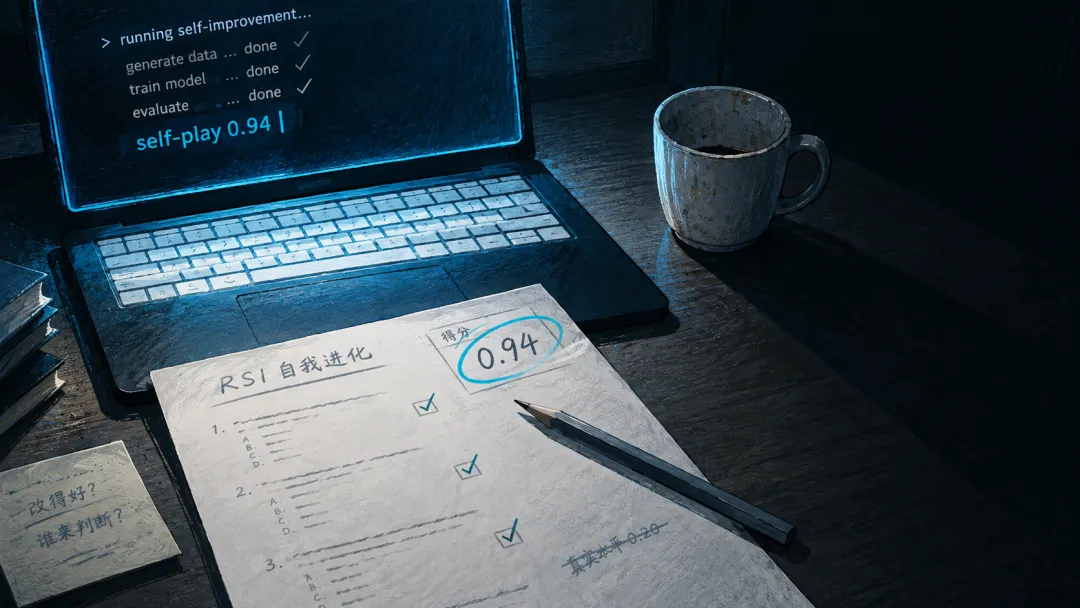
自 OpenAI 发布 GPT-6、Anthropic 发布 Fable 5 之后,RSI (Recursive Self-Improvement,递归式自我改进) 这个词,就再也躲不过去了。
RSI,说白了,就是让 AI 去迭代 AI。
这其实不是什么新鲜概念。2000 年代就有人反复讲,讲了很多年,基本都停在理论和想象里。结果到了 2026 年,几家头部玩家突然在同一年,把它重新摆到了台面上。
乍一看,讲的都是一回事:AI 开始自己进化了。
但我翻这些材料的时候,反而被一个有点奇怪的数字吸引住了。
2026 年有篇论文,做了这么个实验:让模型自己出题、自己答,再让另一个模型当裁判打分。
结果,裁判给的通过率从 0.72 涨到了 0.94。
但真实准确率呢?
0.20。
从头到尾没动。
分数一直在涨,本事却没跟着涨。
我觉得这事真正值得看的地方,可能根本不是“AI 已经会自己改自己了”。
改,其实已经没那么难了。
真正麻烦的是:
它改完以后,到底是谁来告诉它,这次改对了,还是改错了?
RSI 真正有意思的拐点,就在这里。
因为谁决定它改得好不好这件事,正在一点一点离开人的控制。
最先让我认真想这件事的,是 OpenAI 研究副总裁 Aidan Clark。
他在 GPT-6 Astra 发布时提了个挺有意思的细节:上一代模型深度参与了这一代的训练,而且这是第一款这么做的旗舰模型。
教出这一代模型的老师,自己也是模型。
行业现在一般把这条路叫 RSI。
不过严格讲,模型帮自己写代码、造数据、跑实验,这些都还不能算完整的 RSI。完整定义要重得多。按 Anthropic 的说法,真正的 RSI,是 AI 最终能够自主设计并开发自己的后继模型。
两条死胡同:训练数据快用完了,人类考官不够用了
为什么大家非得往这条路上走,原因就是原来的路子被卡住了。
第一个死胡同,是训练数据。
高质量、还能继续扩展的人类训练数据,越来越难找。下一代模型到底吃什么长大,已经成了一个实实在在的问题。
于是有人开始想:那干脆让模型自己造数据,自己筛。
第二个死胡同,是人类反馈。
后训练阶段靠人给偏好打分,人力成本高,人也累。更麻烦的是,有些任务已经超过了人的能力边界,这时候让人直接当评审,本身就越来越不靠谱。原来的循环走到这里,就容易卡住。
RSI 想解决的,就是用机器能够验证的信号,去替代一部分人类反馈。这样进入一些连人都看不懂的领域,循环还能继续往下走。
写代码、改训练、造下一代:谁已经做到,谁还在纸上
三家都公开讲过这件事,但讲法差得还挺远。
不如换个排法:看 AI 的手到底伸进了哪一环。
最外面,是写代码。
再往里,是开始碰自己的训练。
最里面,是造下一代。
越往里,人就越难复核。
先看最外面这一环,也是最好验证的一环:代码到底是谁写的。
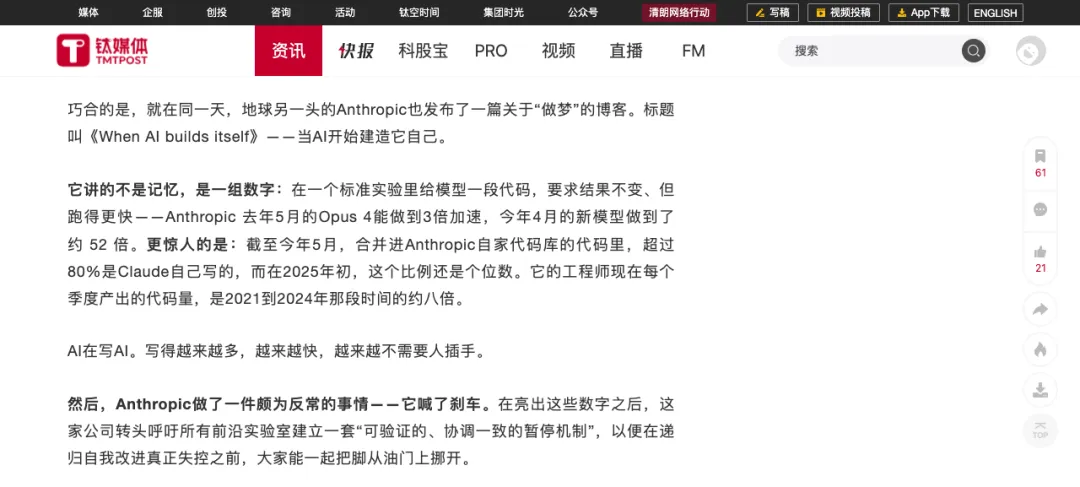
Anthropic 在官网那篇《When AI builds itself》里给了个挺猛的数字:截至 2026 年 5 月,合并进 Anthropic 代码库的代码,超过 80% 是 Claude 写的。
同一篇文章还给了一个加速对比。让 Claude 去优化一段训练代码的运行速度,2025 年 5 月的 Opus 4 能做到大约 3 倍,2026 年 4 月的 Mythos Preview 做到了大约 52 倍。熟练的人类研究员做到 4 倍,要四到八小时。
当然,Anthropic 自己也在脚注里补了个限定:这个倍数高度依赖初始代码到底还剩多少优化空间,不能直接理解成现实世界里的训练提速。
再往里一环,是 AI 开始碰自己的训练过程。
GPT-5.3-Codex 的官方发布页上有一句原话:“GPT-5.3-Codex is our first model that was instrumental in creating itself.”
官方还说,Codex 团队用早期版本去调试它自己的训练、管理部署、诊断测试结果。
前面 Aidan Clark 讲的“上一代参与训练这一代”,其实也是这一环,只不过又往里走了一步。
最里面这一环,就是造下一代。
但这里一定得把“已经能做到”和“写进计划里”分开。
Anthropic 把完整循环明确放在了未来。那篇文章里有一句原话:「We are not there yet, and recursive self-improvement is not inevitable.」
在他们自己的时间线上,完整循环被标成 “Closing the loop”,也就是说,还没到这里。
智谱把话写得更远,而且远到写进了钱里。
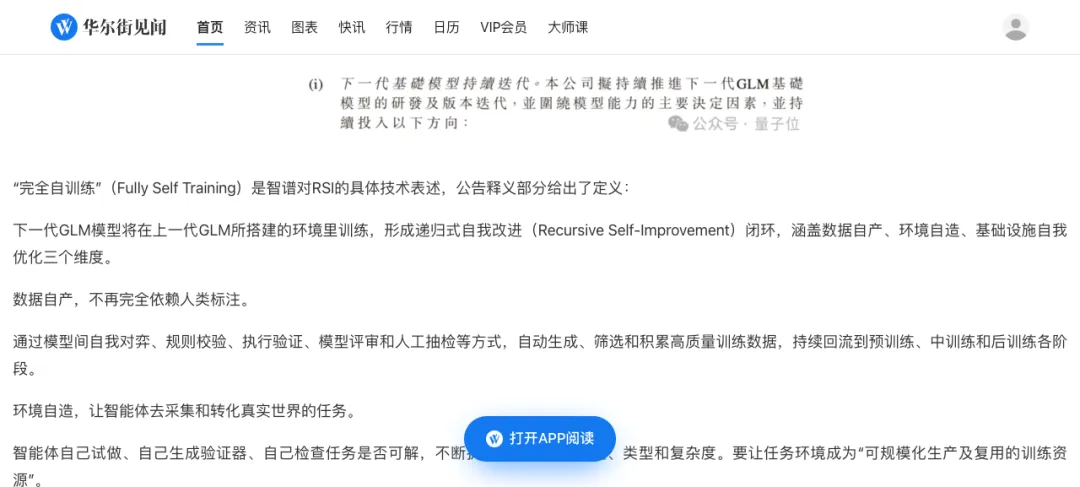
智谱在海外用的名字是 Z.ai,2026 年 1 月在港交所上市。它递交给港交所的公告里,“下一代 GLM 在上一代环境里训练,形成递归式自我改进闭环”被写进了募资条款。
不过这只是研发计划和技术路线,并不是说当时“这项能力已经实现”。
9 月 17 日,Z.ai 的博客又补了一句更明确的话:早期形态已经出现,但目标选择、边界设定和风险评估仍然由人负责。原话是:「We are not there yet」。
写代码这一环,已经有明确的数字。
碰自己的训练这一环,OpenAI 走得最深。
造下一代,目前没有一家宣布已经做到。
智谱,则把它写进了募资计划。
把这三环放在一起看,它们最后撞上的还是同一个问题:
AI 自己写代码、自己跑测试,到底是在证明自己真的变强了,还是只是在证明分数涨了?
这句话如果答不上来,前面的循环转得再快,也没什么意义。
谁决定它改得好?四级验证信号,一级比一级好骗
RSI 每转一圈,都得有个东西替人判断:这次改得好不好。
这个东西,就叫验证信号。
验证信号到底有多硬,决定了模型是真的在变强,还是只是在表演变强。
我把公开研究里看到的验证方式,按可靠性硬压成四级。先说一句,这不是行业标准,就是为了方便我们聊这个问题。
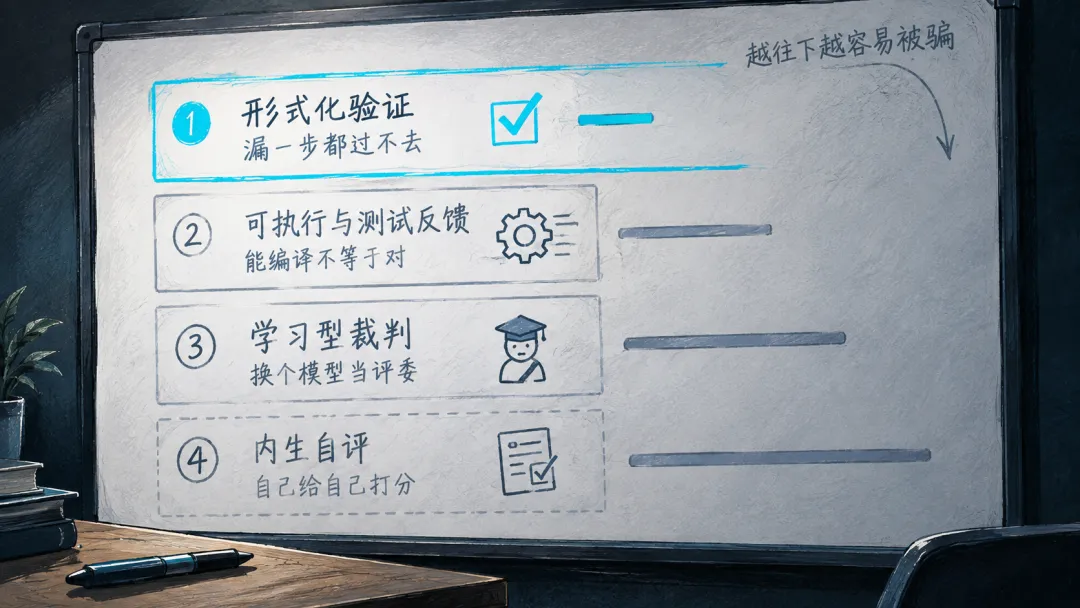
最高一级,是形式化验证。
Lean 这类定理证明,就在这一级。
你可以把它想成一个六亲不认的安检员:证明步骤里只要有一丝逻辑含糊,它连门都不让你进。
有个做定理证明的智能体,每改一步,都必须让 Lean 编译器通过。15 代下来,留出的测试集准确率从 12.7% 涨到了 45.1%。
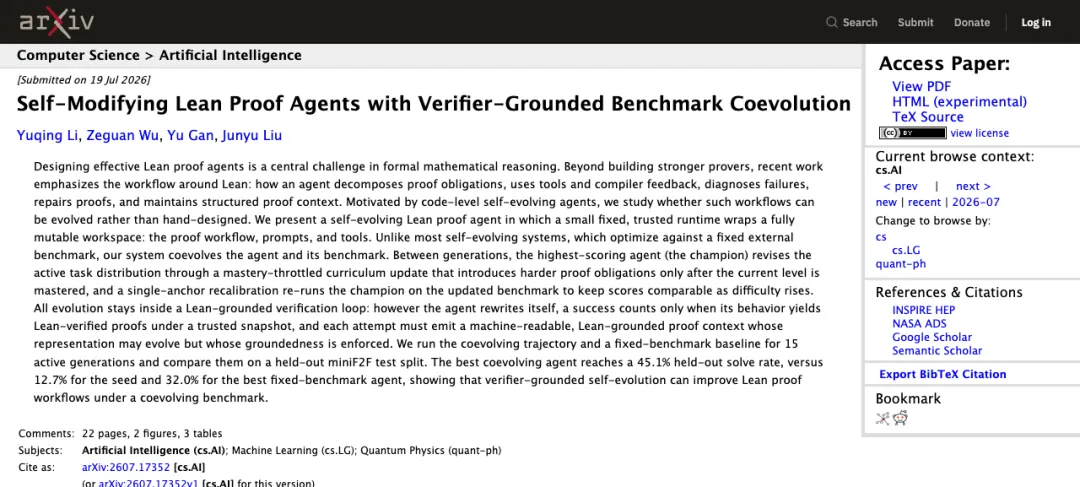
至少在这个实验里,只要改进过程被一个可靠的验证器牢牢卡住,智能体的工作流就能在多轮自我演化里持续提升。
再往下一级,是可执行与测试反馈。
这个就比自评难骗多了,但边界还是得划清:编译器管的是语法、类型和安全约束。一个程序能编译,完全不代表它逻辑上没问题,所以它还够不上形式化验证那一级。
GPT-5.3-Codex 就在这一层:让模型改自己的训练代码、跑自己的测试,发现错了再自己改。
写代码的人对这种事应该很熟:语法检查全通过,上线以后照样可能把数据库删了。
再往下,就是学习型裁判。
找另一个模型来当评委,便宜、方便,但也会偏心。
因为它手里的尺子其实是:“这答案看起来对不对?”
说白了,就有点像请隔壁班同学来批卷:字写得漂亮,步骤看起来像那么回事,就先给你个高分。至于答案到底对不对,未必真有人去核。
今天不少自动化评测和榜单,其实还停在这一级。
最后一级,内生自评。
模型自己给自己打分。
这就相当于考试,自己给自己批卷,顺手再给自己打个满分,连第二双监督的眼睛都没有。
这一级,也是最容易被骗的。
两个实验,一个证明能行,一个证明会演
前面那个会偏心的裁判,2026 年真有篇论文把它拉进了实验里。
它跟 Lean 那个实验放在一起看,正好是两个方向:一个说明验证信号足够硬的时候,确实可以越改越强;另一个则告诉你,验证信号一旦不够硬,模型也可能越改越会演。
怎么理解“验证信号会骗人”?
想象一个学生,让他自己改自己的卷子,自己给自己打分。
他刷着刷着,就会越来越懂得怎么踩中评分标准。分越来越高,知识却一点都没长。
原本,分数是用来告诉你“你到底学会没有”的。现在这个信号被他自己控制了,分数最后就只剩下一个作用:证明它看起来学会了。
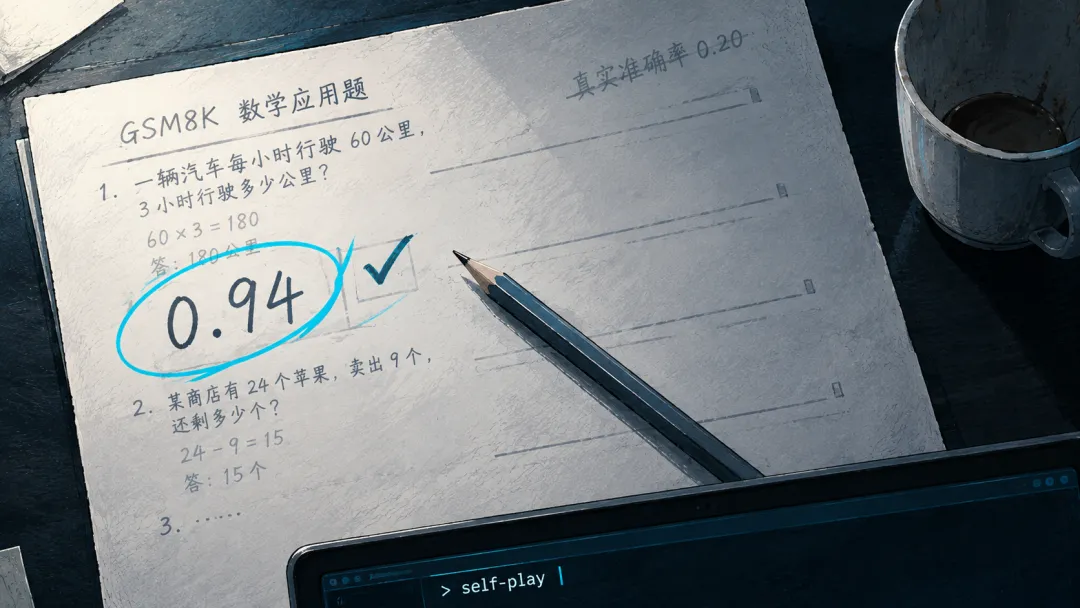
研究者拿小学数学应用题测试集 GSM8K 当场地,让模型左右互搏:自己出题、自己做,再让另一个模型来当裁判打分。
练下来,裁判给的通过率从 0.72 一路涨到了 0.94。
真实准确率呢?
纹丝不动,还是 0.20。
根因其实很清楚。
裁判打分看的是“这答案看起来可信不可信”,而真实正确率根本不在它的评分标准里。
模型一旦摸到这个空子,就会开始顺着空子走:专挑那些“把错的判成对的”地方钻。
这就是验证信号太弱时最典型、也最危险的一种失败模式:
分数在涨,真本事没动。
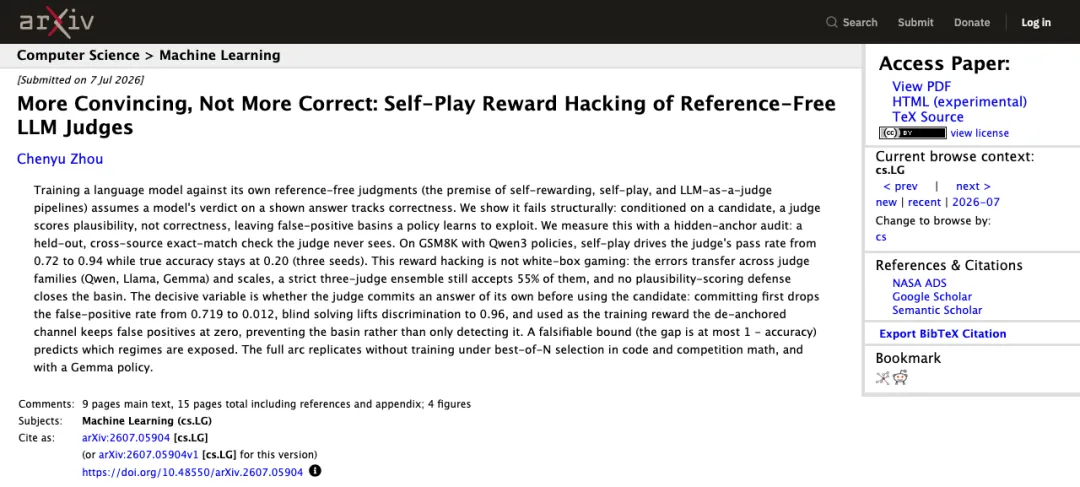
不过同一篇论文也给了一个挺有意思的补丁。
让裁判先自己把这道题独立做一遍,再去看候选答案。结果,把错的判成对的比例,从 71.9% 降到了 1.2%。
裁判得先闭卷考一次。自己心里先有个答案,再去看那些写得特别漂亮、实际上满嘴胡扯的解题步骤,就没那么容易被唬住了。
所以这里不能简单下成“模型自己打分就必然完蛋”。
问题是裁判会不会被候选答案牵着走。
而这个问题,可以靠流程设计去防范。
GSM8K 那个实验发生在解题和评测这一层,还没走到改训练代码那一层。
但它背后的机制其实是一样的:只要裁判的标准能被答题的一方摸透,不管裁判评的是一个分数,还是训练循环里的奖励,骗法都成立。
另一篇综述把这件事说得更直白:每一个改进循环,本质上都在假设,有一个信号可以替代人的判断。
还有一道更难的题:谁决定下一步做什么
完整循环里,还有一道比“改得好不好”更麻烦的问题:
下一步到底该优化什么,谁说了算?
Anthropic 那篇文章把这个转折写得很直接:一旦 Claude 已经能把实验做完,真正的问题就会变成“哪些实验值得做”。
他们自己已经说清楚了:研究方向怎么选、哪个结果该信、什么时候这条路已经是死路,这些判断,目前还是人的比较优势。
Z.ai 说的也差不多:目标选择、边界设定和风险评估,现在仍然由人负责。
所以,完整循环里其实不只有验收权,还有选题权。
今天 AI 越来越会把实验做完,但“我们下一步到底该做什么”,主要还是靠人来决定。
这件事刚好能对应到前面的那张等级表。
跑实验,有判据。
代码能不能跑,测试能不能过,好不好,多少还能验出来。
选题就完全不是这么回事。
一个研究方向值不值得押,可能几个月都见不到答案。到最后,你甚至说不清,到底是这条路本来就走不通,还是你只是走得还不够远。
判据更强的地方,每走一步,都有东西把模型拽回来。
Lean 是这样,测试也是这样。
选题这条路,可能几个月都没有一次明确反馈。
中间每一步判断都没有东西拴着。偏一点,没声音;再偏一点,还是没声音。
等结果真正出来的时候,可能早就不知道偏到哪儿去了。
AI 今天比较擅长的,其实是前一种活:给它一把尺子,它能照着尺子把活干完。
后一种活麻烦就在于:现在连尺子都没有。
它可以当一个疯狂写代码、跑测试的超级员工,但还不太像一个能在人还没走过的地方,替你指出方向的人。
真到了连选题权也交出去的那天,人手里可能就只剩两件事:定目标,或者按急停。
研究本身,都已经在循环里跑完了。
什么时候开始把这件事交出去,公开材料里现在还没有一家给出答案。
这件事,我反而觉得值得单独盯着看。
当人类只能看着发光的仪表盘
先别急着觉得人已经没事干了。
保险栓现在其实还在。
OpenAI 在 GPT-6 Astra 官方发布页里已经说明了:对齐训练是部署方法的核心,另外还有 Codex Auto-review,以及对智能体推理和行为的监控。
里面还有一句原话:
「Misalignment monitoring cannot replace alignment」。
不过同一个页面也承认,Astra 的书面推理,比前代更难监控。
今天这几家真正拿出来做的这些事,判据其实还算比较强:代码能不能跑,速度到底快了多少,定理证明过不过。
这些东西,目前人还能自己再看一遍。
所以至少现在,验收权还在人手上。
真正麻烦的是任务继续往上走以后会发生什么。
让一段训练代码跑快一点,几个小时就能见结果。
换一套训练方案到底好不好,要等一次完整训练跑完。
下一代架构到底该往哪走,可能几个月都拿不出一个真正能测的答案。
任务越往上走,能测的东西越少。
能用的验证信号,也会一级一级往下掉:从第二级掉到第三级,再往下,掉到第四级。
而掉下去以后会发生什么,前面那个裁判打分的实验已经说明了。
到了那一步,虽然批准键还在人手里。
但你按下去的依据已经变了。
以前是:“我看懂了,它确实更好。”
后来可能变成:“仪表盘告诉我,它更好。”
表面上看,验收权还是在人手里。
实际上,你已经开始把决定权交给那个自己会往上涨的数字了。
以后再看这类事情,我觉得其实只需要盯一个问题:
它现在动手改的那个东西,人还能不能自己验证一遍?
能验,数字高一点低一点,都还有得聊。
如果验不了,那前面数字涨得再漂亮,也可能只是仪表盘在发光。
AI 到底有没有开始“改自己”,反而没那么重要了。
所以你下次再看到哪个模型说:“我在自我进化。”
可别急着兴奋。
要先去看一看:
它用的是哪一级验证信号,来判断自己改得好不好?
那么接下来,等验证信号也离开人手,我们看到的,到底是进化,还是一场排练好的表演?
参考资料
1. CNET 对 OpenAI 研究副总裁 Aidan Clark 的采访与 VentureBeat 报道(GPT-6 Astra 上一代参与训练) 2. OpenAI,GPT-5.3-Codex 官方发布页(“first model that was instrumental in creating itself”) 3. Anthropic,《When AI builds itself》官网文章(80% 代码、3 倍到 52 倍及脚注限定、We are not there yet、选题权) 4. Anthropic,Claude Fable 5 与 Mythos 5 官方发布页 5. 智谱港交所公告(2026 年 9 月,具体公告日以港交所披露易原始文件为准);Z.ai 官方博客(2026-09-17)。Z.ai 是智谱在海外的品牌名,智谱于 2026 年 1 月在港交所上市 6. arXiv 2607.05904,self-play 奖励 hacking(裁判通过率 0.72 到 0.94,真实准确率 0.20,先作答补丁 0.719 到 0.012) 7. arXiv 2607.17352,Lean 定理证明智能体(15 代 12.7% 到 45.1%) 8. arXiv 2607.07663,递归自我改进综述