ARTICLE · 1102180
25GB 内存笔记本电脑跑通 744B 大模型:SSD 当显存,GitHub 超 3.8 万星

点击上方蓝字关注我们
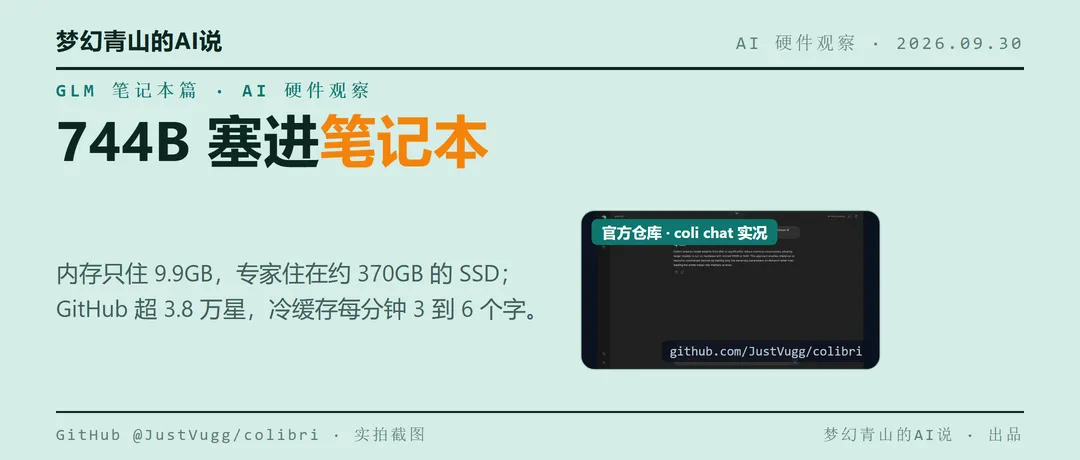
这不是概念演示,是一个能 clone 下来的开源项目:Colibrì,意大利语的「蜂鸟」。纯 C 写的推理框架,单个源文件,零引擎依赖。2026 年 7 月 1 日建库,9 月底 star 数已超 3.8 万,作者 JustVugg 是个人开发者,不是哪家公司的团队。
大模型时代的门槛,正在搬家:从「显存多大」搬到「硬盘多大、你愿意等多久」。744B 装进笔记本,靠的不是黑科技,是一笔 MoE 的算术账。
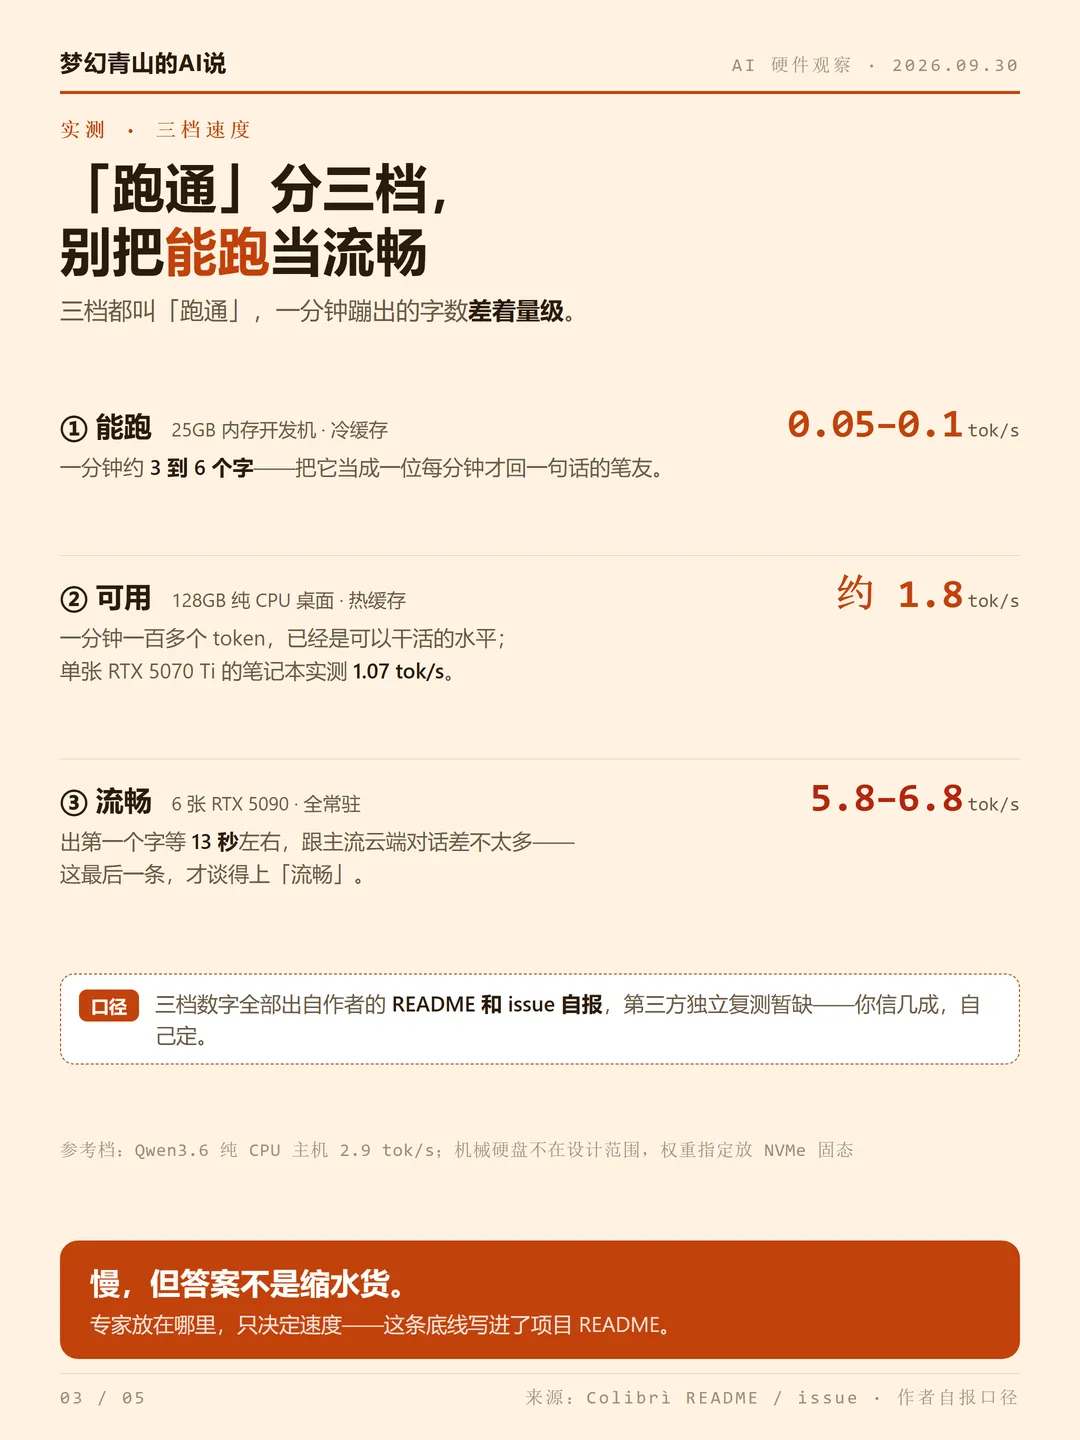
丑话也要说在前头。这台开发机的实测是冷缓存每秒 0.05 到 0.1 个 token,换算一下,一分钟蹦出 3 到 6 个字。能跑,但你要把它当成一位每分钟才回一句话的笔友。
往上堆配置,速度也往上走:128GB 内存的纯 CPU 桌面,热缓存约 1.8 tok/s;插一张 RTX 5070 Ti 的笔记本 1.07 tok/s;6 张 RTX 5090 全常驻,5.8 到 6.8 tok/s,出第一个字等 13 秒左右。这最后一条,才谈得上「流畅」。
「跑通」是什么意思:三档速度,一条底线
「跑通」这个词,得拆成三档来说。
第一档,能跑。25GB 内存的开发机,冷缓存 0.05 到 0.1 tok/s,这是项目的起点数据。换个轻量些的模型,Qwen3.6 在纯 CPU 主机上能到 2.9 tok/s。
第二档,能用。一份 128GB 内存的纯 CPU 桌面实测,热缓存约 1.8 tok/s,一分钟一百多个 token。读个长答案得有点耐心,但已经是可以干活的水平。
第三档,能用爽。6 张 RTX 5090 全常驻内存,5.8 到 6.8 tok/s,跟主流云端对话差不太多。代价是那张桌子,大多数人坐不上。
一条底线写在项目的 README 里:专家放在哪里,只决定速度,不改模型行为。住在硬盘里的专家不会被少算,路由不改,精度不降。慢,但答案不是缩水货。
边界也得划清:上面所有速度数字,全部出自项目作者自报的 README 和 issue,第三方独立复测暂缺。你信几成,自己定。
装得下的算术:每个字只点名 40B
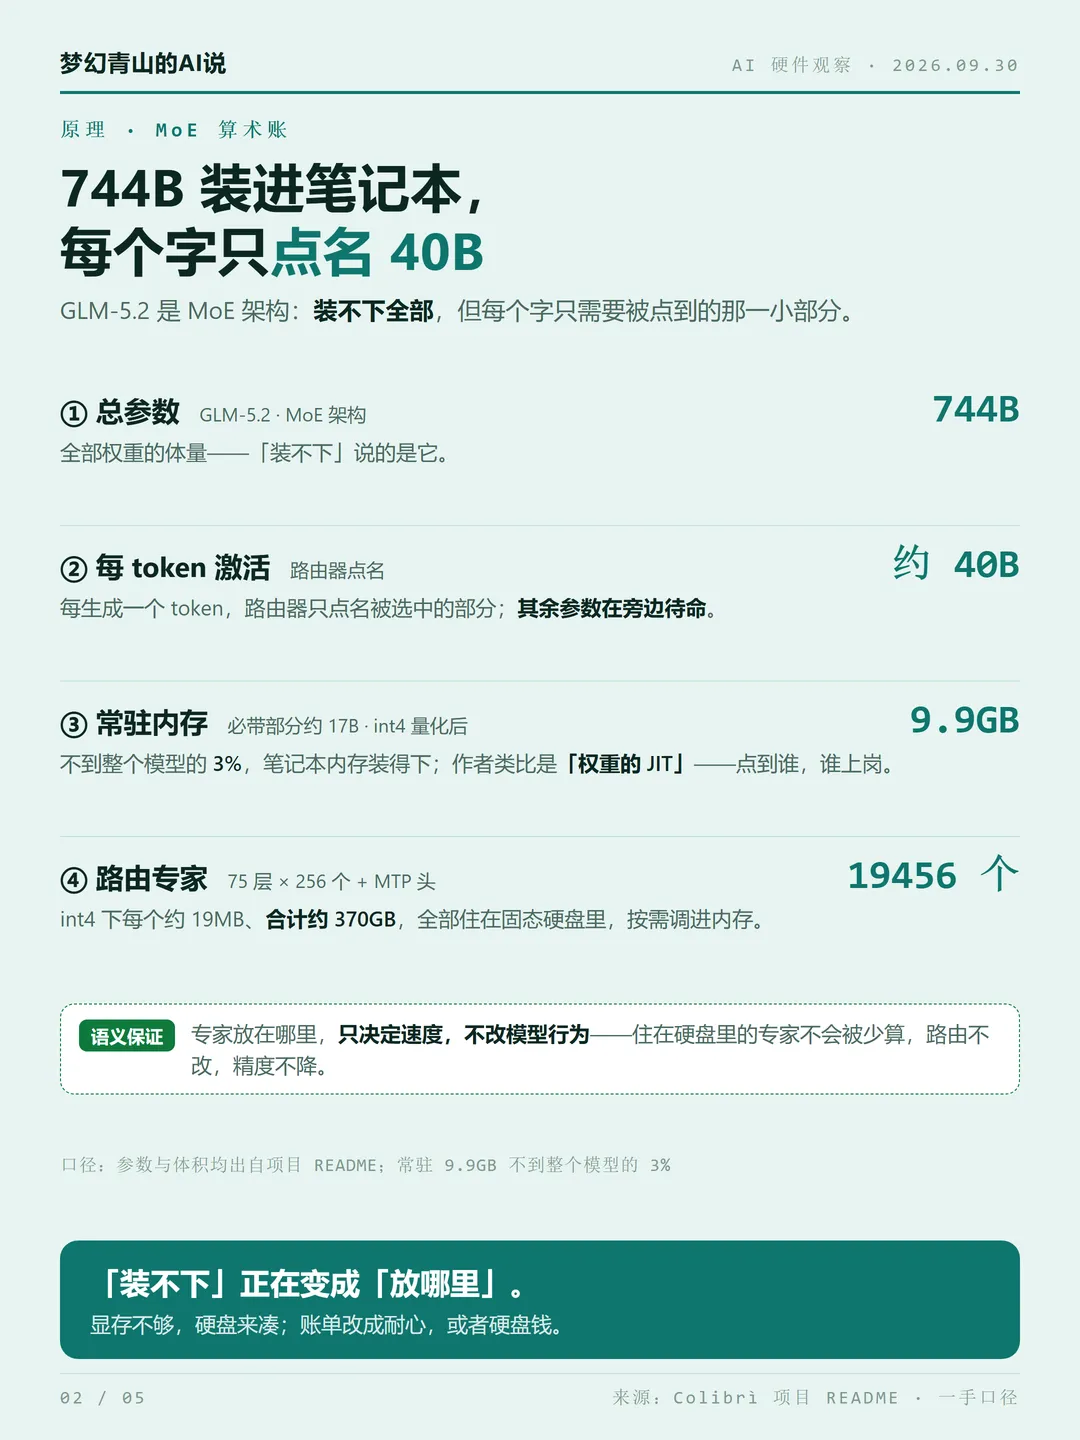
为什么 744B 能塞进一台推荐内存只有 24GB 的机器?
GLM-5.2 是 MoE 架构,总参数 744B,每生成一个 token,路由器只点名约 40B 参与计算,其余参数在旁边待命。账就这么算的:装不下全部,但每个字只需要被点到的那一小部分。
拆开账本:attention、共享专家、embedding 这些必带的部分约 17B,int4 量化后 9.9GB,常驻内存。路由专家有 19456 个,分布在 75 层、每层 256 个,外加 MTP 头,int4 下每个约 19MB,合计约 370GB,全部住在固态硬盘里。
常驻内存的 9.9GB,连整个模型的 3% 都不到。
作者的类比是「权重的 JIT」:路由器点到谁,谁才从硬盘调进内存上岗,跟编译器只编译正在执行的那段代码是一个思路。
光靠按需读,带宽撑不住,项目又堆了三级加速:LRU 缓存把常用专家留在内存,学习型 hot-store 让高频专家升舱,再把下一层提前预取。下一层路由的可预测性实测有 71.6%,预取大多能猜中。还支持双 SSD 镜像,两块盘分摊读取带宽。
放在行业坐标系里看:主流路线是把模型做小,蒸馏、量化,或者直接出 Flash 小杯。Colibrì 反着走,模型一动不动,动的是存储层级。清华系还有一个同思路的 KTransformers,两个项目相互独立,别混成一家。
带走一个判断:MoE 时代,「装不下」正在变成「放哪里」。显存不够,硬盘来凑,账单改成耐心,或者硬盘钱。
代价清单:谁先别碰它
先说反直觉的那个点:跑得动,不等于用得起。
第一笔是下载。预转换好的 int4 权重约 370GB,你得先把这批东西完完整整拉回家。370GB,大约是一块主流 1TB SSD 的三分之一多,硬盘不腾出这块地方,一切免谈。
第二笔是等待。冷缓存那档一分钟 3 到 6 个字,第一句话回完,你的水已经烧开了。没有耐心这个配置,建议直接看下一档。
第三笔是场景。Colibrì 是推理框架,只管出字,不能训练也不能微调。机械硬盘同样不在设计范围里,权重指定放 NVMe 固态,读取带宽就是这套方案的生命线。
第四笔是钱。想要 5.8 tok/s 的流畅档,6 张 RTX 5090 在门口候着。所以它眼下最诚实的定位,是极客玩具加技术宣言,不是大众生产力。
如果你恰好有 16GB 以上内存、一块闲着的固态硬盘,外加一点好奇心,往下看。
现在就能试:一张配置单,一条命令
最低配置 README 写得明白:16GB 内存能跑 GLM-5.2,推荐 24GB;开发机参考是 12 核 CPU 加 25GB 内存。显卡不在必需清单里。
第一步,去 GitHub 找 Colibrì 仓库。Windows、macOS、Linux 都有预编译版,程序本身只有几百 KB,先把它拿下。
第二步,下模型。预转换 int4 权重约 370GB,这步最熬人,硬盘和带宽在这里见真章。
第三步,敲 coli chat,直接开聊。
想看门道,再敲 coli web。Dashboard 实时刷新 tok/s 和专家分布;Brain 页把 19456 个专家整个画了出来,哪个被路由器点名、住在哪一层、热度多高,一目了然。看着自己提问时专家一个个亮起来,比盯着速度数字有意思。
两个预期先立好。16GB 的老笔记本属于「能跑」档,把它当玩具,别当生产工具;第一次提问别急着催,权重正从硬盘往内存里搬,缓存热起来是另一番景象。
有条件就上双 SSD 镜像,读取带宽两块盘分着扛,速度还能再挤一点。
盯两个信号,半年后见分晓
项目往后怎么走,别听我下结论,盯两个能自己验证的信号。
信号一,仓库的迭代节奏。7 月 1 日建库,9 月底 star 超 3.8 万,版本已经走到 v1.12.1,模型覆盖 9 族:从 7B 的 OLMoE 一直到 2.8T 的 Kimi K3,K3 权重约 1.6TB,32GB 内存就能起跑。适配的模型越多、版本走得越稳,这条路线的含金量越高。
信号二,Flash 小杯的低配速度。GLM-5.3-Flash 321B 带 vision,如果这一档「小杯」在 16GB 内存、无独显的机器上爬到可用速度,「硬盘换显存」就从极客玩具变成大众方案。
最后押个注,白纸黑字放这里,半年后可证伪:如果 GLM-5.3-Flash 在一台 16GB 内存、没有独立显卡的笔记本上,还是跑不到每秒 1 个 token,那「门槛从显存转移到硬盘加耐心」这个判断就作废,你也别再信我后面的判断。
我押它能过线。你押哪边,评论区见。
想跟这个项目后续的点个关注,下一批低配实测我会接着盯;觉得有用,点赞转发给那个总抱怨显存不够的朋友。