ARTICLE · 1139881
39 万星的 OpenClaw 之后,私人助理又换了三轮壳
我决定试一次。勾授权的时候,邮箱、GitHub、日历三项挨着一项点,手指在触控板上停了两秒,还是都点了同意。
它的第一句话是:你叫什么名字。
这个开场白我十五年前就听过了。当年那台手机里的女声也这么问过,问完记下你怎么称呼,然后接着装傻。换了几十轮前沿模型,发布会开到旧金山的剧场里,第一句话一个字没变。
我给它的判断是:现在用没必要,深度用更亏。原因不在产品做得糙,这几家的工程完成度其实都在水准线上,有些细节比自己搭的环境顺手得多。问题出在最底下那层方法上。从 GPTs 到今天,把通用模型变成你专属助手的手段,一直是同一件事:把你的东西重新塞一遍。
一、所谓「越用越懂你」,是每一轮都把那摞材料重新塞进同一个模型
拆开看一次请求是怎么拼的。系统提示、记忆文件、工具定义、你刚敲的这句话,被拼成一段长文本,送进同一份权重。
权重一个字节都没动。
没有针对你的微调,没有只属于你的表征向量,也没有哪次对话被写回模型内部。它「记得」你,是因为上一轮那些记录这一轮又出现在输入里。所谓个性化,就是把上下文重新读一遍。你越用它,它手上的材料越多,模型本身一点没变。
为什么不能真的学进去?训练一轮的算力和周期摆在那儿,没有哪家会为单个用户重跑一遍权重,成本上划不来,工程上也不可回滚。走输入这条路,是唯一能立刻生效、还能随时撤销的方案。这个选择有它的道理。
这条线走下来很清楚。最早的 GPTs,固定塞一段别人写好的提示词,所有人共用同一段话,区别只在你新建了几个。ChatGPT 加了记忆,把你的对话压成摘要,下一轮回填进去。再往后跨会话、跨 Agent 共享,Agent.md、MEMORY.md、SKILL.md 这些文件开始落到磁盘上。到 OpenClaw,渠道和定时任务接上了,就有了「主动找你聊天」这套说法,说白了就是定时触发一次,触发时照样把那堆文件重读一遍。
每一步都在加外围,内核那层没被碰过。
写个二十行的脚本,你自己就能看见这件事。
# probe_context.py —— 看每一轮请求实际被重新塞进去多少字# 用法:python3 probe_context.py /tmp/myagentimport pathlibimport sysroot = pathlib.Path(sys.argv[1])root.mkdir(parents=True, exist_ok=True)memory = root / "memory.md"memory.touch()for turn in range(1, 6):with memory.open("a", encoding="utf-8") as fh:fh.write(f"\n[第 {turn} 轮] 用户问了第 {turn} 个问题,助手回了答案。\n")bundle = "\n".join(p.read_text(encoding="utf-8") for p in sorted(root.rglob("*.md")))print(f"第 {turn} 轮:本轮请求携带 {len(bundle)} 字符上下文")
跑出来的数字只增不减,增速还越来越快。文件越大,每一轮反复重读的开销越高,而模型那边什么都没记住。
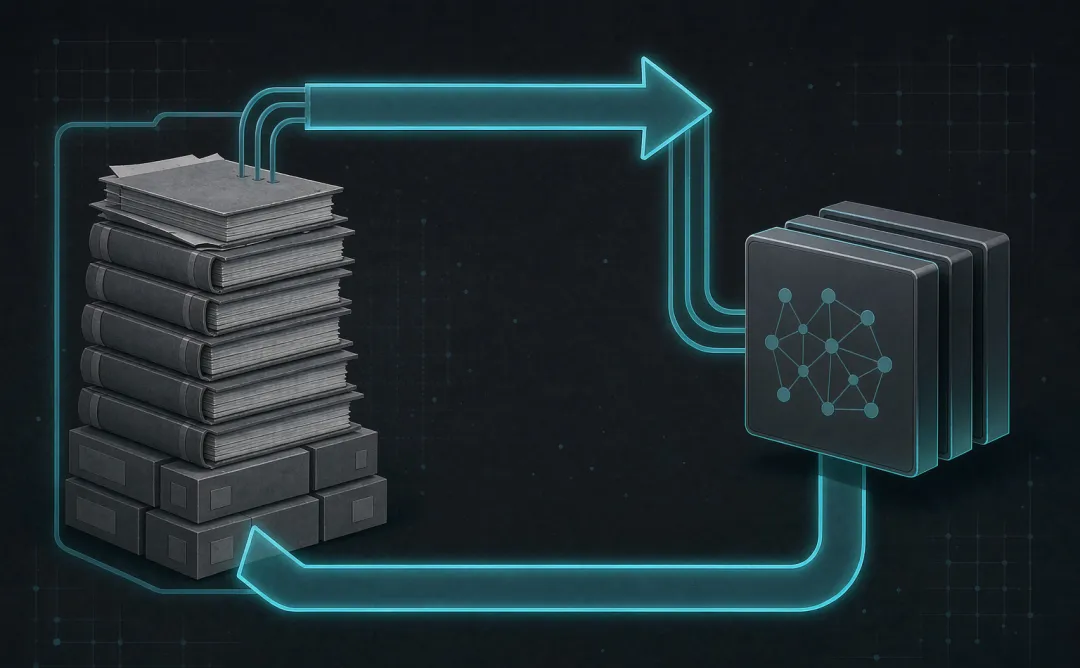
这套做法还有两个副作用,都不显眼。一个是注意力被稀释:同样一条记录,放在开头和埋在一千行琐碎内容中间,起作用的分量不一样,越靠后越容易被忽略。另一个是成本和延迟,上下文按 token 计价,你喂得越多,每一轮越贵、越慢。检索增强算是个补丁,从库里挑相关片段再塞进去,挑的过程本身会挑错,挑错了它照样答得笃定。
还有窗口这堵墙。上下文再长也有边,记录攒到一定程度,早期内容要么被截断,要么被摘要压扁,而压缩就是丢信息。
跑通这个脚本只花一分钟,它顺手解释了一个更疼的现象:你把用惯了的助手换个底座,它立刻失忆。记录存在它自己库里的那份带不走,存在你硬盘上的那份才跟得上你。也能顺带解释另一件事:新产品介绍页翻来覆去就那几个词,可讲的变化确实只在外围。我做过后端,日均千万级请求的服务跑久了只信一条——状态别放在你控制不了的地方。放大到私人助理,这条一样成立。
二、三个月换了三轮壳,换掉的是入口和授权面,记忆的所有权没动
九月的发布节奏密得离谱。九月八日 Meta 的 Muse 上线,主打个人生活管家,接邮件、日历、出行、购物。九月二十八日 Manus 把 Cue 跟 Manus 2.0 一起发出来,给每个分身配独立的邮箱、电话号码和钱包,让它别总借你的账号行事。九月二十九日 DevDay 上,OpenAI 的 Dots 压轴,带着自己的云电脑和浏览器,能挂的应用数以千计。再往前,SpaceXAI 的 Grok Bot 八月十一日就开了 beta,走的是公司里按角色分派的路线。
名字一个比一个像人,都在讲同一件好事:它替你干活,你不用在 App 之间来回切。
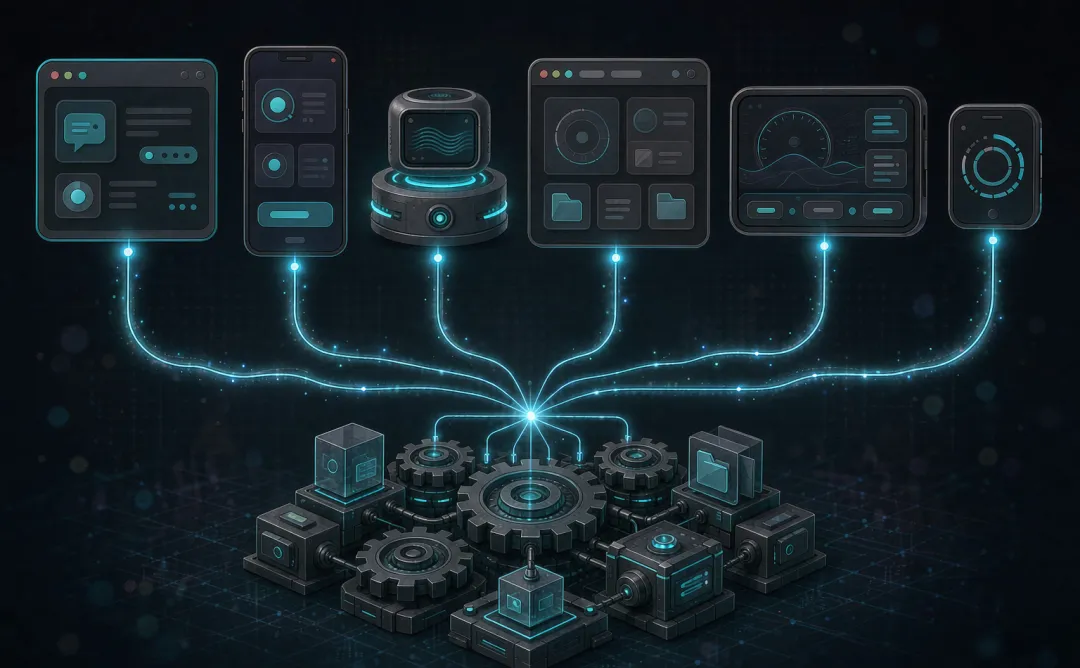
看一下它们的开场流程。注册完先问你叫什么,接着让你给它起个名字,然后弹出一长串授权:邮箱、GitHub、X、飞书、QQ、博客,一项一项勾。勾完它读你的信息,写成 Agent.md,或者挂成检索索引随时来查。换了产品,这套流程从头再走一遍。重新授权、重新回答一遍那些莫名其妙的问题、重新攒记录,一样都省不掉。
工程上这些差别有真价值。Cue 把身份切开,减少的是你本人的暴露面。Muse 拿 Sentinel 把凭据挡在模型层外面,模型看不到你的真实密码。Dots 给你一个后台,能看它此刻在做什么。这些都是实在的设计,值得认。
同时要认另一半:授权清单越长的产品,帮你干的事越多,你交出去的口子也越多。邮箱能读信、代码库能改代码、钱包能付钱,它们被收进一个你没法审计的黑盒子里,出了事只能等对方给说法。Cue 给每个分身配独立钱包,其实就是在承认这个风险,用隔离去换一点安全边界。
想验证记忆归谁,有个笨办法。注册完先问一遍「我的记录能不能整份导出成文件」,再看它怎么答。答得含糊的,你就知道那份记录只是寄存在它那儿。
存下来的东西呢?还是自然语言写的文件,或者被切碎塞进向量索引的片段。落点仍在别人的机房。数据能不能整份导出、账号被封之后怎么善后、产品哪天关停你还剩下什么,这三件事没有一家给出承诺。而这三件事恰好决定了你这几年的记录值不值钱。
再看一眼那条已经跑完的路。OpenClaw 在 GitHub 上的星数是 391,599(2026-10-07 查的 API),从 Clawd 改名 Moltbot,再改名 OpenClaw,代码 MIT,跑在你自己的机器上。这批产品里它是唯一把数据留在你设备上的那个,代价是配置门槛,社区里代装服务的价格一度喊到几百块钱一次。星数堆到三十九万这件事本身有信息量:大家对「数据在自己手里」是有感觉的。这一点比叫法重要得多。
三、真正在变的是数据怎么收集,先把它记到自己手里
私人助理肯定是个长期方向,这话我认。尴尬的是眼下卡在中间态:能拿到的数据没有质变,所以只能反复造新词、换包装。模型能力几个月一换,产品形态跟着换,而你喂进去的那份记录是长期资产,它的时间尺度比产品长得多。
真正的突破得等采集层出变化。第一步是渠道打通,你的邮件、日程、聊天记录终于能被同一个东西读到,量攒够了会有一次质变。第二步更远,得等脑机接口这类东西给出另一维度的数据,那些用自然语言根本描述不出来的习惯、直觉和潜意识,才有机会被记下来。现在连第一步都还在半路上,第二步连影子都没有。
那今天能做什么。找个地方攒自己的记录,写日志是最省事的一种。
这件事我有过教训。前面几年没认真记,等想把几年的经历丢给模型分析,发现在手的信息量太少,它只能抓着记得稍认真的那一两段反复咀嚼,结论整个跑偏。后来想明白原因:检索是按相似度取最相关的几条,你哪几天写得细、哪几天只有一句话,模型拿到的样本天生就是偏的。写得均匀比写得漂亮重要。
后来改成每天固定写三行:今天做了什么决定、当时凭什么这么判断、后来结果怎么样。有空再加一行「当时还没想清楚的是什么」。三个月回头翻一次,就能看出自己反复在哪些地方栽跟头。
存法也简单,纯文本文件按日期命名,放在自己硬盘或者自己的仓库里。这样攒两三年,换模型、换产品、换公司,这份上下文都跟着你走。
纸质本子也行,问题是检索起来费劲,脚本读不到,想喂给模型只能一页页拍照。能被机器直接读到的记录,才方便以后拿去做复盘、写年终总结。
现阶段把心力全押在某一款私人助理上,代价是把几年的记录存进一个你既不知道它未来长什么样、也不清楚它拿你的数据去做什么的中间产物里。产品会换代,记录得留下。
# dump_log.sh —— 把日志目录拼成一份可移植的上下文,喂模型前先看体积# 用法:bash dump_log.sh ~/journal out/context.mdset -eusrc="${1:?日志目录}"out="${2:?输出文件}"mkdir -p "$(dirname "$out")"{echo "# 我的记录(按时间正序)"find "$src" -name '*.md' | sort | while read -r f; doechoecho "## $f"cat "$f"done} > "$out"echo "拼出 $(wc -m < "$out") 字符,来自 $(find "$src" -name '*.md' | wc -l) 个文件"
黑镜那集里给过另一种解法,脑子里插个芯片实时记录,连日记都省了。那是第二步的事,现在拿不到。第一步能拿到的东西,就看你愿不愿意每天花三分钟写下来。
回到开头那个问题。它问你叫什么名字的时候,你其实该反问它一句:我今天说过的话,明天存在哪里,能不能整份拿走。答不上来,这份记录就别只写在那一个 App 里。