ARTICLE · 1168109
知识库解析 PDF 实践:如何保留上下标、行内图片和原文位置
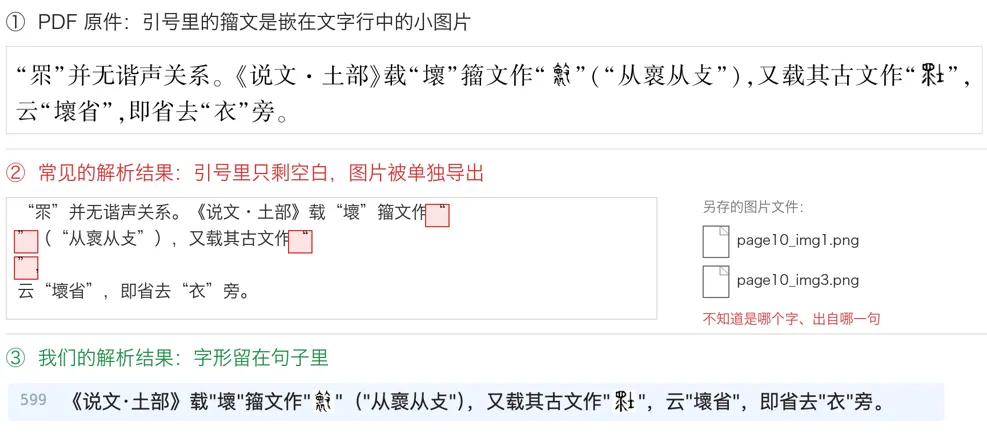
同一句话在 PDF 原件、常见的解析结果和我们的解析结果中的样子。
图中的例句出自一篇古音学论文,引号中的籀文在原件里以小图片的形式嵌在文字行中。常见的解析方式把文字和图片分开处理,于是文本里的引号中只剩空白,字形图片被单独存成了文件。文字和图片都还在,它们之间的关系,以及图片在原件中的位置却都丢失了。上下标也有同样的问题,10⁻³ 的指数常被排到下一句的开头。
本文介绍我们团队为知识库解析 PDF 的做法,重点讲解行内图片和上下标两件事。贯穿全文的指导思想只有一句话。
尽可能把原件里的信息完整地留下来,包括「位置信息」。
一个字是上标,是信息;一张图夹在哪两个字中间,也是信息。信息一旦丢失,检索召回的效果就会大打折扣。
01 先看一个例子
下图是开头那句例句在原件中的样子,出自《中国语文》2025 年第 4 期一篇古音学论文。引号中的两个古文字字形不在现行的 Unicode 字符集里,无法作为普通文字排版,论文只能用嵌在行内的小图片来表示。

图1 原件「籀文作」「古文作」后面引号里的字形都是嵌在文字行里的小图片。
用常见的方式读取这一页的文字层,得到的结果如下。
“眔”并无谐声关系。《说文·土部》载“壞”籀文作“
”(“从褱从攴”),又载其古文作“
”,
云“壞省”,即省去“衣”旁。
图片被单独导出成 page10_img1.png、page10_img3.png 之类的文件。这样会带来两个问题。
•文本里「籀文作“”」只剩一对空引号,无论是人还是大模型,都无从得知籀文的字形;
•图片被检索命中时,无从得知它是哪个字的籀文,出现在文章的哪一节、哪一句。
同一段经我们的管线处理,输出的正文如下。图片文件名是图片内容的哈希值,这里只显示前 8 位,下同。
《说文·土部》载"壞"籀文作""("从褱从攴"),又载其古文作"",云"壞省",即省去"衣"旁。
图片留在文档流中原来的位置上。按 Markdown 显示的效果如图 2。
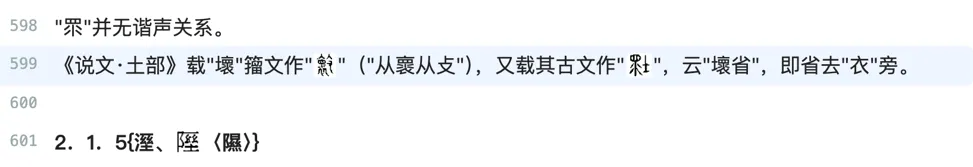
图2 生成的正文按 Markdown 显示的效果。左侧是行号,第 601 行是一个小节标题,标题中同样内嵌一个行内字形图片。
我们另外记下了这句正文在原件上的位置,即第 10 页的坐标框 [73.97, 88.25, 493.06, 128.41],单位是 PDF 点。这句话在原件上排成两行,两行的字框合成了这一个框。两个图片引用也各自记有图片本身的坐标框,比如第一个字形是 [307.82, 92.94, 318.11, 103.71]。
下面依次介绍管线的整体结构、行内图片如何放回文档流,以及上下标如何识别。
02 管线总览
我们的目标是输入一份 PDF,输出一份普通的 Markdown 文本,其中数学公式用 LaTeX 表示,图片用标准的图片语法引用。之后的切块、向量化、检索和大模型阅读,都只针对这份文本操作。
整个流程分为抽取和生成正文两步。

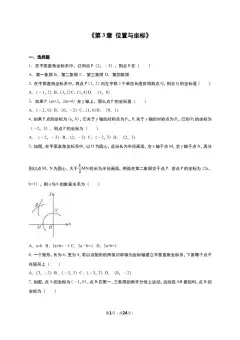
抽取逐页进行。下图是一份八年级数学期末试卷第 2 页上的第 7、8 题,三栏分别是各步的结果。
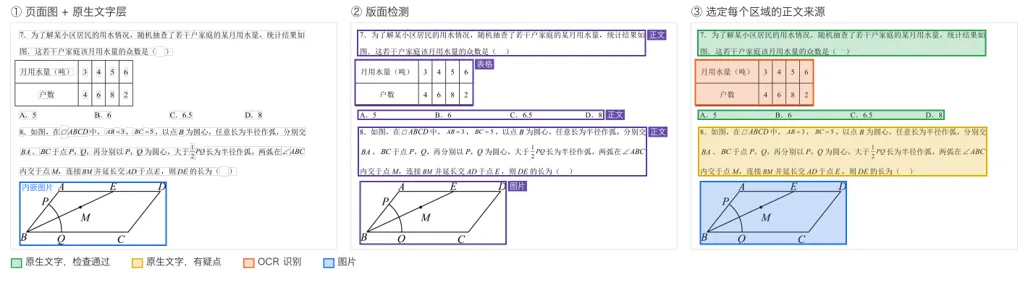
图3 ① 页面按 2 倍分辨率渲染成图,同时用 PyMuPDF 读取原生文字层,灰框是每个文字片段的位置,蓝框是内嵌图片。② PP-DocLayoutV3 把页面分成区域,打上正文、表格、图片等标签,字和图片按重叠面积归入区域。③ 逐区域检查原生文字是否可用,选定正文来源。
第 ③ 步会检查有没有可疑的字符编码、有多少墨迹没被字框盖住、文字是否旋转或不可见,再按字体抽查几行,与 OCR 结果核对,查出编码表损坏的文字层。绿色区域是第 7 题的题干和选项,检查都通过,正文直接用原生文字。黄色区域是第 8 题,其中的 ▱、∠ 在文字层里是 Unicode 私有区编码,按字体查表还原后,正文仍用原生文字。橙色区域是表格,表格的格线不在文字层里,原生文字无法覆盖页面上的墨迹,于是把整块区域裁成图片交给 PaddleOCR-VL 识别,识别出的文字写入正文。蓝色区域是配图,正文里放图片本身。
抽取完成后进入生成正文这一步,依次识别上下标、规范化字符。在生成正文的过程中,原件里的每个字始终保留自己的坐标,因此每一行都能映射回原件的页码和坐标框;#、

图4 灰框是原生文字的字框,红线是每行的基线,蓝框是两张字形图片。第一张图高 10.77pt,所在行字号 10.29pt;图片中心下移 0.35 个字号后,离基线只差 0.004 个字号。
无法确定所在行的图片单独成段,放在文档流中相应位置的附近,不丢弃。
标题里的字形同样会插入行内,比如图 2 第 601 行的小节标题 ## 2.1.5{溼、〈隰〉}。因此按标题切块时,块所带的章节名里也有这个字形。
3.3大图的处理
版面检测标为「图片」的区域,正文里单独成段,按阅读顺序留在文档流中,排在前后文字之间。具体还有以下几条规则。
•原图优先。内嵌原图覆盖区域的 65% 以上、且自身 85% 以上落在区域内,就用原图,保留原始分辨率;否则从页面图上截取。
•扫描底图。占文字区域面积 30% 以上的内嵌图通常是扫描件的整页底图,不计入该文字区域。
•OCR 识别失败的区域,正文里用该区域的页面截图代替,保证内容不丢失。
3.4正文中的图片引用
图片用标准 Markdown 语法引用,文件名是图片内容的 SHA-256,写作 。
这样,同一张图片的引用始终相同。同一个字形在文中出现 3 次,3 处引用就是同一个文件名,全文搜索这串哈希,即可找到它的每一处出现。凭文件名也能直接取回图片,不需要知道它在第几页。与正文里的文字一样,图片在原件上的坐标框也另外记录了下来,可以定位到原件上的对应区域。
3.5示例
表格里的字形。古音学论文的表 5 里,每个竹简字形后面跟着它出自哪支简。
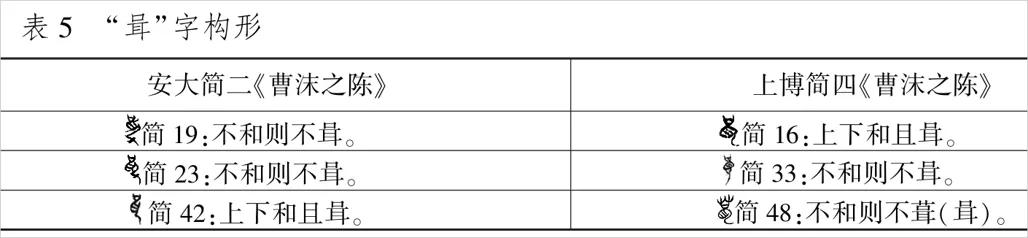
图5 原件中的表5
简19:不和则不咠。
简16:上下和且咠。
简23:不和则不咠。
……
每张字形图和它的出处在同一行。如果把图片单独导出,这 6 个形状相近的字形就无法与出处对应。
选项全是图片。同一份数学试卷中,第 1 题的四个选项都是图片。
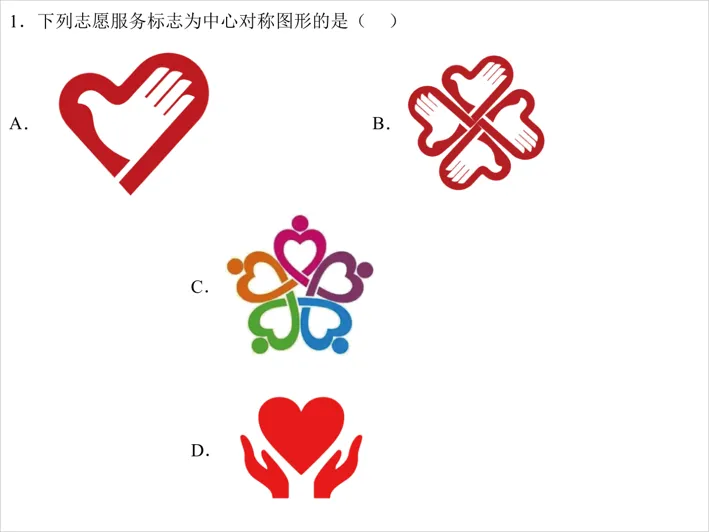
图6 原件。每个选项字母和它的标志图片排在同一排。
1.下列志愿服务标志为中心对称图形的是()
A.
B.
……
四张图按大图处理,单独成段,每个选项字母后面紧跟着它的图片。
3.6图片如何参与检索
图片本身无法按文字检索,但留在文档流里以后,就能通过它周围的文字被找到。计算向量时,我们先把图片引用去掉,因为 64 个字符的哈希对语义没有意义,只会带来噪声。以图 1 那句为例,它的向量由「《说文·土部》载"壞"籀文作""("从褱从攴")……」算出,上下文完整,仍能被检索命中;而命中后返回的是带图片的原句。因此,只有图片、没有文字的块去掉图片引用后就没有内容了,不进入索引。
命中的块记录了行号区间,可以经由每行的位置映射回原件的页码和坐标框。大模型拿到的是带图片引用的正文,支持图像输入的模型可以按引用取回图片,看清籀文的字形或选项里的标志;需要给用户展示图片时,原样输出  即可。
04 上下标:别让 10⁻³ 变成 10 和 -3
4.1为什么上下标会错位
PDF 的文字层里没有「上标」这个概念。10⁻³ 里的 −3 只是一个字号小一点、基线高一点的普通文字片段,按基线分行时常被当成另一行,排到文档流的其他位置。
下图出自一篇硕士学位论文的第 62 页。

图7 原件,出自硕士学位论文《面向肺部气道分割的高效学习算法研究》第 62 页。
不处理上下标时,得到的正文如下。
优化器采用Adam,初始学习率设置为3×10。
对于BAS数据集,使用多步调度器在第-3 20和第60次迭代将学习率降低10倍,训练总共进行100次迭代。
−3 的基线比正文高 4.8pt,被排进了下一句。大模型读到的学习率是 30,「第-3 20和第60次」更是不知所云。
再看同一篇论文第 47 页的上标引注。
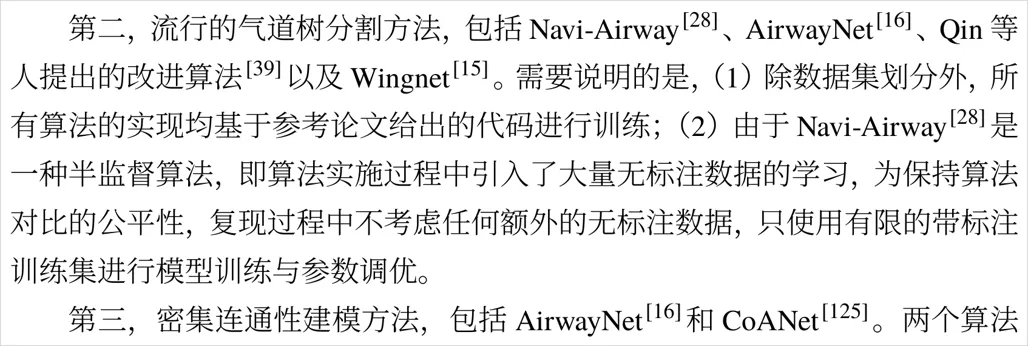
图 8 原件。算法名后面的 [28]、[16] 是上标引注。
第二,流行的气道树分割方法,包括Navi-Airway、[28] AirwayNet、[16] Qin等人提出的改进算法以及Wingnet。
需要说明的是,(1)除数据集划分外,所[39] [15]有算法的实现均基于参考论文给出的代码进行训练;……
[28]、[16] 错位到了后一个算法名的前面,[39]、[15] 更是插到了「所有」两字之间。
化学文献里的上下标更多。下面两段来自 FDA 的两份公开指南,一处是亚硝胺的结构通式,一处是核磁共振的同位素标记。

图9 原件,出自 FDA《Control of Nitrosamine Impurities in Human Drugs》第 9 页。
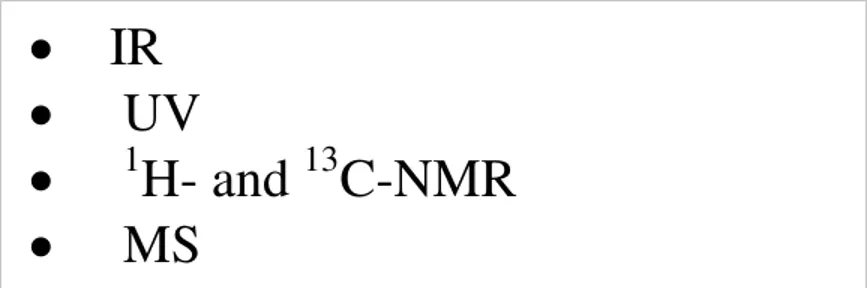
图10 原件,出自 FDA《Question Based Review (QbR) Drug Substance Reviewer Companion Document》第 11 页。
... bonded to an amine (RN(-R)-N=O), as shown in Figure 1.
The compounds can form by a 1 2 nitrosating reaction between amines ...
• H- and C-NMR 1 13
取代基编号 1、2 错位到了下一句,¹H、¹³C 的质量数被排到了行尾。R¹、R² 是两个不同的取代基,¹³C-NMR 和「C-NMR 13」的含义也不同。
4.2识别上下标
在同一行里,把每个文字片段和左右相邻的片段比较。上下标所附着的正常字号片段,下文称为「基字」。一个片段满足下表全部条件时,就认定为基字的上标或下标,表中的 em 指基字的字号。
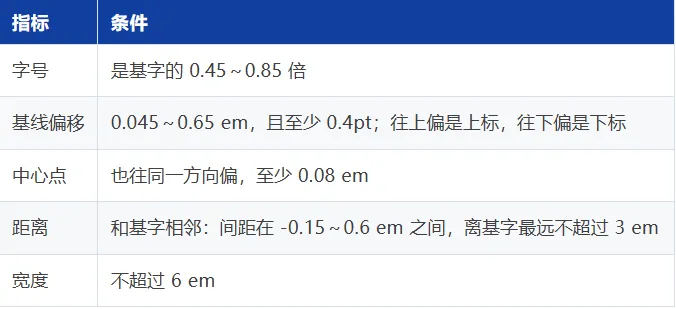
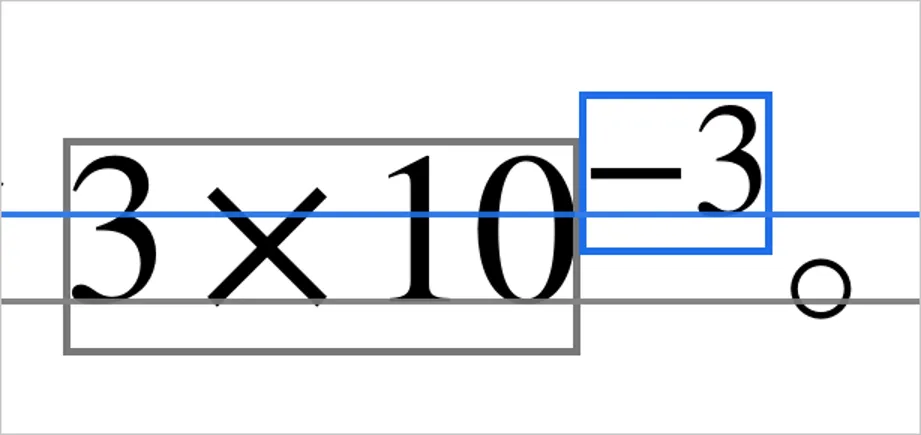
图 11 灰框是基字「3×10」,灰线是它的基线;蓝框是候选「−3」,蓝线是它的基线。−3 是 9pt,3×10 是 12pt,比例 0.75;基线上移 4.80pt,即 0.40 em,判定为上标;中心上移 0.34 em;两者间距不到 0.01pt。
此外还有几条补充规则。
•拆成几段的下标,比如 max 拆成 m、a、x,每段都可以跳过相邻的同样大小的小字,向外寻找基字,最多跳过 8 个。
•两边都能当基字时取左边。Word 导出的 PDF 里,下标离右边的字往往略近,如果按距离选择,CO₂ 的下标会被错误地识别为后面「的」字的下标。左边是标点、列表符号这类不能带上下标的字符时,才取右边,比如图 10 的 • ¹H,上标附着到右边的「H」上。
•以下情况不处理。左右两边的结论矛盾,一边是上标、一边是下标;基字本身也是小字,比如上标的上标;以及旋转、竖排的行。
4.3正文中的上下标写法
正文里的数学内容统一用 LaTeX,上下标也一样,写法见下表。
•基字以数字结尾时,这串数字一并放入公式,写作 3×$10^{-3}$,不写作 3×10$^{-3}$,因为 markdown-it-texmath 等常用的 Markdown 公式插件不把数字后面的 $ 当作公式开头。
•相邻的上下标合成一个公式,避免两个 $ 相连被当成行间公式。
•下标里的空格写成 \ ,数学模式会忽略普通空格。
•上标引注和带圈数字写成普通文字,只调整位置,搜 [125] 仍能搜到。
处理后,前面几段的正文如下。
优化器采用Adam,初始学习率设置为3×$10^{-3}$。
对于BAS数据集,使用多步调度器在第20和第60次迭代将学习率降低10倍,训练总共进行100次迭代。
第二,流行的气道树分割方法,包括Navi-Airway[28]、AirwayNet[16]、Qin等人提出的改进算法[39]以及Wingnet[15]。
... bonded to an amine (R$^{1}$N(-R$^{2}$)-N=O), as shown in Figure 1.
The compounds can form by a nitrosating reaction between amines ...
• $^{1}$H- and $^{13}$C-NMR
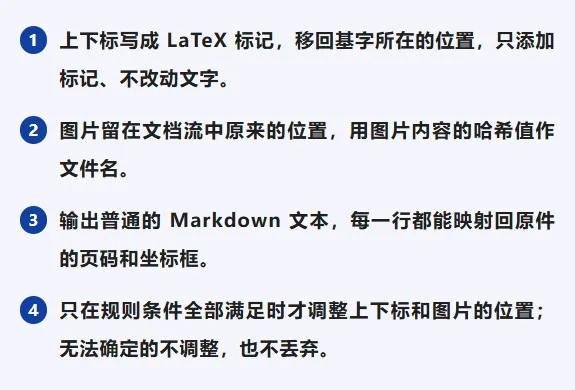
识别上下标没有改动原件的文字,只添加了标记、调整了位置。
每个字都保留原来的坐标,并入公式的「10」也一样。
表格里的化学式另有处理方式。表格区域整块裁图,由 PaddleOCR-VL 直接输出带 LaTeX 的表格。比如 QbR 第 15 页的「Dissolve 6.8 g of KH₂PO₄」,输出是 Dissolve 6.8 g of $ KH_{{2}}PO_{{4}} $。这是 OCR 模型的原样输出,写法和上表不同,我们没有改写。
4.4为什么不用别的写法
我们也考虑过另外几种写法。CO₂、10⁻³ 这样的 Unicode 上下标字符只覆盖数字和少数字母,写不出 𝑠𝑒𝑔、540 NRU 这样的上下标。HTML 的 <sub>、<sup> 标签会干扰搜索,大模型回答时也不该输出 HTML。如果正文不加标记,只在界面上显示成上下标,大模型读到的仍是「3×10」和「-3」,问题并没有解决。
LaTeX 写法的代价是搜「CO2」搜不到「CO$_{2}$」。在我们的系统里,检索由大模型自己发起,所以我们在系统提示里告诉它,搜上下标时使用 CO$_{2}$ 这样的 LaTeX 写法。
05 已知的局限
上下标的识别依赖基字所在的行。如果基字本身被分错了行,上下标即使识别正确,也会跟着错位。比如前面那篇硕士学位论文第 45 页的「γ₁ 与 γ₂ 为不同损失函数之间的平衡权重」,𝛾$_{2}$ 本身识别正确,却随基字错位到了下一句开头。
行内图片的处理只覆盖 PDF 里真正嵌入的图片。有些字形是用矢量路径画出来的,既不在文字层里,也不是内嵌图片,正文里这个位置目前是空白,图 1 那篇论文里就有几处。
大图和它的说明文字分在两段时,两者的对应关系只靠阅读顺序维持。试卷第 1 题这样逐个排列的选项没有问题;如果选项排成 2×2 网格,或者字母和图片上下错开,顺序就可能出错。
小结
把 PDF 转成文本时,最容易丢失的是字和字、字和图之间的关系。−3 是 10 的指数,R¹、R² 是两个取代基的编号,引号里的字形是「壞」的籀文,表格里的每个字形对应一支简,四张标志图各自对应一个选项。
要保住这些关系,就要让上下标回到基字旁边,让图片留在原来的位置,同时记下每一行在原件中的位置。我们的做法可以归结为以下四条。
这样得到的文本可以直接用于切块、向量化和检索,其中的每一句话都能溯源到原件中的具体位置。
供稿人:冯国宇 AI全栈工程师
文中示例取自《中国语文》2025 年第 4 期《论缉部在晚期上古汉语中的分化》;硕士学位论文《面向肺部气道分割的高效学习算法研究》;某地 2022~2023 学年八年级数学期末试卷;美国 FDA 2024 年 9 月发布的《Control of Nitrosamine Impurities in Human Drugs》和《Question Based Review (QbR) Drug Substance Reviewer Companion Document》。插图为原件节选,仅用于说明处理效果。
立即扫码申请免费测试账号
联系我们
杨女士
电话 Tel:021-33680778
邮箱 Mail:marketing@qinchengsoft.com
点击下方👇阅读原文抢先体验AI落地!