ARTICLE · 1210552
AI 最大的问题,是它太勤快了
有意思 AI · 2026.10
QUOTE
AI 不累。这是它最大的优点,也是它最大的灾难。
最近我在 GitHub 上刷到一个仓库,16.7 万颗星。
我第一反应是,这又是什么新模型,或者哪个大厂开源了什么新框架。
点进去一看,整个仓库的核心,是一段 3.5KB 的提示词。
它叫 Ponytail。
本文看点
01
16.7 万星,只为一段提示词
02
七级台阶,先问能不能不写
03
代码少一半,测试反而多了
01
THE LAZY ONE
公司里那个最懒的人
Ponytail 的自我介绍只有一句话。
「他一言不发。他写一行。它能跑。」
我看到这句话的时候,脑子里立刻浮现出一个人。
每个公司都有这么一个人。扎个马尾,戴副椭圆眼镜,在公司的年头比版本控制系统还长。
大家抱着一堆代码去找他,他不说话,看完,删掉一大半,留下一行。跑了。然后端着杯子走了。
Ponytail 干的事,就是把这个人塞进 AI 里。
仓库是今年 6 月 12 日建的,到今天刚过四个月。MIT 协议,支持 20 种 agent,Claude Code、Codex、Cursor、Copilot 都能装。
四个月,16.7 万星。这个速度本身就很能说明问题。
我又翻了一遍 README。作者 DietrichGebert 没放自己的照片,也没讲什么创业故事。
整个仓库最像个人介绍的地方,就是那句“你认识他。长马尾。椭圆眼镜。”
剩下的,全是规矩。
这也是为什么,这个仓库里没有一句“颠覆”、“革命”、“重新定义”。它只是在复述一个老工程师的日常。
而它的核心,真的只有那段 3.5KB 的 SKILL.md。没有模型,没有框架,没有 SDK。剩下的全是适配器,作用只有一个,把这段提示词塞进不同的 AI 里。
坦率的讲,我第一次看到这个项目,反应不是“又一个提示词工程”。
我是在想,一个这么朴素的东西,凭什么能让 16 万人点星。
01
16.7 万
GitHub stars
02
4 个月
从建仓到现在
03
3.5KB
核心提示词
02
THE LADDER
它先问的不是怎么写
Ponytail 干活之前,会先爬一个七级台阶。
这东西需要存在吗。
代码库里是不是已经有了。
标准库能不能干。
平台原生功能能不能干。
已经装了的依赖能不能干。
能不能一行写完。
才轮到“写最少能跑的代码”。
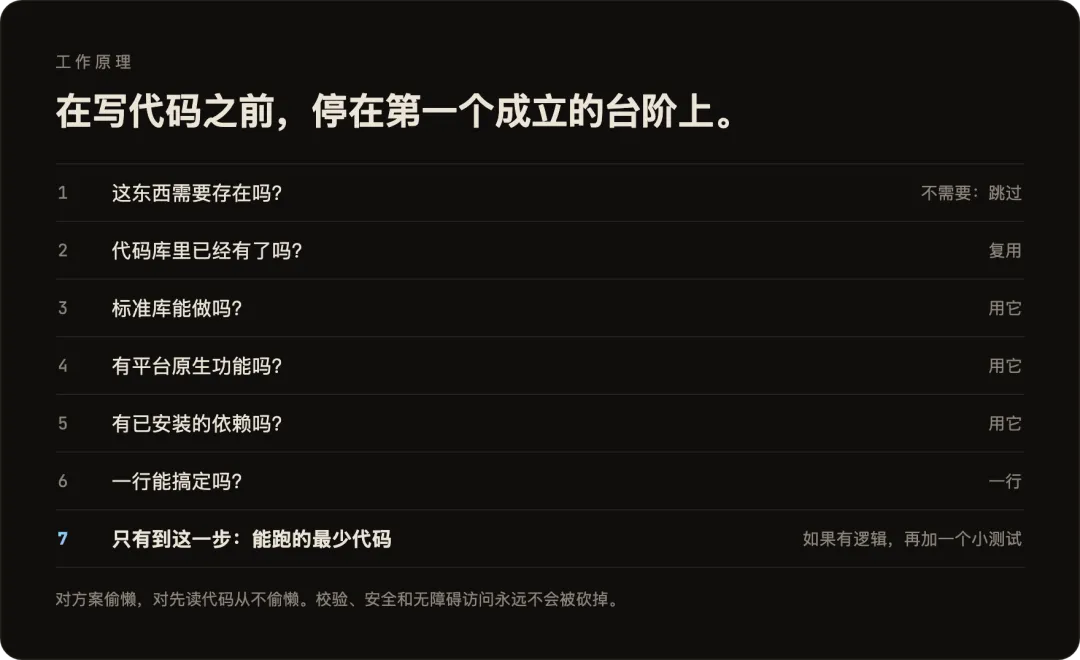
七级台阶:先问能不能不写。图源:Ponytail 仓库
注意这个顺序。它动手之前,先想的是能不能不写。
这七级台阶,其实是一套很老的工程直觉。过去它活在资深工程师的脑子里,现在被写成了一段可以复制的文本。
比如加一个日期选择器。
不装 Ponytail 的 agent,会先装一个日期库,再手写一个日历组件,顺手补上时区处理、键盘导航、无障碍标签,还有一个没人提过的“清空”按钮。335 行。
Ponytail 会先看仓库里有没有现成的 Input 组件,再看浏览器是不是本来就带日期选择。两样一拼,10 行。
335 行
不装 skill
10 行
Ponytail 5
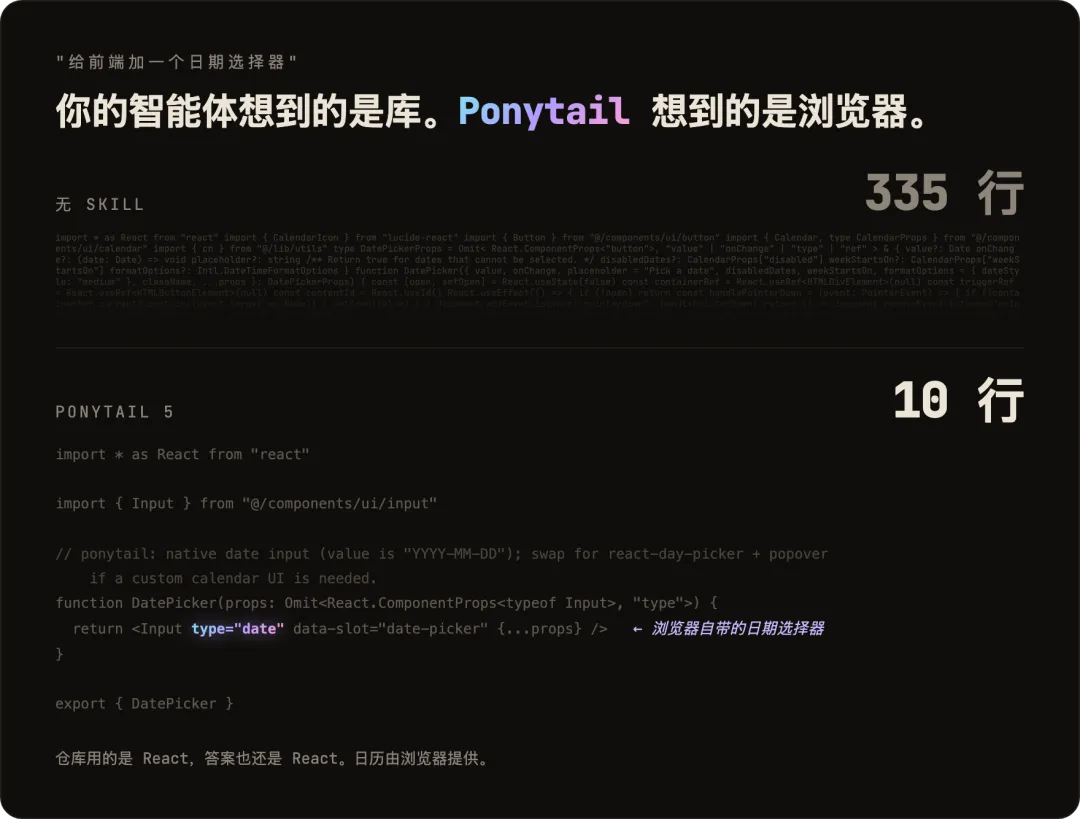
同一个日期选择器:335 行与 10 行。图源:Ponytail 仓库
这种差距不是个例。在作者跑的 39 个任务里,一抓一大把。
给前端加一个向导,311 行变成 90 行。加一个命令面板,319 行变成 131 行。
加一个拖拽上传,247 行变成 62 行。用 LangGraph 搭个小应用,148 行变成 29 行。画个曼德博集合,129 行变成 32 行。
最夸张的还是日期选择器,335 比 10。
三十三倍。
03
THE NUMBERS
少一半代码,多一倍测试
看到这里,大家可能会想,少写代码有什么难的,让 AI 少写点不就行了。
问题就在这儿。
粗暴地让 AI 少写,它第一刀砍的往往是校验、错误处理、安全检查和测试。代码是短了,线上也开始出事了。
Ponytail 的作者显然知道这件事。所以他在 README 里专门写了一句话,大意是,规则跟 token 最少没有关系,规则是只写任务需要的东西,永远不砍校验、错误处理、安全和无障碍访问。
README
规则跟 token 最少没有关系。规则是只写任务需要的东西,永远不砍校验、错误处理、安全和无障碍访问。
翻成大白话,方案可以偷懒,责任不能偷懒。
它的基准测试数据是这么来的。Claude Code,Opus 5.5,同一个 agent,装 skill 和不装 skill 各跑一遍。
39 个任务,包括一个真实的 FastAPI + React 仓库,每个任务跑 5 次,一共 585 次会话。
结果是这样。
代码行数少 53%,时间少 41%,成本少 26%,输出 token 少 45%。
换句话说,它省下来的不只是打字的时间,还有以后读代码、改代码、修 bug 的时间。
按常理,代码砍一半,质量多少要掉一点。
但是它没有。
-53%
代码行数
-41%
时间
-26%
成本
-45%
输出 token
98%
高风险逻辑带测试
30/30
安全任务通过
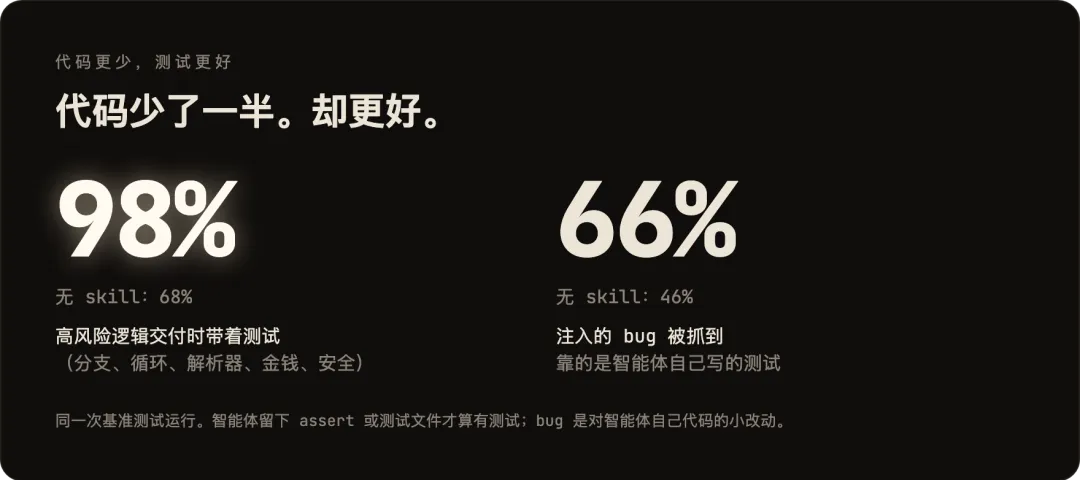
代码少一半,测试反而更好。图源:Ponytail 仓库
在 18 个带隐藏检查的任务里,Ponytail 5 通过了 87 次,总共 90 次,通过率 96.7%。不装 skill 是 86 次,95.6%。基本持平,略高一点。
六个安全任务,SQL 注入、路径穿越、伪造 token、限流、格式错误的 CSV、缓存,三十次运行全部通过。
更反直觉的是测试。
Ponytail 有个规矩,带分支、循环、解析器,或者涉及钱和安全的逻辑,必须留一个小测试。
按这个标准筛出 22 个该有测试的任务,Ponytail 5 有 98% 交了测试,不装 skill 是 68%。
作者还往这些代码里注入了一些小 bug,比如把比较符号反过来、删掉一个 if、差一位。Ponytail 写出来的测试能抓到 66%,不装 skill 是 46%。
代码少了一半,测试反而多了。
这事儿就有点意思了。
当然,数据是作者自己跑的。信不信,各位自己判断。但他把方法、每个任务的明细、局限性都摊在仓库里,连哪次运行为什么没算进去都写了。
这份 benchmark 也有它的边界。它只测了 Claude Code,Bash 被关掉了,agent 只负责写代码和测试,不负责调试。
39 个任务里,只有 18 个带隐藏检查。作者自己也写了,另外 21 个任务只能证明代码交付了、能编译,证明不了质量。
所以他又找了另一个模型做盲评,看代码有没有真的完成任务。Ponytail 5 是 105 次全部“完整实现”,不装 skill 是 100 次全部完整。
两边都没掉链子。
这种坦诚,比数字本身更少见。
04
THE PROBLEM
AI 不会累,这才是灾难
那为什么这么个东西,能拿 16.7 万星。
我想了很久。
后来想明白了。因为这四年,我们一直在夸 AI 会写代码。
没人夸它少写。
AI 不累。这是它最大的优点,也是它最大的灾难。
人写代码会烦。会因为需求太蠢而砍掉一半功能,会因为“这玩意儿以后谁维护”而拒绝加抽象,会因为今天想早点下班而选择一个最土但最稳的方案。
AI 不会。让它加个功能,它顺手给你加三层抽象、四个配置项、一套“以后可能会用到”的插件机制、一个只有它自己看得懂的工厂函数。
比如我只是想给一个内部脚本加个重试。它会先抽象出一个 RetryPolicy,再写一个 BackoffStrategy,再补一层配置合并,最后告诉我这样“更可扩展”。
我看着那两百行代码,只想说,我只是想重试三次。
它像一个刚入职的应届生。精力旺盛,态度积极,极度渴望证明自己。
「大家说要个杯子,它给你造了一条陶瓷生产线。」
然后大家 review 的时候,面对两千行 diff,开始怀念那个一言不发的老哥。
Ponytail 真正卖的东西,是一套判断力。
知道什么不该做。
这套判断力,学校不教,面试不问,绩效也不直接考核。它只在每一次代码评审、每一次线上事故、每一次“这个需求能不能不做”的对话里,慢慢长出来。
大家给这个仓库点星,点的是一种久违的共鸣。被 AI 的过度热情折磨过的人,看到“少写点”这三个字,很难不点。
05
SENIORITY
真正的资深,敢不做
我个人觉得,“资深”这个词被误解了很久。
很多人以为资深就是会得多。会十种语言,背得出十种设计模式,简历上写满技术栈。
这些当然算本事。
但真正的资深,是知道哪些坑不用踩,哪些需求可以不做,哪些代码可以不写。
年轻人的代码是加法。资深的代码是减法。
Ponytail 把这个东西拆成了很具体的行为。
比如修 bug。它不会在别人指出的那个函数里打补丁,它会先 grep 所有调用方,找到根因,在共享的那一层修一次。
比如搬代码、合并代码。原来有的错误处理和校验,一行都不能丢。
比如捷径。如果一个方案有已知的局限,它必须留一行注释,写清楚局限是什么,什么时候该升级。
它甚至配了一个命令,/ponytail-debt,把这些欠下的账收集成一张清单,免得“以后再说”变成“永远不做”。
还有 review。
以前的 /ponytail-review 只找能删的代码。现在它像那个半夜会被电话叫起来修线上的人。
它会读这次改动碰到的代码,不是只看 diff。它会追数据从哪进来、存在哪、从哪出去。它会 grep 每一个调用方。
它输出的每一条发现,都必须带四样东西:这是什么、问题在哪、怎么修、不修会怎样。没有具体案例的担心,它不许写。
基准测试里有个真实的例子。一次改动重命名了一个字段,diff 本身看不出问题。但一个没被改过的文件 src/routes/feed.js,现在每次请求都会崩。
Ponytail 找到了。它写清楚这是什么、问题在哪、怎么修、不修会怎样。
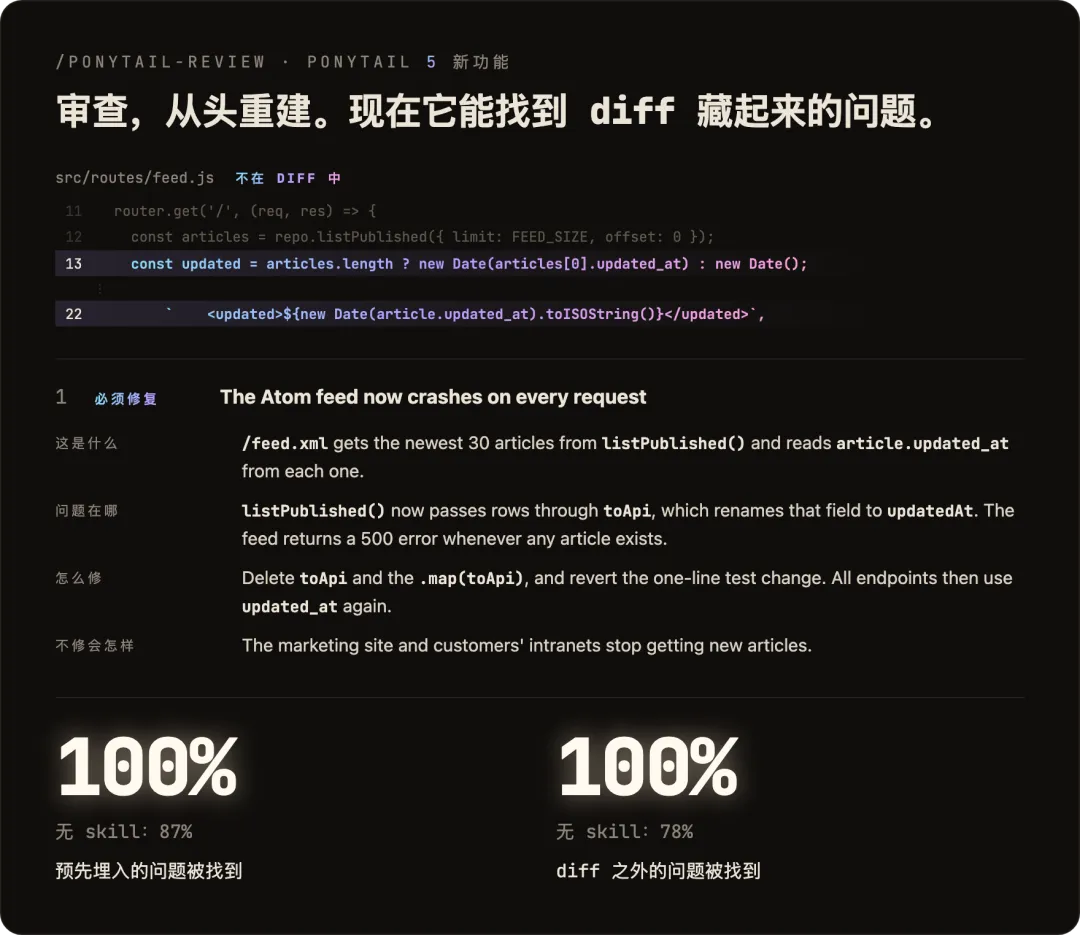
不在 diff 里的问题,被找了出来。图源:Ponytail 仓库
埋进去的问题,它找到 100%。不装 skill 是 87%。diff 之外的问题,它找到 100%。不装 skill 是 78%。
还有个 /ponytail-audit,对整个仓库做同样的事。先摸清入口、数据流、项目预期要扛多大负载,再排优先级,告诉大家先修哪个。
它不会只列一份“可以删掉的代码清单”就完事。
∞
EPILOGUE
写在最后
Ponytail 有三个档位。
lite,做你要的,顺口提一句更小的方案,让大家自己选。
full,默认档,上面那些规矩全开。
ultra,除了干活,还会质疑需求。作者的原话是,当“代码库把人惹毛了”的时候用。
我特别喜欢这个描述。
一个 AI 工具,没有把自己包装成无所不能的超级员工,反而给了大家一个“今天不太想干活”的档位。
5.3 版本还加了一条信息栏,就悬在 Claude Code 的输入框上面。这次任务花了多少钱,用了多少 token,复用了多少已有代码,最后一次改动之后测试过没过。
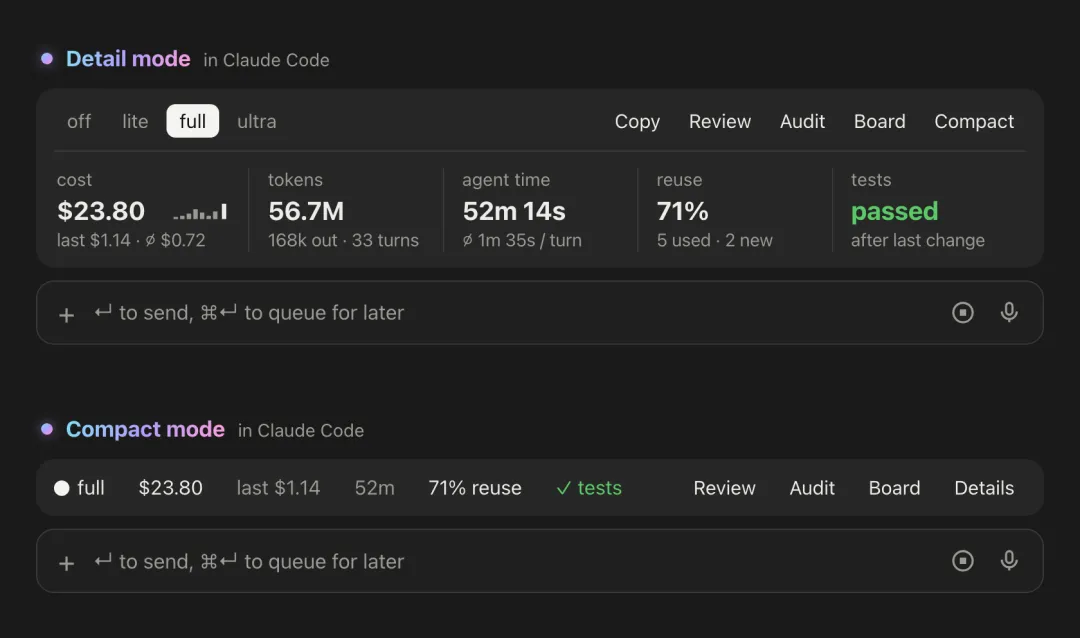
5.3 版本的信息栏。图源:Ponytail 仓库
它甚至会把“复用率”当成一个值得展示的指标。
再往后,它做了一个本地看板。过去 30 天在多少个项目上花了多少 agent 时间、多少 token、多少钱,哪个会话的测试没过,全给你列出来。数据默认只留在本机。
大家想想,别的 AI 工具都在比谁生成得多、谁写得多、谁覆盖得广。它在比谁复用得多、谁新写得更少。
这个价值观,挺不合时宜的。
也挺珍贵的。
我们总以为,AI 时代最稀缺的是生成能力。
其实不是。
生成已经不值钱了。现在任何一个模型,都能在几秒钟里给你吐出一千行看起来能跑的代码。
值钱的是克制。是判断。是在所有人都能写出一千行的时候,有人敢说,十行够了。
这套东西最聪明的地方,是它没有绑定任何一个模型。它是一段文本。
Claude Code 能读,Codex 能读,Cursor 能读,Copilot 也能读。20 种 agent,共用同一套规矩。
它没有发明新能力,它只是把一种快被忘掉的工作习惯,重新写成了 AI 能听懂的话。
Ponytail 的 FAQ 里有一段,我看了好几遍。
有人问,如果真的需要那个 120 行的缓存类呢。
「你不需要。非要的话,他也会写。慢慢地。正确地。一边看着你。」
我看到这儿笑出来了。
一个 AI 项目,最打动人的部分,是它假装自己有点不情愿。
还有个问题,问它能不能扩展。
它说,你从没写过的代码可以无限扩展。零 bug,零 CVE,开天辟地以来 100% 在线。
这话是玩笑,也是真话。
我至今依然记得看到这句 FAQ 时的反应,笑了半天。。。
那个扎马尾的人,现在住进了大家的 agent 里。
他还是不说话。
但他会看着你。
AI 啊。真好玩。
项目地址
github.com/DietrichGebert/ponytail
/plugin marketplace add DietrichGebert/ponytail
/plugin install ponytail@ponytail
不用谢他。他不会说。
以上。
我是有意思君,一个 AI 博主,在这里记录 AI 行业里那些值得多看一眼的事。
如果你觉得今天这篇有收获,欢迎点赞、在看、转发三连,我们下篇见。