ARTICLE · 1222667
【第55期】CSIG文档图像分析与识别专业委员会学术微沙龙
CSIG文档图像分析与识别专业委员会学术微沙龙(简称:文档图像微沙龙)在线学术报告会第55期于2026年8月18日成功举行。
本沙龙由中国图象图形学学会主办,文档图像分析与识别专委会发起承办,中国图象图形学报协办。
本场活动邀请中国科学院信息工程研究所李庚洛博士分享最新成果:HunyuanOCR-1.5:让轻量级 OCR 视觉语言模型更快、更强;邀请百度大模型青年团尹悠阳研究员分享最新成果:无限OCR:迎接单次长程解析新纪元。
微沙龙活动在B站、蔻享学术、中国图像图形学报视频号进行了同步直播。三个平台共计约3710人次的相关领域的老师同学观看学习。
1
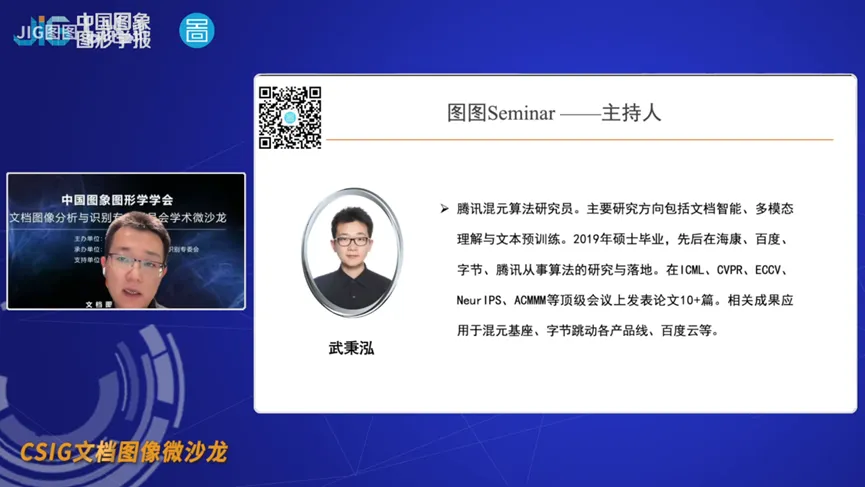
第一场报告活动由腾讯混元算法研究员武秉泓担任主持人。
报告人来自中国科学院信息工程研究所的李庚洛博士。
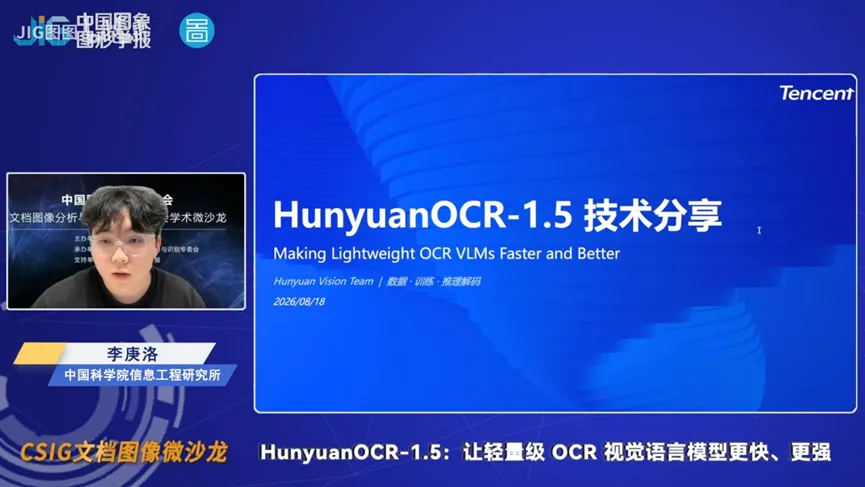
报告题为“HunyuanOCR-1.5:让轻量级 OCR 视觉语言模型更快、更强”,系统介绍了团队在轻量级端到端 OCR 视觉语言模型上的最新进展。报告首先交代了这项工作的出发点:随着多模态大模型的发展,OCR 正从传统的检测、裁剪、识别、重组这一级联流水线,走向用单一视觉语言模型直接完成文档解析、文本检测识别、信息抽取、文本图像翻译与多图文档理解。现实中大量信息以文档与图像形式存在,既包含复杂版面结构,也包含跨语言文本内容,如何在一个轻量模型里同时做到快与强,成为落地的关键挑战。HunyuanOCR-1.5 正是在 1.0 已验证的轻量级架构之上,不重做骨干网络,而是围绕“更快”与“更强”两条线进行系统升级。在“更快”方面,团队把 DFlash 推测解码适配到 OCR 解码过程。密集文档、表格、公式这类任务的共同特征是输出极长且局部高度规律,DFlash 正是利用这一规律,在保持输出分布不变的前提下显著压缩长结构化输出的延迟。最终 Transformer 推理提速 6.37 倍,vLLM 推理提速 2.14 倍,使其在同级轻量 OCR 视觉语言模型中取得最快的推理表现。在“更强”方面,核心是 Agentic Data Flow,一套由智能体驱动的数据构造系统。它把模型暴露出的短板翻译成可执行的数据需求,再自主完成素材搜索、质量校验与数据管线搭建,思路是从人工预先定义数据配方转向模型表现驱动数据演进。借助这套系统,模型在古文字识别、低资源多语言解析、细粒度图表与复杂表格解析、多图文本中心问答以及文档幻觉评测等长尾能力上取得明显改善;配合升级后的预训练与后训练配方,并引入 4K 高分辨率与 128K 长上下文扩展,模型在高分辨率、长上下文与多任务场景下的能力进一步延展。在评测与开放方面,HunyuanOCR-1.5 在 OmniDocBench v1.6 上跻身端到端 OCR 方案的第一梯队,同时在上述长尾任务上取得新的性能里程碑,并保持 1B 规模的轻量化部署优势。报告最后介绍,团队将开放模型权重与 SFT、RL 训练代码,以推动社区在文档解析与 OCR 方向上的后续研究与落地。
参考论文
[1]. Gengluo Li, et al. HunyuanOCR-1.5: Making Lightweight OCR VLMs Faster and Better. arXiv:2607.04884, 2026.
[2]. Gengluo Li, et al. StrucTab: A Structured Optimization Framework for Table Parsing. ECCV 2026.
[3]. Gengluo Li, et al. Chronicles-OCR: A Cross-Temporal Perception Benchmark for the Evolutionary Trajectory of Chinese Characters. arXiv:2605.11960, 2026.
[4]. Shangpin Peng, et al. ChartArena: Benchmarking Chart Parsing across Languages, Scenarios, and Formats. arXiv:2606.01348, 2026.
[5]. Long Xu, et al. MORE: A Multilingual Document Parsing Benchmark and Evaluation. ICML 2026.
2
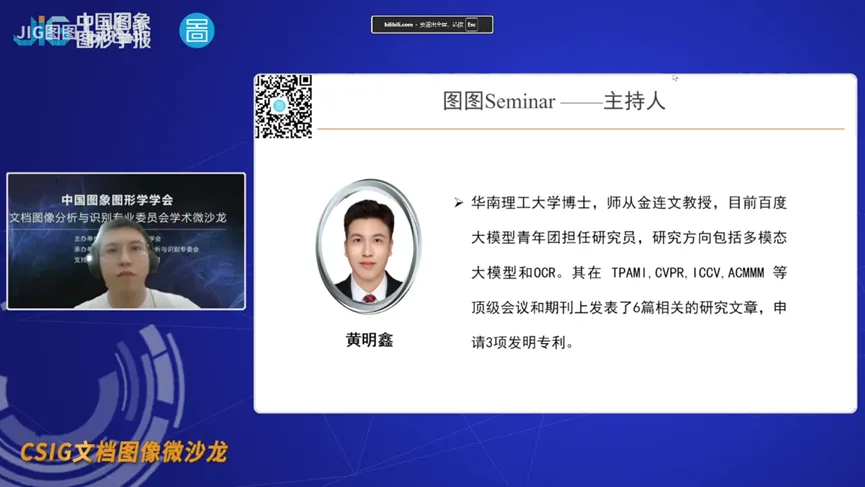
第二场报告由百度青年团黄明鑫研究员担任主持人。
报告人为百度青年团尹悠阳研究员。
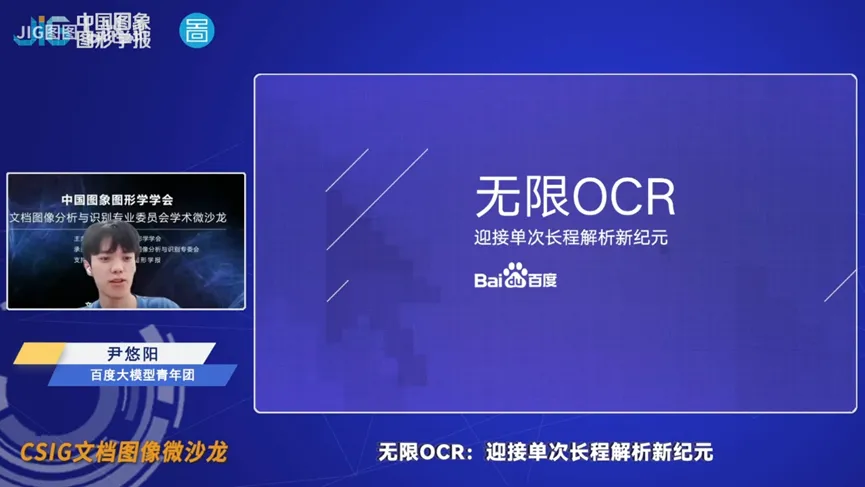
报告题为:“无限OCR:迎接单次长程解析新纪元”,介绍了面向长文档连续解析的最新研究。报告首先指出,现有OCR模型在处理多页文档时,面临键值缓存持续膨胀、推理效率下降及跨页面解析连续性不足等挑战。针对这些问题,研究提出参考滑动窗口注意力机制(R-SWA),使模型始终访问完整的视觉与提示词信息,同时仅关注固定窗口内的历史输出,在保留参考信息的同时控制缓存规模。基于该机制构建的Unlimited OCR模型,实现了多页文档的一次性解析,在OmniDocBench v1.5和v1.6上的综合得分分别达到93.23%和93.92%,并在40页以上的长文档测试中保持稳定表现。在约6000个输出Token时,其推理吞吐较DeepSeek OCR提升约35%。Unlimited-OCR 开源仅三个月,在GitHub上的Star数量便已突破2.7万,获得了业界的广泛好评。同时在HuggingFace上Likes数位列所有OCR模型历史第一,下载量近千万次。
参考论文
[1]. Yin Y, Liu H, YY, et al. Unlimited OCR Works: Welcome the Era of One-shot Long-horizon Parsing[J]. arXiv preprint arXiv:2606.23050, 2026.
[2]. Wei H, Sun Y, Li Y. DeepSeek-OCR: Contexts Optical Compression[J]. arXiv preprint arXiv:2510.18234, 2025.
报告回放
B站视频链接:
https://www.bilibili.com/video/BV1EfnE6MEkU/
或扫描二维码观看:
END
加入学会:
关注我们: