ARTICLE · 1239392
OpenAI万亿估值: API用户3步降本备灾
OpenAI 传新一轮融资 300 亿美元,估值冲上 1.25 万亿。你以为这只是资本狂欢?对天天调 API 的开发者来说,这意味算力被资本深度绑定,IPO 前夕的财务美化期,API 涨价和商业化收割即将到来。你的账单要爆了。
一、融资 300 亿,买的不只是模型是算力
OpenAI 这轮由 Coatue 和 UAE 投资者领投,估值达 1.25 万亿。最关键的细节是:UAE 的资金可能附带一项协议,为 OpenAI 提供更多计算能力。
这说明什么?算力已经成为比模型本身更稀缺的硬通货。资本注入不是为了做慈善,当算力与特定资本深度绑定,优先级必然是保障大客户和自身 IPO 前的利润率。
普通开发者的 API 调用优先级,大概率会被挤占或变相加价。你以为买的是模型服务,其实买的是算力租约,而算力正被大资本包场。
UAE 的算力优势来自过剩的能源和新建智算中心。当 OpenAI 接受这种算力,意味着它的服务可用性将受制于这些基础设施的调度策略,你的请求可能要跨半个地球排队。
二、IPO 前夕,别指望 API 降价
OpenAI 6 月已提交机密 IPO 文件。从 8520 亿到 1.25 万亿,估值翻倍的前提是讲好盈利故事。连亏损的 AI 公司都要给投行交利润表了。
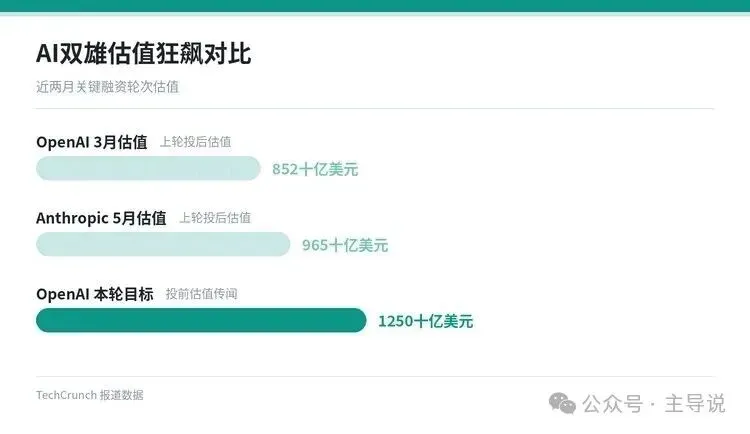
两家 AI 巨头近期估值对比,条形越长估值越高,OpenAI 冲向 1.25 万亿。
IPO 前夕的常规操作是:砍补贴、推高客单价商业版、限制低价 API 的并发。为了财务报表好看,免费额度和低价折扣必然首当其冲被砍。
资本要的是利润表,不是开发者的白嫖账单。
Anthropic 5 月融资 650 亿,估值 9650 亿,当时被认为是 IPO 前最后一轮。现在它寻求 1.5 到 2 万亿估值,说明闭源大模型的开价越来越离谱。
两家巨头在 IPO 趋跑,意味着整个闭源 API 市场的红利期结束。双雄争霸,争的是谁的客单价更高,而不是谁对开发者更友好。
你以为模型越强越便宜?错,模型越强,算力越吃紧,变现压力越大。闭源模型的能力越接近 AGI,其 API 的门槛和溢价只会越高。
三、你的 API 账单面临 3 个暗坑
巨头冲 IPO,压力全传导给 API 用户。不提前防备,下个月账单就可能教你做人。这三个坑,踩中任何一个都够呛。
并发降级不报错:算力被大客户挤占,低优先级请求延迟飙升,但不报错,你的应用默默变卡,用户体验崩盘。
模型路由暗调:高成本模型被悄悄替换为蒸馏版,输出质量下降,但计费名称不变,你花原价买了个缩水服务。
隐性费率调整:免费额度缩水,阶梯折扣门槛提高,中小团队拿不到之前的折扣,账单不知不觉翻倍。
这些变化往往不会发全量邮件通知,而是悄悄更新在定价页的角落里。等你发现时,往往已经多交了几个月的冤枉钱。
很多开发者以为只要代码能跑就行,忽视 SLA 细节。闭源厂商的 SLA 对延迟和降级几乎没有赔偿承诺,你只能默默承受。
我的实测
这次没能在本机复现,文中数字均来自项目官方文档,已在正文标注出处。你在自己机器上试过吗?
四、3 步备灾,把主动权拿回来
闭源模型不可控,必须建立自己的对冲机制。不要把核心业务逻辑死绑在某一家 API 上。以下三步,建议本周内完成。
抽象模型调用层:代码里不要硬编码 gpt-4o,用路由网关(如 OneAPI)统一接管,随时可切换底层模型,做到代码层无感切换。
锁定长期折扣:如果当前用量稳定,立刻联系商务签年框,锁定当前费率,避免 IPO 后涨价被动。签不了年框就预充值锁定额度。
测平替开源模型:对非核心链路,立刻用 Qwen 或 Llama 等开源模型做 A/B 测试,评估降级影响,准备好随时降级的预案。
对于用量不大的个人开发者,签年框不现实。最靠谱的是转向 Groq 等提供固定算力租赁的平台,或者用第三方托管的开源 API,避免按量计费的波动。
别嫌麻烦,等 API 宕机或涨价 50% 时再改代码,那才叫真的手忙脚乱。多接一个模型供应商,就多一条生路。
五、一键测速:你的 API 还好吗
与其盲猜不如实测。跑一下这个脚本,看看你常用的 API 端点延迟是否已经悄悄翻倍。如果延迟异常,立刻启动降级预案。
bash
#!/bin/bash # API 延迟测试脚本 (替换 YOUR_API_KEY) API_KEY="YOUR_API_KEY" URL="https://api.openai.com/v1/chat/completions" for i in {1..5}; do START=$(date +%s%N) curl -s -X POST "$URL" \ -H "Authorization: Bearer $API_KEY" \ -H "Content-Type: application/" \ -d '{"model":"gpt-4o-mini","messages":[{"role":"user","content":"hi"}],"max_tokens":1}' > /dev/null END=$(date +%s%N) DIFF=$(( (END - START) / 1000000 )) echo "请求 $i: ${DIFF} ms" done脚本中 max_tokens 设为 1,是为了只测网络和排队延迟,不测生成速度,既省钱又能精准定位是否被限流。
如果连续 5 次请求延迟波动极大,或者平均超过 2 秒,说明你大概率已经被挤到了低优先级队列。
建议把此脚本加入 crontab,每天定时跑三次,把结果写入日志。一旦延迟连续三次超过阈值,自动发告警,甚至自动切到备用模型。
六、算力为王,多模备胎
闭源 API 是租来的地盘,开源模型才是自己的退路。
1.25 万亿估值背后,是 OpenAI 对算力饥渴的极致体现。UAE 资本换算力,算力换估值,估值换 IPO 流动性。这条链路里,没有中小开发者的位置。
面对闭源巨头 IPO 前的收割期,最务实的做法就是:核心业务留开源兜底,API 调用做好网关路由,成本账本按天核对。
开源生态的成熟度已经超乎想象。Qwen2.5 和 Llama3 在多数任务上已经能平替 GPT-4o-mini。自己部署或用第三方托管的开源 API,成本能降到十分之一。
今天多配一个备用节点,明天巨头涨价时,你就能云淡风轻地看着别人发朋友圈骂街。别等账单爆了才找退路,现在就动手。
你在用哪家 API?最近延迟有变化吗?留言聊聊
本文仅为行业观察与信息整理,不构成任何投资建议。
本文使用 AI 辅助完成资料检索与初稿整理,文中的观点、判断与个人经验由作者本人补充,全部内容经作者审核后发布。